
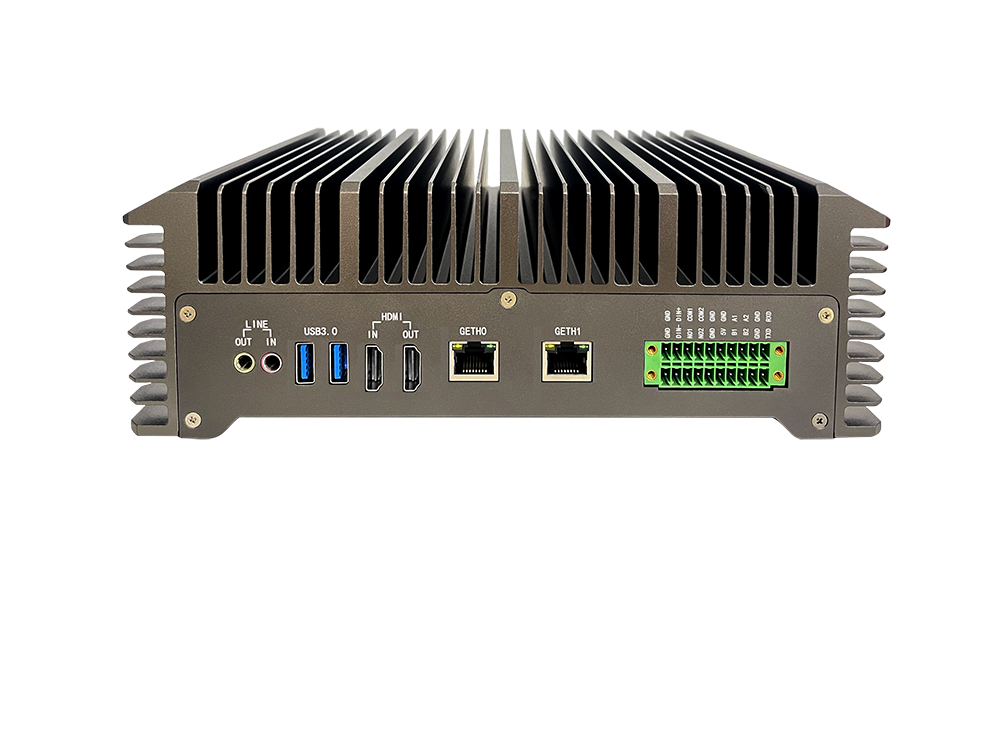
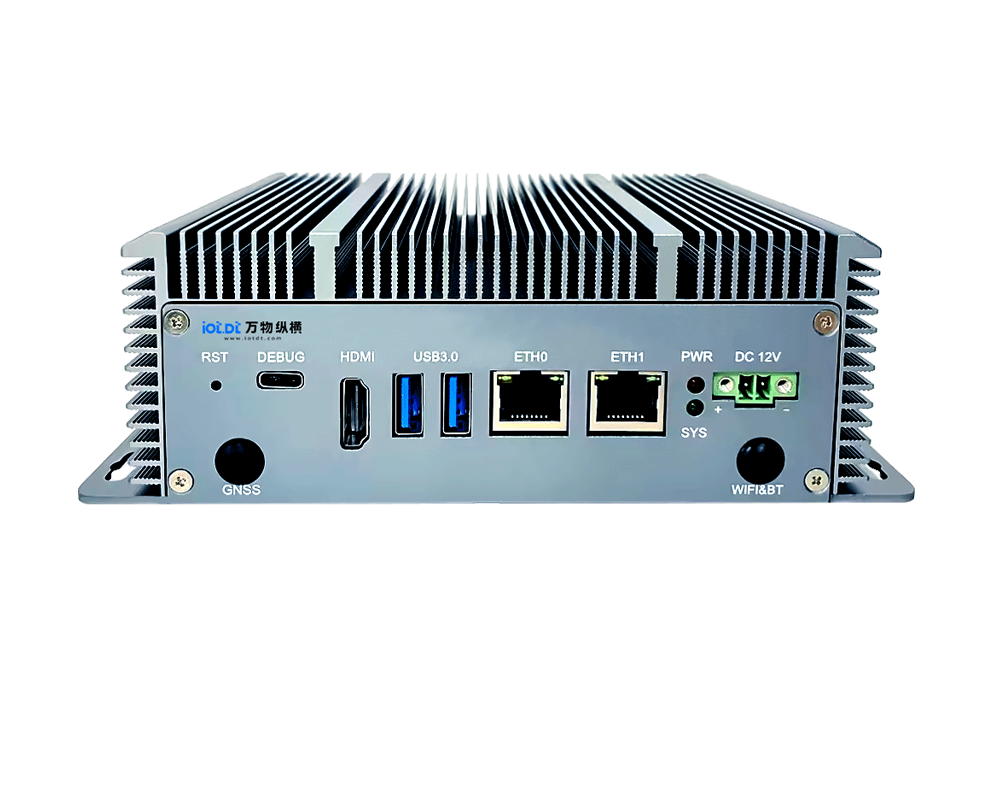
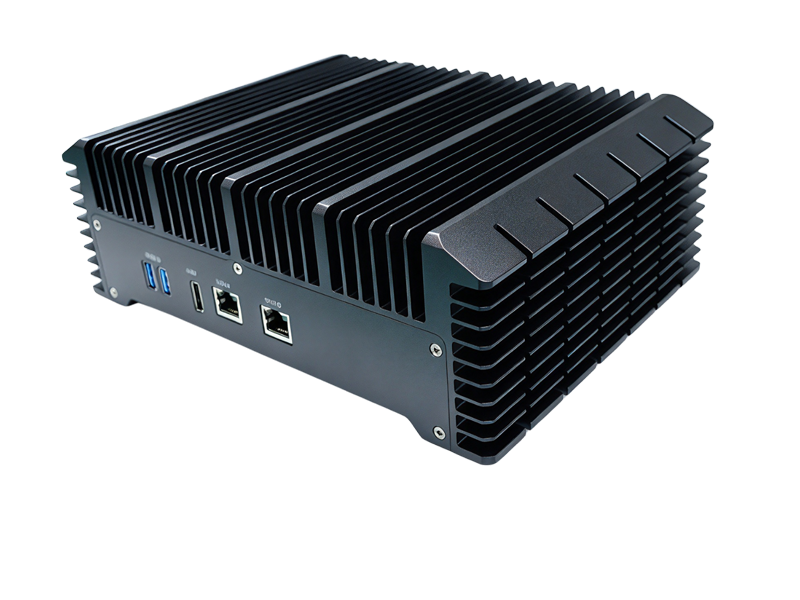
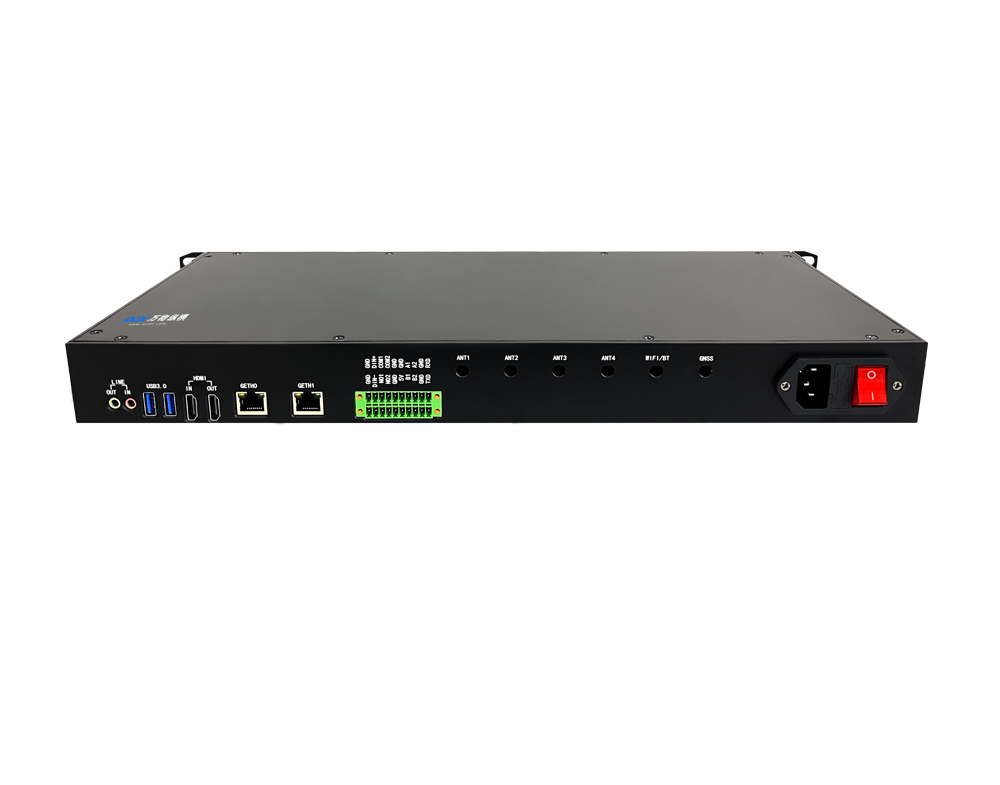
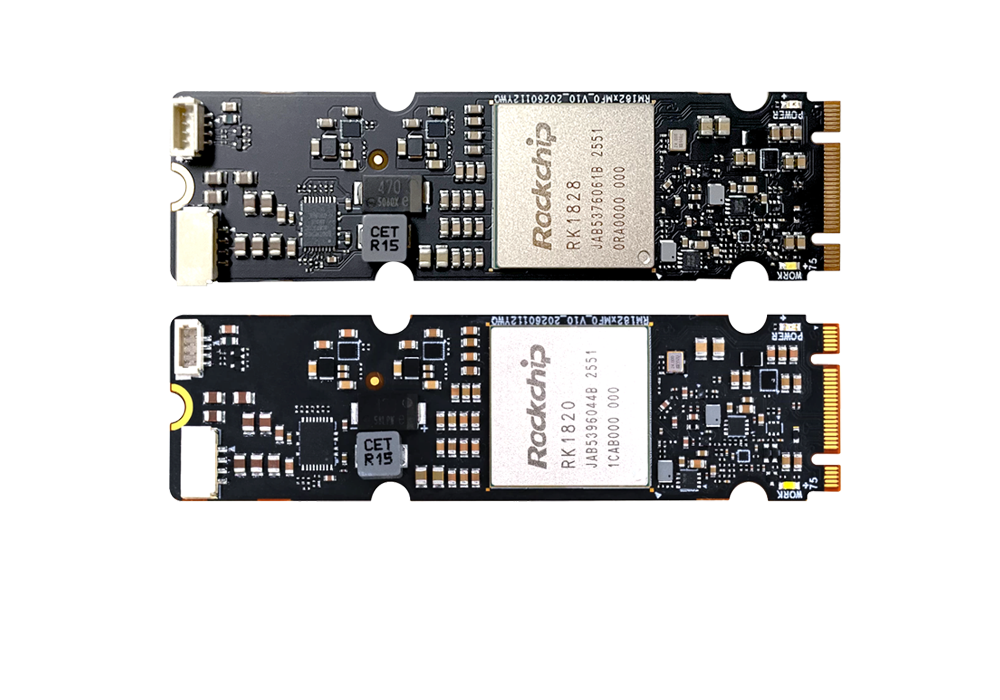
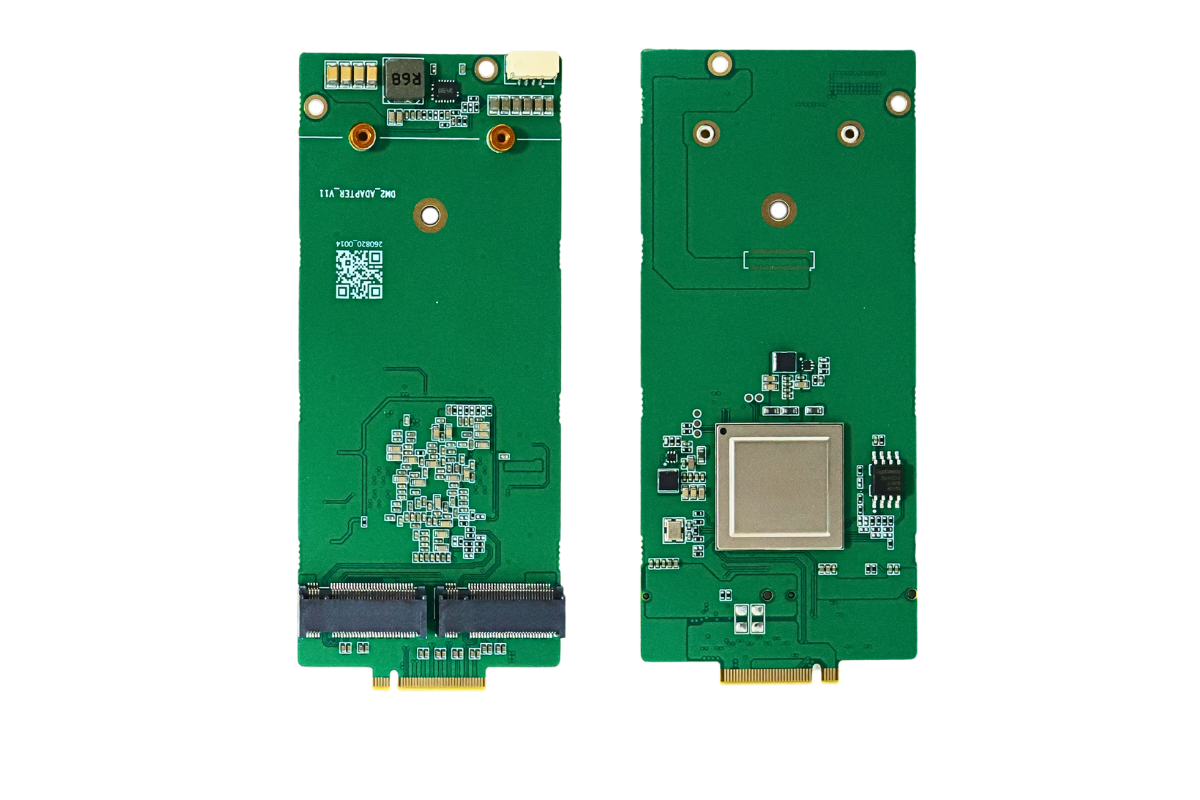


LQ50 在超长上下文、大 KV Cache、大参数量模型场景能效更强;RK1828 在中小上下文、7B 以内模型、低功耗小体积边缘设备、批量并发场景更均衡,生态更成熟。
长上下文推理瓶颈不是单纯算力,而是 KV Cache 读写带宽、片上存储容量、Prefill 阶段访存开销。
硬件基础差异
项目 | ||
架构 | 传统 NPU + 片载 5GB DRAM,INT8 20TOPS | 存算一体架构,板载最高 48GB LPDDR5,160TOPS 弹性算力,带宽 153.6GB/s |
单卡典型功耗 | 约 10W 满载 | 单卡 Prefill 约 10~14W,Decode 约 11W;LQ50 Duo 双芯满载 28~31W |
原生内存 | 5GB DRAM(单卡) | 最高 48GB,KV Cache 容量优势巨大 |
扩展方式 | 多卡级联,RKNN3,支持 27B | 单卡 / 双芯 Duo,原生擅长超大 KV Cache |
长上下文场景各自优势
RK1828 优势:中小长上下文、轻量边缘、并发交互
1. 7B 模型 + 16K 以内上下文能效好、整机功耗低
单卡 5GB 片载内存,Qwen7B/8B 搭配 16K 上下文,KV Cache 占用可控,单卡 10W 功耗,风冷即可,适合 AI 盒子、智能座舱、小型边缘网关,批量多会话并发时稳定性强。
2. 软件生态成熟,RAG + 长文档摘要落地门槛低
RKNN3 对 Qwen 全系列深度适配,原生支持 16K 上下文,OpenAI API 接口,模型转换、量化工具链完善,工程落地快,多卡级联方案成熟,适合批量项目交付。
3. TTFT 首 token 延迟表现优秀
中小 prompt Prefill 速度快,人机交互场景体感好,适合需要频繁问答、文档检索类长文本交互。
短板(长上下文):单卡仅 5GB 内存,32K/64K 超长上下文时 KV Cache 容易爆内存;跑 14B 及以上模型必须多卡级联,级联后 PCIe 通信开销上升,长 Prompt Prefill 阶段能效会明显下滑。
LQ50 优势:超长上下文、大 KV Cache、14B+ 模型场景能效突出
1. 存算一体架构天然降低 KV Cache 搬运功耗,超长上下文能效占优
长上下文最耗资源的是 KV Cache 反复读写,LQ50 存算一体减少数据搬移;板载超大 LPDDR5,单卡即可承载超大 KV Cache,轻松跑 32K/64K 上下文,甚至支持 14B 模型长文档,不用立刻多卡分摊权重,减少 PCIe 开销。
2. 大参数量长文档场景能效比更高
Qwen3-14B、长输入(上万 token 文档一次性喂入)的 Prefill 阶段,LQ50 单卡就能承载,对比 RK1828 多卡级联方案,单位 token 功耗更低;LQ50 Duo 双芯可本地跑 32B 级模型长上下文,适合档案解析、合同审阅、长代码库分析等大文档场景。
3. 带宽上限高
153.6GB/s 带宽,超长 prompt Prefill 阶段(一次性处理大量输入 token),访存瓶颈远小于 RK1828。
短板:
生态比 RKNN3 新,算子适配、第三方模型移植工作量更大;
7B 小模型 + 短上下文场景,能效优势不明显,成本高于 RK1828;
多并发小会话场景,调度开销相比 RK1828 方案不占优。
选型判断(长上下文场景)
选 RK1828:
场景:7B/8B 模型,≤16K 上下文,设备功耗受限(整机 ≤15W)、AI 盒子/工控、RAG 多并发问答、快速量产交付,优先成熟度、成本、TTFT。
选 LQ50(LQ50 Duo):
场景:32K/64K 超长上下文、14B 及更大模型,一次性长文档输入、大 KV Cache 需求,长文档精读、法律/病历/源码库本地解析,可以接受更高 BOM 成本,追求 Prefill 阶段长输入能效。
总结
16K 以内长上下文、7B 模型、低功耗边缘:RK1828 能效更好,落地更快。
32K+ 超长上下文、大 KV Cache、14B+ 模型:LQ50 存算一体 + 大内存架构,长 Prompt Prefill 能效优势明显。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部