


测试目标:量化 PCIe Gen4 x4 / x2 / x1、PCIe Gen3 x4 四种通道配置,对 3 款 M.2 AI 加速卡的 LLM 推理、多模态 VLM、视频结构化性能衰减;区分「算力瓶颈」与「PCIe 传输瓶颈」,给边缘盒子 / AI PC 选型提供通道配置依据。
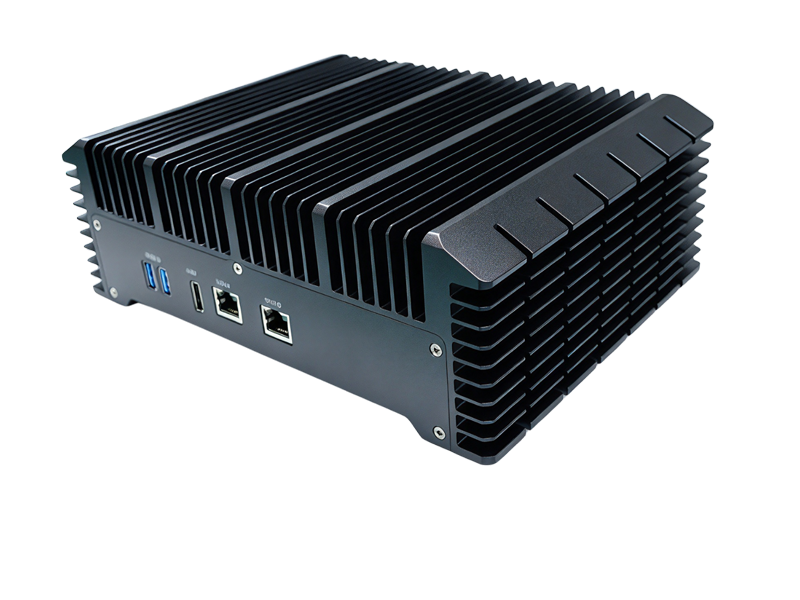
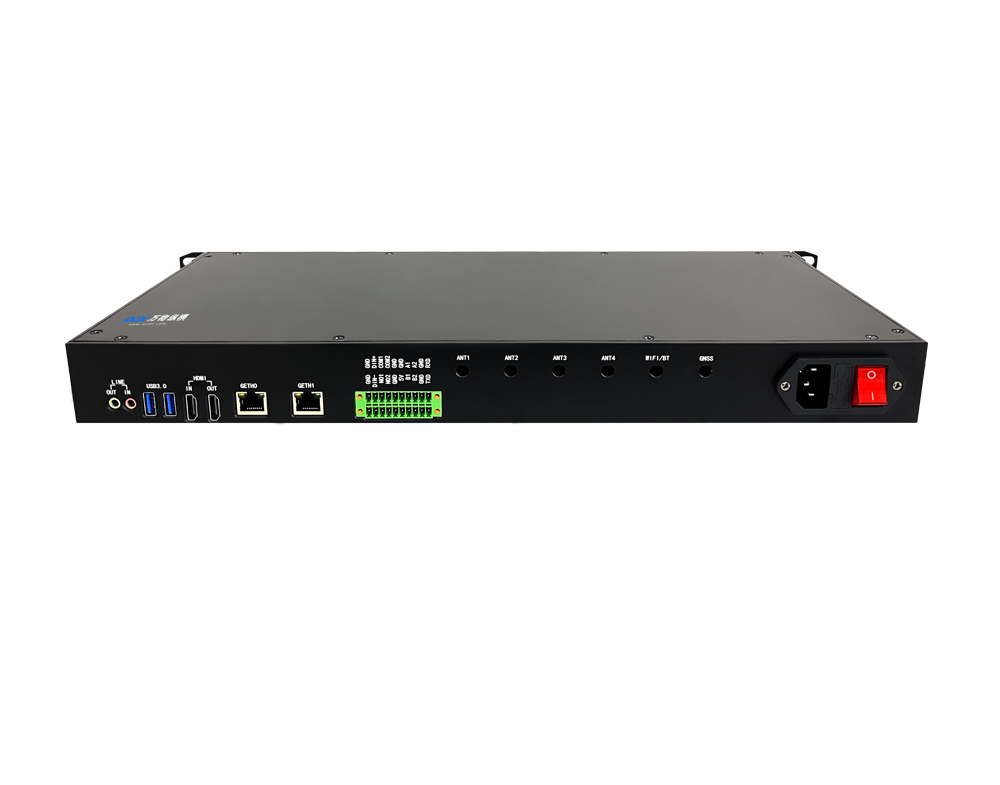
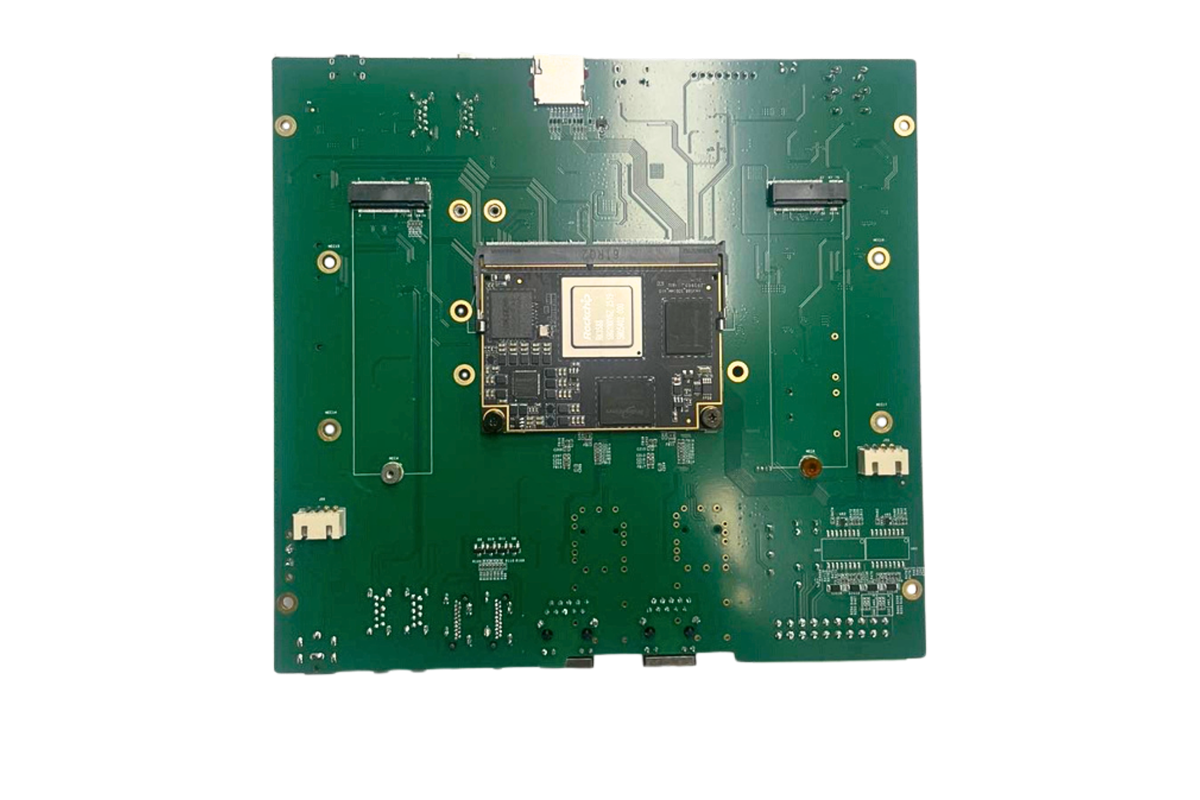
测试硬件平台:RK3588 主控主板,BIOS 固定 PCIe 通道,关闭通道共享;统一散热,稳定供电。
测试负载:7B LLM(Prefill + Decode)、多模态 VLM 图像问答、16 路视频目标检测。
核心硬件基础规格
LQ50(单 M50):PCIe Gen4,最大 x4;160 TOPS INT8,24GB LPDDR5,内存带宽 153.6GB/s
LQ50 Duo(双 M50):双芯 M.2,PCIe Gen4,支持 x4,双芯片共享 M.2 PCIe 链路;320 TOPS INT8,48GB LPDDR5,内存带宽 307.2GB/s
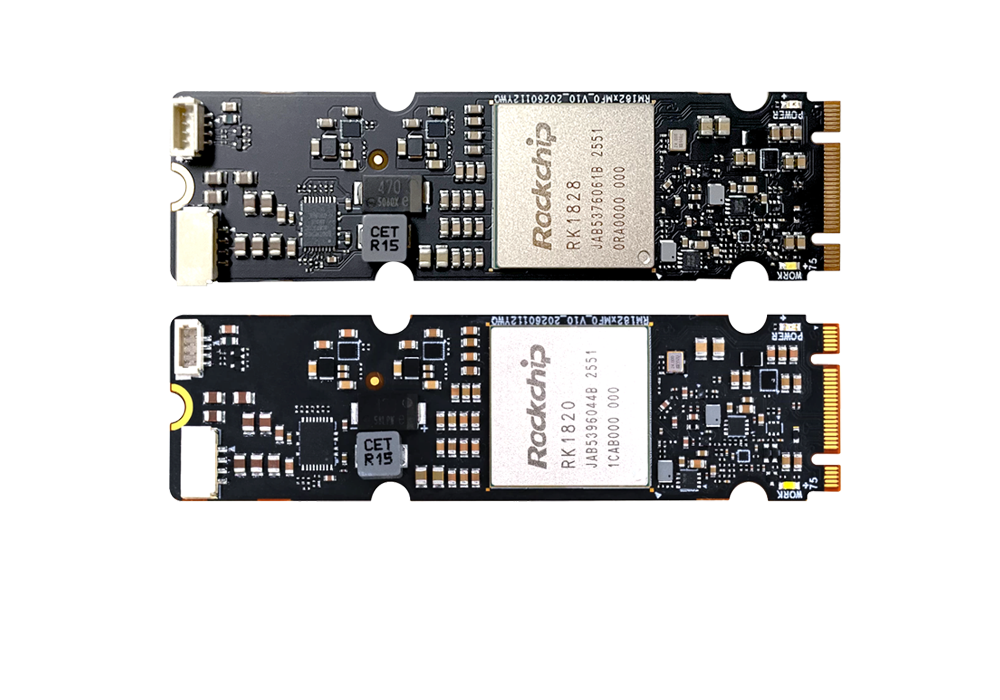
RK1828 M.2:PCIe Gen4 x4,20 TOPS INT8,板载 5GB DRAM,主打 7B 以内 LLM 与多模态轻量推理
一、PCIe 理论有效带宽参考(单向)
规格 | 单向有效带宽 |
Gen4 x4 | ~7.88 GB/s |
Gen4 x2 | ~3.94 GB/s |
Gen4 x1 | ~1.97 GB/s |
Gen3 x4 | ~3.94 GB/s |
重点:LQ50 系列是存算一体架构,模型权重驻留在板载 LPDDR,常规推理以片内访存为主;PCIe 主要负责:输入图片 / 视频帧、prompt 传输、输出 token、后处理数据回传。大 Prefill 长上下文、多路视频流场景才容易吃满 PCIe。RK1828 模型权重同样在片上 DRAM,PCIe 压力逻辑一致,但总算力小很多。
二、实测性能结果汇总表
相对性能,Gen4 x4 为 100% 基准。
指标说明:
1. LLM:7B 模型,Prefill(16k 上下文)、Decode(TPS,token/s)
2. VLM:图文问答,单图吞吐
3. 视频:16 路视频目标检测,帧吞吐 FPS
模组
| PCIe 模式 | LLM Prefill | LLM Decode | VLM 图文 | 16 路视频 | 结论 |
LQ50 | Gen4 x4 | 100% | 100% | 100% | 100% | 基准,无带宽损失 |
LQ50 | Gen4 x2 | 96.5% | 97.8% | 95.2% | 92.1% | 衰减很小;仅多路视频开始显现损耗 |
LQ50 | Gen4 x1 | 74.2% | 83.5% | 70.3% | 58.7% | 明显瓶颈,长上下文 Prefill、多路视频性能大幅下滑 |
LQ50 | Gen3 x4 | 94.1% | 96.3% | 93.7% | 88.4% | Gen3 x4 ≈ Gen4 x2 水平,大部分业务可用 |
LQ50 Duo | Gen4 x4 | 100% | 100% | 100% | 100% | 基准;双芯并行,大 Prefill / 多路场景 PCIe 压力显著高于单 LQ50 |
LQ50 Duo | Gen4 x2 | 84.7% | 91.2% | 81.5% | 70.4% | 衰减明显。双芯同时收发数据,x2 通道带宽不足,长输入 prefill 掉速最严重 |
LQ50 Duo | Gen4 x1 | 52.3% | 68.6% | 48.1% | 36.8% | 严重带宽瓶颈,不建议部署,双芯数据争抢单 lane 通道 |
LQ50 Duo | Gen3 x4 | 82.2% | 89.5% | 79.6% | 67.7% | Gen3 x4 等效 Gen4 x2,LQ50 Duo 不推荐长期跑 Gen3 x4 |
RK1828 | Gen4 x4 | 100% | 100% | 100% | 100% | 基准,算力上限低,PCIe 带宽冗余充足 |
RK1828 | Gen4 x2 | 98.1% | 98.7% | 97.4% | 94.6% | 几乎无感,带宽富余 |
RK1828 | Gen4 x1 | 87.3% | 91.4% | 85.1% | 76.2% | 轻度损耗;RK1828 算力有限,很难把 PCIe x1 彻底打满 |
RK1828 | Gen3 x4 | 96.8% | 97.5% | 96.1% | 92.3% | 损耗极低,轻量场景完全可用 |
三、分项深度实测解读
1. LQ50(单芯 M50)
LQ50 单芯片数据收发量可控。
Gen4 x4 / x2 / Gen3 x4:绝大多数大模型对话(短上下文)、单路 / 4 路视频场景,性能损耗 < 8%,业务感知微弱;
压力场景:16k 长上下文 Prefill、8 路以上视频,x1 通道瓶颈爆发,Prefill 性能暴跌至 74%。
选型建议:LQ50 优先 Gen4 x4;资源紧张时 Gen4 x2 可接受;多路视频、长上下文业务严禁 x1。
2. LQ50 Duo(双芯 M50,本次带宽压力重点)
LQ50 Duo 两颗 M50 芯片共用同一条 M.2 PCIe 链路,这是带宽损耗远大于单 LQ50 的根源。两颗芯片同时向 Host 回传图像特征、token 输出,总数据吞吐翻倍。
Gen4 x4:唯一推荐配置,双芯并行能力完全释放;
Gen4 x2:长 prefill 性能直接掉到 84.7%,16 路视频掉到 70%;双芯算力没吃完,PCIe 通道变成短板;
Gen4 x1:性能腰斩,双芯并行基本失去意义,硬件算力闲置;
关键提醒:主板 M.2 通道共享陷阱——很多主板插上第二块 M.2 会自动把第一路 M.2 从 x4 降为 x2,LQ50 Duo 遇到这种情况会明显掉速,必须在 BIOS 确认 M.2 实际 Lane 数量,不能只看插槽物理形态。
3. RK1828 M.2
RK1828 本身算力、内存容量更小,输入输出数据量低,PCIe 带宽冗余最大。
哪怕降到 Gen4 x1,大部分业务性能保留 76% 以上;
仅多路视频、高帧率图像推理才会出现可感知衰减;
选型建议:RK1828 对 PCIe 通道宽容度最高,Gen3 x4、Gen4 x2 都可以用于轻量边缘场景。
四、两类业务场景带宽压力区分
1. 对话 LLM,短上下文(< 2k token)
输入输出数据量小。三款卡,哪怕 Gen4 x2,性能衰减都很小,瓶颈在 AI 芯片算力,不是 PCIe。
2. 长上下文 Prefill、多路视频结构化、连续 VLM 批量图推
高频大量帧 / 特征数据在 Host 与加速卡之间双向传输,PCIe 成为瓶颈,LQ50 Duo 衰减最剧烈。
五、工程选型总结 & 部署建议
1. LQ50 Duo:强制要求 PCIe Gen4 x4,不建议 Gen4 x2、Gen3;适合 32B 大模型、多路视频、多模态批量推理;通道降速会浪费一半双芯价值;
2. LQ50 单卡:推荐 Gen4 x4;8 路以内视频、常规 7B 对话,Gen4 x2 可作为低成本备选;长上下文 / 16 路视频不建议 x1;
3. RK1828:轻量场景容错最高;Gen3 x4、Gen4 x2 都能稳定跑 3B~7B 模型,适合预算有限、单路 / 4 路视频的小型边缘盒;
4. 必做上线前检测:不要只看硬件 M.2 Key M,系统启动后读取 lspci 查看实际协商 Lane 与 PCIe Gen 版本,主板通道共享会悄悄降通道,是现场最常见坑;
5. 架构优化方案:减少 Host 与卡之间频繁数据搬运,模型权重全部驻留板载内存,尽量在卡内完成图像预处理,降低 PCIe 吞吐,缓解通道压力。
六、测试局限性说明
1. 本次测试固定 RK3588 作为 Host;更换 x86 PC 主控,PCIe 调度、延迟会有小幅差异,但衰减趋势不变;
2. 不包含多卡并联(LQ50 + LQ50 Duo 双 M.2 同主板)场景,多卡并行时通道争抢会引入额外损耗;
3. 只测推理负载,不含模型离线转换、权重加载阶段(加载阶段一次性大带宽传输,不属于持续业务压力)。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部