
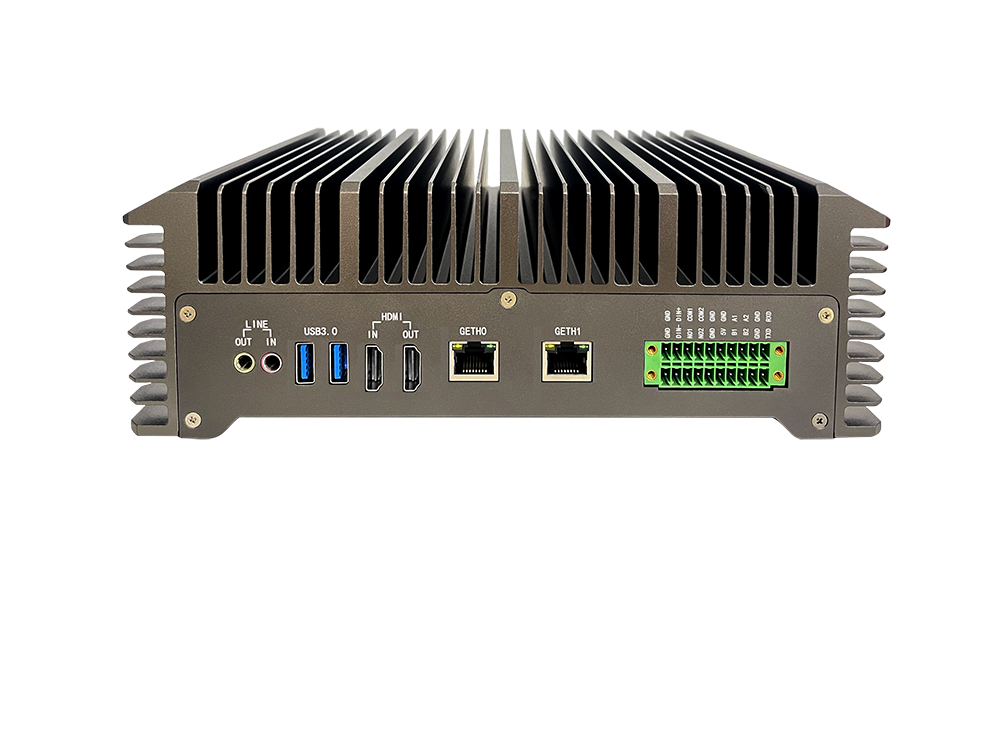
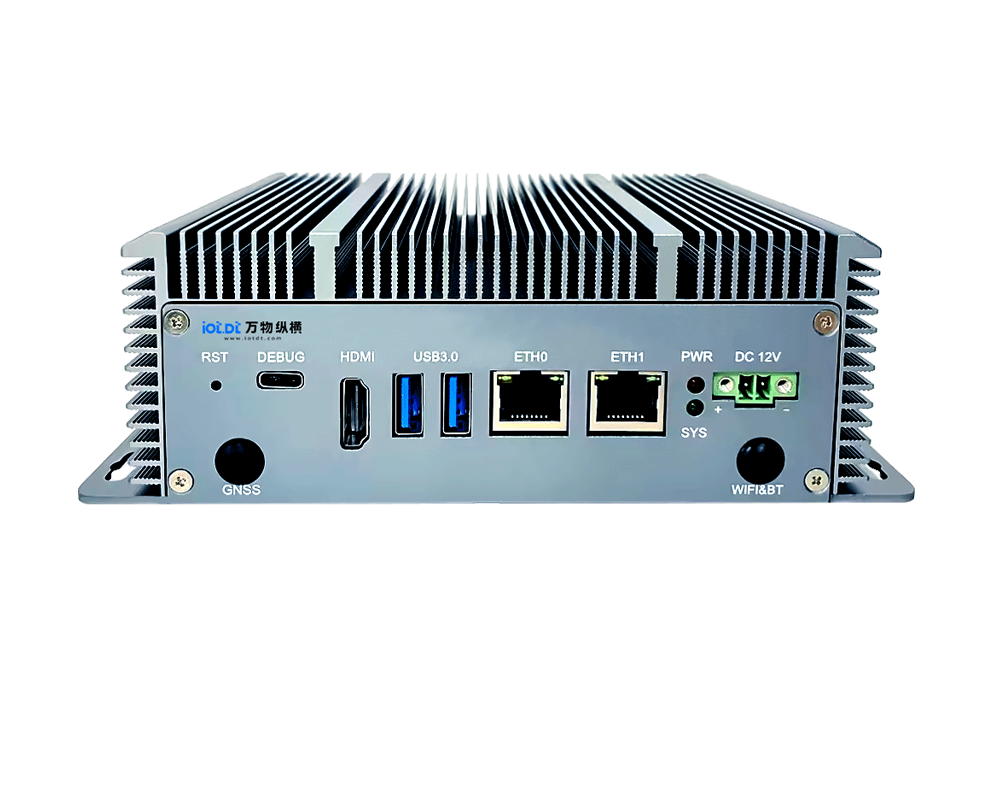
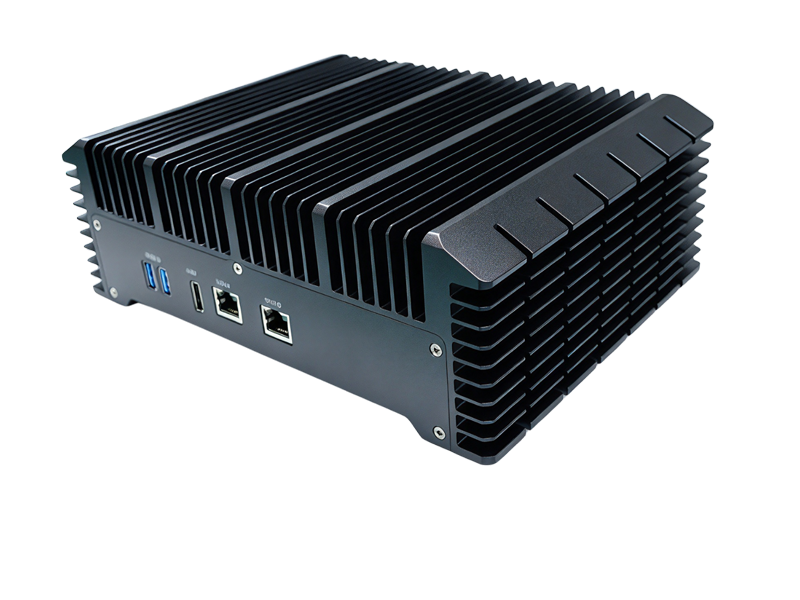
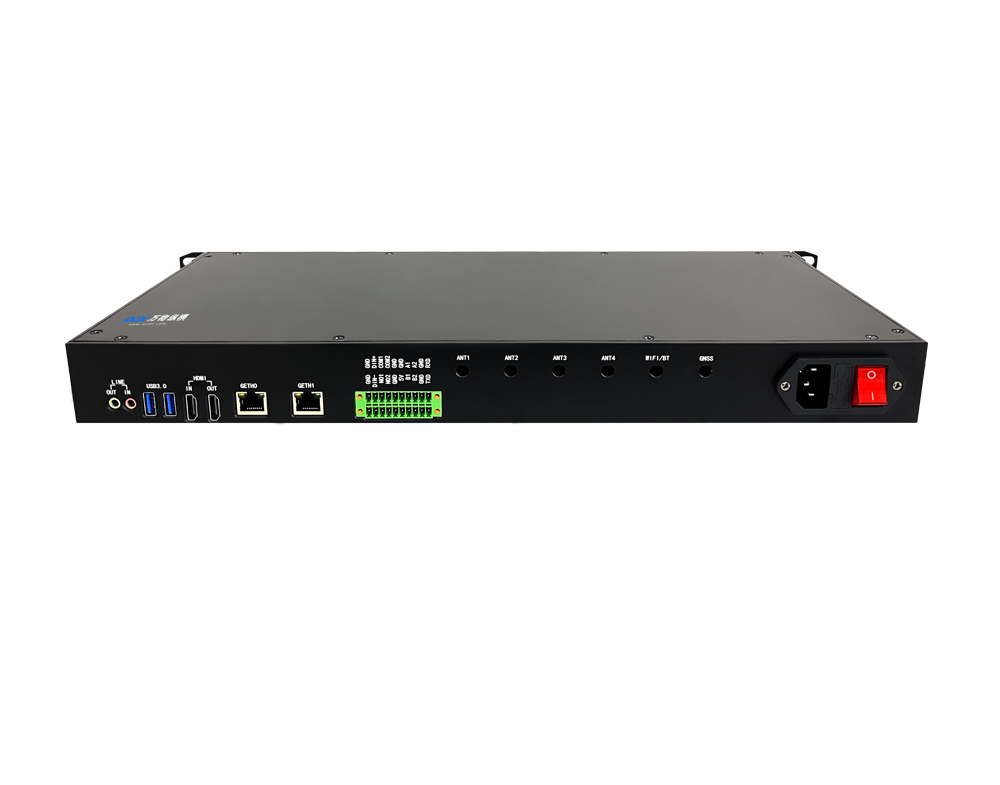
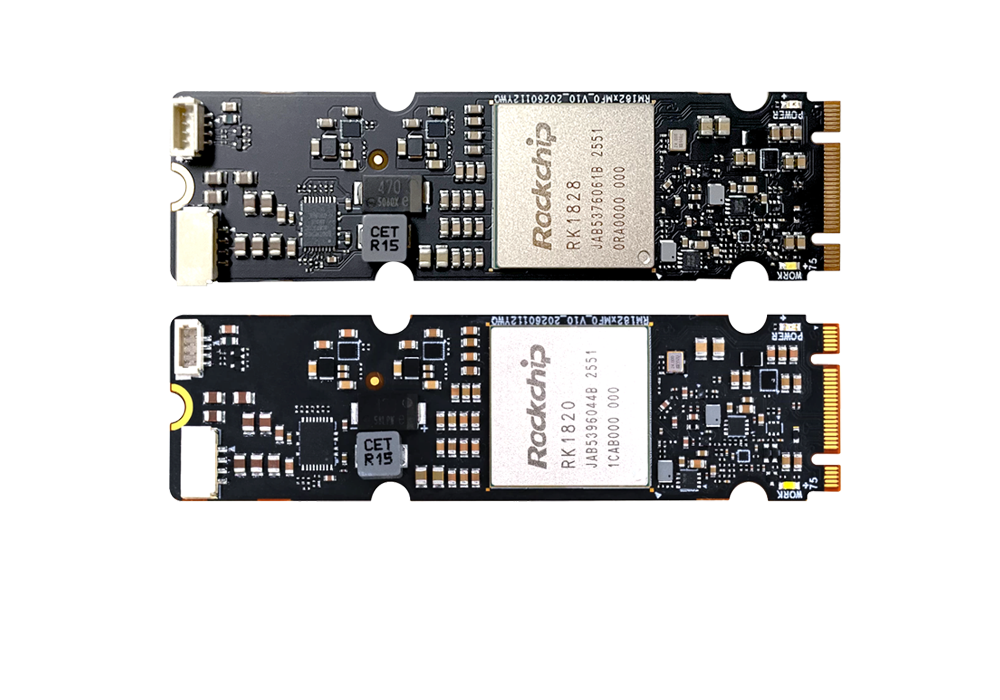


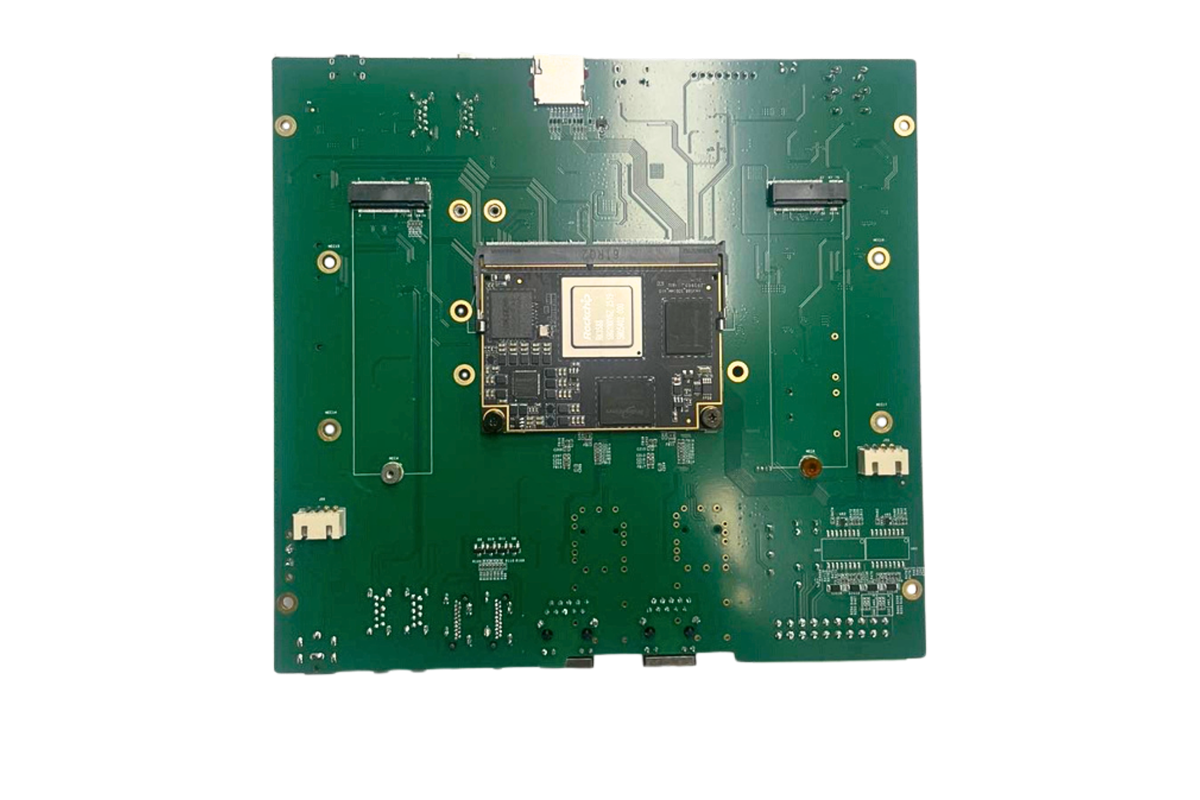
RK3588 是瑞芯微 8nm 工艺旗舰嵌入式 SoC,自研三代三核 NPU,INT8 峰值算力 6TOPS,CPU、ISP、硬编解码、NPU 高度集成,是当下工业视觉、AI 摄像头、边缘盒、智慧工地、明厨亮灶等视觉项目主流国产化边缘方案,兼顾成本、功耗与本地推理能力。
一、核心硬件规格总览
模块 | 参数说明 |
CPU | 4×Cortex A76@2.4GHz + 4×Cortex A55@1.8GHz,大小核 8 核架构 |
GPU | Mali G610 MC4,支持 Vulkan、OpenCL,支持 UI 渲染、可视化叠加 |
NPU | 三核架构,6TOPS@INT8;支持 INT4/INT8/INT16/FP16/BF16 混合运算 |
ISP | 48MP 双通道 ISP,硬件 HDR、3A、3DNR 降噪、鱼眼校正、去雾,多路摄像头接入 |
多媒体 | 8K@60fps H.265 解码、8K@30fps 编码,支持 AV1 4K 解码 |
接口 | PCIe3.0、千兆网、MIPI CSI、HDMI2.1、eDP、SATA,方便扩展存储与外设 |
系统 | Linux、Ubuntu、Debian、Android,RKNN Toolkit2 模型工具链 |
重点:6TOPS 是 INT8 量化下的峰值算力;FP16 算力大幅下降,不能直接对标 FP16 算力指标;算力上限不等于实际帧率,预处理、内存拷贝、算子兼容、带宽都会吃掉性能。
二、NPU 实测推理参考(INT8,RKNN 量化)
YOLOv5s(640×640):约 54 FPS
YOLOv8n(640×640):约 65 FPS
ResNet18 分类:约 244 FPS
MobileNetV2:约 200 FPS
人脸识别、车牌识别、人员越界:稳定 30 FPS 以上
典型负载整机功耗 5~6W,无风扇方案也可稳定运行;NPU 负责神经网络推理,CPU 只做图像采集、后处理、跟踪、业务逻辑、上报,负载隔离,多路视频流更稳。
三、边缘 AI 视觉落地优势
1. 端侧离线推理,低时延、隐私可控
图像不上云,本地完成目标检测、分割、计数、异常识别,规避网络抖动、带宽成本、数据合规风险,适合园区、工地、后厨、充电桩、工厂质检。
2. ISP+NPU 原生联动,视觉链路一体化
摄像头图像经过 ISP 硬件降噪、HDR 校正后直接送 NPU,省去 CPU 图像格式转换开销,暗光、逆光场景检测效果优于纯 CPU 方案,支持多路 MIPI 相机接入。
3. 工具链成熟,主流视觉模型友好
RKNN Toolkit2 支持 PyTorch、ONNX、TensorFlow 导出、量化、算子调试;工业视觉常用 YOLO、PP‑Seg、OCR、姿态识别都有成熟移植案例,社区开发资料丰富。
4. 国产化成本优势
对比英伟达 Jetson 系列,RK3588 开发板、核心模组价格更低,供货稳定,适合批量 AI 相机、边缘分析盒子量产。
四、必须正视的性能边界(避坑要点)
1. 算子兼容问题:不是所有 ONNX 算子都能跑 NPU,不支持算子会回退 CPU,帧率暴跌;复杂 Transformer、大 VLM 原生适配差,不适合跑大视觉语言模型。
2. 量化影响精度:INT8 量化压缩算力、提速,但校准集不合理会导致漏检、误检;高精度场景可选用 INT16/FP16,但算力会明显下滑。
3. 内存瓶颈:DDR 带宽与内存大小限制多路并发,4G 版本适合 1~2 路 4K/多路 1080P;8G 版本多路并发更从容。
4. 定位是 CNN 视觉芯片:擅长检测、分类、分割等传统 CV;不主打大模型生成式推理,跑 1B 级小 LLM 速度有限,不要当成通用大算力卡。
五、典型落地场景
工业质检:产品缺陷检测、尺寸初判、有无料检测
安防视觉:周界入侵、烟火识别、离岗、安全帽反光衣识别
智慧商农:客流统计、禽畜计数、果实分拣
车载/舱内:驾驶员状态识别、舱内监控
AI NVR、边缘分析盒子:多路视频智能分析
六、总结
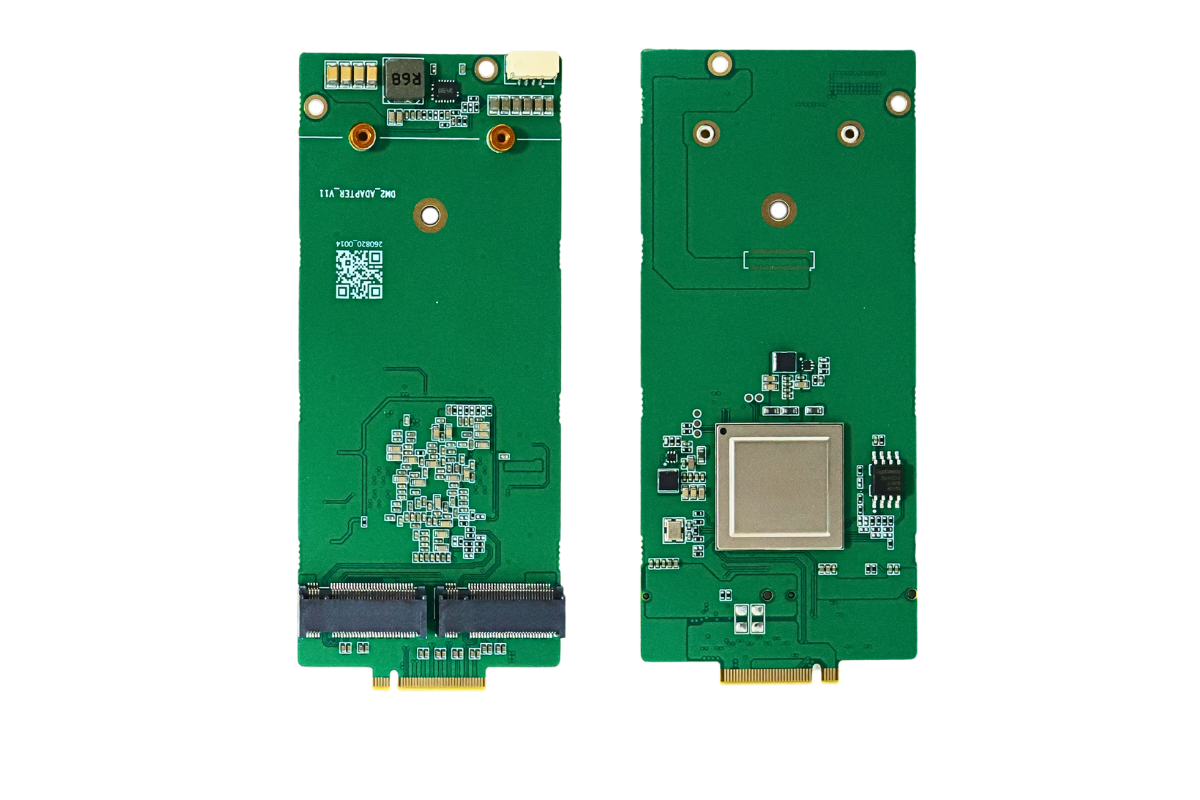
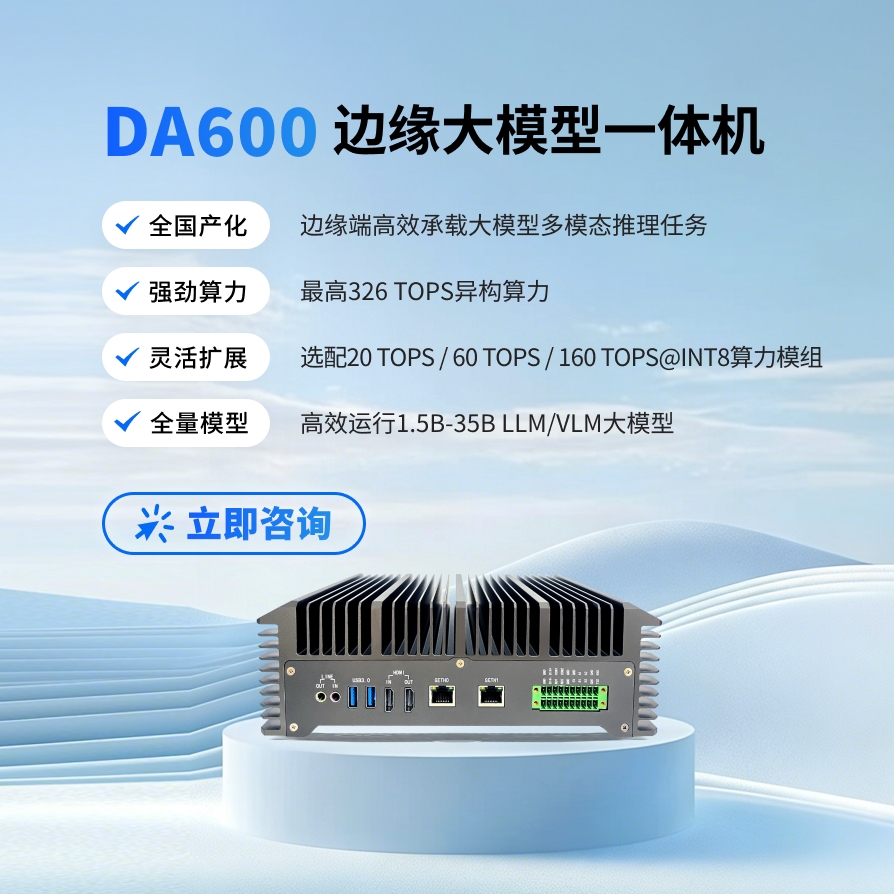
RK3588 的 6TOPS INT8 NPU,是中低路数、实时 CNN 视觉任务的高性价比国产化方案;常规单路/双路 1080P YOLO 检测完全够用;如果需要多路高并发、超大模型、VLM,就需要搭配额外 M.2 NPU 算力卡(如 LQ50、BM1684X)扩展算力。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部