
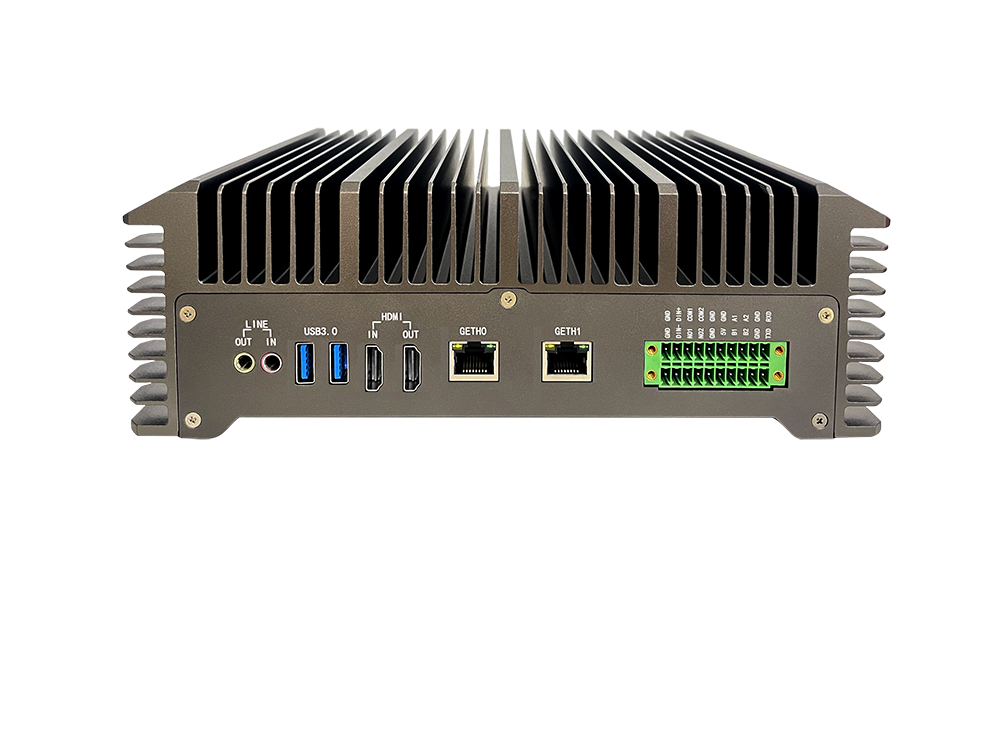
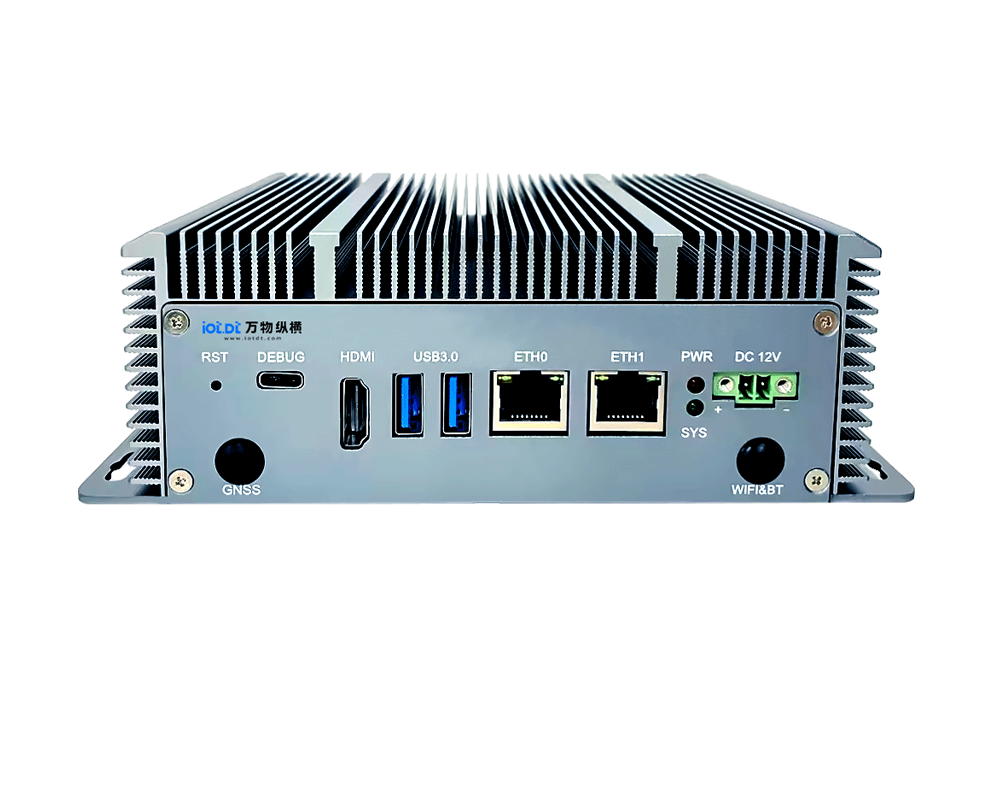
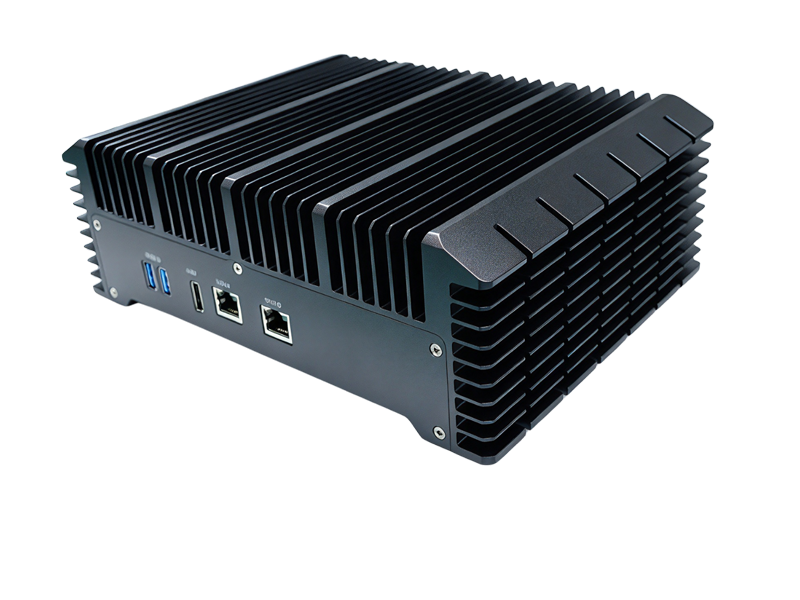
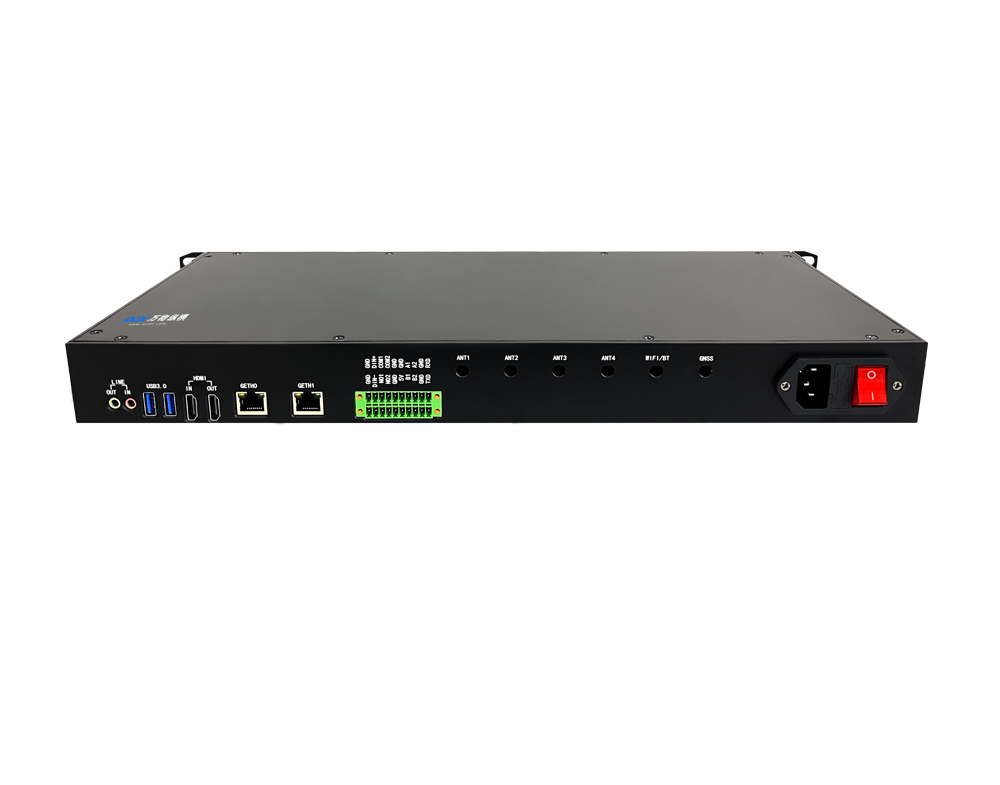
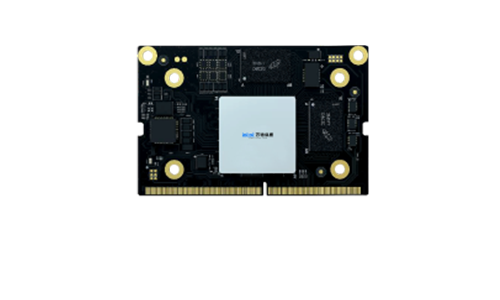
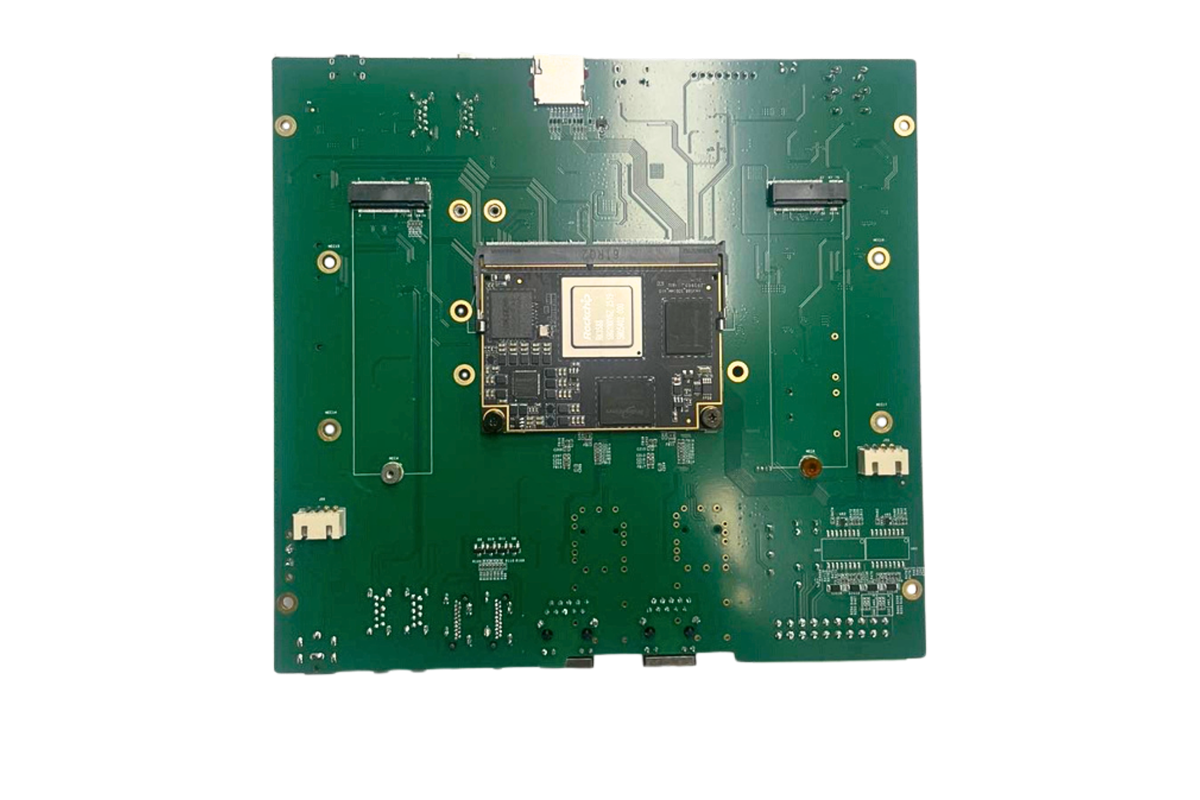


RK3588 SOM 是当下替代进口边缘算力模块(Nvidia Jetson、i.MX 高端模组等)的主流国产方案,主打国产化自主可控、异构算力、强多媒体、模块化交付,适合工业视觉、智慧安防、机器人、本地多模态推理、智能座舱等边缘端场景;但它不是"直接 pin to pin 替换",算力模型、散热、供电、软件栈是落地关键卡点。
一、核心优势(对标进口算力模组)
1. 自主可控,供应链稳定,满足信创招标
瑞芯微国产 SoC,RK3588J 工业版本可配套国产 LPDDR4、国产 eMMC,BOM 可做全国产化归档,规避断供、授权限制风险。
适配银河麒麟、统信、翼辉等国产 OS,支持国产化审计材料交付。
SOM 核心板 + 载板分离架构,B2B 连接器,不用反复重绘主控 PCB,研发迭代快,适合多型号产品复用。
2. 异构算力 + 多媒体一体化,单模块搞定"采集-推理-编解码-显示"
CPU:4×A76 + 4×A55,大小核动态调度,兼顾推理调度、业务控制、协议转发。
NPU:6TOPS@INT8,三核架构,支持 INT4/INT8/INT16/FP16/BF16 混合精度,YOLO、OCR、分类、2B/7B 量化 LLM、多模态 VLM 都可部署。
GPU:Mali-G610 MC4,支持 3D 渲染、GUI、可视化。
VPU:8K@60fps 硬解、8K@30fps 硬编码,多路 MIPI CSI、HDMI IN,多路视频结构化场景优势明显,省去额外编码卡成本。
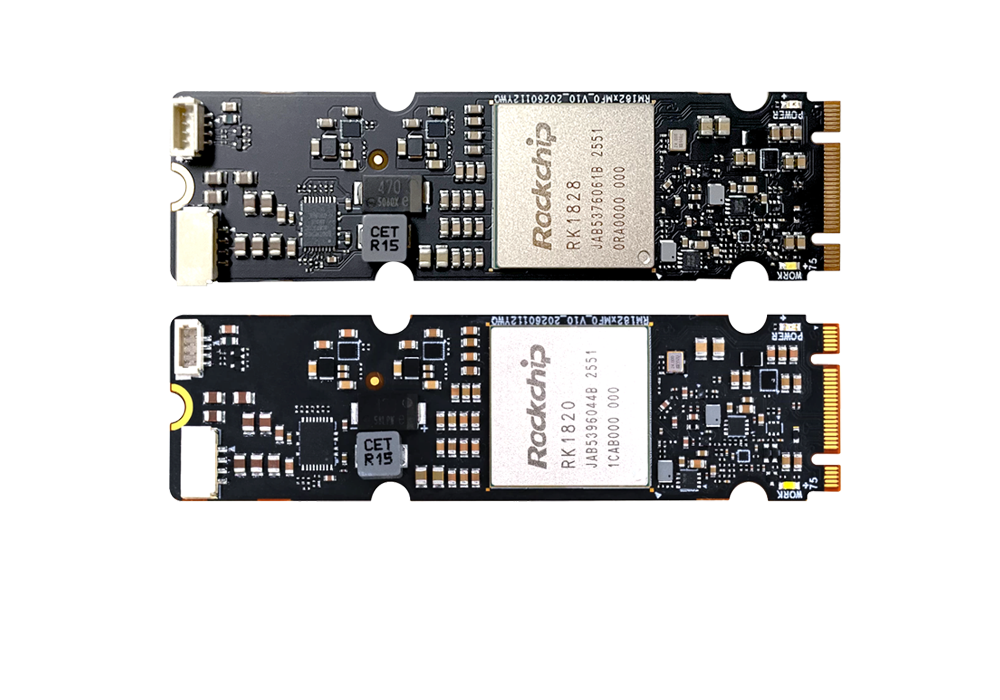
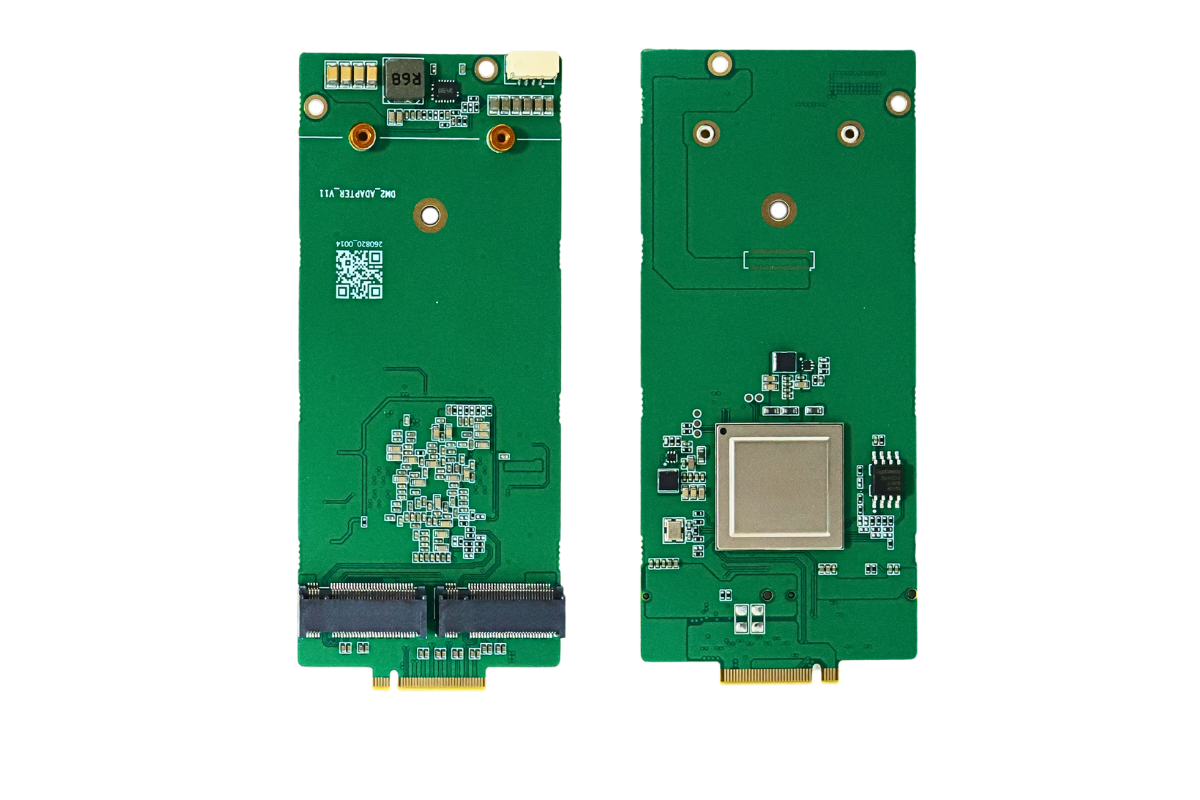
高速接口原生齐全:PCIe3.0×4、双千兆 RGMII、多路 MIPI CSI/DSI、USB3.0、SATA,可扩展 NVMe 固态、算力扩展卡(RK1828)、5G 模组。
3. 功耗与成本优势,适合 7×24 边缘终端
待机约 2.4W,常规 AI 推理负载约 7W,满载最高约 10W;对比同算力进口模组,整机功耗更低、BOM 成本显著下降。
支持无风扇散热设计(工况受限)。
供货周期可控,方案商配套成熟,国内技术支持响应快,适合批量工控、安防、机器人项目。
4. 软件生态成熟,工具链完善
官方 RKNN Toolkit、RKLLM 大模型推理库,支持 PyTorch/ONNX 模型转 rknn;配套 Debian、Ubuntu、Android、ROS2,大量开源 Demo、模型 Zoo,视觉算法迁移门槛持续降低。
二、边界短板(选型前必须看清,避免盲目替换)
1. NPU 生态和算子完备度弱于 Jetson:复杂算子、自定义算子、部分大模型需要二次适配、量化调优;CUDA 生态完全不兼容,原有 CUDA 代码必须重构、转 rknn,这是进口替换最大工作量。
2. 持续满载散热压力大:多路视频 + NPU 长时间跑满,极易降频,导致推理帧率跳水;密闭机柜、高温车间场景散热是必做专项设计。
3. 工业版本区分:普通 RK3588 商用版温区窄;工业 RK3588J 才支持宽温(-40~85℃),选型时不要拿消费级核心板直接上工业项目。
4. PCIe 带宽、并发上限有限:不适合超高并发、多卡集群、云端大算力场景;定位是边缘端单节点算力,不是服务器级算力。
三、项目落地关键要点(从选型 → 样机 → 量产)
阶段 1:需求评估与选型(替换进口第一步)
1. 算力摸底:统计同时视频路数、模型大小、推理帧率、精度要求。6TOPS INT8 适合多路 YOLO、轻量多模态;如果需要更高算力,预留 RK1828 算力卡 PCIe 扩展方案。
2. 版本区分:商用版 / 工业 RK3588J / 车规 RK3588M;确认温区、振动、EMC、防腐蚀要求,工业项目优先选工业级 SOM。
3. 对标原进口模块:不要直接对标算力数字,重点评估算子兼容性、视频通道、实时性、长期稳定性,先做 POC 对比测试。
阶段 2:硬件设计(最容易踩坑)
供电设计:RK3588 瞬时峰值电流大,DDR 电源要求高;推荐工业宽压 9~36V 输入,相机、5G、SSD 独立供电,增加 TVS、防反接、滤波;DDR 走线严格按官方参考,保证纹波、阻抗,避免偶发重启、死机。
散热专项设计:
平均负载 < 5W、通风良好:可被动散热(金属外壳 + 导热垫)。
多路视频、持续 NPU 满载、密闭机箱:必须主动散热 + 分区导热。
软件配合:做温控策略,限制 NPU、A76 最高频率,业务错峰调度,避免持续满载。
载板设计:SOM 只负责核心算力,载板做隔离、ESD、RS485/RS232、继电器等工业接口;B2B 连接器选型加固,振动场景增加锁扣。
存储:eMMC 做磨损均衡,7×24 设备减少高频随机写入,开启硬件看门狗,防止卡死。
阶段 3:软件与模型迁移(进口替换核心工作量)
1. 模型迁移流程:PyTorch → ONNX → RKNN Toolkit 量化、校准 → 部署;FP16 模型通常需要 INT8 量化,精度损失提前做回归测试。
2. 原有 CUDA 代码不能直接跑,需要重构:推理部分迁移到 RKNN/RKLLM,预处理、后处理用 OpenCV、RK Media 库硬件加速。
3. 系统裁剪:量产去掉桌面组件,精简内核;固定内核版本、固件版本,避免 SDK 版本漂移带来的兼容性 bug。
4. 实时性需求:A55 小核做采集、通信、控制;A76 + NPU 跑推理,核隔离、任务绑核,避免抢占。
阶段 4:可靠性、量产验证
必过测试:高低温循环、老化 7×24h、振动、静电 ESD、电源波动测试。
版本锁死:核心板厂商固件、RKNN SDK、内核版本统一归档,量产不随意升级。
供应链确认:锁定 SOM 供货、LPDDR/eMMC 国产物料交期,避免断料。
四、适合 / 不适合替换场景
判定 | 典型场景 |
✅ 适合 | 工业视觉缺陷检测、智能摄像头、机器人小脑、本地离线大模型、智慧工地、车载边缘、商显 AI 盒子、内网私有化边缘设备。 |
❌ 不适合 | 依赖 CUDA 生态、超大模型推理、多卡高并发训练、对算子完整性要求极高的科研场景。 |
五、快速落地建议
优先先用成熟 SOM 开发板做 POC,把原有业务模型跑通、测精度和帧率,确认算子无卡点;再基于厂商提供的参考原理图做载板定制,同步散热、供电仿真;最后再做可靠性和 EMC 认证,不要直接投产。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部