
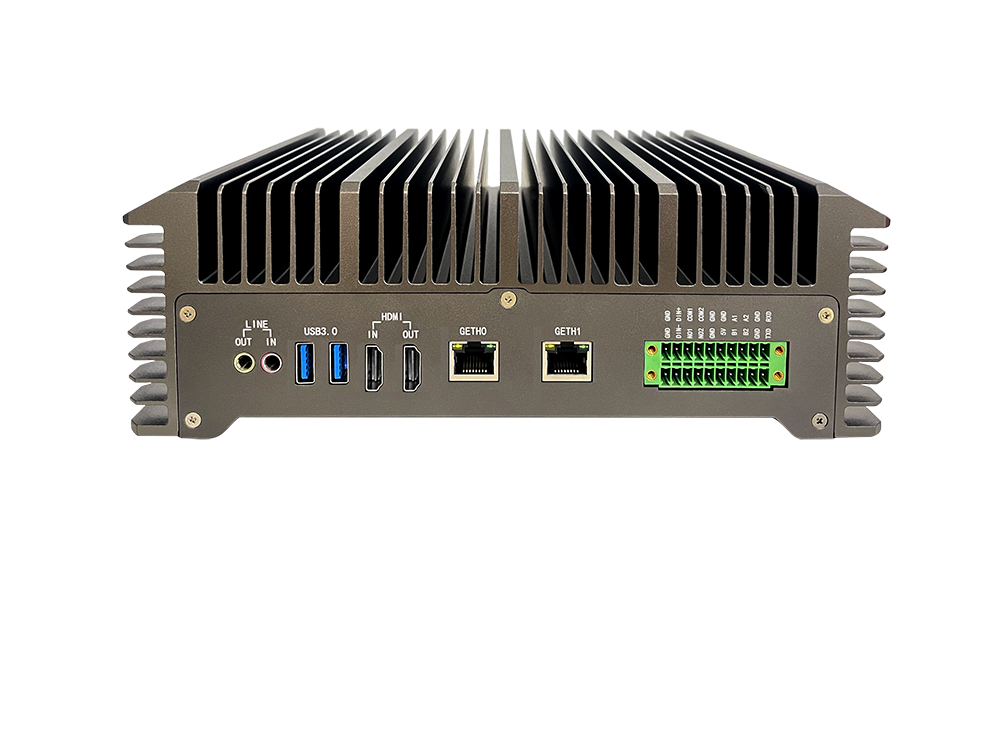
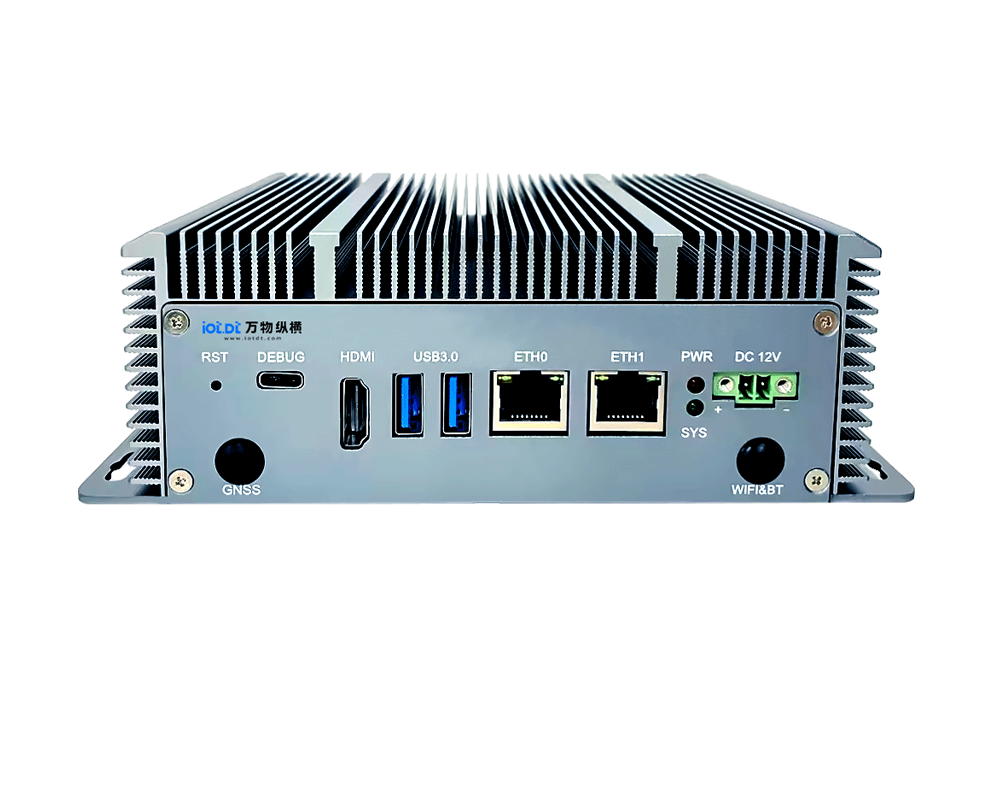
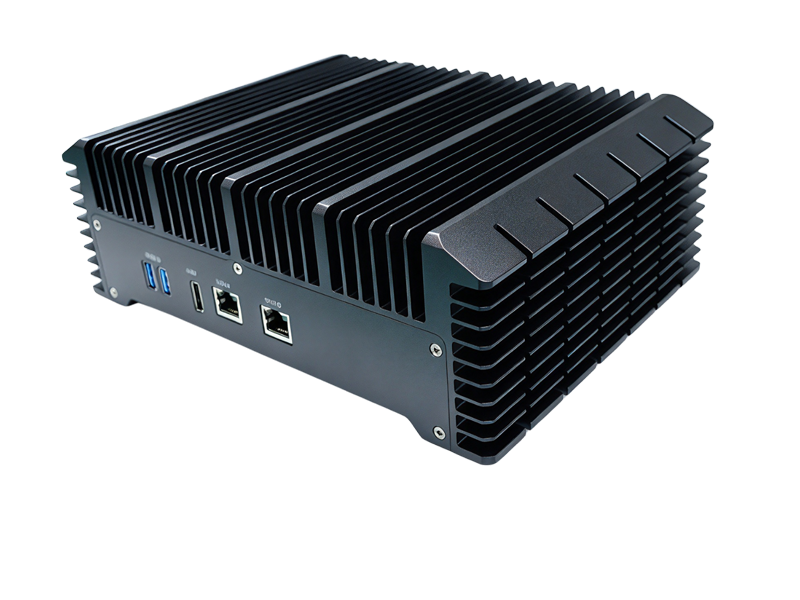
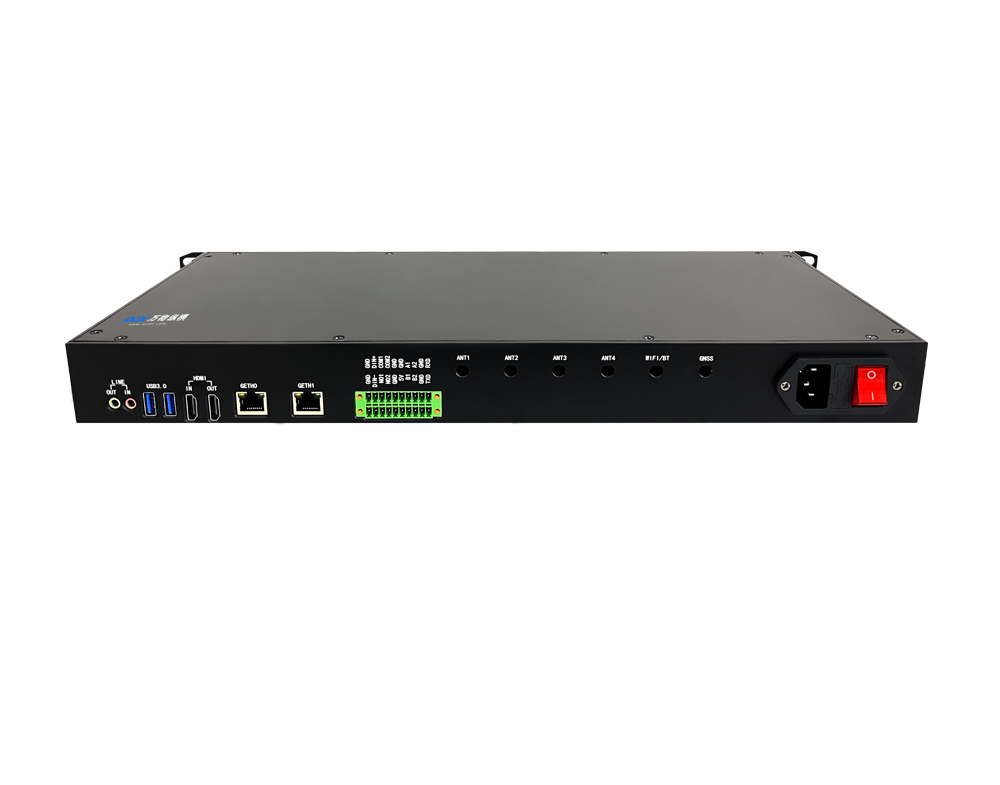
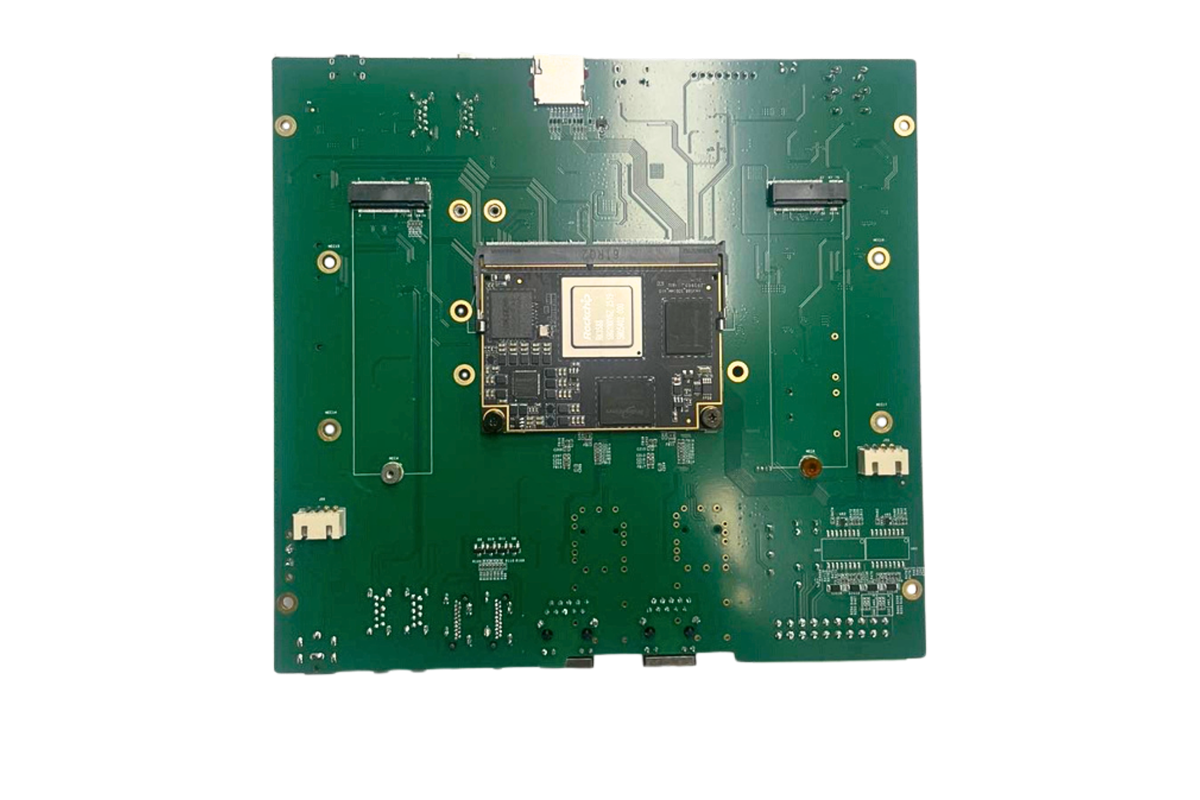
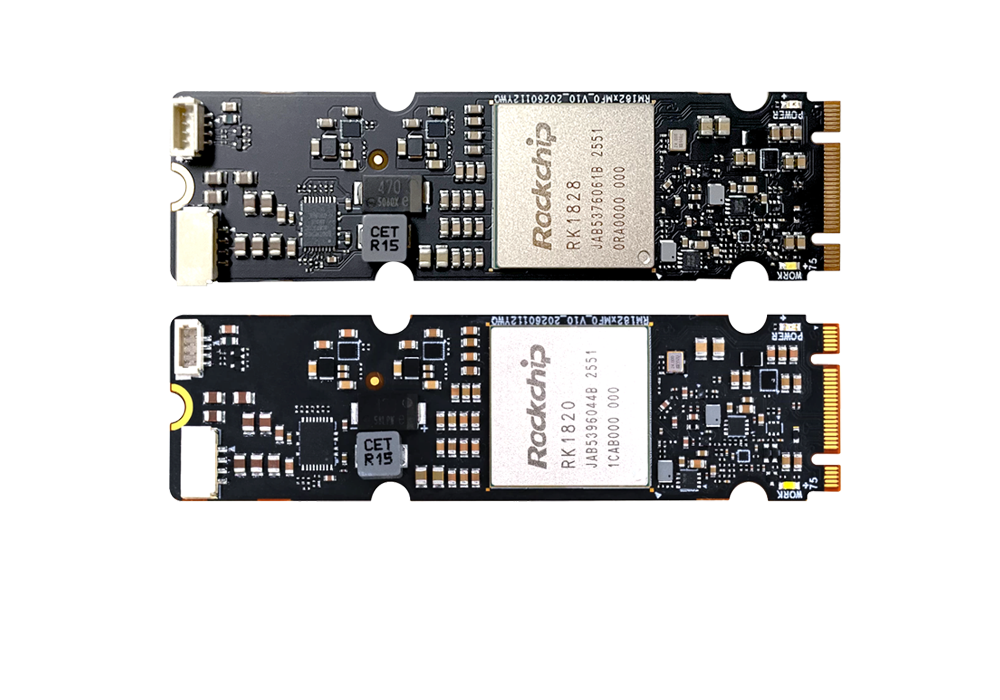
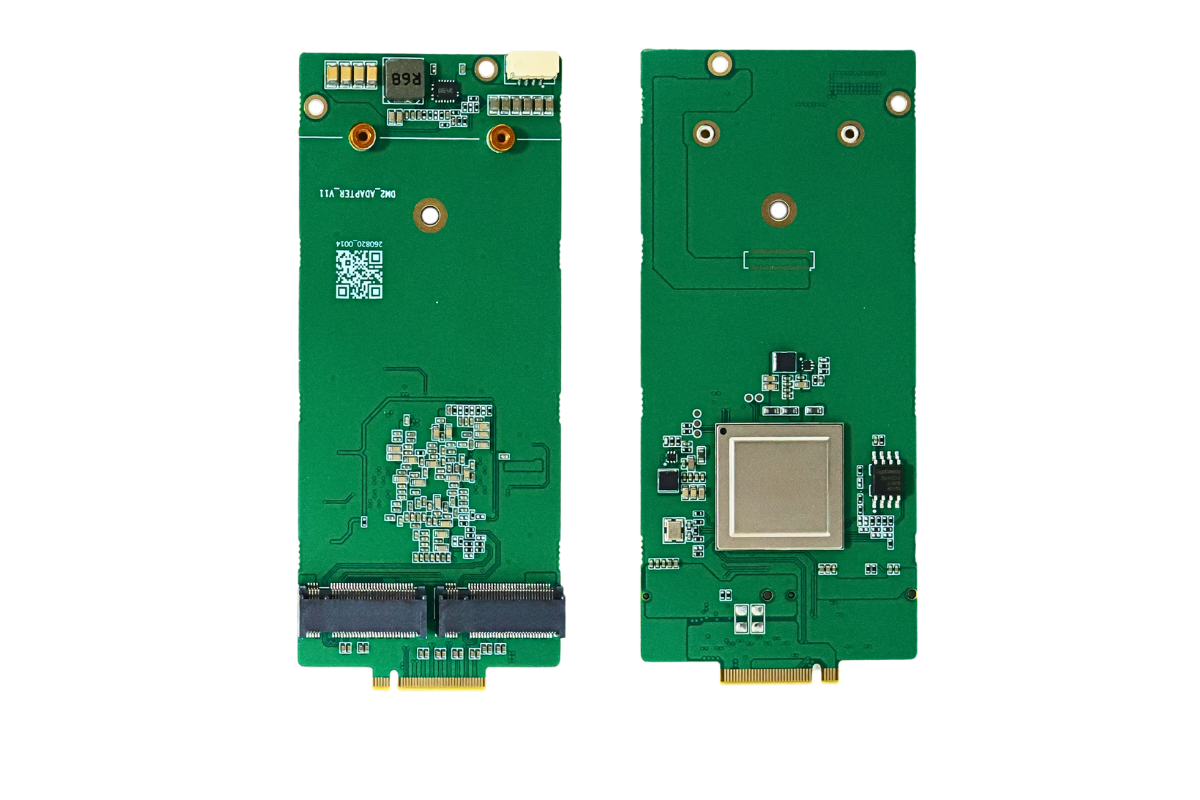


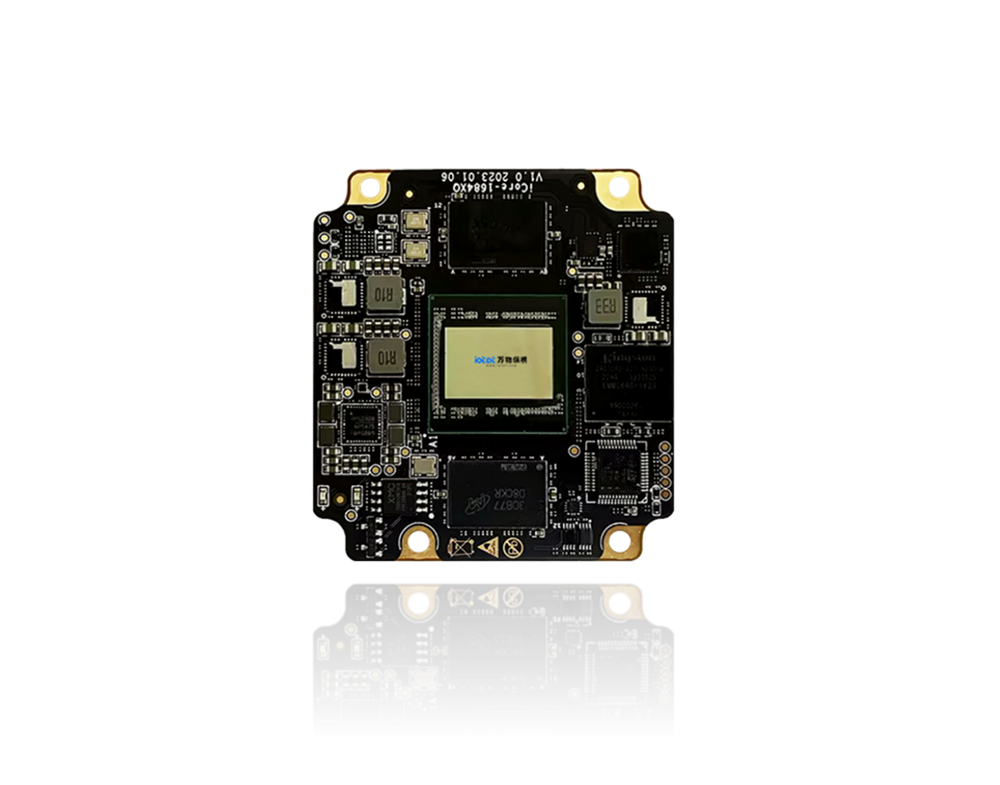
BM1684X:INT8 32TOPS,12nm工艺,8核A53@2.3GHz,核心板标配最大16GB LPDDR4x,支持Sophon SDK原生编译 + TPU-MLIR开源编译器,精度覆盖INT8/FP16/BF16/INT4(AWQ/GPTQ),擅长边缘视觉+轻量LLM多模态融合,在安防、工业质检、本地Agent、明厨亮灶、低空小场景等领域非常适配。
结论:YOLO全系列原生好跑、帧率很高;Qwen优先2B/4B/7B量化版,14B勉强跑、70B+无法落地。
一、BM1684X支持的模型清单
1.1 大语言模型(LLM)
Qwen系列(重点):
Qwen1.5/Qwen2/Qwen2.5:0.5B、1.8B、2B、4B、7B(INT4/INT8,主流可稳定跑)
Qwen2.5-14B:仅16GB内存版本、INT4量化可加载,token速度偏低,适合演示,不适合高并发业务
Qwen-VL / Qwen3-VL(多模态):2B/4B/7B-VL,图文问答,TPU-MLIR适配完善,适合巡检OCR+理解场景
❌ Qwen2.5-32B、72B:内存带宽不足,BM1684X不适合
其他主流LLM:ChatGLM2-6B、ChatGLM3、Llama3-8B、MiniCPM、Phi系列、Baichuan2-7B,同样需要INT4/INT8量化。
1.2 YOLO目标检测系列(边缘主力)
YOLOv5、YOLOv7、YOLOv8(detect/pose/seg/obb)、YOLOv9、YOLO10、YOLO11、YOLO12、YOLO26,全部支持PTQ量化导出bmodel;INT8是业务首选,NMS、后处理可以TPU加速或者ARM侧处理。
优势:芯片自带视频硬解码,支持32路1080P,YOLO可以多路并行分析,是BM1684X最成熟的应用场景。
1.3 其他配套可用模型
SAM、Grounding DINO、PP-OCR、Whisper语音、Stable Diffusion轻量化版本、ByteTrack/DeepSORT跟踪、ResNet、MobileNet等分类分割模型。
二、Qwen在BM1684X实测数据
测试条件:16GB核心板,TPU-MLIR,INT4 AWQ,单轮对话、贪心解码、关闭批生成,bmodel TPU加速,ARM负责token解码。
模型 | 推理速度 | 适用场景 |
Qwen2.5-2B-Instruct | 35~45 token/s | 上下文2k,非常流畅,RAG、指令小助手首选 |
Qwen2.5-7B-Instruct | 18~25 token/s | 上下文2k,工业本地问答、设备运维Agent主流方案 |
Qwen2.5-14B-Instruct INT4 | 7~12 token/s | 加载慢、内存吃满,只适合低频次交互,不适合持续调用 |
Qwen2.5-7B-VL多模态 | 12~18 token/s | 图文输入,图片编码+LLM串行推理,适合拍照质检、看板识别 |
2.1 部署坑点提醒
1. BF16原生7B权重13GB+,16GB板卡直接OOM,必须INT4量化;
2. 长上下文(8k+)会大量占用KV Cache,速度断崖下跌;
3. Sophon原生SDK LLM demo支持度不如TPU-MLIR社区新模型跟进快,新Qwen版本优先TPU-MLIR编译。
三、YOLO部署实测
测试条件:640×640输入,bmrt_test单batch,INT8精度。
模型 | 单帧推理耗时 | 等效FPS | 备注 |
YOLOv8s | ~3.1ms | 320+ | 纯TPU推理,不含图像预处理+NMS |
YOLOv8m | ~5.7ms | 170+ | 工业质检常用 |
YOLO12s | ~4.2ms | 230+ | 轻量化新模型,小目标表现更好 |
YOLOv8s-pose | ~3.14ms | 318 | 姿态检测,工地、人体行为分析 |
真实业务帧率:带上图resize、解码、NMS、绘制后,YOLOv8s稳定80~120FPS;多路视频场景下可以同时跑8~16路1080P检测,非常适合智慧园区、工地。
FP16精度更高,速度约INT8的一半;FP32不推荐边缘使用,速度很慢。
3.1 YOLO部署踩坑
1. 导出ONNX需要去掉后处理,NMS尽量放到TPU侧算子加速,ARM NMS会拖慢整体链路;
2. YOLO12等新模型部分自定义算子,Sophon SDK算子库不全,优先TPU-MLIR;
3. 多路并发时,瓶颈经常是内存带宽、硬解码通道,不是TPU算力。
四、部署两条路线对比
对比维度 | 算能官方Sophon SDK(bmodel) | 开源TPU-MLIR |
优势 | 文档完善、官方demo、稳定,适合YOLO、传统CV;商业项目技术支持 | 紧跟HuggingFace,Qwen3、YOLO12、多模态更新快,支持AWQ/GPTQ INT4,社区活跃 |
劣势 | LLM新模型跟进慢,Qwen新版本适配滞后,量化方案选择少 | 上手门槛高,部分冷门算子需要手写实现,商业技术支持弱 |
五、业务选型建议
1. 纯视觉项目(检测、分割、多路视频):闭眼选YOLOv8/YOLO12 INT8,Sophon SDK开发最快;
2. 需要本地LLM对话、RAG、设备Agent:优先 Qwen2.5-7B INT4(16GB板卡);追求高吞吐选Qwen2.5-2B;
3. 图文一体场景(拍照识别+理解):Qwen2.5-VL 7B量化;
4. 8GB内存版本核心板:只能跑2B及以下Qwen,YOLO不受内存限制。
六、对比参考:BM1684X vs BM1688
BM1688算力更低,主打超低功耗;BM1684X内存上限更高、LLM能力明显强一档,是边缘端视觉+小LLM融合的高性价比方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部