
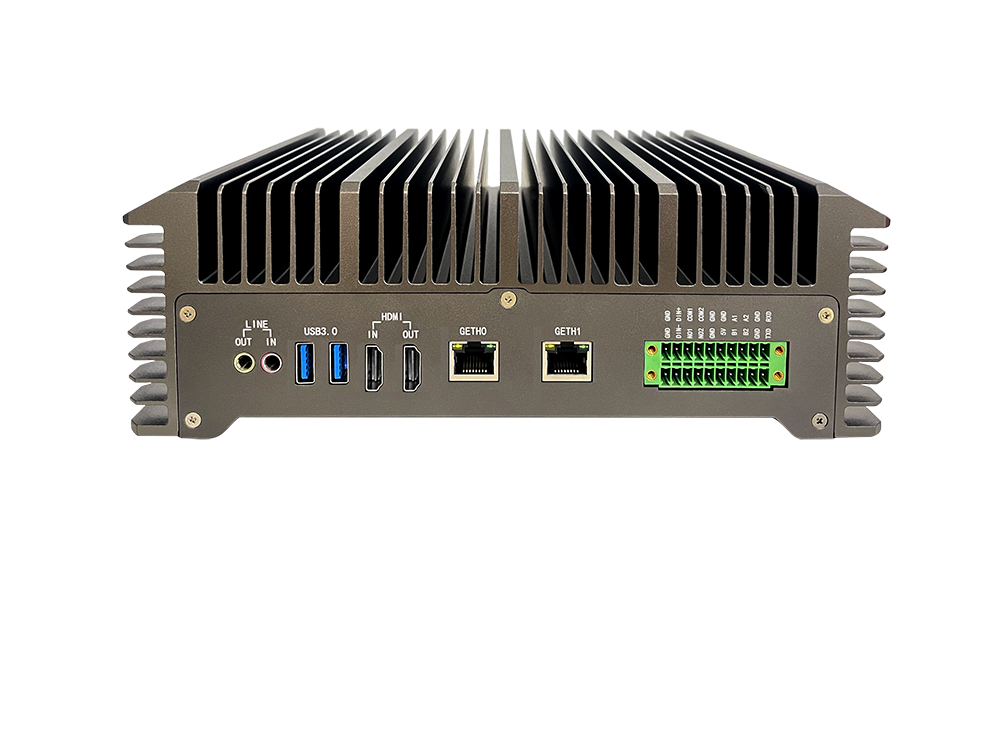
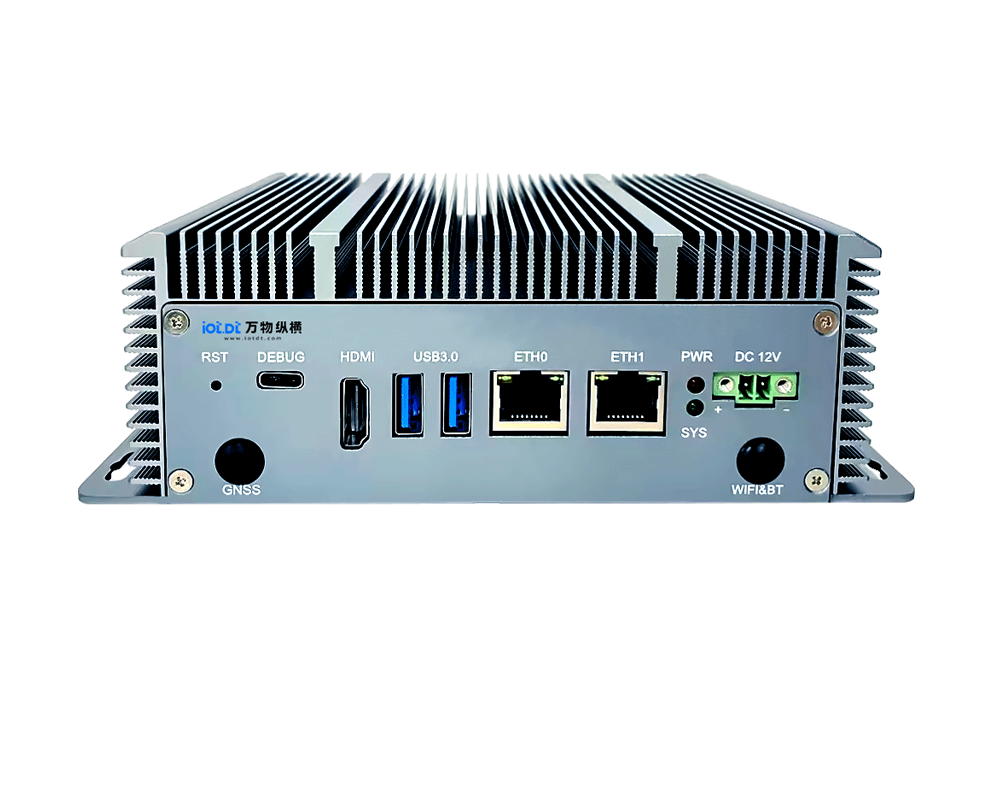
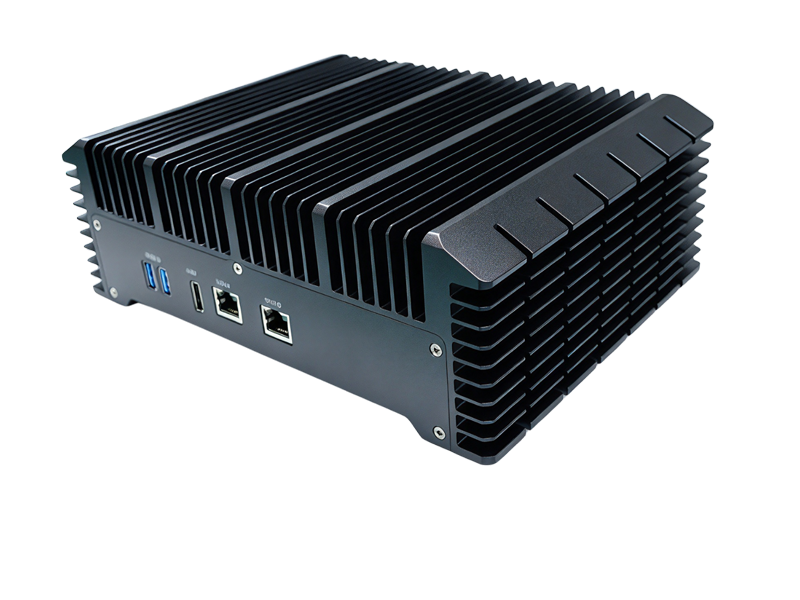
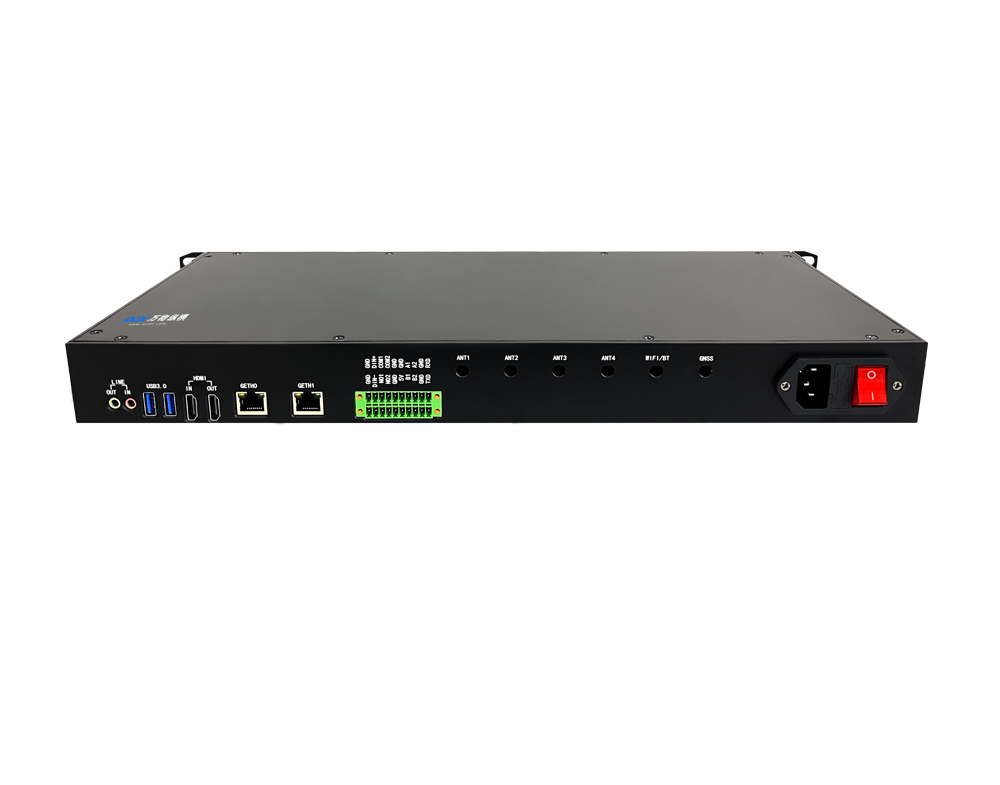
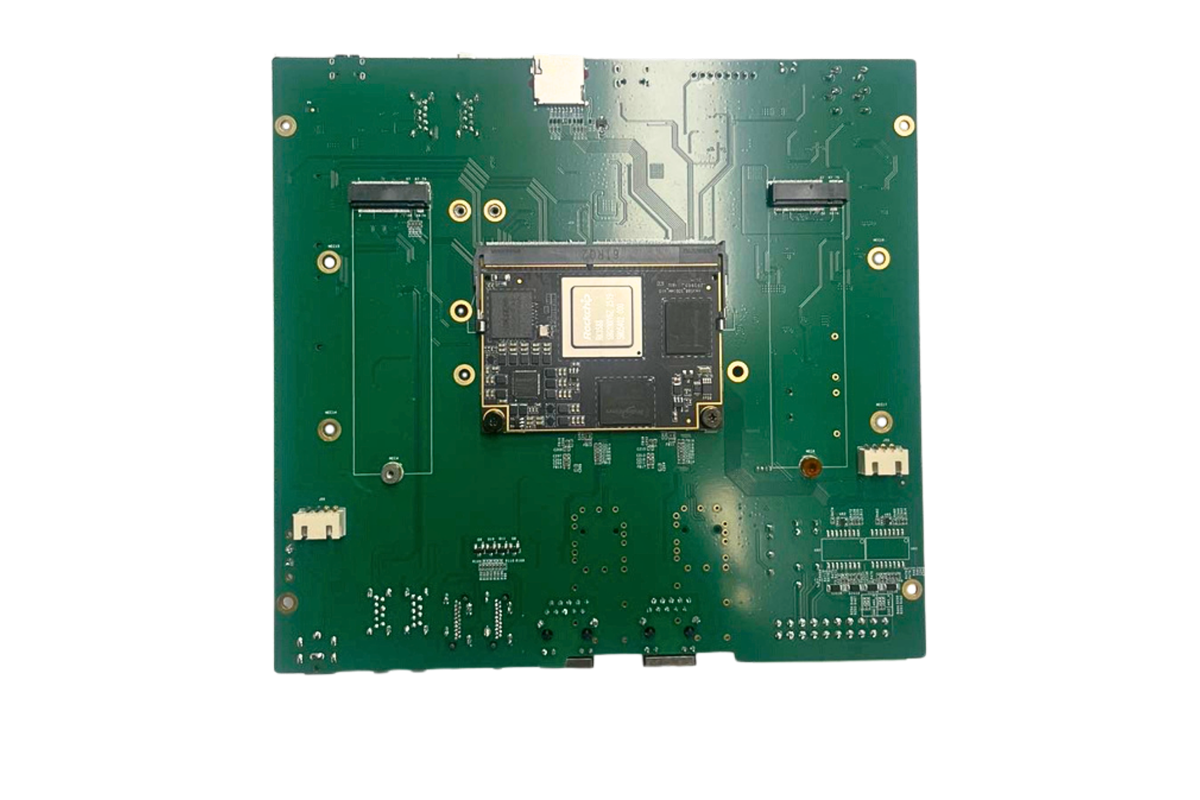
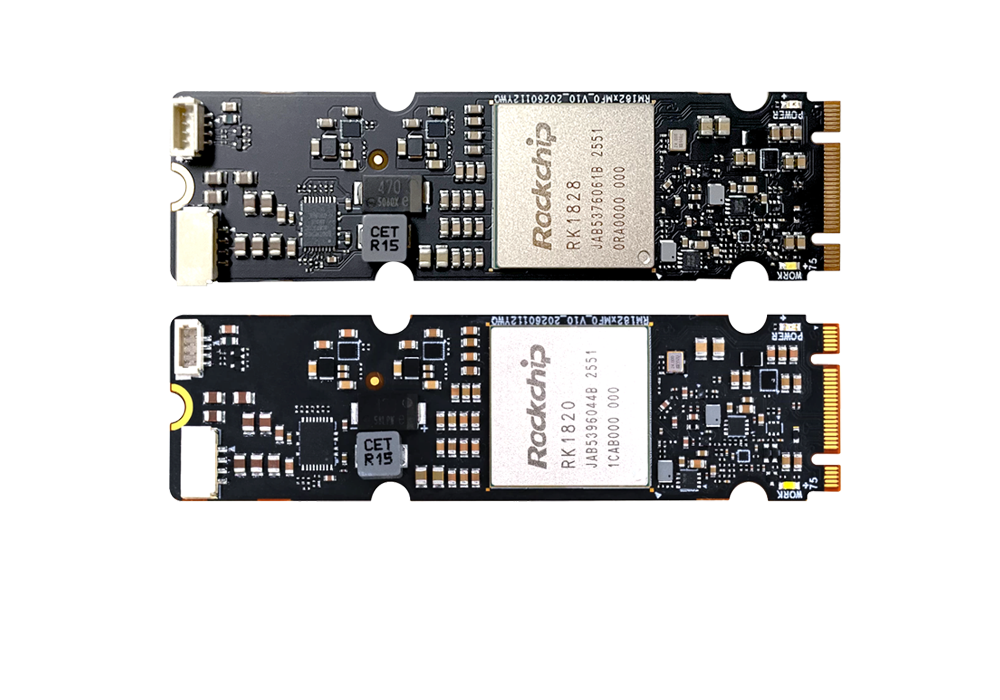
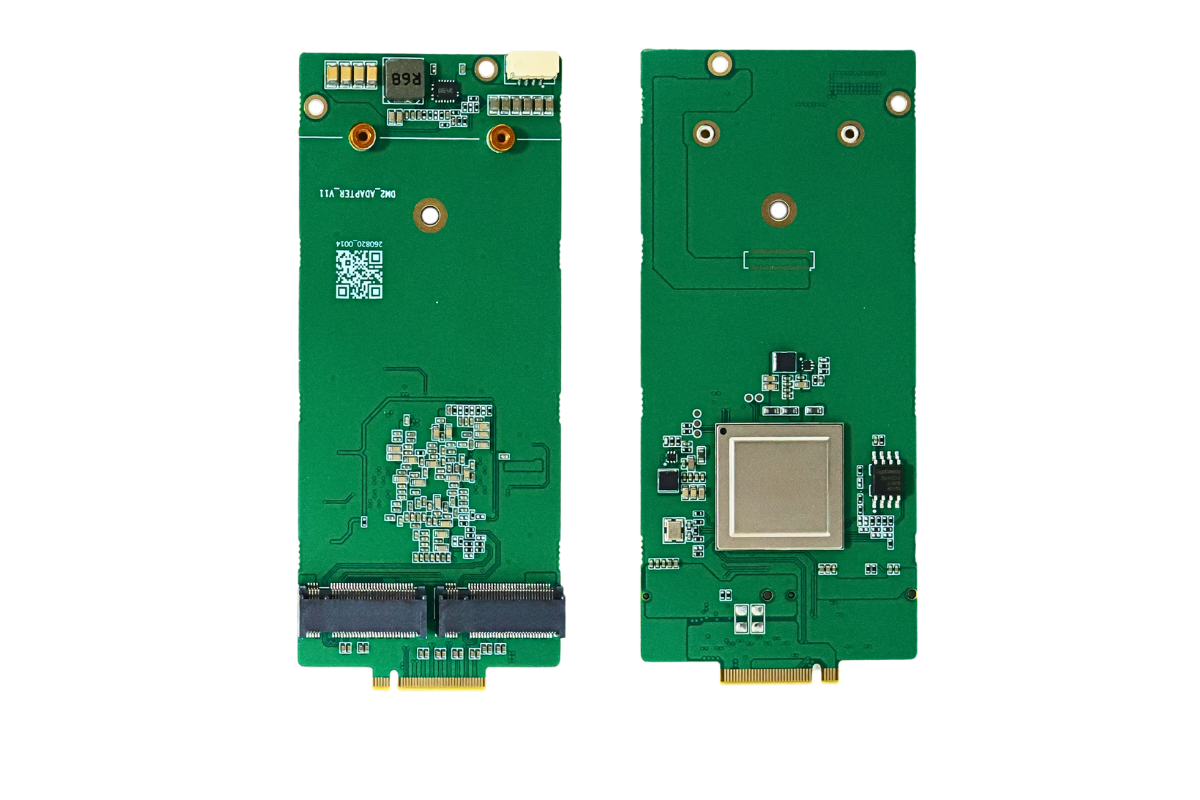


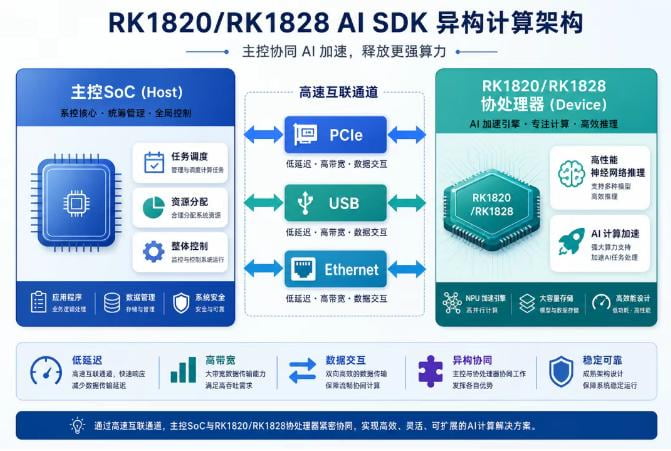
RK3576 主控(6 TOPS)负责业务调度、视频采集、前处理、显示、外设;RK1828 是独立协 NPU(20 TOPS INT8,5 GB 片内 3D 堆叠 DRAM、1 TB/s 带宽),专门承接 LLM/VLM 大模型重推理。二者算力隔离、分工异构,不是简单叠加 NPU 池。RK3576 原生 RKNN2 与 RK1828 的 RKNN3 是两套独立工具链,不能混用是最大坑点。
一、什么时候适合上 RK1828?(先判断,不要盲目加卡)
RK3576 自带 NPU 6 TOPS,适合:YOLO、检测、分类、轻量 OCR、小 embedding、简单时序模型。出现下面情况,才是典型算力/内存墙瓶颈:
1. 跑 3B 及以上 LLM、VLM 多模态,内存爆、TPS 很低、TTFT 长;
2. 多并发视觉+大模型一体,主控 NPU 被占满、CPU/内存带宽卡死;
3. 模型权重大、反复 swap,主控 DDR 带宽成为瓶颈(RK3576 没有片内高带宽显存);
4. 存量 RK3576 设备,不想换主控、不想重新画板、重过认证,低成本升级 AI 能力。
不适合场景:单纯跑多路 YOLO 检测,优先优化 RK3576 原生 NPU + RGA,RK1828 性价比低。
二、硬件适配要点(M.2 PCIe2.1 x1,B-M Key)
2.1 关键规格
接口:M.2 B+M Key,走 PCIe 2.1 x1;不是 NVMe,是 AI 协卡
算力:20 TOPS INT8;支持 INT4/INT8/FP8/FP16/BF16 混合精度
片内 DRAM:5 GB(RK1828),RK1820 仅 2.5 GB,跑 7B INT4 优先选 RK1828
功耗:平均约 13.6 W,峰值约 29.4 W;必须做好散热,风冷即可,工业盒要预留风道
供电:很多板卡 M.2 插槽供电不足,优先确认 12 V 供电能力,很多坑在这里
2.2 硬件检查清单
1. RK3576 主板 M.2 插槽:确认是 B-M Key、PCIe 通道开启,不是只走 SATA;
2. 内核设备树:打开 PCIe 控制器、复位脚、供电控制;
3. 散热:RK1828 发热明显,不要裸卡闷在密闭壳子里;
4. 布线:PCIe 差分阻抗、参考时钟,长走线容易丢包、断链接;
5. 多卡:RK3576 一般只适合单卡;多卡扩展需要主板多路 PCIe,不推荐 RK3576 做多卡集群。
架构逻辑:PCIe 只是通道,RK1828 有独立固件、独立运行时,不是 RK3576 的 NPU 扩展核。模型跑在 RK1828 片内 DRAM,不占用 RK3576 的 DDR,这是它解决内存墙的核心优势。
三、软件栈核心区分(重中之重,很多人踩坑)
项目 | RK3576 原生 NPU | RK1828 算力卡 |
工具链 | RKNN-Toolkit2 / RKNN Lite2 | RKNN3 SDK(RKNN3 Toolkit、rkllm3 runtime) |
模型格式 | .rknn v2 | .rknn3 / rkllm 格式 |
驱动 | 内核 rknpu2 驱动 | 独立 rk182x PCIe 驱动 + 板端固件 + rkllm3 service |
系统 | Linux / Android | Linux / Android,镜像必须厂商预适配或单独装 RK182X 安装包 |
典型模型 | YOLO、CNN、轻量检测 | Qwen、MiniCPM、DeepSeek、LLaMA、VLM 多模态 |
3.1 软件部署流程
1. 镜像准备:RK3576 固件需要支持 PCIe、RK182X 驱动;不要直接拿普通 RK3576 出厂镜像插卡,大概率识别不到;优先用板厂配套适配镜像。
2. 安装 RKNN3 SDK 包:rknn3_rk182x_m2_installer_arm64.tgz,解压执行 install.sh,重启后自动加载 RK1828 固件、拉起 rkllm3 后台服务。
3. 验证命令:执行 rknn-smi,可看到 RK1828 设备、版本、温度、带宽;失败优先查 PCIe 枚举、供电、固件版本匹配。
4. 模型转换:PC 端用 RKNN3 Toolkit 导出 rkllm3 模型(INT4/INT8 量化);RKNN2 导出的 rknn 不能在 RK1828 上跑。
5. 业务分层(推荐):
RK3576:CSI 采集、RGA 图像缩放、解码、预处理、业务逻辑、Web/API、调度;
RK1828:接收预处理后图像/文本,跑 VLM/LLM 推理,返回结果给主控;
通信:PCIe 高速 DMA,rkllm3 自带 C/Python API,也支持 OpenAI 兼容 API 服务(rkllm3-server),方便上层对接。
rknn-smi
四、调度方案(两种主流工程模式)
4.1 分离调度(推荐,稳定)
视觉小模型(YOLO)跑 RK3576 原生 NPU;大模型 LLM/VLM 全部交给 RK1828。两套推理引擎独立跑,互不抢占资源,适合智慧工地、明厨亮灶、座舱、机器人。
4.2 统一服务网关(适合 Agent、多模态)
主控起调度服务,根据模型类型自动路由:小模型 → rknn2,大模型 → rkllm3;适合对话+视觉一体的 AI 盒子。
不支持:自动负载均衡、模型自动分片到 RK3576 NPU + RK1828 联合推理;瑞芯微 SDK 现阶段没有自动异构分片,分片要自己在上层业务做。
五、实测性能参考(RK3576 + RK1828)
Qwen 3B INT4:TPS 80~110 token/s
Qwen 7B INT4:可完整装入 5 GB 片内 DRAM,TPS 30~50 token/s,TTFT 可压到 300 ms 以内
VLM(图文问答):图片预处理在 RK3576 RGA,编码器+LLM 在 RK1828,避免 PCIe 反复传大图
对比:纯 RK3576 原生 NPU 跑 7B,基本跑不动,内存溢出、吞吐极低。
六、高频踩坑清单
1. 版本不匹配:RKNN3 Toolkit 版本、板端固件、rkllm3 runtime 必须对齐;固件版本低会出现识别到卡但加载模型失败。
2. PCIe 供电不足:rknn-smi 偶尔丢设备、重启消失、大模型跑起来掉卡;优先外接 12 V 给 M.2。
3. 带宽浪费:图片不做预处理直接整图传给 RK1828,PCIe 带宽被占死,延迟飙升;务必在 RK3576 侧用 RGA 做裁剪、缩放、归一化。
4. 工具链混淆:拿 RKNN2 导出的 rknn 丢给 RKNN3,直接报错。
5. 散热不足:长时间 7B 满载,温度保护降频,TPS 暴跌。
6. 内核设备树没开 PCIe 复位:上电识别不到,热插拔失败。
7. 安卓平台:权限、selinux 策略、固件加载权限,比 Linux 调试麻烦很多。
七、备选方案对比(如果你不想上 RK1828)
1. 纯软件优化:模型降参、更激进量化、RGA 预处理、多路推理队列限速;适合预算紧、只加少量并发;上限低。
2. 换更高算力主控(RK3588):一次性换板,成本高,存量设备无法复用。
3. 其他 M.2 算力卡(LQ50 等):存算一体路线,生态和 RKNN3 完全独立,需要换整套 SDK。
八、总结
RK3576 + RK1828 M.2 是存量 RK3576 设备低成本升级端侧大模型的标准方案,核心价值是把 LLM/VLM 的重推理卸载到带独立 5 GB 高带宽片内显存的协卡,绕开 RK3576 的 DDR 内存墙。
核心约束:两套独立 NPU 工具链、无自动联合分片、PCIe 供电/散热是硬件第一风险点;工程上优先做"小模型本地 NPU、大模型卸载 RK1828"的分离架构,稳定性最好。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部