
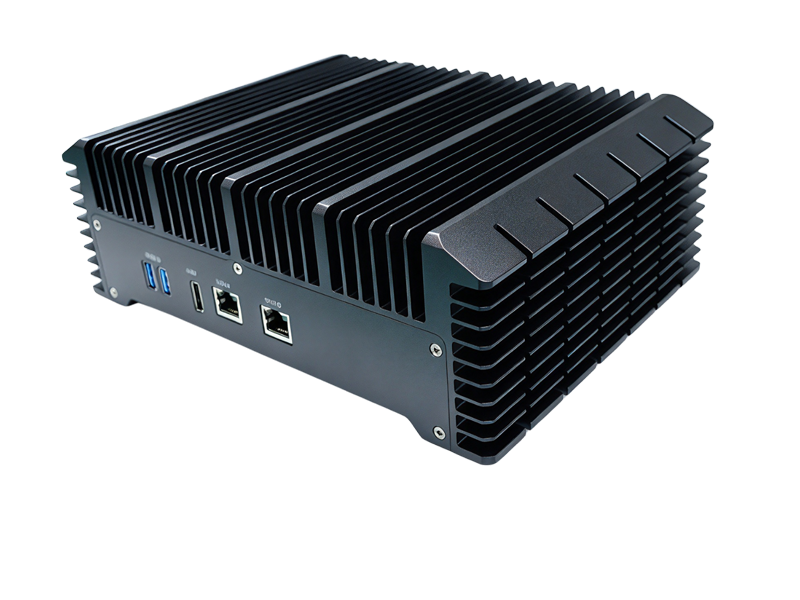
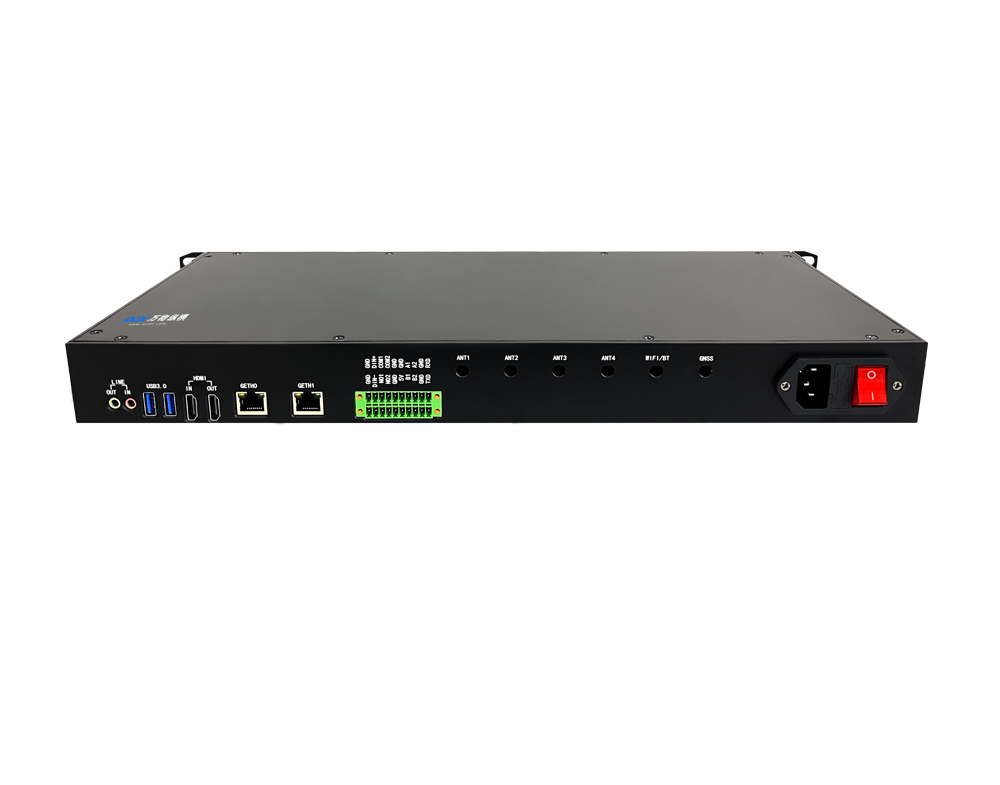
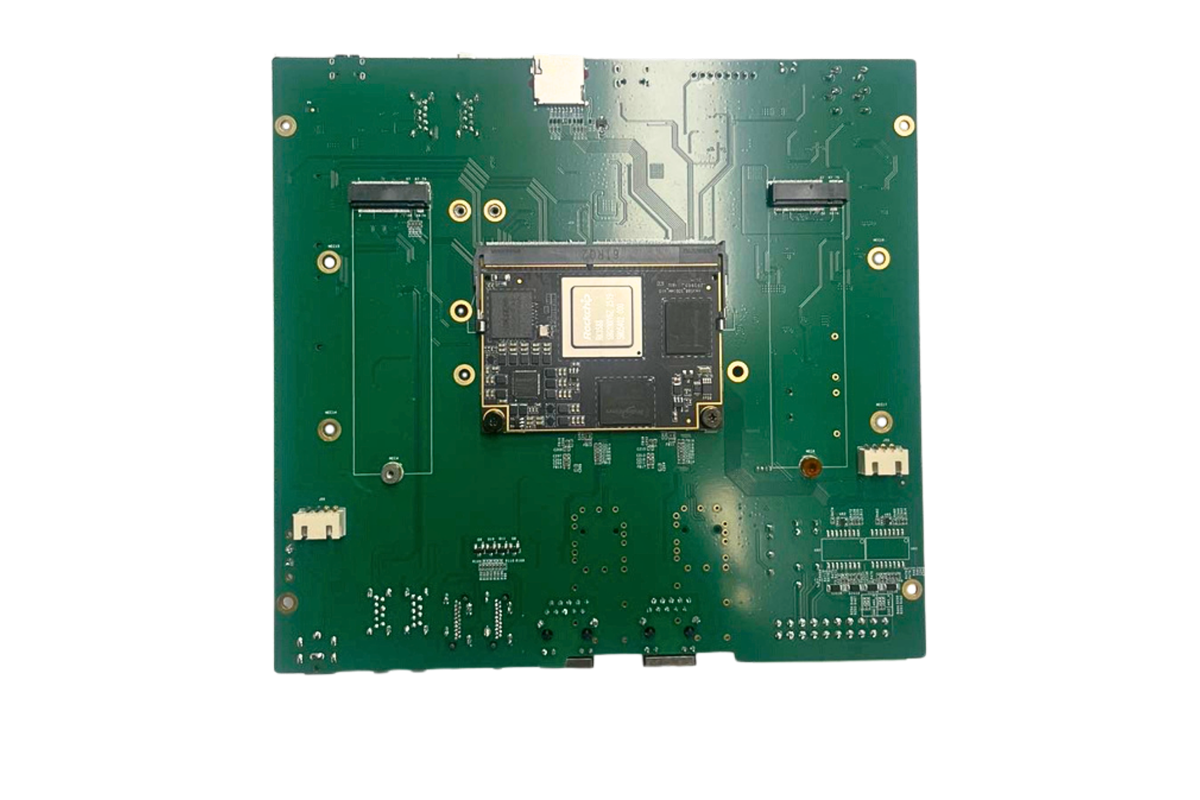


1. 算力底座:3TOPS 之外,升级集中在 AI 与视觉链路
RV1126B 是瑞芯微面向端侧与边缘侧 AI 视觉场景的 SoC,2025 年 5 月量产出货,定位是 RV1126 的全面升级版。判断这颗芯片的能力,不能只看 3TOPS 这个数字,它的 CPU 位宽、ISP 架构和接口带宽共同决定了能跑什么业务。
维度 | 参数 |
CPU | 4×Cortex-A53,最高 1.6GHz(RV1126BJ 为 1.3GHz),64 位 ARMv8-A,512KB L2,集成 NEON 与 FPU |
NPU | 3TOPS@INT8;支持 INT4 / INT8 / INT16 / FP16 / BF16 / TF32;支持 W4A16、W8A16 混合精度量化、权重稀疏化与 Transformer 优化 |
ISP | 12M ISP@30fps;另配独立的 8M AI-ISP@30fps,运行 AI-ISP 时不占用 3T NPU 资源 |
视频编解码 | 编码最高 12M@30fps 或 4K@45fps;解码 4K@30fps;H.265 / H.264 硬编硬解,支持多码流与智能编码 |
视频输入 | 2×4-lane 或 4×2-lane MIPI CSI,最多 4 路;另支持 DVP / BT.1120、SubLVDS 与 16bit 热成像输入 |
网络与外设 | 千兆 RGMII(带 TSO / USO 加速)、USB 3.0 + USB 2.0、2×CAN FD、DSMC 并口可扩展 FPGA |
安全 | 国密 SM2 / SM3 / SM4,TrustZone 安全隔离,Keyladder 密钥管理 |
尺寸 | 芯片 14×14mm;核心板常见 35×35 至 40×40mm,亦有 38×38mm 的迷你整板 |
与上一代 RV1126 相比,这次升级不是简单地把 NPU 从 2TOPS 提到 3TOPS:CPU 从 32 位 A7 换成 64 位 A53,ISP 从 5MP 提到 12MP 并新增独立 AI-ISP,摄像头输入从双路扩到 4 路,USB 从 2.0 升到 3.0,以太网从百兆升到千兆。正是这些配套能力,让它能同时承担视觉分析和轻量语义任务,而不只是多跑几个检测模型。
2. 大模型实测:2B 能跑,吞吐落在 5 tokens/s 档
飞凌嵌入式基于 RV1126B 的 OK1126B-S 开发板跑出了一组可以直接对比的实机数据:输入序列 128 token、每条生成 64 token、w8a8 量化。这组数字比"能跑 2B"的宣传语更能说明实际体验。
模型
| 参数规模 | 精度 | 首 token 延迟 | 生成吞吐(tokens/s) | 峰值内存 |
Qwen2 | 0.5B | w8a8 | 655.78ms | 14.95 | 655MB |
Qwen2 | 0.5B | fp | 381.12ms | 8.59 | 1104MB |
Qwen2.5 | 1.5B | w8a8 | 669.94ms | 5.55 | 1660MB |
DeepSeek-Distill-Qwen | 1.5B | w8a8 | 838.75ms | 5.57 | 1692.8MB |
LLaVA-OneVision-Qwen2 | 0.5B | w8a8 | 969.68ms | 14.89 | 619MB |
Qwen2-VL | 2B | w8a8 | 692.73ms | 5.14 | 16360MB |
第一层结论是参数规模直接决定可用性。0.5B 级模型能跑到 15 tokens/s,按中文约 1.5 至 2 token 一个字折算,每秒输出 8 至 10 个汉字,短指令响应和多轮轻交互的感受接近正常;一旦上到 1.5B 至 2B,吞吐掉到 5 tokens/s 上下,写满 64 token 需要 12 秒左右,用户会明显感到"在等它说"。首 token 延迟反而差别不大,都在 0.4 到 1 秒之间,说明瓶颈不在 prefill,而在逐 token 生成的算力密度。
第二层结论更值得注意:2B 多模态的内存开销是硬门槛。同一组测试里,Qwen2-VL-2B 的峰值内存达到 16360MB,而多数 RV1126B 整机配的是 1GB、2GB 或 4GB 板载内存。也就是说,"支持 2B 多模态"在算力上成立,但在多数实际配置上装不下。规划产品时,2B 多模态只应出现在 8GB 及以上内存的定制机型里,且要预留系统与视觉链路的占用。
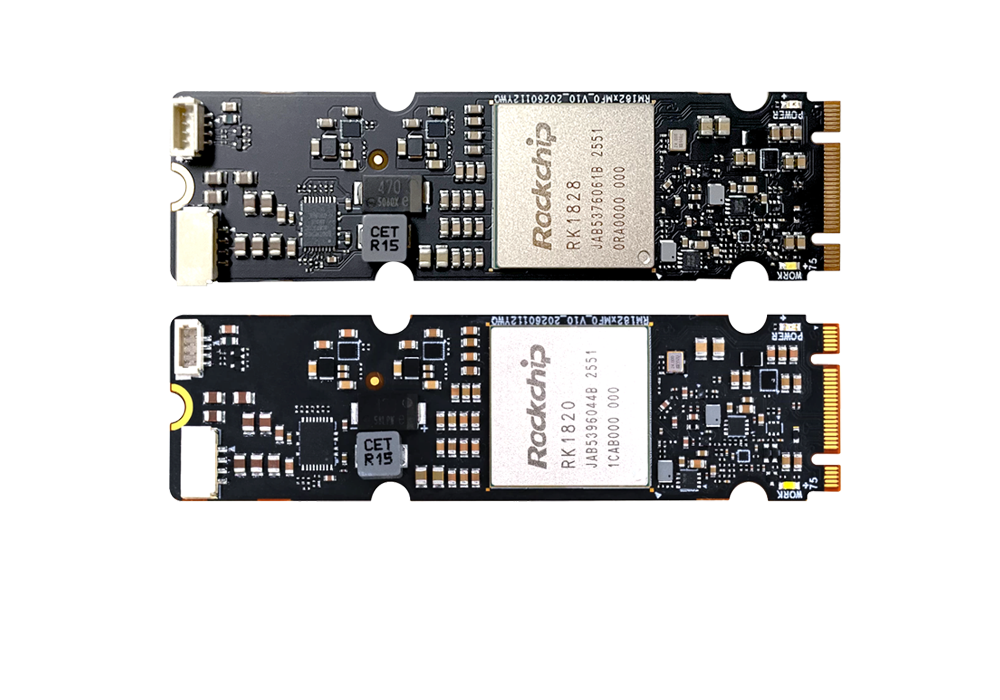
顺带需要区分一个容易混淆的口径:业界常引用的"7B 模型 50+ tokens/s、首帧 160ms"属于瑞芯微 RK182X 系列协处理器的成绩(RK1828 跑 Qwen2.5-7B),那是通过 PCIe 与主 SoC 协同、内置高带宽 DRAM 的另一档方案。RV1126B 没有这个带宽条件,不能用同一组速率数据做参照。
3. 视觉推理:目标检测提升最高约 2.5 倍,才是这颗芯片的主场
把大模型放在一边,RV1126B 相对上一代的真实提升主要体现在 CNN 类视觉模型上。同样的 INT8 精度、同样的 640×640 输入,帧率对比如下。
模型 | 输入尺寸 | RV1126 帧率 | RV1126B 帧率 |
yolov8n | 640×640 | 35.4 | 50.24 |
yolov8s | 640×640 | 13.1 | 25.96 |
yolov8m | 640×640 | 5.8 | 11.8 |
yolo11n | 640×640 | 17 | 42.84 |
yolo11s | 640×640 | 7.3 | 23.72 |
RetinaFace_mobile | 320×320 | 212.5 | 295.26 |
模型越大,提升越明显:yolo11s 从 7.3 帧到 23.72 帧、yolov8m 从 5.8 帧到 11.8 帧,都是两三倍的量级;小模型因为本身受调度与前后处理开销牵制,提升幅度收敛在 1.4 倍左右。换算成业务能力,单路 1080P 视频跑 640×640 的 yolov8s,25 帧已能满足实时分析;跑 yolov8m 也有 11 帧以上的余量用于多路轮询。
这也解释了为什么它的典型场景是"视觉为主、语义为辅":4 路摄像头输入、12M ISP 加 8M AI-ISP,配合 50 帧级的轻量检测,能在本地闭环完成人形、安全帽、烟火、区域入侵这类判定;语义理解交给 0.5B 级模型做短描述,或按端云协同交给云端。
4. 功耗与散热:整机空载 1.2–1.8W,无风扇可长期运行
低功耗是这颗芯片在边缘盒子里的另一项硬指标。不同厂商的核心板与整机配置差异较大,下表按测试条件分开列出,避免把核心板数字和整机数字混用。
平台 | 测试条件 | 功耗 |
飞凌 FET1126B-S 核心板 | 无负载待机 / CPU 四核满载 | 0.505W / 1.51W |
飞凌 OK1126B-S 开发板 | 无负载待机 / CPU 四核满载 | 1.27W / 2.24W |
飞凌 OK1126B-S 开发板 | CPU、内存、eMMC 三压并发 | 2.635W |
飞凌 OK1126B-S 开发板 | 摄像头 + 7 寸屏 + 播放视频 | 4.66W |
创龙 TL1126-EVM 评估板 | 空载 / CPU 四核满载 | 1.80W / 2.76W |
Firefly AIO-1126BJD4 | 典型 / 最大 / 休眠 | 3.6W / 7.2W / 0.84W |
AOV 值守模式 | 摄像头休眠,核心板保持值守 | 约 0.007W |
取中位水平,不带屏的整机空载在 1.2 至 1.8W,CPU 满载 2.2 至 2.8W,带摄像头并持续推理大约在 2 至 3W;只有加上屏幕、并发读写和多路视频时才会进入 4W 以上。这个量级意味着绝大多数盒子可以做成无风扇封闭结构,只在 4W 以上的工况需要导热垫或散热片辅助。
散热方面,第三方压测给出的参考区间是:RV1126B 在无风扇、仅配基础铝散热片的条件下做 CPU 与 NPU 双烤,核心温度稳定在 65 至 80℃;触及约 85℃ 时内核会主动降频,这是保护机制正常工作,不代表器件损坏。换句话说,裸板能扛住持续推理,但装配密闭外壳的量产机型要按外壳内温重新核算散热余量。
5. 视觉链路:AI-ISP、多目拼接与超级编码构成差异化
真正把这颗芯片和同价位竞品拉开差距的,不是 NPU 的 3TOPS,而是围绕视觉的一整套硬件单元。
AI-ISP 独立运行:8M@30fps 的 AI-ISP 是独立硬件单元,跑 3DNR、HDR、鱼眼校正、去雾时不占用 3T NPU,避免了传统"ISP 加 NPU 联合处理"方案的带宽与功耗双重消耗。
多目动态拼接:支持 2×6M 双目拼接与 4×2M 全录拼接,基于自研 AVS 算法把多路输入合成一路,拼缝处无明显割裂,适合全景与超广角产品。
硬件级 6-DOF 数字防抖:在运动载体上抑制高频抖动,输出稳定的视频流,对车载与机器人场景价值直接。
超级编码:8M@45fps 智能编码,通过动态码率优化比传统 CBR 节省约 50% 码流,同等存储容量可提升一倍录制时长。
热成像支持:最大 16bit 数据输入,内置 OCC 像素偏置校正、自动 NUC、去横竖条纹、3D 与 2D 降噪、动态范围压缩,可在无光环境下工作。
AOV 3.0:加入低功耗音频事件唤醒,可识别狗吠、玻璃破碎、枪声等异常声源,配合 1mW 级待机实现 7×24 小时值守。
这套能力的组合效果,是让"看得清"和"看得懂"在同一颗芯片上完成。对做安防、工业质检、车载视觉的整机厂商来说,省掉的是外挂 ISP、外挂拼接芯片和额外的编码算力,整机 BOM 与结构空间都会更紧凑。
6. 落地边界:适合端云协同,不适合当本地 2B 对话主力
把前面的实测数据放回具体业务,能得出比较清楚的配置边界。
业务场景 | 推荐配置 | 依据 |
智能安防摄像机、门禁闸机 | YOLO 轻量检测 + 0.5B 视觉模型 | 0.5B 视觉模型 14.89 tokens/s,检测 50 帧级 |
工业缺陷检测、光伏与锂电 AOI | yolov8s 至 yolov8m、yolo11n | 640×640 INT8 下 11 至 43 帧,单路可实时 |
端云协同的本地 Agent | 端侧 0.6B ViT 做视觉理解,LLM 上云 | 官方演示方案,本地脱敏上传,成本较纯云端降低一半以上 |
本地 2B 大模型对话主力 | 不建议按此规划 | 2B 多模态 5.14 tokens/s,峰值内存 16.4GB |
3B 至 7B 流畅输出 | RK3588 + RK182X 协处理器 | 不同算力档位:RK1828 跑 7B 首帧约 160ms、50+ tokens/s |
三条边界值得写进选型文档。第一,把 2B 当"能跑"而不是"好用":算力口径成立、体验口径不成立,5 tokens/s 只适合短指令、结构化抽取和单轮问答,长文生成与多轮闲聊会明显卡顿。第二,内存优先于算力:2B 多模态真正卡住的是 16GB 级内存,而不是 3TOPS,立项时先确认内存配置再谈模型规模。第三,端云协同是这颗芯片的最优解:端侧跑 0.6B 视觉模型完成本地理解与脱敏,语义生成交给云端,既保住实时性和隐私,又把成本压下来。
反过来说,如果业务本质是"多路视频 + 本地实时判定",RV1126B 的性价比很高:4 路摄像头、12M ISP、独立 AI-ISP、千兆网口和 2W 级功耗,在这个价位上很难找到同等完整度的替代。3TOPS 不够支撑本地大模型时代的所有想象,但足够支撑"视觉即入口"的绝大多数落地方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部