


1. 赛道全景:两条技术路线分道,M.2 成为边缘部署标准形态
随着边缘大模型推理、智能视频分析、工业质检等场景规模化落地,M.2 形态 AI 算力卡凭借标准接口、小巧体积、可直接嵌入工控机、AI 盒子与边缘网关的特性,成为边缘侧算力部署的核心赛道。国产阵营在这一形态上的产品布局,已清晰分化为两条路线:一条是以登临科技为代表的通用 GPU 架构,兼顾模型通用性与推理效率;另一条是以后摩智能为代表的专用加速架构(存算一体、NPU),主打特定场景下的极致能效与显存密度。
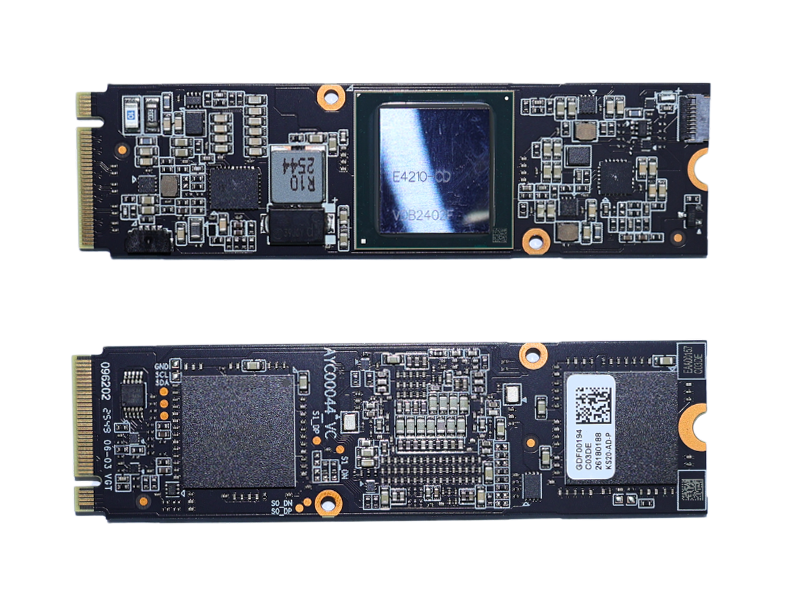
1.1 登临科技 KS20-A:GPU+ 架构的通用型代表
KS20-A M.2 是登临科技面向边缘侧的 M.2 形态主力产品,基于自研 GPU+ 架构,融合了传统 GPU 的软件通用性与 ASIC 的计算高效率,是当前国产通用型 M.2 算力卡的代表。
核心算力:INT8 有效算力 60 TOPS,INT4 可达 120 TOPS,同时支持 FP16/TF32/FP32 全精度计算。
功耗控制:典型工作功耗仅 20W,峰值不超过 25W,无需主动强散热即可稳定运行。
存储配置:板载 16GB/32GB 显存,内存带宽 102.4 GB/s,可支持 Qwen3 30B 级模型的单机推理加载。
接口与解码:PCIe 4.0 x4 接口,支持最大 60 路 1080P@30FPS 视频硬解码,适配多路安防与视频分析场景。
系统兼容:支持 Windows/Linux/Android 及麒麟、统信等国产操作系统,兼容 CUDA 生态,算法迁移成本低。
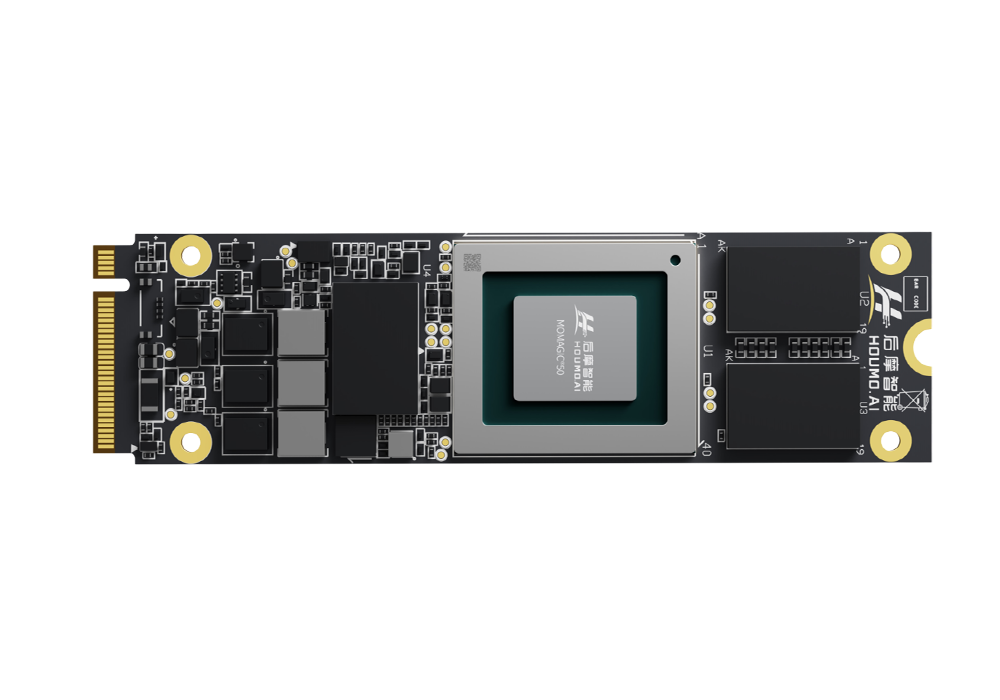
1.2 后摩智能 LM5010(原力擎 LQ50 M.2):存算一体路线的大显存方案
后摩智能基于存算一体技术路线的边缘大模型推理模组,诉求点在“大显存 + 高算力密度”,面向需要更大参数模型全量加载的边缘推理场景。
核心算力:最高 160 TOPS 弹性算力,bFP16 精度下可达 100 TFLOPS,支持 INT8/INT16/bFP16 混合精度。
存储配置:板载 24GB/48GB LPDDR5/LPDDR5X 内存,带宽最高 153.6 GB/s,支持大参数模型全量加载。
形态特性:标准 M.2 接口设计,可直接集成于边缘网关、AI PC、视频会议终端等设备。
使用代价:采用专用软件栈,模型与算子适配需按厂商工具链重新转换,算法复用成本高于通用 GPU 路线。
1.3 算能、瑞芯微:核心板形态为主,标准 M.2 独立卡较少
算能、瑞芯微等厂商的边缘 AI 产品更多以 SOC 核心板、计算模组形态为主,标准 M.2 接口的独立算力卡布局相对较少。例如算能 CV186AH、BM1688 多以核心板形式落地,主打低功耗视觉分析,INT8 算力覆盖 7.2—16 TOPS,更适合轻量 AI 任务,而非边缘大模型推理。
2. 能效比对决:KS20-A 进入第一梯队的依据
在边缘侧场景中,单位功耗算力与实际业务能效比标称峰值算力更重要——功耗直接决定散热设计、设备体积与长期运维成本。KS20-A 跻身第一梯队,依靠的不是最高标称算力,而是在通用架构下把有效算力、功耗与生态成本一并压到了可落地区间。
2.1 关键参数横向对比
产品型号 | 架构路线 | INT8 有效算力 | 典型功耗 | 标称能效比(INT8) | 显存容量 | 通用兼容性 |
登临 KS20-A M.2 | GPU+ 通用架构 | 60 TOPS | 20W | 3.0 TOPS/W | 16/32GB | 高(兼容 CUDA 生态) |
后摩 LM5010 M.2(原力擎 LQ50 M.2) | 存算一体专用架构 | 160 TOPS(弹性) | 约 30—40W | 约 4—5 TOPS/W | 24/48GB | 中(专用软件栈) |
算能 CV186AH 核心板 | NPU 专用架构 | 7.2 TOPS | 约 5W | 1.44 TOPS/W | 最大 8GB | 中(面向视觉场景) |
表中能效比为标称算力与典型功耗的简单比值,仅用于同一口径下的横向参照;后摩方案标称能效更高,但其专用架构的算法迁移与二次开发成本未计入,实际部署侧的综合成本需结合项目周期评估。
1.1 能效优势来自三个层面
1. 架构级效率优化。GPU+ 架构通过软件定义的片内异构体系,针对 Transformer 结构做了硬件级优化,在典型 AI 推理场景下的性能能效比可达国际主流同级别产品的 3—5 倍。相比传统 GPU,它避免了通用计算单元的闲置损耗;相比纯 ASIC,又保留了全场景模型适配能力。
2. 业务场景的实际释放率更高。在边缘大模型推理与多路视频分析等真实业务中,KS20-A 的有效算力释放率高于同功耗竞品。例如单卡加载 Qwen3 30B 模型推理时,整机(搭配 ARM 主控)功耗可控制在 40W 以内,显著降低边缘设备的散热与供电门槛。
3. 全生命周期成本更低。CUDA 生态兼容可将算法迁移成本降低 60% 以上,避免专用芯片的二次开发投入;同时支持多系统、多平台适配,设备复用率更高,从部署到运维的综合能效更优。
3. 场景落地:高能效拓宽“无感集成”的边界
M.2 形态的核心价值在于无感集成,而高能效进一步拓宽了它的落地边界。以 KS20-A 为代表的第一梯队产品,已在三类场景实现规模化落地。
场景 | 典型配置与能力 | 客户价值 |
边缘大模型一体机 | 搭配国产 ARM 主控,单盒运行 30B 级大模型,支撑本地化智能问答 | 政务、园区、企业数据不出域,整机功耗可控 |
智能安防与工业质检 | 60 路视频硬解码叠加 60 TOPS AI 算力,同时完成多路结构化分析与缺陷检测 | 一台设备替代多卡方案,机箱与散热成本下降 |
信创边缘设备 | 全栈国产化适配,支持国产 CPU 与麒麟、统信等操作系统 | 满足政务、金融行业的安全合规要求 |
4. 年度趋势与结论
2026 年国产 M.2 AI 算力卡赛道呈现三条明确趋势:算力持续上探,从十 TOPS 级迈向百 TOPS 级,开始承载边缘大模型推理;能效成为核心竞争指标,低功耗、高有效算力的产品更受市场青睐;通用性升级,从单一视觉加速走向全场景通用推理。
结论上,登临 KS20-A 以“能效比 + 通用性”的组合,缓解了行业内“专用芯片能效高但通用性差、通用芯片兼容好但能效低”的矛盾,成为边缘侧通用 AI 部署的代表性选型。需要说明的是,能效判断依赖标称参数与特定实测条件,不同模型规模、batch 配置与散热设计下的表现仍需按项目验证;对于显存需求超过 32GB 的大模型场景,存算一体的大显存方案仍是更现实的选项。随着大模型向边缘侧加速渗透,高能效 M.2 算力卡将成为国产 AI 芯片规模化落地的关键突破口。
请用手机扫码查看分享内容
 下一篇:小卡释放大算力!登临KS20-A M.2 AI算力卡,60TOPS低功耗边缘加速方案落地
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)


 试用申请
 产品咨询
 在线客服
 回到顶部