
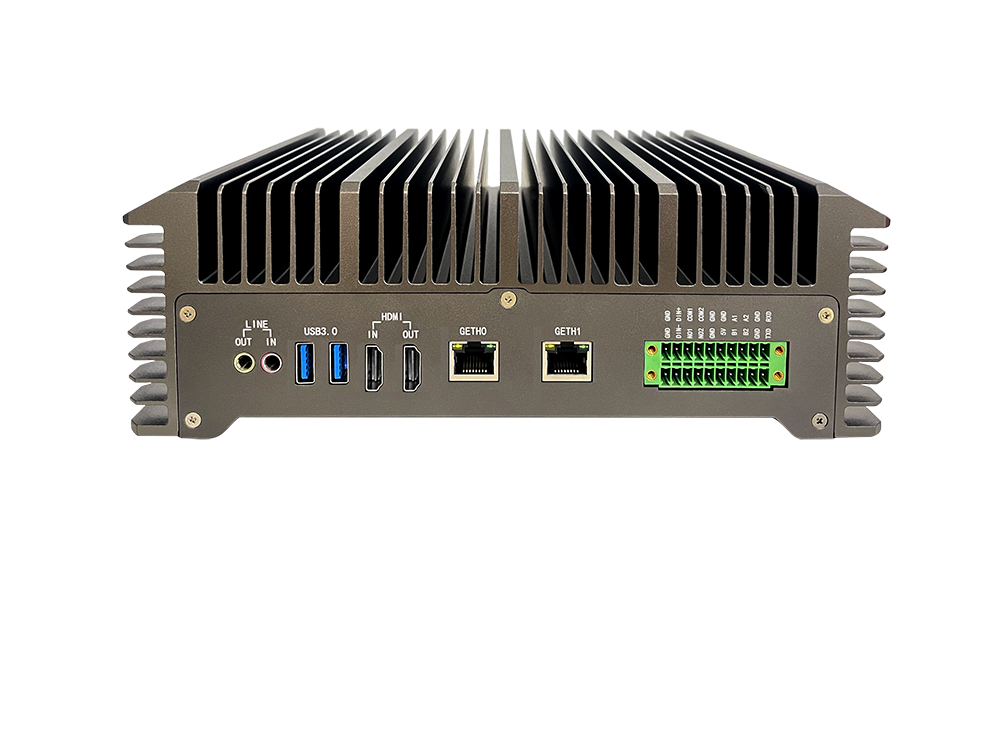
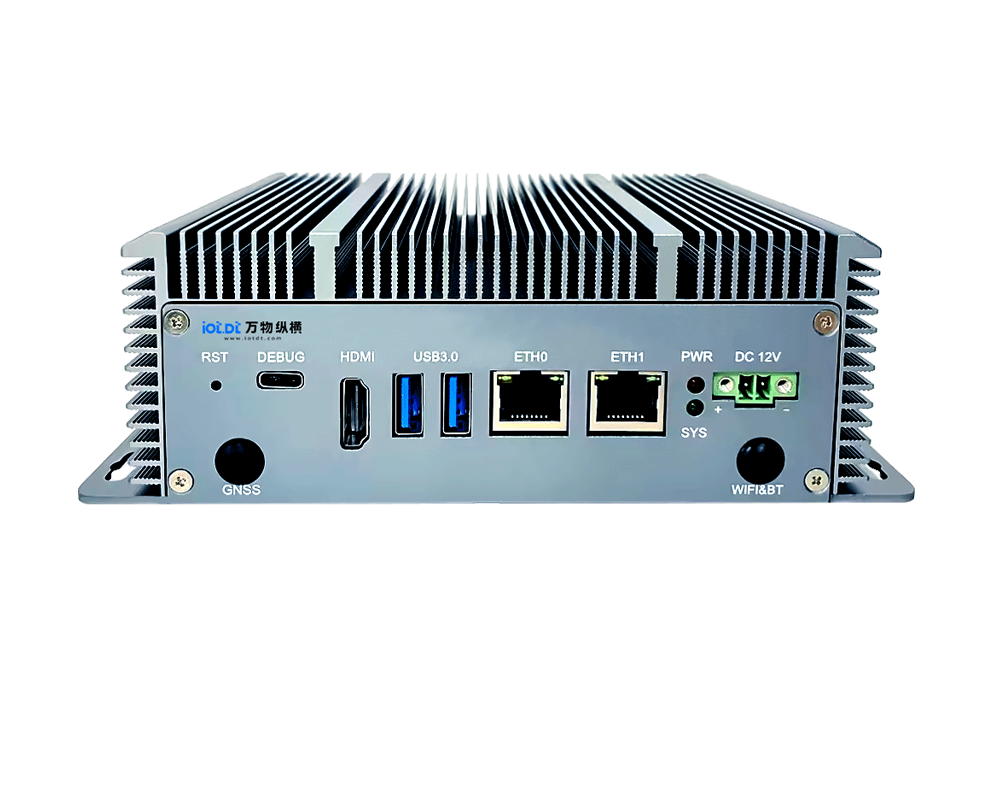
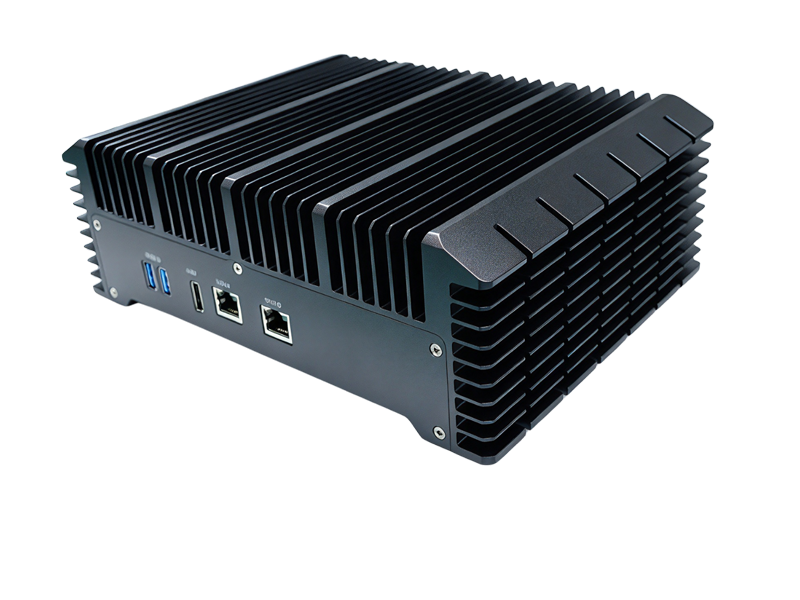
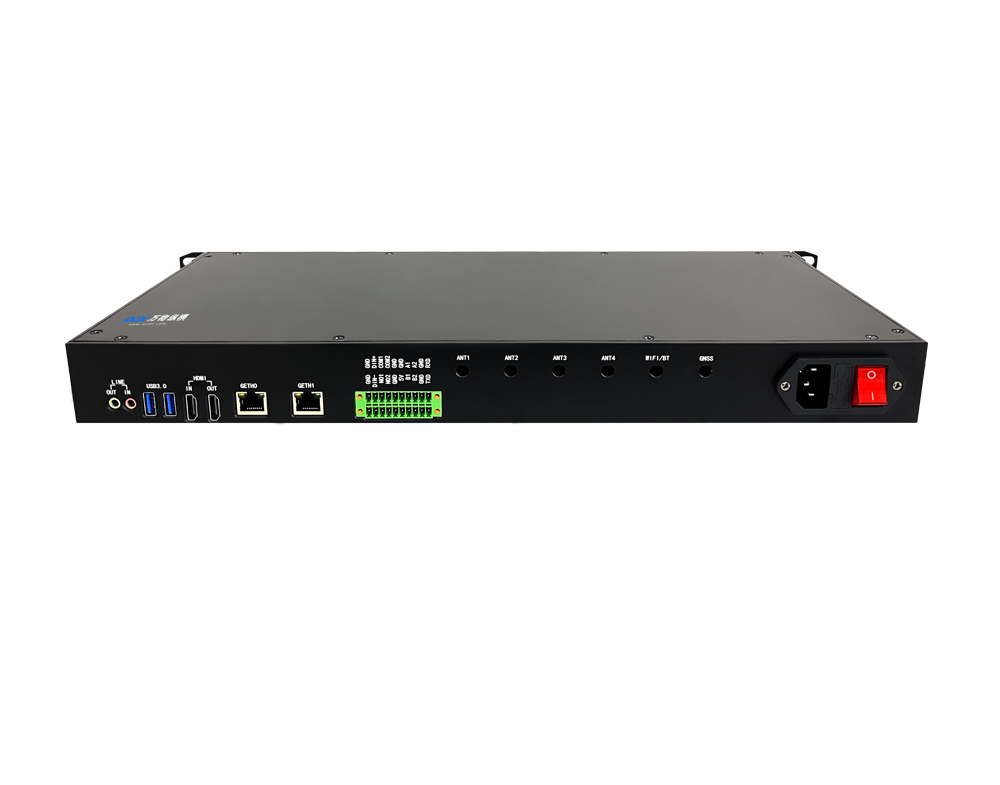
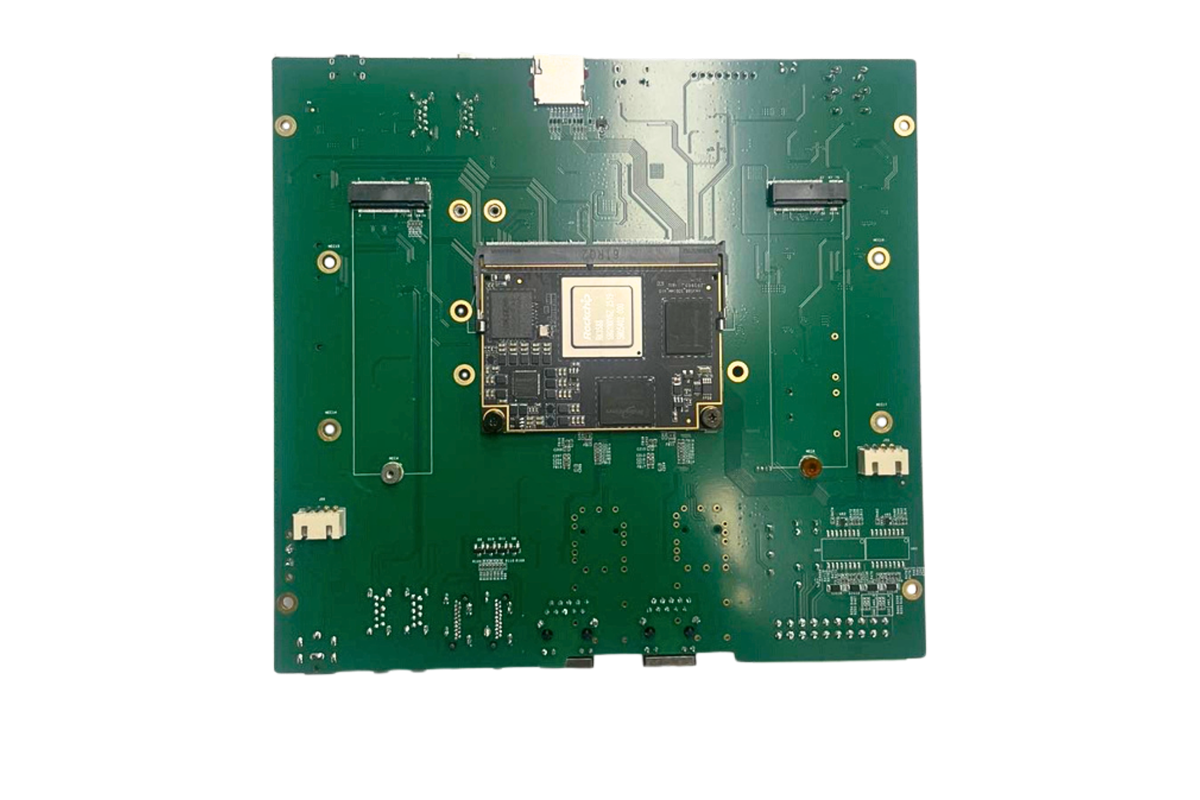


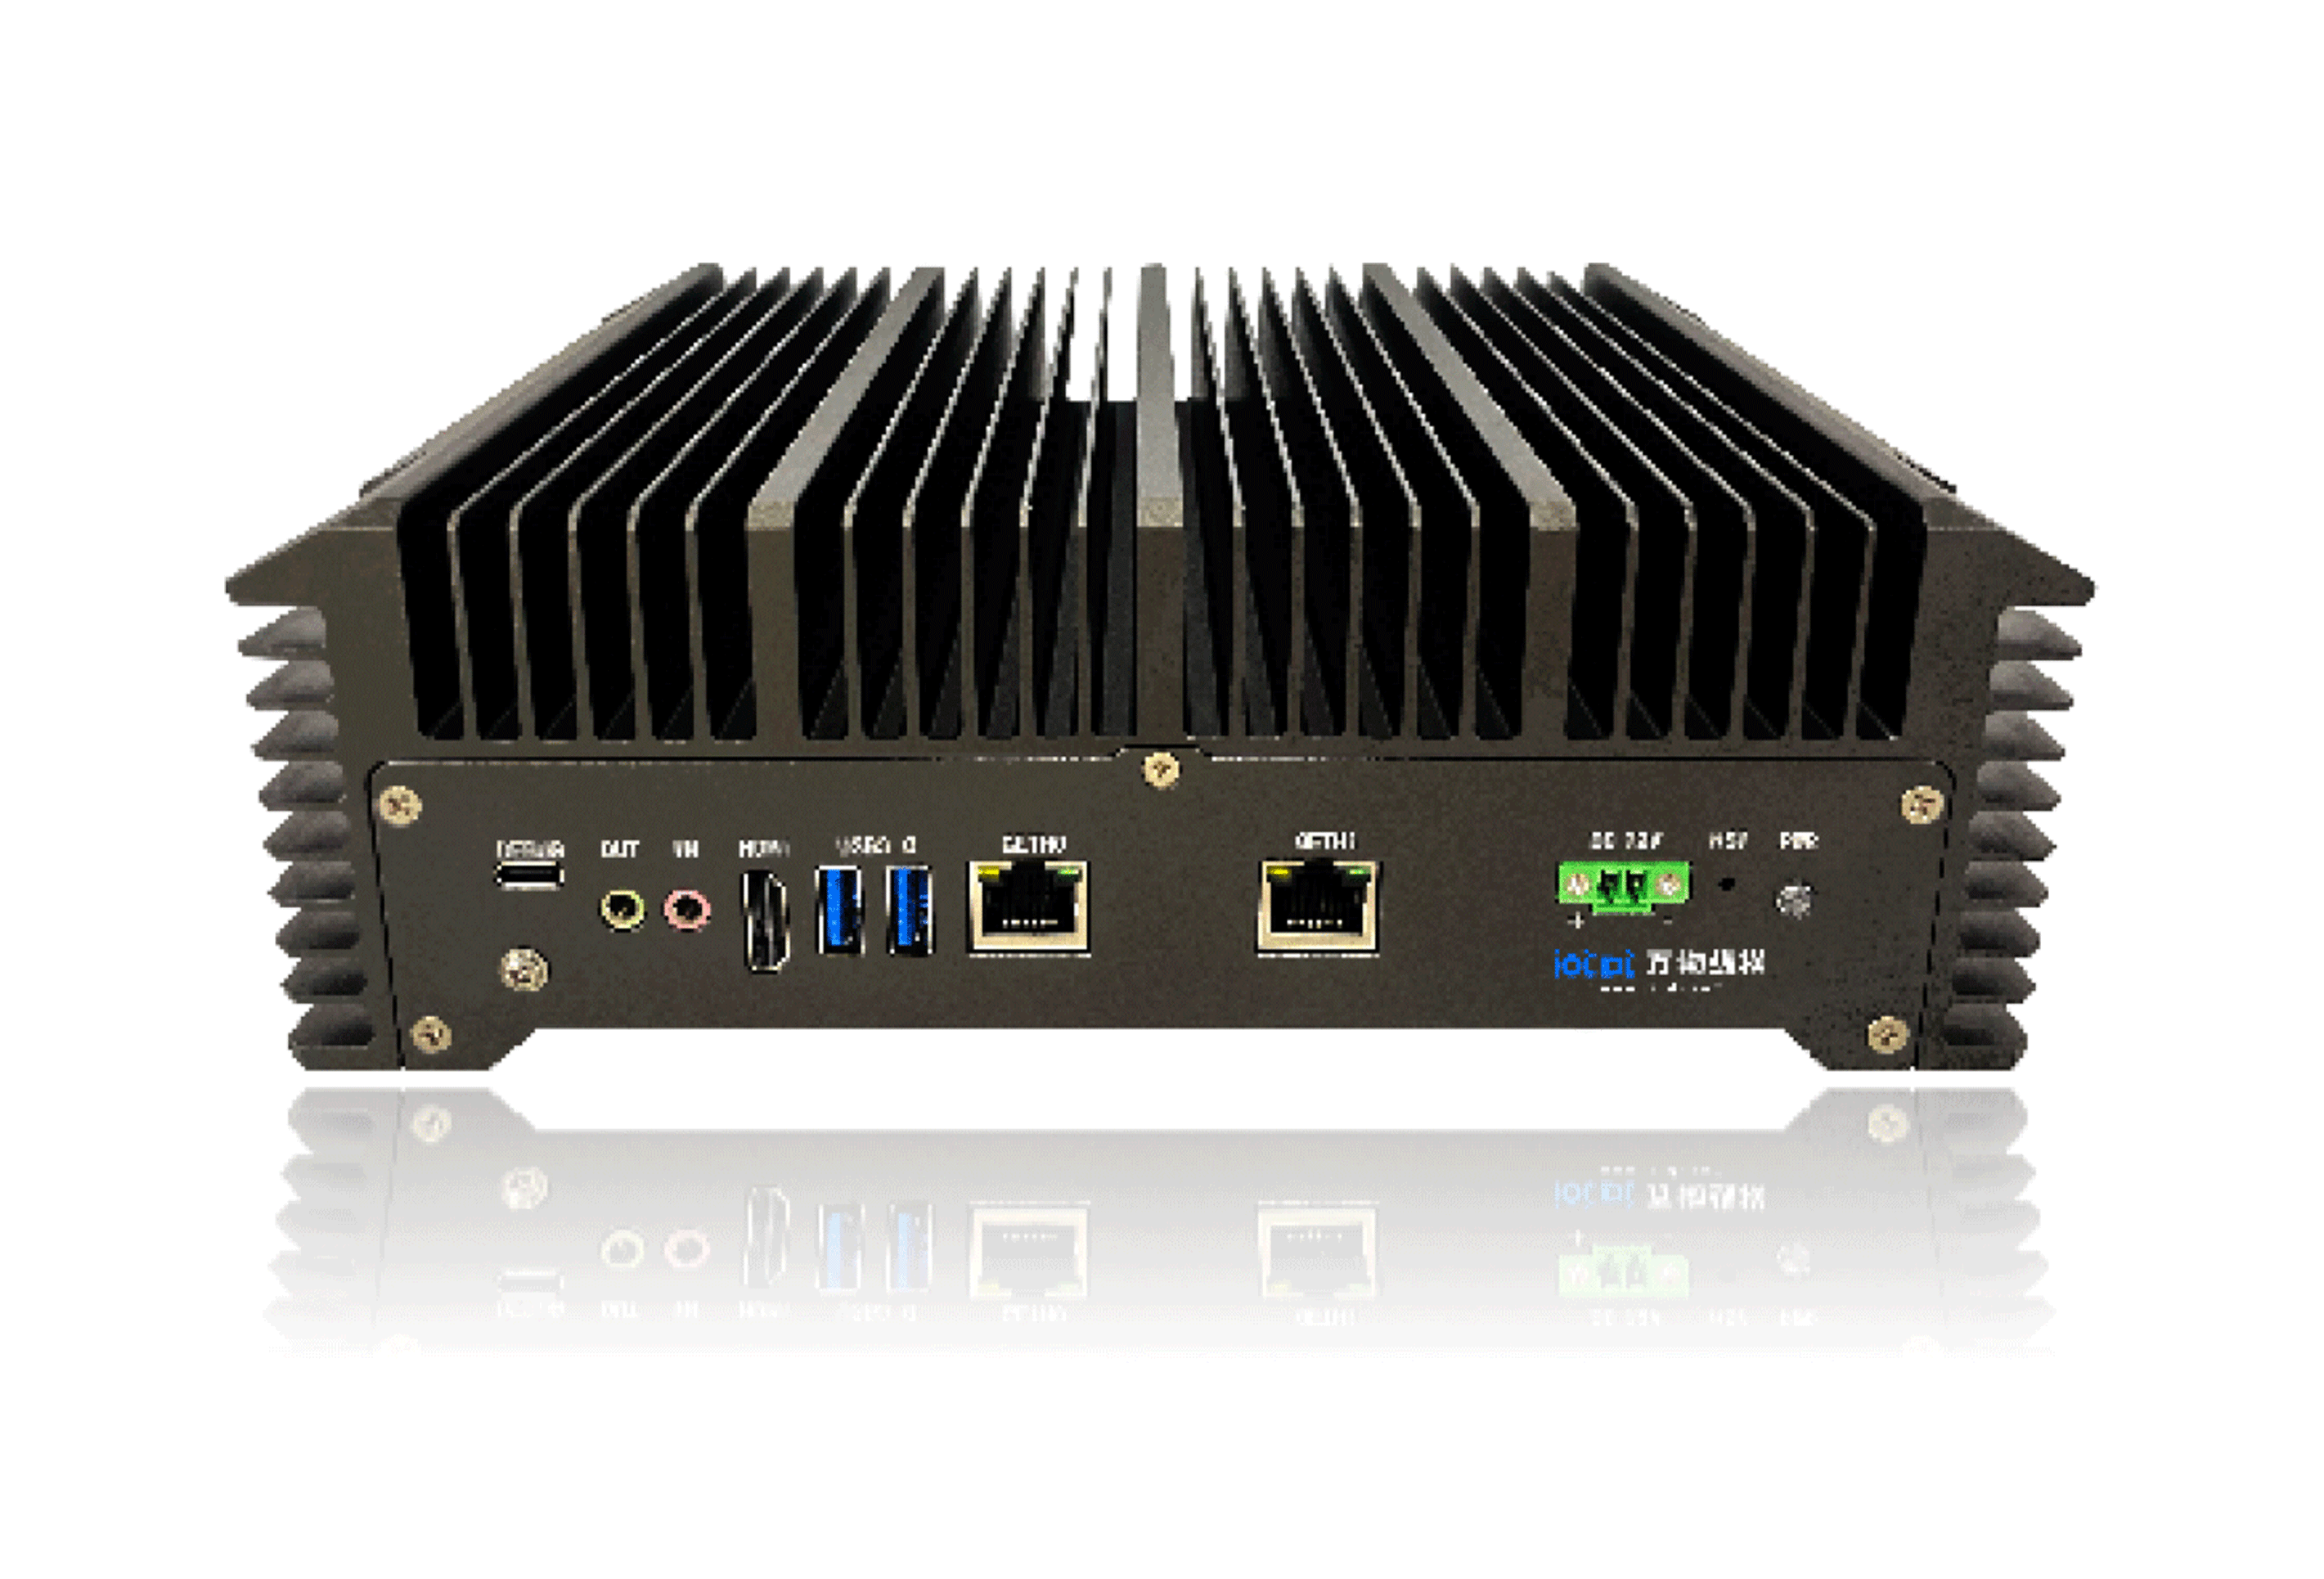
随着边缘智能场景从单点试点走向规模化落地,行业对AI盒子的需求已从"具备算力"升级为"高并发、低功耗、全链路端侧处理"。算能推出的第四代张量处理器BM1684X,凭借32TOPS INT8峰值算力与32路1080P高清视频硬解码的核心组合,成为中端边缘AI盒子的标杆级芯片方案,正在重新定义边缘智能设备的性能基准。
算力与解码双维突破,解决端侧核心痛点
过往边缘AI方案常陷入"算力充足但解码能力不足""解码路数够但算力撑不起算法"的错位问题,BM1684X则实现了两大核心能力的同步拉满,适配多路视觉分析的典型场景需求。
32TOPS峰值算力,覆盖多精度推理需求
BM1684X的INT8峰值算力达到32TOPS,同时支持16 TFLOPS FP16/BF16与2 TFLOPS FP32混合精度计算,可灵活适配从目标检测、人脸识别、行为分析到轻量化大模型端侧部署的多元算法需求。相比上一代产品,其能效比提升2倍,在边缘设备有限的功耗预算下释放更强计算性能;内置增强型SORT、NMS、Scatter-gather等后处理引擎,可独立完成算法后处理步骤,减少CPU调度开销,提升端到端推理效率。
32路高清硬解码,实现解码+分析并行
视频编解码是边缘视觉场景的基础能力,直接决定单设备可接入的摄像头路数。BM1684X集成高性能VPU单元,支持H.264/H.265格式下32路1080P高清视频硬件解码,最高帧率可达30fps;在实际业务场景中,可稳定实现32路1080P@25fps视频解码与AI智能分析同步运行,单设备即可完成全链路处理,无需额外搭配解码芯片。
同时芯片支持12路1080P@25fps视频编码,单路最大解码分辨率可达8K,兼顾多路并发与超高清场景;JPEG图片编解码能力达1080P@600fps,可适配图片抓拍、工业质检等高频图像处理需求。
面向边缘场景深度优化,落地能力全面
边缘AI盒子的真实价值不止于纸面参数,更在于对复杂部署环境的适配性。BM1684X从硬件集成、环境适应性到开发生态做了全链条优化,大幅降低落地门槛。
硬件层面,芯片集成8核ARM Cortex-A53@2.3GHz通用处理器,最大支持16GB LPDDR4x高速内存与64GB以上eMMC存储,SOC模式下可独立运行完整操作系统与业务程序,无需额外主控芯片,简化硬件设计。整机典型功耗控制在18W以内,支持-40℃~+70℃宽温工作,可覆盖户外闸机、工业厂区、井下矿区等严苛环境;配备PCIe Gen3、双千兆网口及多路GPIO、I2C、UART接口,既可作为算力核心嵌入终端设备,也能独立组成边缘计算节点。
开发生态上,配套的SOPHON SDK提供从底层驱动、模型编译器到推理部署的一站式工具链,原生兼容PyTorch、TensorFlow、PaddlePaddle等主流深度学习框架,算法迁移成本低,支持客户快速完成场景化定制开发。
重构场景部署模式,降本增效显著
依托"32路解码+32TOPS算力"的核心配置,基于BM1684X的边缘AI盒子可单设备覆盖中大型场景的智能分析需求,彻底改变传统"多台低算力设备级联"的部署模式。
在智能安防、智慧园区场景中,单台盒子即可完成32路监控摄像头的人脸抓拍、人车非识别、周界入侵检测、视频结构化等全量分析,减少设备数量、布线成本与运维节点;在智慧工地、工业质检场景中,可同时对接多路工业相机,实现缺陷检测、作业行为规范分析的实时处理;此外,32TOPS的算力储备也支持7B参数以内轻量化大模型的端侧私有化部署,适配本地智能问答、语义分析等新兴边缘需求。
定义边缘AI盒子的性能新基准
BM1684X的核心价值,在于打破了边缘AI盒子"单参数内卷"的行业惯性,实现了算力、解码、功耗、生态的均衡突破:32路解码匹配主流安防与工业场景的并发需求,32TOPS算力支撑算法迭代与多任务并行,成熟的工具链与宽温设计保障规模化落地可行性。
它不仅是一款芯片方案,更成为中端边缘AI盒子的"标配参照系"——推动行业从单一参数比拼,转向"全场景落地能力"的综合竞争,加速边缘智能在各行业的规模化普及。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部