
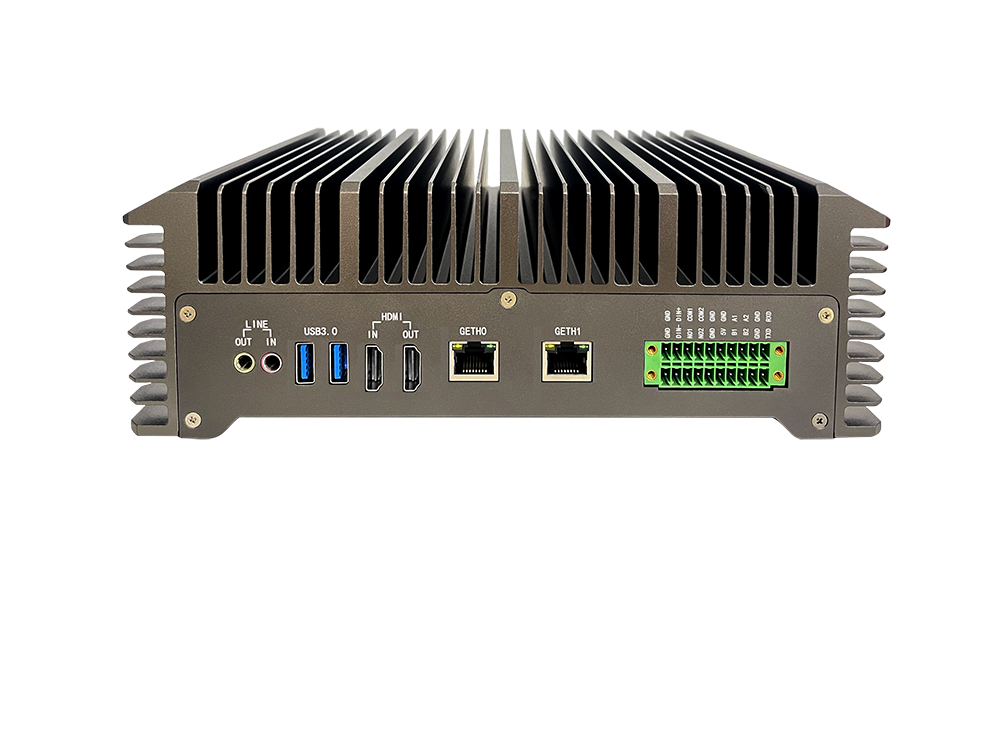
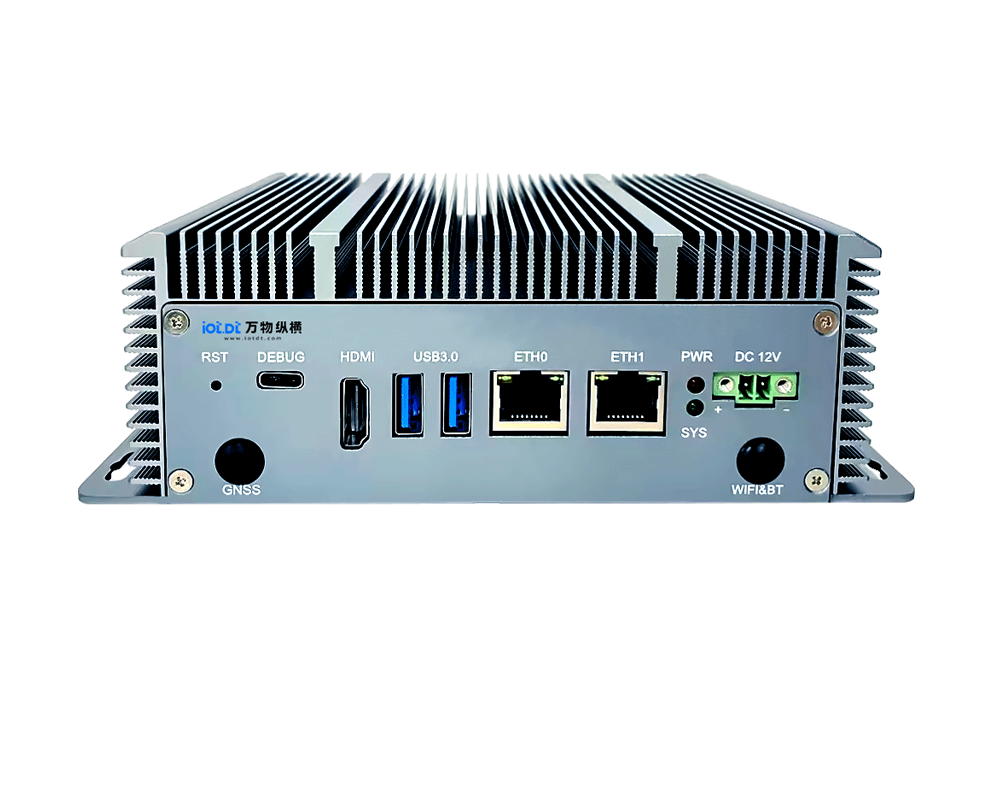
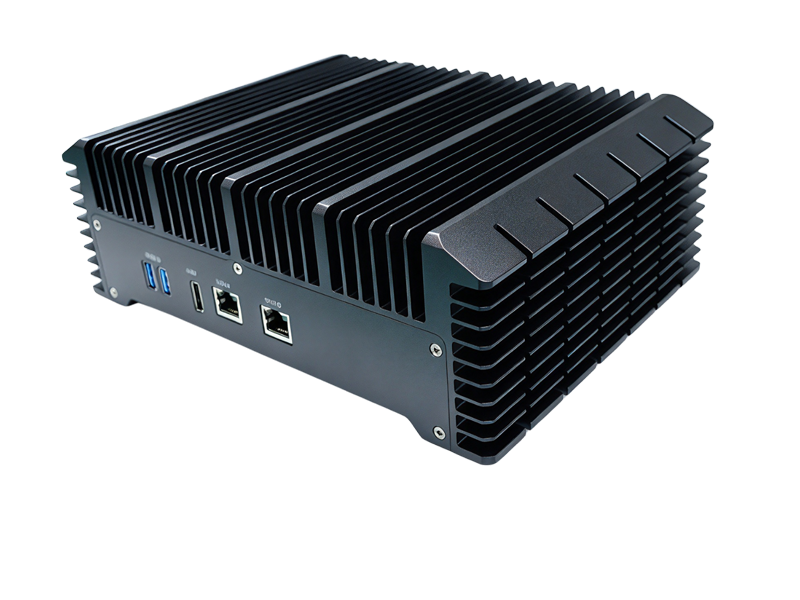
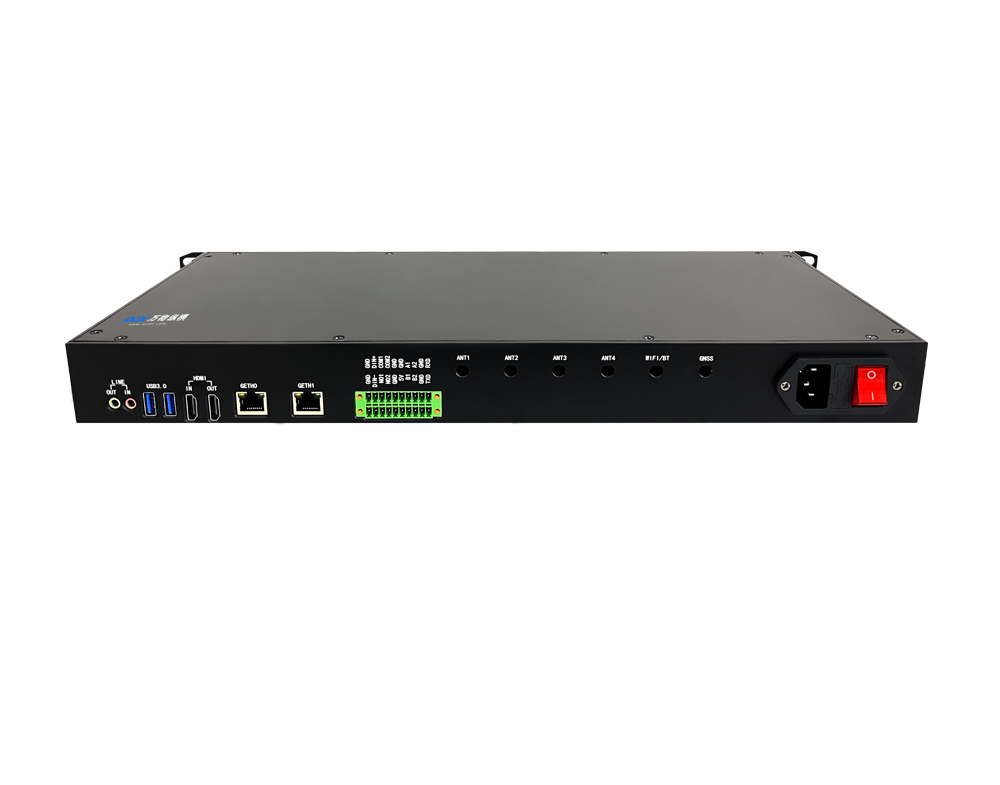
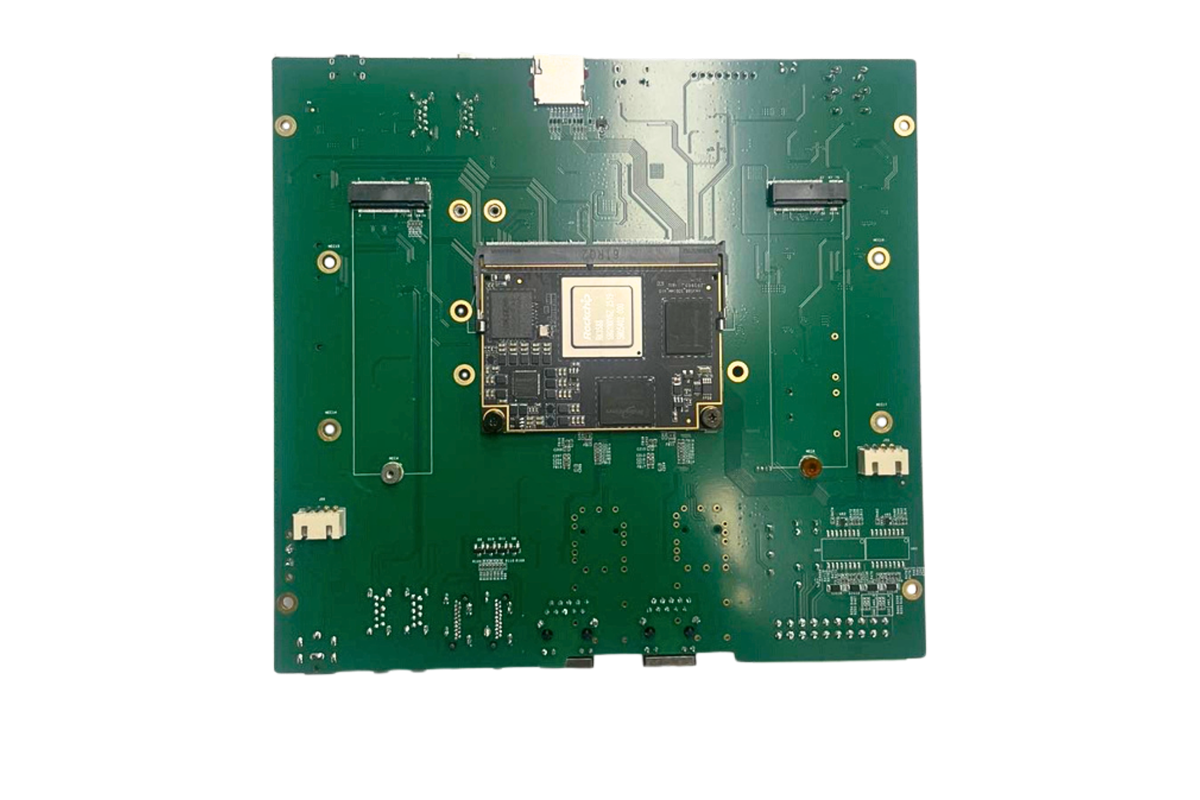


BM1684X是算能推出的第四代张量处理器(TPU),定位中高端边缘AI推理与智能视觉场景,是国产边缘AI芯片中"专用算力+视频硬加速"路线的代表产品。其竞争力可以从硬件性能、场景适配、生态落地、竞品对比与短板五个维度综合评估。
一、核心硬件性能:边缘端第一梯队的AI算力密度
BM1684X采用12nm工艺,主打"专用TPU算力+集成VPU编解码"的架构设计,核心参数如下:
AI算力:INT8峰值32TOPS,FP16/BF16 16TFLOPS,FP32 2TFLOPS,支持INT4混合量化,算力较上一代BM1684提升约2倍。
CPU与内存:集成8核ARM Cortex-A53@2.3GHz,最高搭配16GB LPDDR4X内存,满足边缘端业务逻辑与数据缓存需求。
功耗与工业级能力:芯片典型功耗17W,模组级典型功耗18W,整机功耗约24W;支持-40℃~105℃工作温度,满足工业级宽温部署要求。
从能效比来看,32TOPS/18W的算力密度在国产边缘专用AI芯片中处于上游水平,显著高于通用SOC类方案,专门针对推理场景做了硬件级优化。
二、差异化核心优势:强视频能力+全栈自主可控
BM1684X的核心竞争力并非单纯堆算力,而是精准匹配了边缘计算最主流的视觉分析场景,同时满足信创替代需求。
1. 高密度视频编解码,直击安防/工业视觉痛点
集成独立VPU单元,与TPU物理隔离,可实现"解码+AI分析"并行处理:支持32路1080P@25fps视频解码、12路1080P@25fps编码,兼容8K分辨率,JPEG解码可达600帧/秒。
单芯片可同时完成32路高清视频的结构化分析(人脸识别、行为检测、安全帽识别等),无需额外搭配解码芯片,在智慧安防、明厨亮灶、智慧工地、智慧矿区等多路视频场景中,大幅降低整机BOM成本与部署复杂度。
2. 全链路自主可控,信创场景核心替代方案
芯片架构、工具链全栈自研,无海外IP授权限制,通过信创安全可靠I级认证,是政务、国企、能源等信创刚需场景中,英伟达Jetson系列的核心国产替代选项。
支持安全启动、TrustZone、硬件国密算法加速(SM4/SHA等),满足行业数据安全合规要求。
三、软件生态:工具链完备,视觉场景成熟,大模型加速跟进
算能为BM1684X配套了完整的SOPHON SDK,覆盖模型转换、量化、部署全流程:
框架兼容:支持PyTorch、TensorFlow、PaddlePaddle、ONNX、Caffe等主流深度学习框架,内建150+算子,支持用户自定义算子开发。
工具链能力:提供PTQ离线量化、自动混合精度调优、前后处理算子融合、多芯分布式推理等优化能力,降低算法迁移成本。
大模型适配:原生支持ChatGLM2/3-6B、Qwen-7B、Llama3-8B、Stable Diffusion等轻量化大模型的本地推理,可满足边缘端私有化大模型、智能客服、内容生成等需求。
生态合作:与百度飞桨深度适配,联合落地了海淀城市大脑、智慧加油站等项目;与Firefly等数十家硬件厂商合作推出核心板、边缘盒子、整机服务器等产品形态,硬件生态丰富度在国产AI芯片中处于前列。
短板在于:生态规模与英伟达CUDA仍有量级差距,小众算子、非视觉类模型(语音、推荐等)的适配成本较高,工具链易用性与社区活跃度弱于国际大厂。
四、竞品横向对比:精准卡位细分赛道
将BM1684X与边缘计算赛道主流方案对比,其定位和优劣势非常清晰:
方案
| 核心算力(INT8) | 典型功耗 | 核心优势 | 核心劣势 | 目标场景 |
算能BM1684X | 32TOPS | 17W(芯片) | 算力高、视频解码强、自主可控、性价比优 | CPU通用性能弱、生态规模有限 | 多路视频分析、工业视觉、信创边缘推理 |
瑞芯微RK3588 | 6TOPS | 约10W(整机) | CPU/GPU性能强、生态极丰富、成本低 | AI算力低、多路视频能力弱 | 通用边缘计算、轻量AI、消费级终端 |
华为昇腾310 | 20TOPS | 约8W | 功耗优、华为生态闭环、政企渠道强 | 生态封闭、绑定华为体系、供货灵活度低 | 华为云边协同、政企安防项目 |
英伟达Jetson Xavier NX | 21TOPS | 10-15W | CUDA生态无敌、算法适配零成本 | 价格高、受出口管制、非信创 | 通用边缘AI、科研、高端工业 |
简单来说:
对比通用SOC(RK3588):BM1684X的AI算力是其5倍以上,视频处理能力差距更大,适合AI负载重、视频路数多的专业场景;但RK3588通用计算能力更强,适合"轻AI+重业务逻辑"的通用边缘设备。
对比国际大厂方案(Jetson):BM1684X算力更高、价格更低、完全自主可控,是信创场景的刚需替代;但生态成熟度和开发便捷性差距明显。
对比华为昇腾:算能方案更开放,第三方硬件生态更丰富,项目适配灵活度更高;但昇腾依托华为全栈能力,在大型政企项目中渠道优势显著。
五、真实竞争力总结与短板
核心竞争力定位
BM1684X是国产中高端边缘视觉推理赛道的第一梯队产品,在"多路视频结构化分析"这个细分场景中,是国产方案里综合能力最强的选项之一。它精准切中了安防、工业、政务等领域"高算力+多视频路数+信创替代"的核心需求,凭借"算力够用、视频能力突出、价格可控、交付稳定"的特点,已经实现了规模化落地,是国产AI芯片在边缘赛道突围的代表性产品。
不可忽视的短板
CPU性能偏弱:8核A53均为能效小核,复杂业务逻辑、多服务并发场景下性能不足,很多整机方案需要额外搭配RK3588等主控芯片,增加了系统复杂度。
工艺代差:12nm工艺相比当前主流的8nm/7nm边缘芯片,能效比仍有提升空间,功耗控制并非顶尖水平。
场景覆盖面窄:深度优化集中在视觉推理,非视觉类AI任务、通用计算场景适配不足,属于"专用型"而非"通用型"边缘芯片。
生态厚度不足:工具链虽完备,但开发者社区、第三方算法库、行业案例积累与英伟达、华为仍有明显差距,中小客户迁移成本较高。
整体而言,BM1684X走的是"垂直场景深耕"的路线,没有盲目对标通用GPU,而是在边缘视觉这个最大的边缘AI细分市场做到了国产领先,是国产AI芯片差异化突围的典型路径。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部