
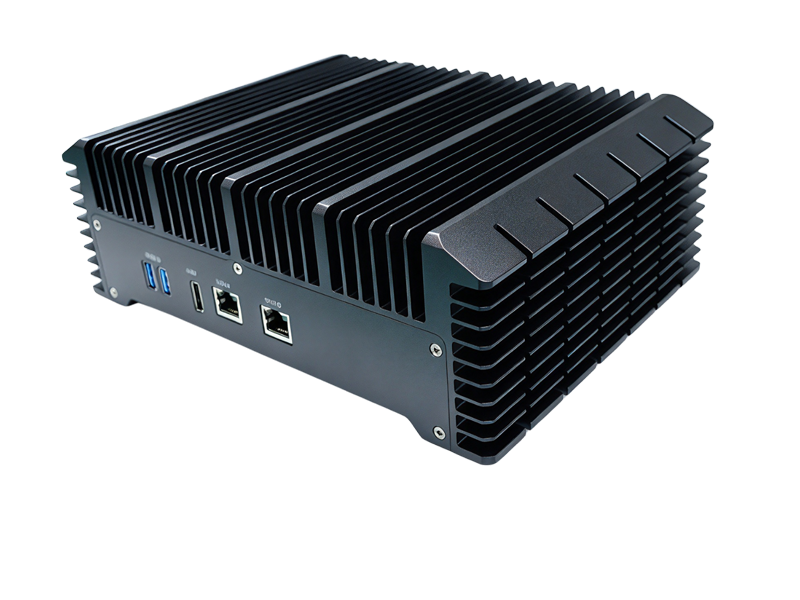
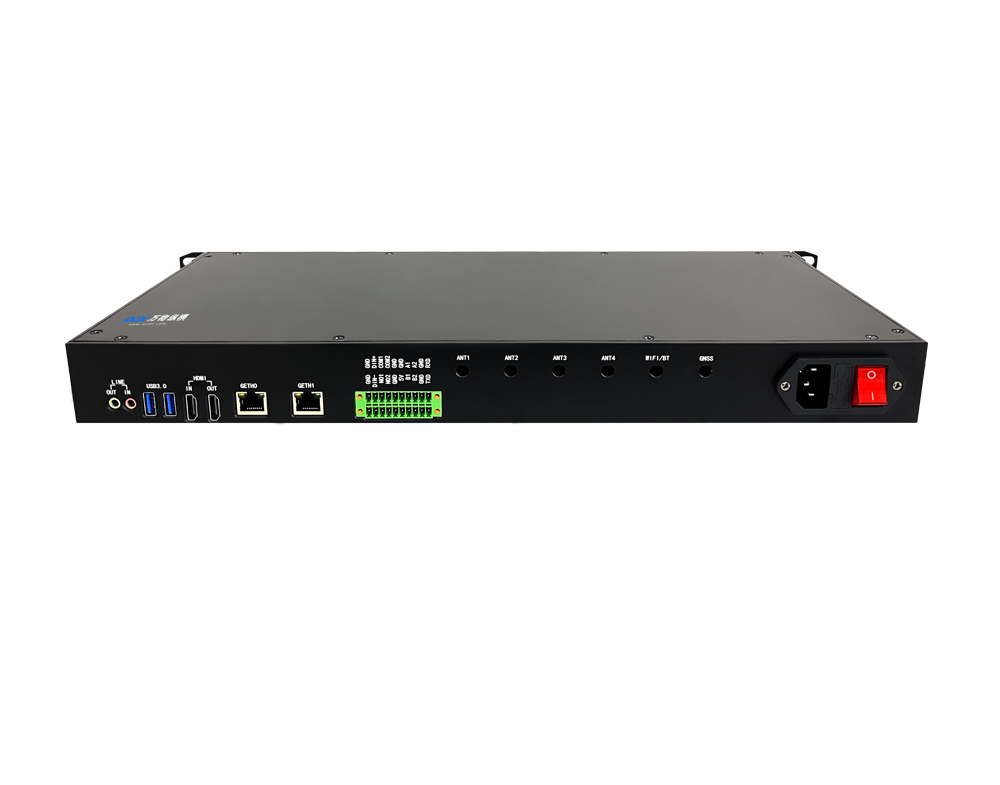
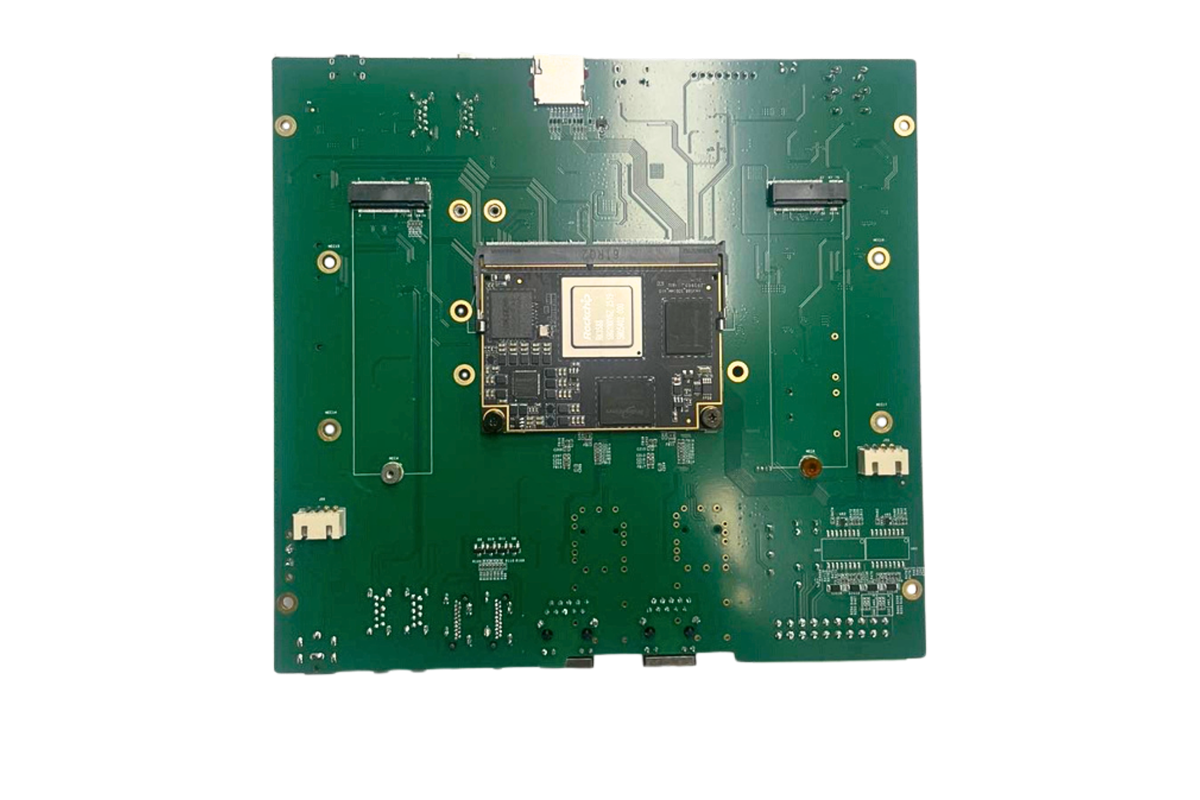
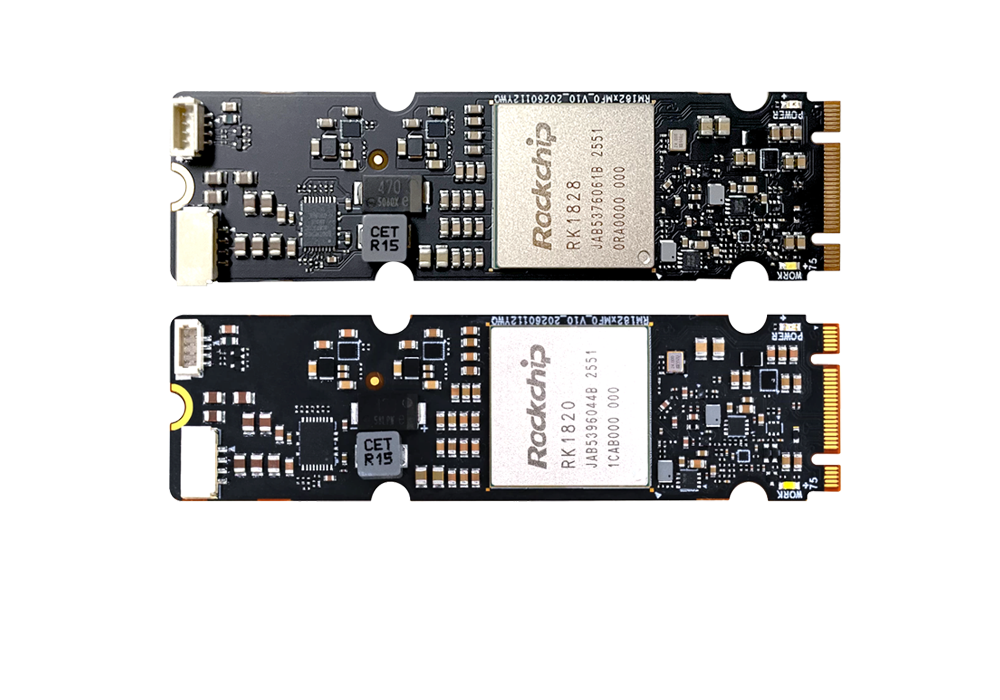
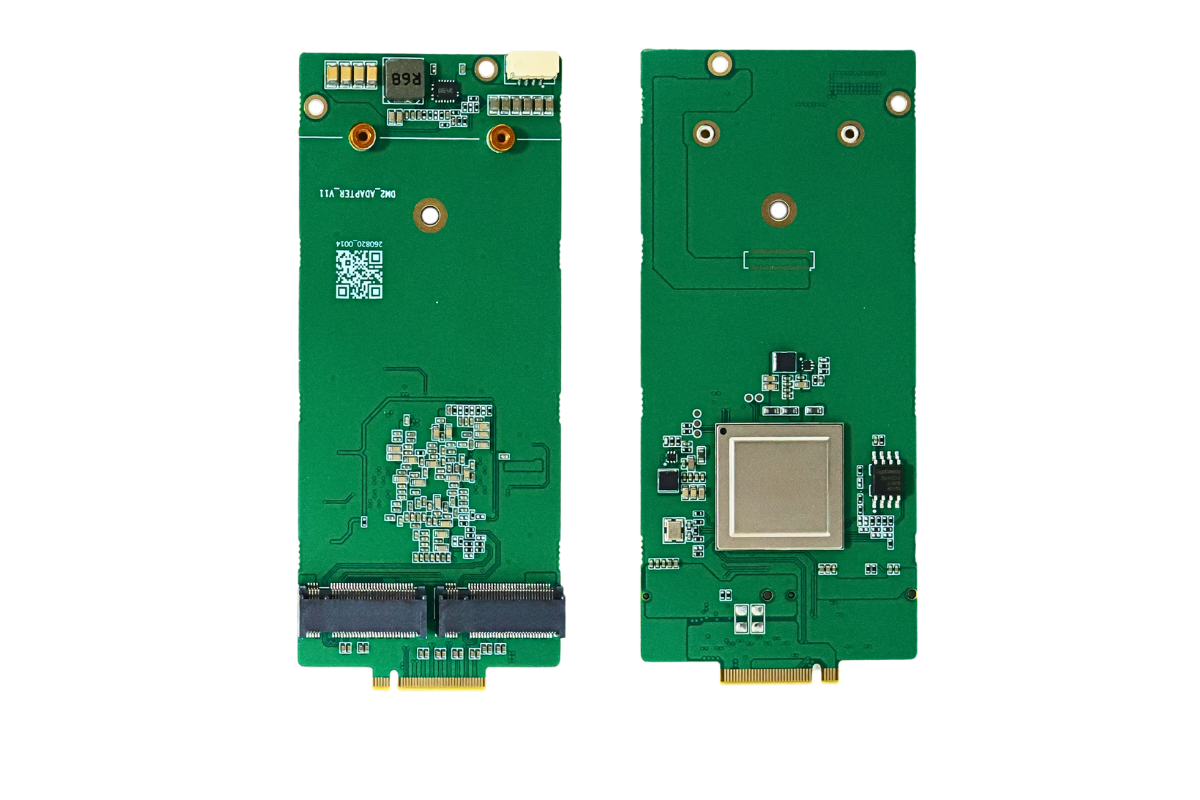


RK1828 是瑞芯微推出的专用端侧 AI 协处理器,以 M.2 算力卡形态为主,支持 Qwen / DeepSeek 大模型本地部署。
一、核心硬件规格
项目 | 参数说明 |
AI 算力 | 20 TOPS @ INT8,支持 INT4 / INT8 / INT16 / FP8 / FP16 / BF16 混合精度运算,可根据场景在精度与推理速度间灵活权衡。 |
内存配置 | 内置 5GB 3D 堆叠高带宽 DRAM,内存带宽达 1024GB/s,从架构上解决大模型推理的内存带宽瓶颈,单卡原生支持 7B 参数级大模型本地运行。 |
主控与接口 | 集成三核 64 位 RISC-V 处理器,采用 M.2 2280 标准形态,通过 PCIe 2.1 接口与 RK3588、RK3576 等主控板对接,即插即用完成算力扩展。 |
功耗与散热 | 典型功耗约 5W,支持被动散热方案,无需复杂风冷 / 液冷,适配嵌入式、边缘端低功耗部署场景。 |
二、Qwen / DeepSeek 大模型本地部署能力
该算力卡已完成主流开源大模型的深度适配,可实现全本地私有化推理。
1. Qwen 系列全栈适配
覆盖 Qwen2.5 3B / 7B、Qwen3.5 全系列,以及 Qwen3.5-Omni 全模态、Qwen3-VL 多模态模型。
实测单卡运行 Qwen2.5-3B 可达约 102 token/s,Qwen2.5-7B 可达约 70 token/s,首 Token 延迟低至百毫秒级,满足流畅交互需求。
瑞芯微原厂完成底层算子调优,配合 RK3588 / RK3576 双芯架构,可实现 2B–7B 模型端侧流畅运行,支持多模态语音、视觉融合交互。
2. DeepSeek 系列部署支持
支持 DeepSeek-R1-Distill 等轻量化系列模型,可通过 RKNN3 工具链转换为 rkllm 格式在 NPU 上加速推理,社区与原厂均提供部署示例与转换指南,适配成熟度高。
搭配多卡级联方案时,可支撑更大参数规模的 DeepSeek 模型本地部署,实现推理性能与模型能力的弹性升级。
三、开发套件配套与扩展能力
标准开发套件通常由「主控开发板 + RK1828 算力卡」组成,配套完整开发资源。
1. 弹性算力扩展
支持 PCIe 多卡级联统一调度,可实现单卡跑 7B 模型、双卡跑 12B 模型、4 卡跑 27B 模型的灵活扩展。双卡系统整机功耗约 30.5W,四卡约 57.8W,远低于 GPU 服务器的功耗与体积门槛。
2. 软件工具链
配套 RKNN3 完整开发工具链,支持 TensorFlow、PyTorch、ONNX 等主流框架模型转换。
提供 Debian 系统固件、Docker NPU SDK、大模型部署 Demo、CV 视觉算法案例。
提供 OpenAI 兼容 API 接口,可直接对接 Agent 框架。
3. 开发资料
厂家提供原理图、PCB 设计文件、BOM 清单、硬件 datasheet,以及大模型部署指南、算法开发手册,降低二次开发与产品化门槛。
四、现货直供与服务优势
该类算力卡开发套件由瑞芯微授权方案商原厂直供,具备以下特点:
供货稳定,支持批量采购与定制化适配(如接口改型、系统定制、模型预部署)。
提供原厂级技术支持,涵盖模型转换、性能调优、场景落地全流程跟进。
兼容银河麒麟等信创系统,可满足政务、工业、车载等私有化合规场景的部署要求。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部