


一、产品定位
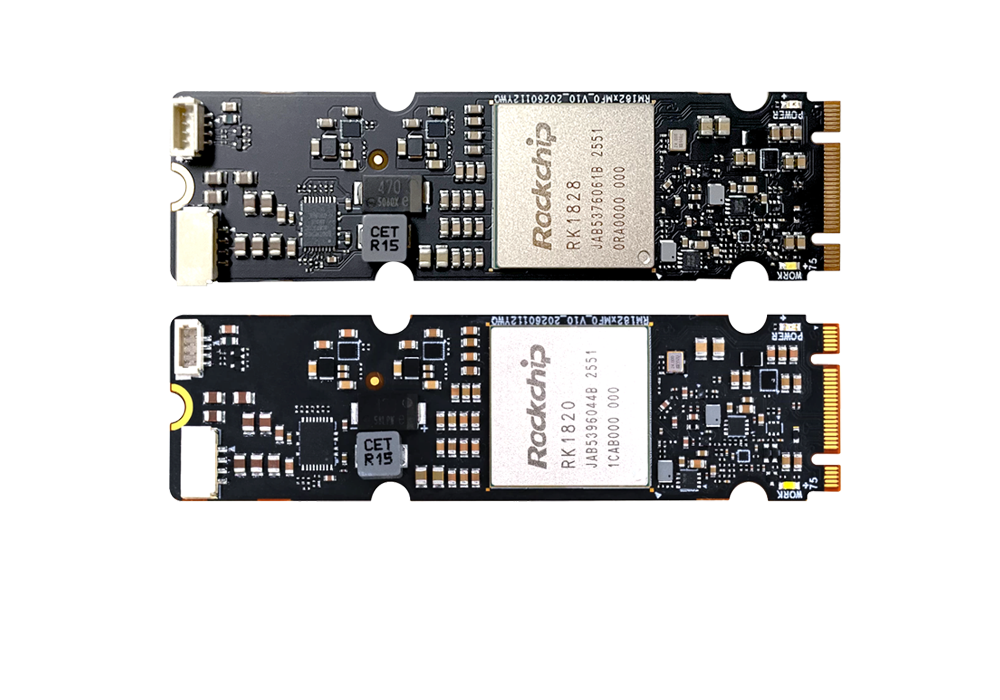
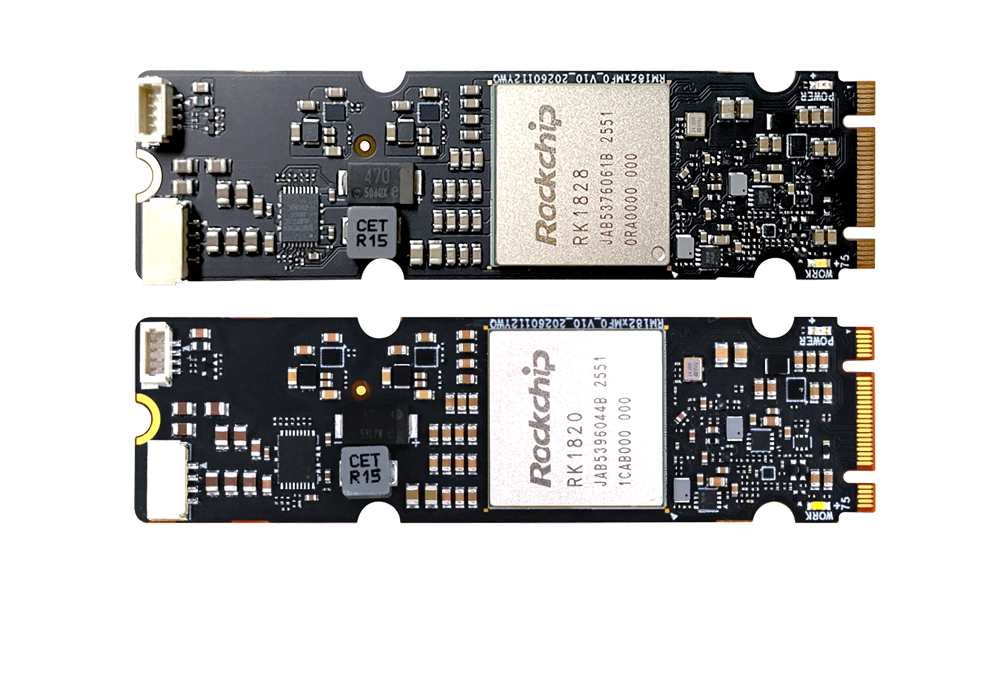
RK1828 是瑞芯微推出的专用端侧 AI 协处理器(算力加速卡),核心定位是为现有嵌入式主控方案扩展 AI 算力,主打低功耗下的大语言模型 / 多模态推理,走"低成本、即插即用、存量升级"的路线,并非通用型边缘计算 SoC。
二、核心优势
1. 3D 堆叠内存架构,大模型推理能效比突出
它最大的技术亮点是采用 3D TSV 堆叠封装,内置 5GB 高带宽 DRAM,内存带宽达 1024GB/s,直击端侧大模型推理"内存带宽优先于纯算力"的核心瓶颈。
实测表现:Qwen2.5-7B(INT4)模型下,SODIMM 版本可实现约 69 token/s 的生成速度,实际推理效率甚至高于理论算力远超它的 Jetson Orin NX(100TOPS)——后者受限于外部内存带宽,同模型下仅约 14.5 token/s。
整卡典型功耗仅 5W 左右,支持被动散热,能效比在同级别产品中处于第一梯队。
2. 生态适配完善,存量升级成本极低
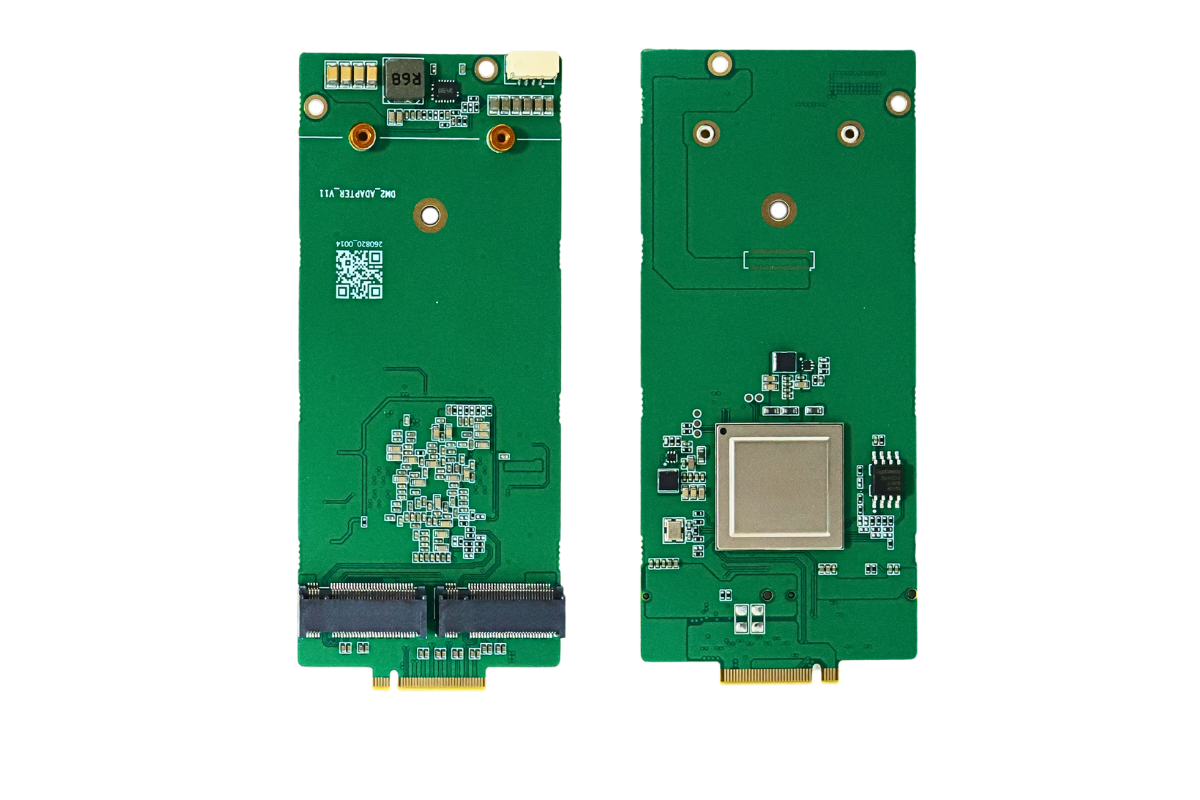
与瑞芯微自家 RK3588、RK3576 等主流主控深度适配,通过 PCIe 2.0 / USB 3.0 接口即插即用,无需更换整机,即可将设备 AI 算力从 6TOPS 升级至 26TOPS,升级成本远低于替换高端主控方案。
配套 RKNN3 SDK 完整支持 TensorFlow、PyTorch、ONNX 等主流框架,对 Qwen、MiniCPM、DeepSeek 等国产大模型做了深度优化,40+ 主流模型可开箱即用,开发门槛较低。同时支持多卡级联,4 卡组合可实现 80TOPS 总算力,支撑 27B 级别模型本地推理,扩展性灵活。
3. 工业级可靠性,场景适配广泛
支持 -40℃ ~ 85℃ 工业宽温工作,适配工业视觉检测、边缘计算网关、输电线路巡检、铁路巡防等严苛场景。
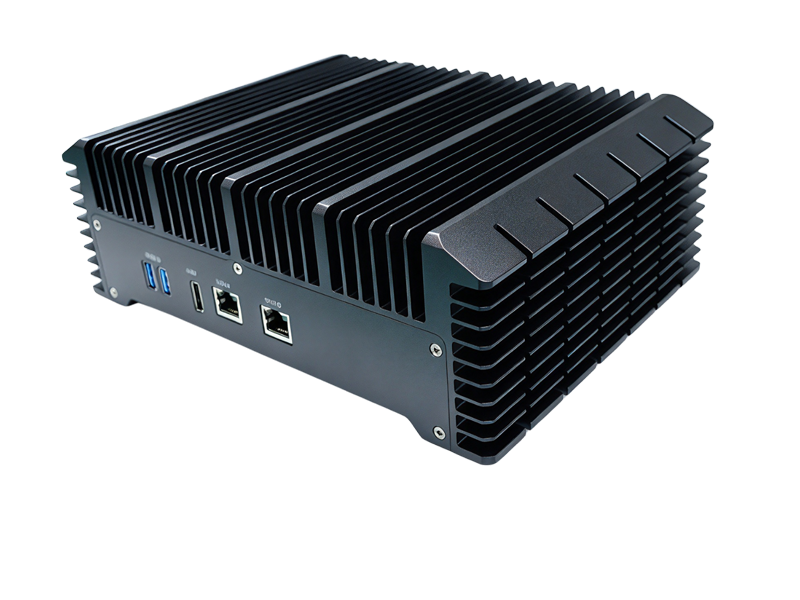
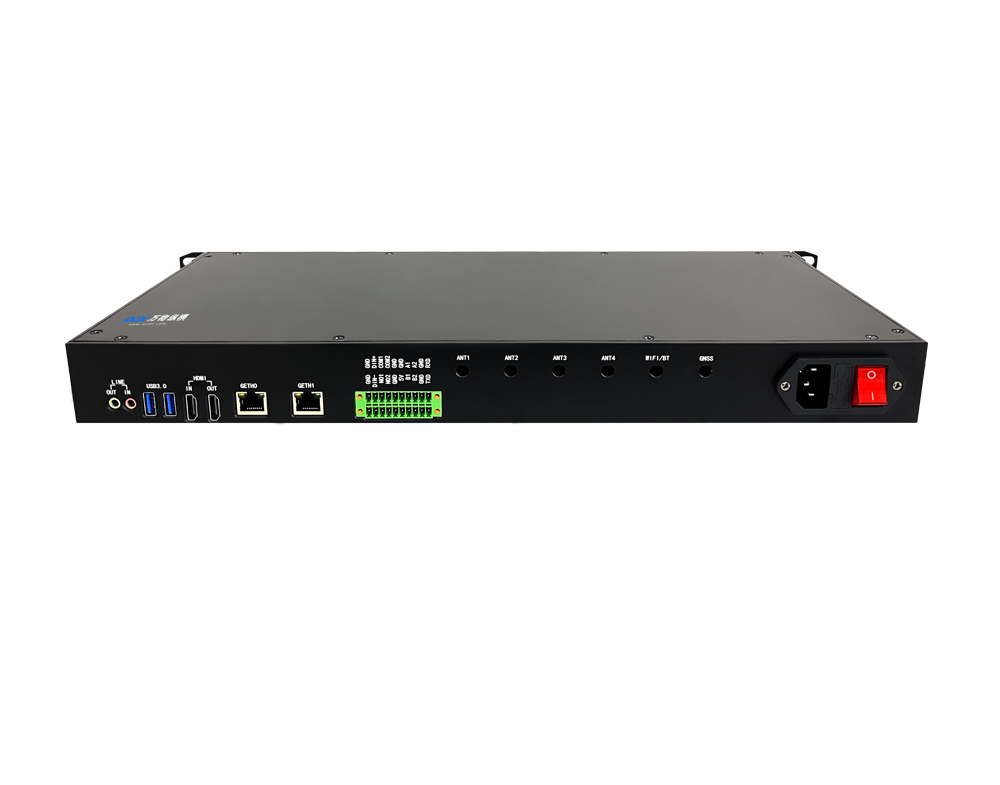
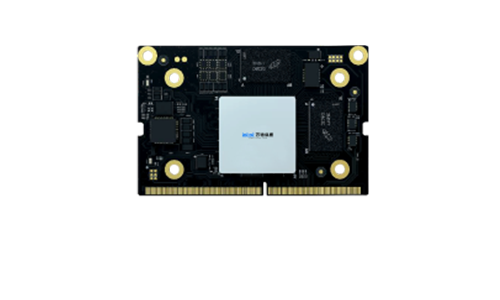
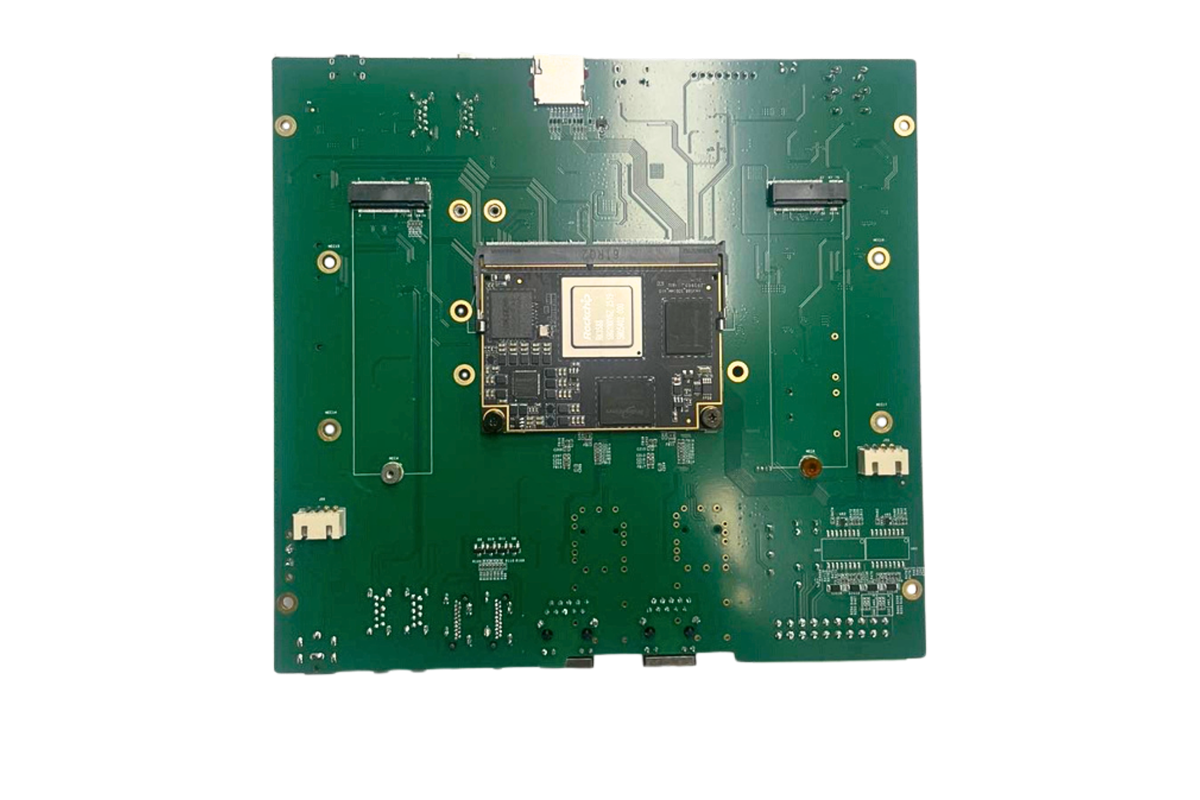
提供 M.2 2280 和 SO-DIMM 两种标准形态,可灵活集成到开发板、工业整机、智能终端等不同设备中;自带 2D 图形引擎与 JPEG 编解码硬件,可独立完成图像预处理,不占用主控 CPU/NPU 资源,多任务并发稳定性更好。
4. 全精度覆盖,兼顾大模型与传统视觉
支持 INT4 / INT8 / INT16 / FP8 / FP16 / BF16 混合精度运算,既可以通过 INT4 量化运行 7B 级大语言模型,也能以 INT8 精度高效运行 YOLO 等传统视觉模型——实测 YOLOv5s 推理耗时稳定在 31ms 以内,满足工业实时检测要求。
三、明显短板
1. 制程保守,纯算力天花板有限
采用 20nm 成熟制程,供应链安全、良率高,但算力密度与 12nm / 7nm 竞品有差距,单卡 20TOPS INT8 属于入门到中端水平,不适合高算力密度需求场景;PCIe 2.0 x1 接口带宽有限,多卡级联或大数据量传输时存在瓶颈。
2. 仅为协处理器,无法独立运行
必须搭配主控 SoC 使用,不能单独作为设备主控,不适合单芯片极简方案;内置的三核 RISC-V 仅用于任务调度,性能较弱,无法承担系统级运算。
3. 视频编解码能力薄弱
仅集成 JPEG 编解码,无 H.264 / H.265 硬件视频编解码单元,多路视频分析场景必须依赖主控,在安防、视频流处理类场景中,相比 CV186AH 这类集成 VPU 的完整 SoC 劣势明显。
四、在国产边缘 AI 芯片中的定位
国产边缘 AI 芯片可分为三大赛道,不同赛道定位差异极大,不能单纯以算力数值横向对比:
赛道分类 | 代表产品 | 核心定位 | 算力区间 |
通用边缘计算 SoC(单芯片方案) | 算能 CV186AH、瑞芯微 RK3588、地平线旭日 5 | 集成 CPU / NPU / VPU / 外设,可独立跑系统,作为设备主控 | 几 TOPS ~ 几十 TOPS |
边缘 AI 协处理器 / 加速卡(算力扩展) | 瑞芯微 RK1828、爱芯元智入门级加速卡 | 搭配主控使用,专职 AI 推理,主打存量设备升级 | 十几 TOPS ~ 几十 TOPS |
高端边缘推理卡(边缘服务器级) | 算能 BM1688、华为昇腾 310、寒武纪思元边缘系列 | 边缘机房 / 网关级部署,高算力密度 | 上百 TOPS |
RK1828 属于边缘 AI 协处理器赛道的中端主力,是国产端侧大模型轻量化加速的第一梯队产品:
1. 协处理器赛道内,架构创新领先:它是国产少有的采用 3D 堆叠内存、专门针对 LLM / VLM 优化的边缘加速卡,大模型实际推理体验远超同算力级别的传统视觉加速卡,甚至能跨级挑战更高算力的通用 SoC。
2. 与通用 SoC 互补而非竞争:对比同价位的 CV186AH(7.2TOPS INT8,完整 SoC),RK1828 纯 AI 算力是其近 3 倍,大模型性能优势显著,但缺少主控能力与视频编解码,二者分别对应"算力扩展"和"单芯片方案"两个不同需求。
3. 产业地位上,是瑞芯微"双轨战略"的核心:瑞芯微在 AIoT 与工业边缘领域属于国产第一梯队平台厂商,RK1828 补齐了其"主控 SoC + 协处理器"双轨产品线的大模型算力短板,填补了"低成本存量设备升级大模型能力"的市场空白,目前已在机器人、工业视觉、智能终端等几十个行业落地量产。
五、总结
整体而言,RK1828 不是一款"堆算力参数"的产品,而是精准卡位端侧市场需求,用架构创新实现了低功耗下的大模型落地,是一款定位清晰、性价比突出的国产边缘 AI 加速方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部