
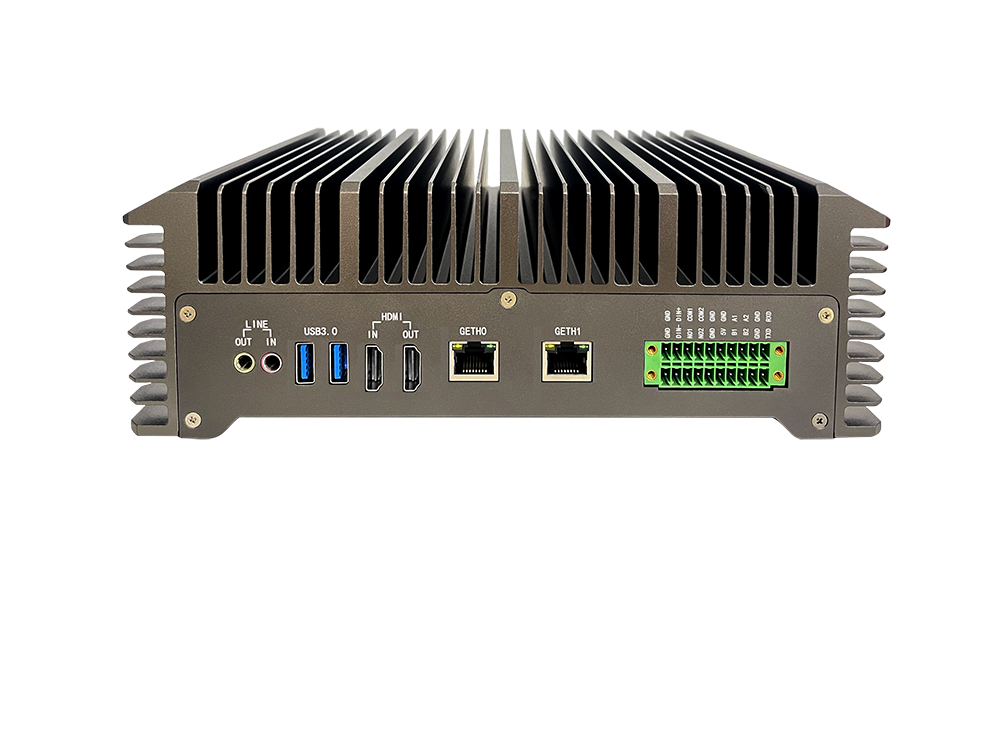
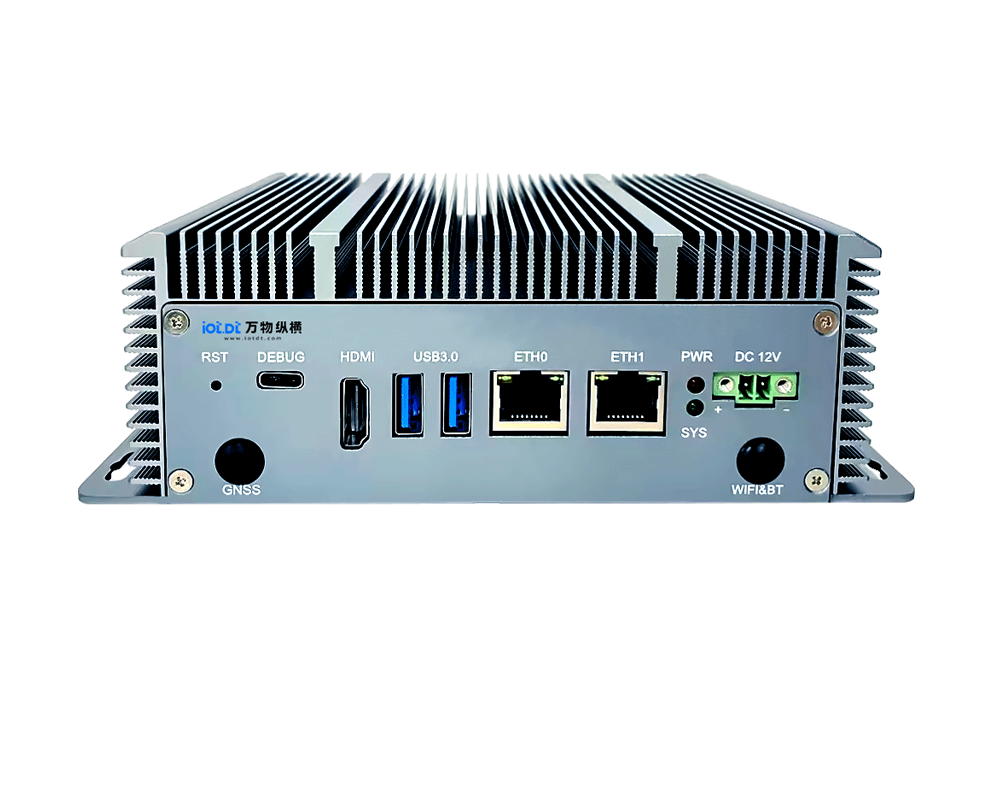
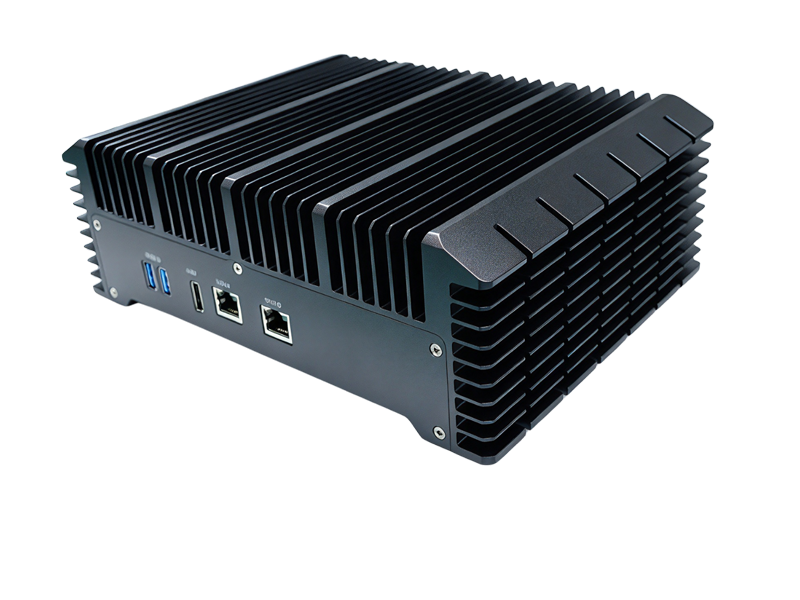
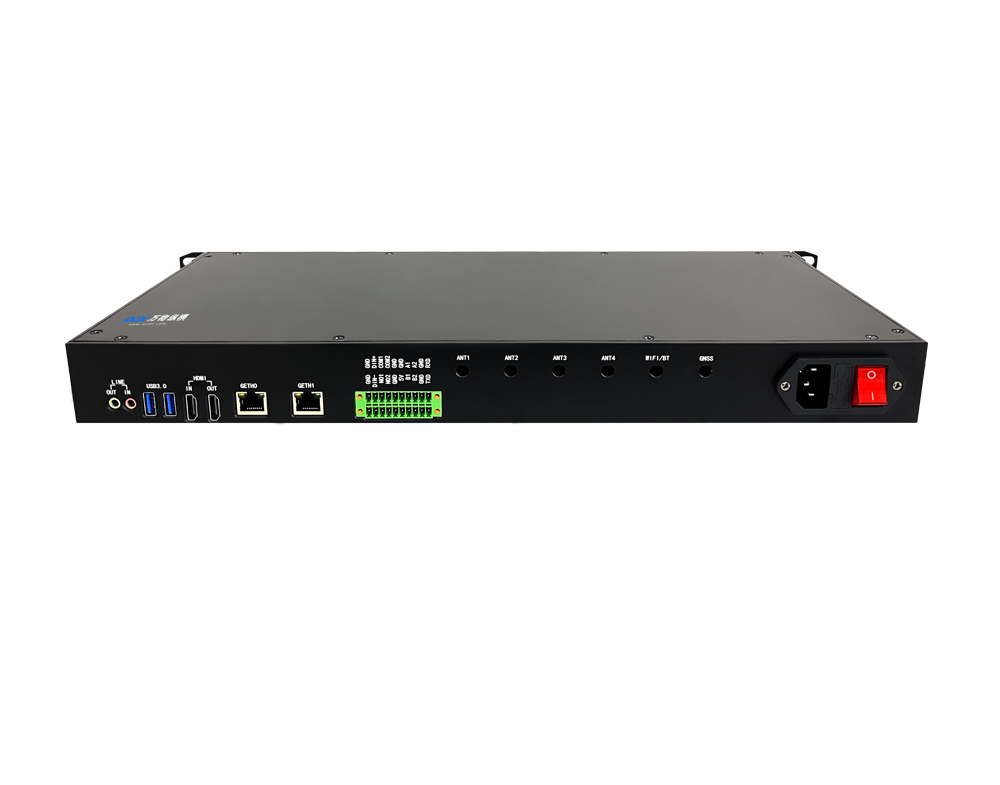
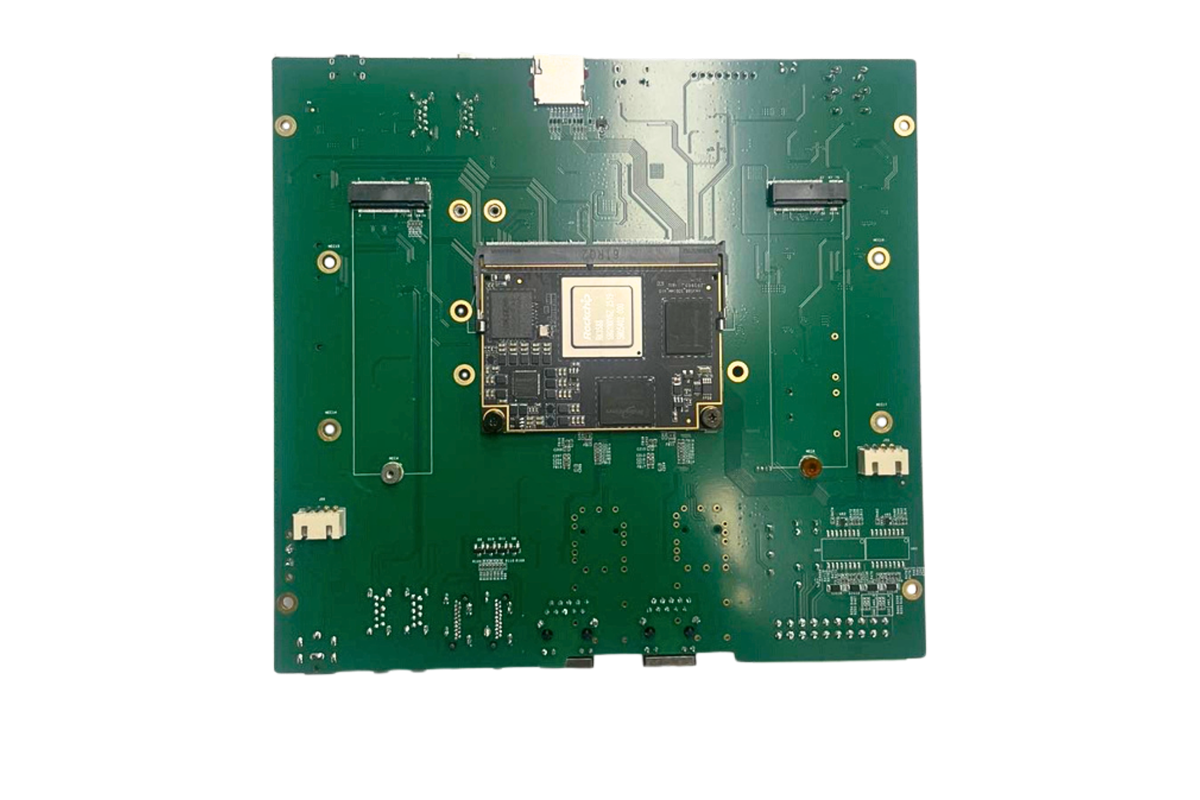


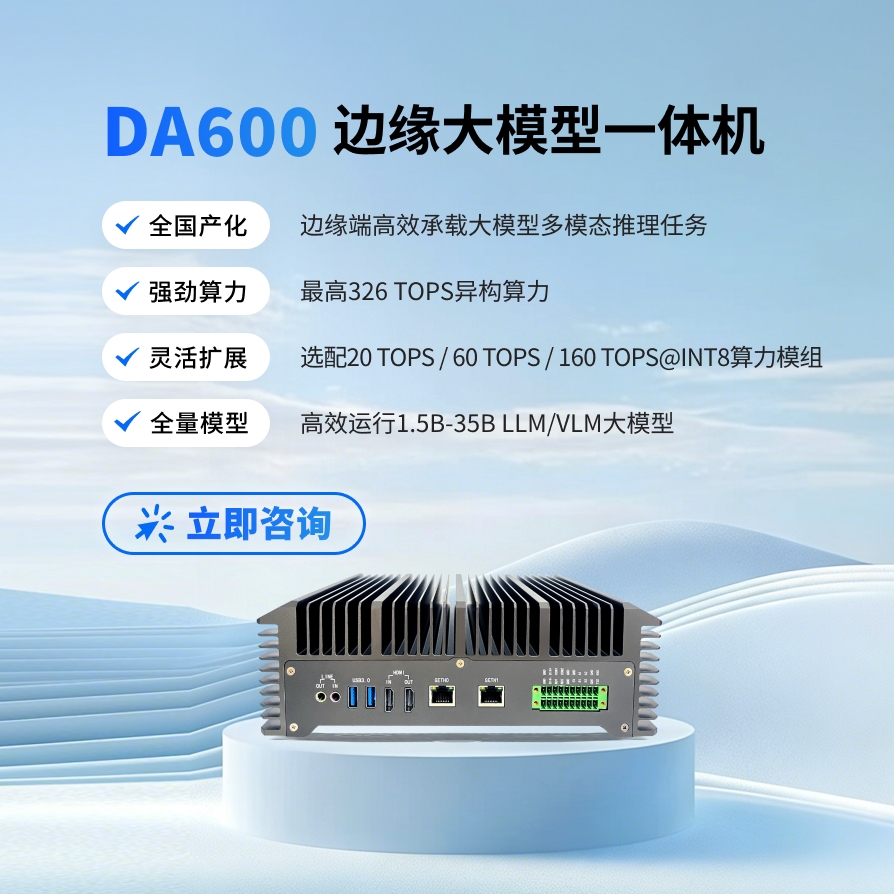
这套方案采用主控+AI协处理器的任务级异构架构,并非简单的算力叠加,核心逻辑是 RK3588 负责系统调度、外设与视频业务,RK1828 专职承载大模型推理,在边缘端场景下的体验可以从硬件架构、性能表现、部署适配、局限短板四个维度展开。
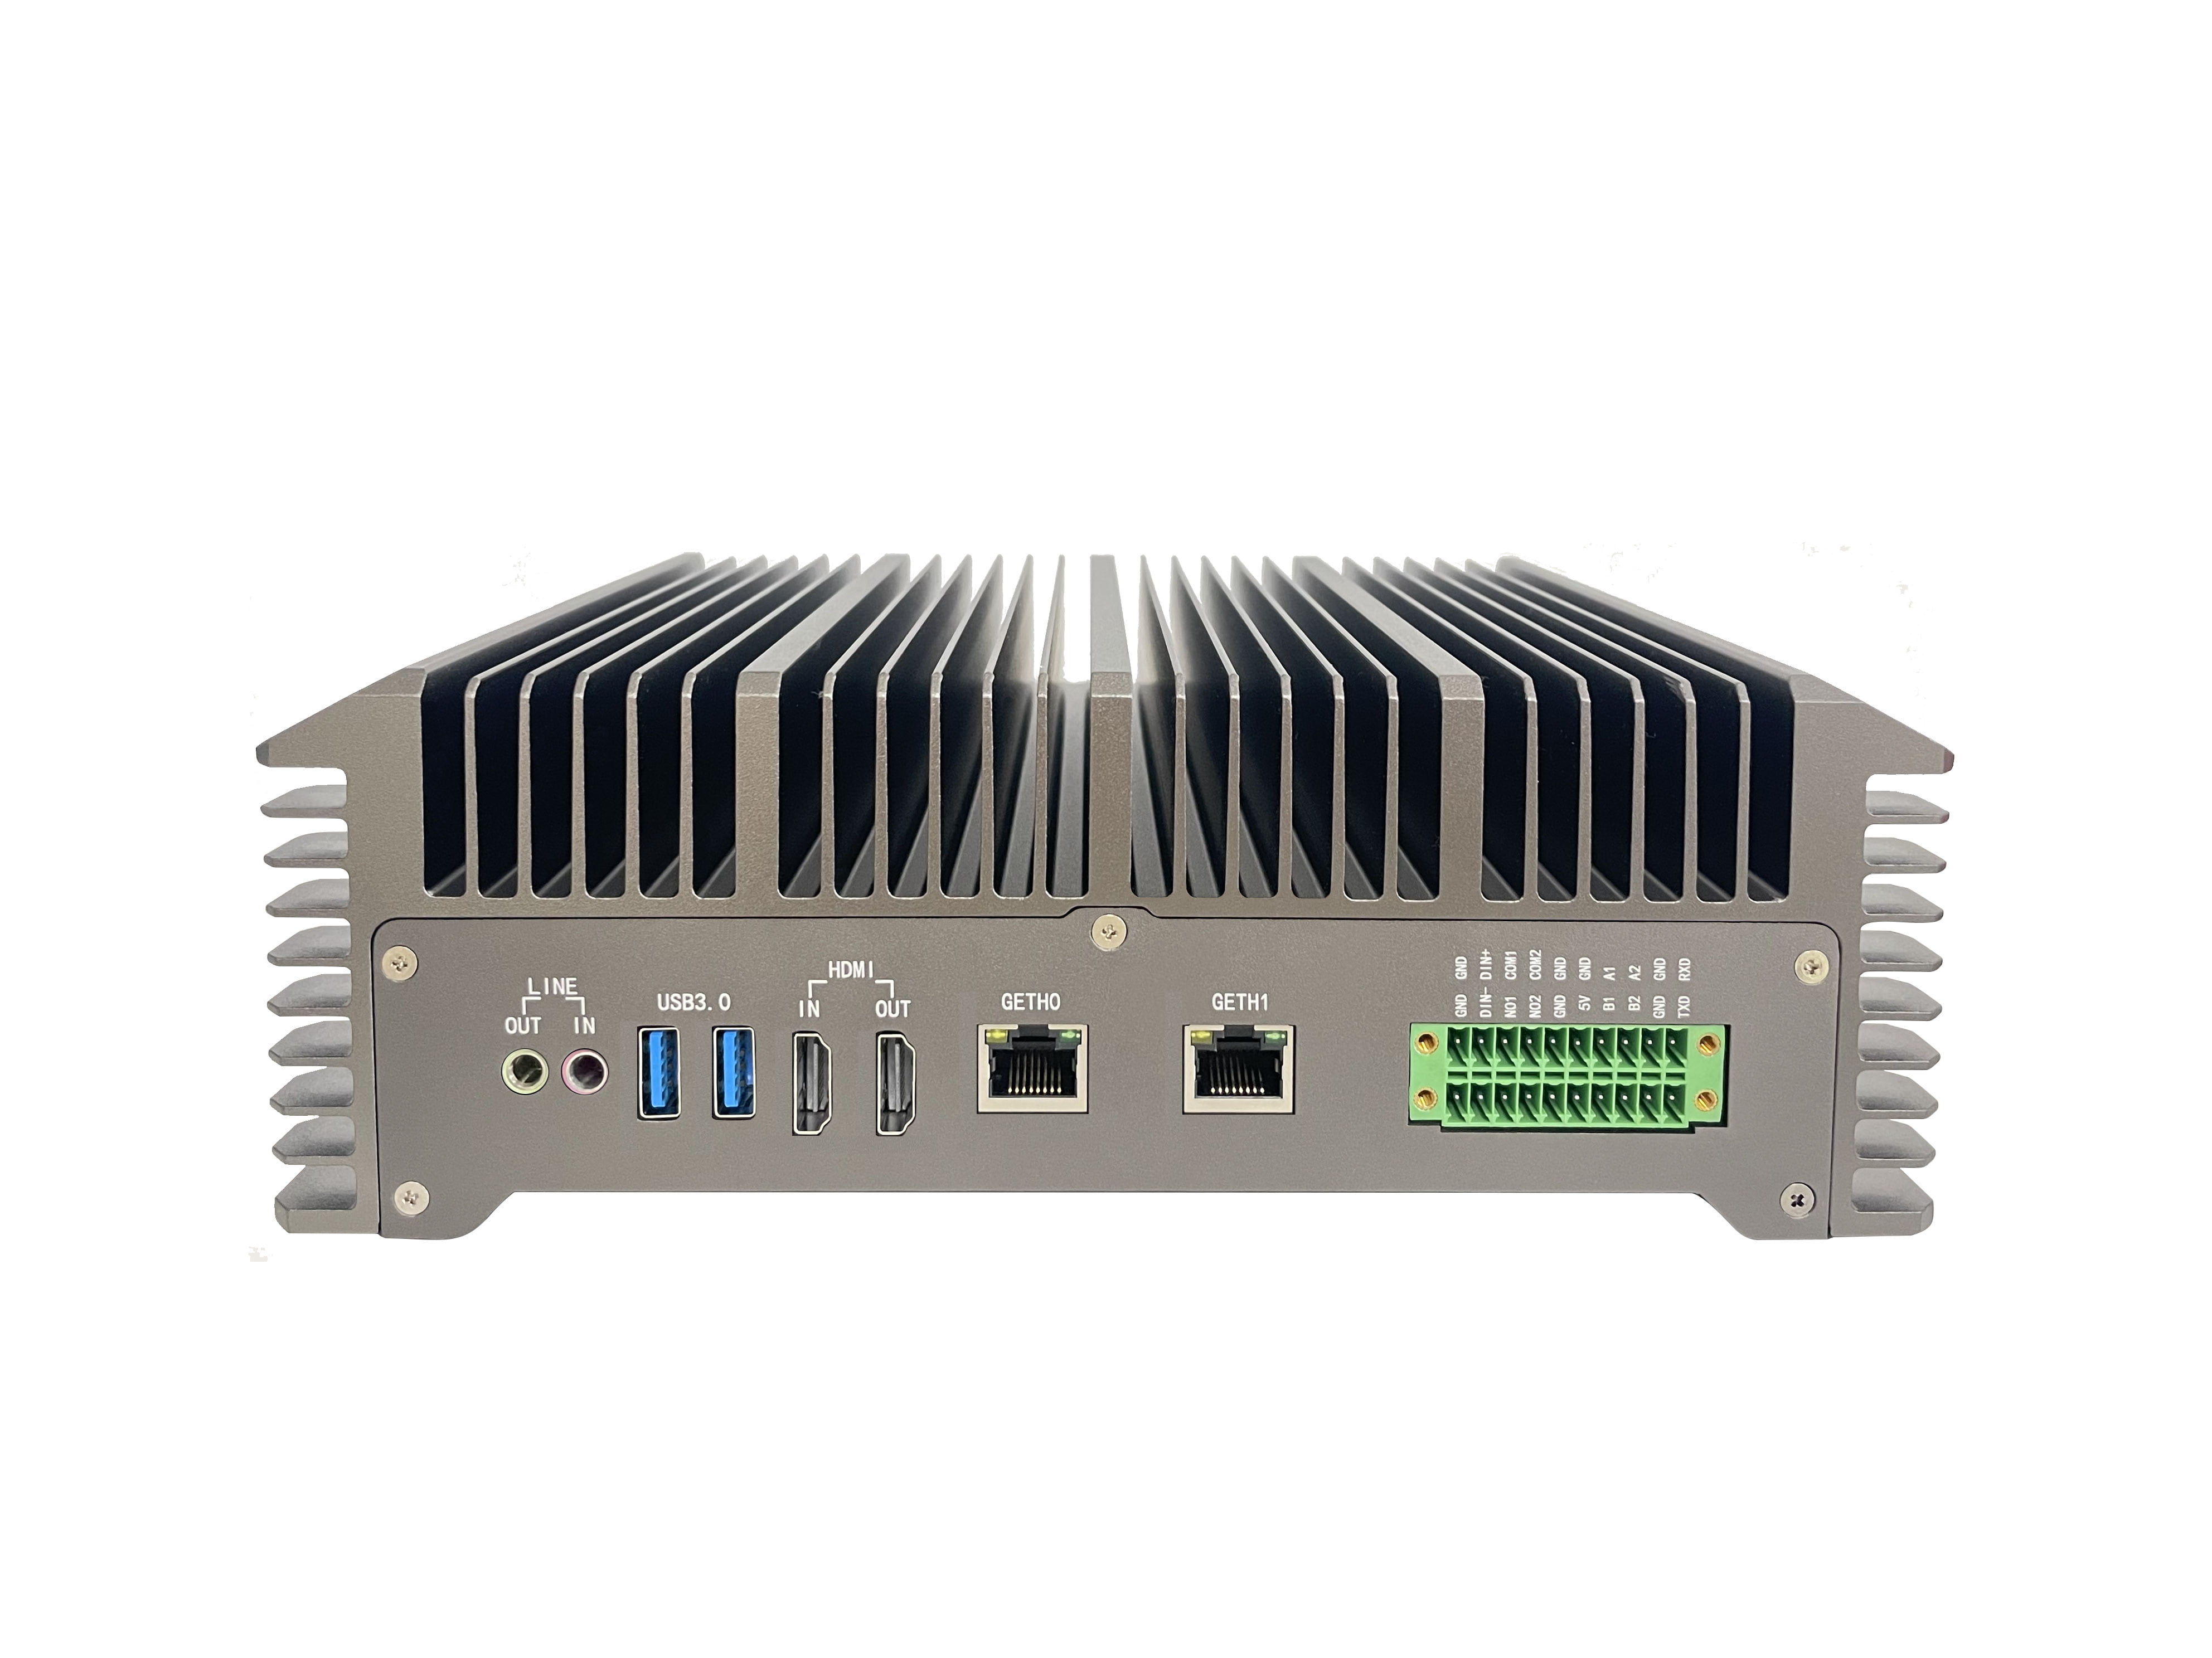
硬件协同与互联基础
接口与互联方式
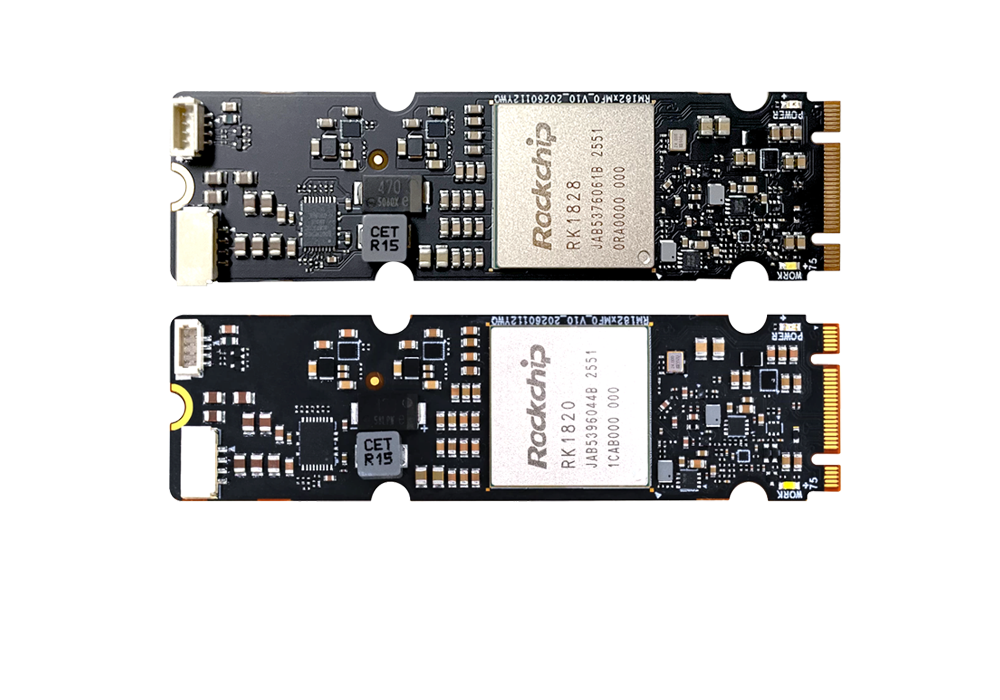
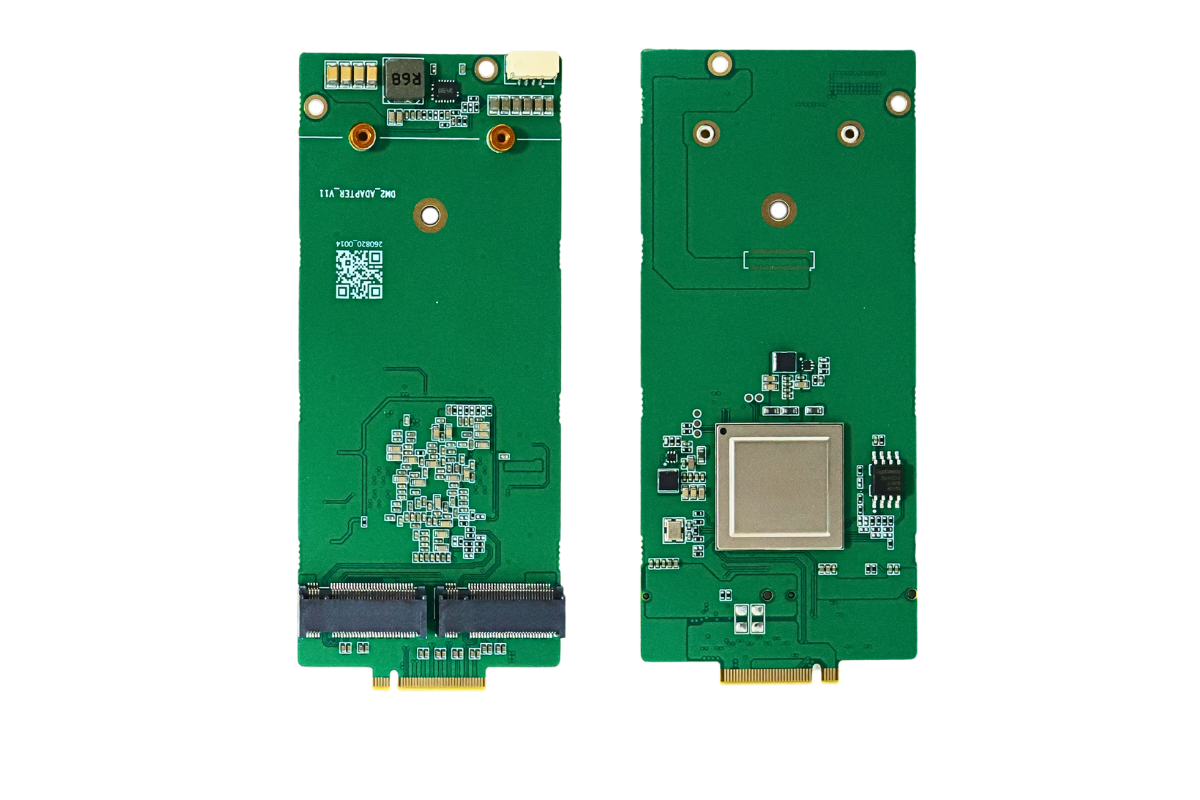
RK1828 算力卡通常采用 M.2 2280(Key B-M)形态,通过PCIe 2.1 x1 与 RK3588 的 M.2 插槽连接,单链路带宽约 5Gbps,物理和电气上与 RK3588 的 PCIe 3.0 接口兼容,即插即用,无需额外硬件改造。RK3588 最多可扩展 2~4 张 RK1828,满足阶梯式算力升级需求。
资源分工与隔离
RK3588:承载操作系统、外设驱动、8K 视频编解码、多路摄像头接入、轻量视觉推理(如 YOLO 小模型)等通用业务,自带 6TOPS INT8 NPU 不参与大模型核心推理;
RK1828:专职负责 LLM/VLM 大模型推理,单卡提供 20TOPS INT8 算力,内置 5GB 3D 堆叠片上 DRAM,内存带宽达 1024GB/s,完全不占用 RK3588 的系统内存,从硬件层面避免了大模型与业务系统抢资源的卡顿问题。
大模型推理性能实测
当前主流 SDK(RKNN3 V1.0 及以上)已完成深度优化,不同参数量模型的实测表现如下(均为 INT4/INT8 量化、端侧本地推理数据):
模型型号
| 上下文长度 | 首Token延迟(TTFT) | 解码速度(Decode TPS) | 数据来源 |
Qwen2.5-0.5B | 1024 | ~166ms | 160~216 tokens/s | 飞凌嵌入式、瑞芯微官方 |
Qwen2.5-1.5B | 1024 | ~323ms | 107~111 tokens/s | 飞凌嵌入式 |
Qwen2.5-3B | 1024 | ~527ms | 78~102 tokens/s | 飞凌嵌入式、瑞芯微官方 |
Qwen3-7B/8B | 1024 | ~1s 内 | 40~61 tokens/s | 瑞芯微官方、行业方案商 |
Qwen3.5-9B(双 RK1828) | 4K | — | ~33 tokens/s | Firefly 社区多卡测试 |
Qwen3.8-27B(四 RK1828) | 4K | ~6.9s | ~13 tokens/s | 飞凌四卡级联方案 |
实际交互体验
3B 及以下模型对话流畅度接近云端轻量模型,首字延迟低于 0.6 秒,生成速度肉眼无等待感;7B 级别模型可满足日常问答、知识库 RAG 等场景,连续生成无明显卡顿;10B 以上模型需多卡级联,更侧重模型容量而非交互速度,适合离线总结、长文本处理等非实时场景。
部署落地的核心优势
业务与算力解耦,稳定性强
这是该方案相比纯单芯片方案的最大价值:工业、安防等场景中,RK3588 可同时跑 36 路视频解码+轻量 AI 分析,RK1828 独立承载本地大模型,两者互不抢占资源,不会因为大模型推理导致视频掉帧、系统卡死,长期运行稳定性远高于单芯片跑全部业务的方案。
软件栈成熟,部署门槛低
瑞芯微官方 RKNN3 SDK 已完整适配该组合,支持 Linux/Android 系统,提供 Python API 和模型转换工具链,覆盖 Qwen、Gemma、GLM Edge 等 40+ 主流大模型与多模态模型,原生支持 Function Call、mRoPE、RAG 检索等特性,开发者无需从零适配,参照官方示例即可完成部署。
算力弹性扩展,成本可控
无需更换主控主板,通过增减排 RK1828 算力卡即可调整算力,从单卡 26TOPS 到四卡 86TOPS 平滑升级,初期硬件投入低,后续模型升级有充足扩展空间,相比直接更换更高端主控的方案成本优势明显。
现存的短板与局限
单卡模型容量上限明显
RK1828 单卡 5GB 片上内存,INT4 量化下最多稳定承载 7~8B 级模型,10B 以上必须依赖多卡级联;且多卡级联解决的是模型容量问题,吞吐量不会随卡数线性提升,4 卡跑 27B 模型仅 13 tokens/s 左右,大参数量模型的交互体验会明显下降。
PCIe 带宽存在前置瓶颈
受限于 PCIe 2.1 x1 的带宽,长上下文输入的 Prefill 阶段会有延迟损耗,输入长度从 4K 升到 8K 时,首 Token 延迟会翻倍;但 Decode 阶段单 Token 数据量小,带宽几乎不影响生成速度。
小模型性价比不足
1.5B 以下的轻量模型,数据传输的开销会抵消部分算力优势,速度提升幅度有限;部分场景下直接用 RK3588 自带 NPU 运行即可满足需求,外挂算力卡的边际收益不高。
体验总结与适用场景
这套方案不是为了追求极限大模型速度,而是解决边缘端"业务与大模型并行运行"的核心痛点。
体验最佳场景:智慧工地、工业巡检、智能盒子等需要同时跑多路视频+本地大模型的边缘设备,既能保证业务稳定,又能实现离线大模型交互;
不推荐场景:仅需要跑小模型、无并发业务需求的纯对话设备,纯 RK3588 或更低成本主控即可满足,外挂算力卡性价比偏低。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部