
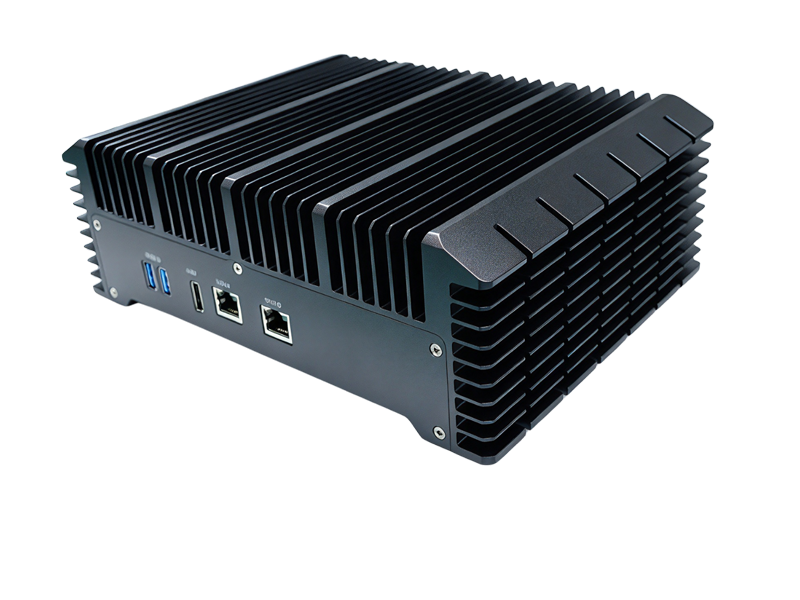
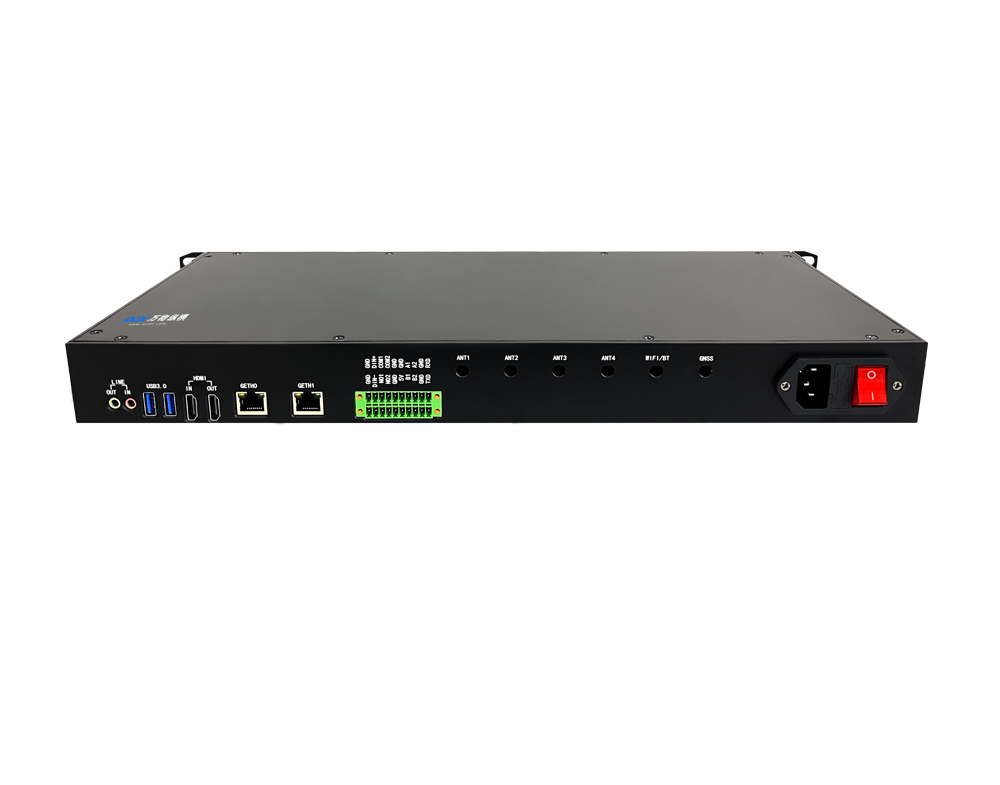
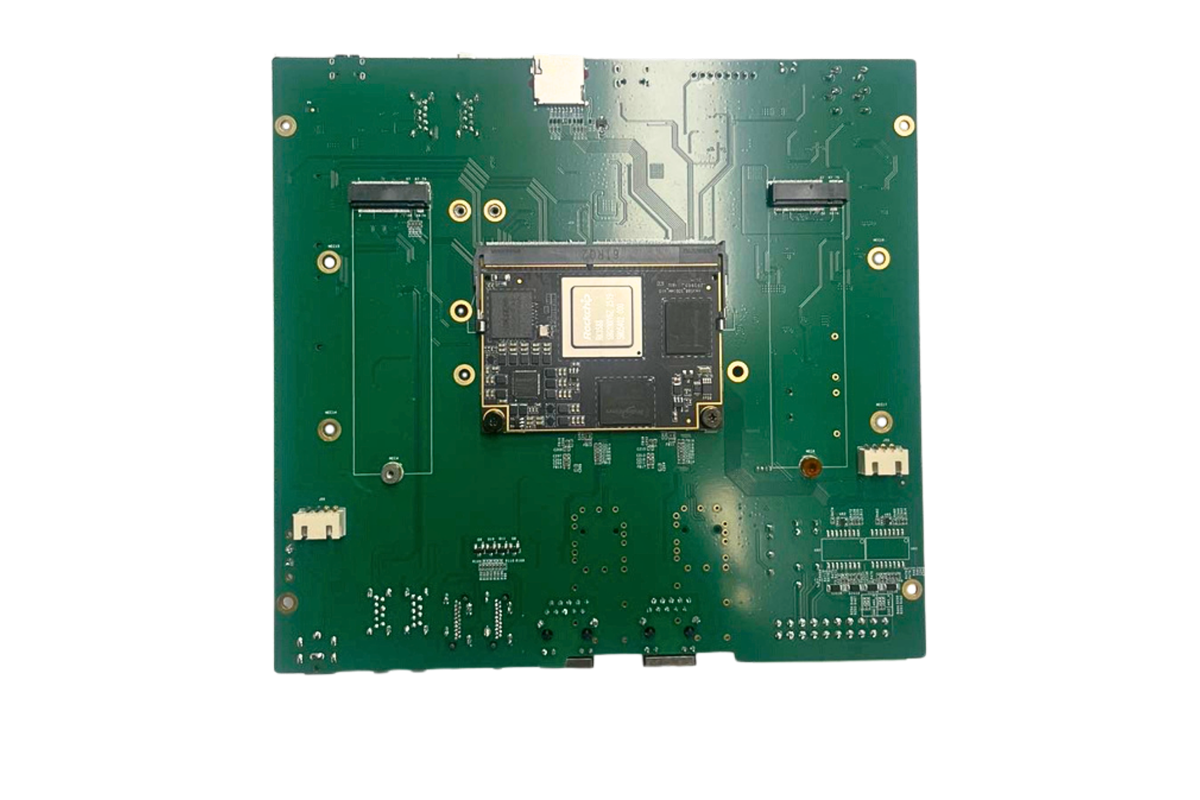
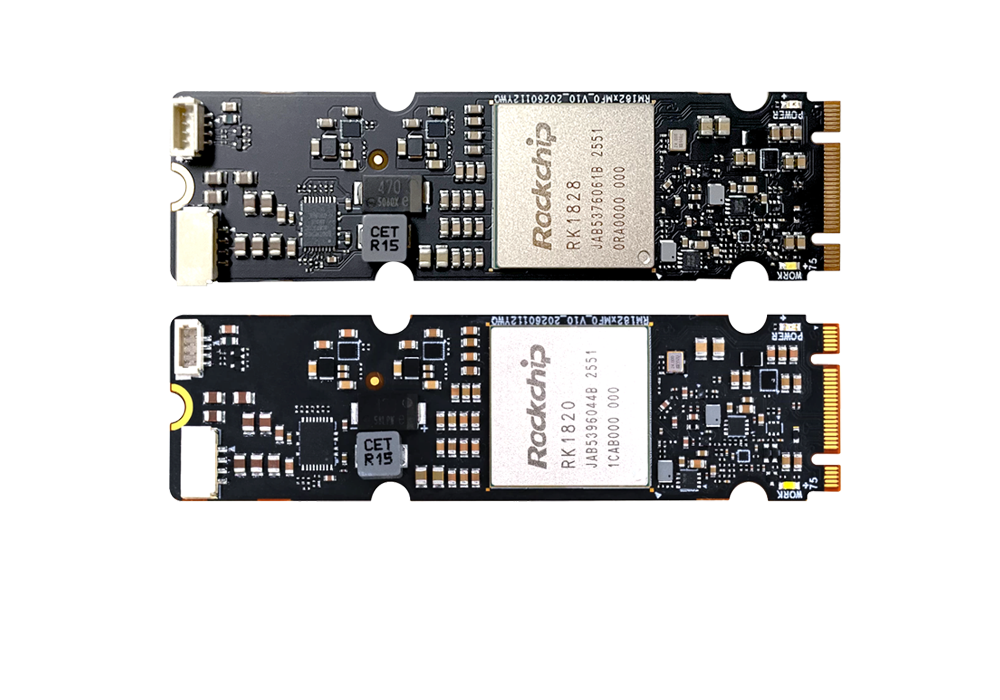
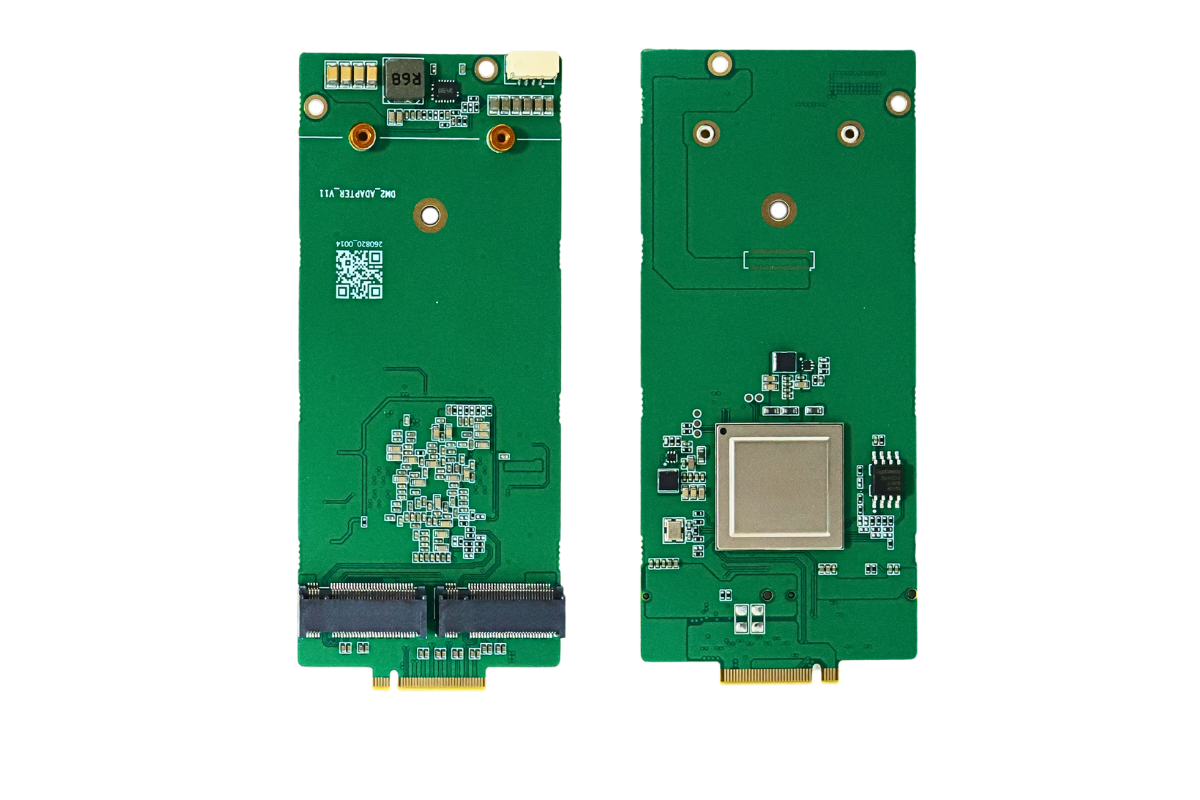


登临 KS20-A 属于登临纳适™系列边缘算力卡,INT8 算力标称约 60TOPS(同系列满血版为 70TOPS),典型功耗 25W,基于自研 GPU+架构,兼容 CUDA 生态。目前已完成多款主流大模型的适配与性能优化,覆盖通用语言、多模态、垂直领域等方向。
一、适配大模型总览
分类 | 模型方向 | 代表模型 | 适配说明 |
通用语言基座 | 通义千问(Qwen)系列 | Qwen2.5、Qwen3(含 Qwen3-30B MoE)、Qwen3.8-27B 等 | 官方 Day0 级适配,边缘场景首选选型 |
通用语言基座 | DeepSeek 系列 | DeepSeek 通用基座、DeepSeek-R1-Distill 等 | 支持轻量化推理部署 |
通用语言基座 | 智谱 GLM 系列 | ChatGLM / GLM 系列开源基座 | 已完成适配优化 |
通用语言基座 | 其他开源主流模型 | 百川(Baichuan)、Llama、Vicuna、BLOOM、GPT-2、OPT、MiniCPM、GPT-OSS、Mimo、Kimi 文本基座、MiniMax 文本基座等 | 均已完成适配验证 |
多模态与生成类 | 视觉多模态 | Qwen2.5-VL、MiniMax H3-Image、MOSS-Image、Pixtral、CHATIMG | 覆盖边缘侧视觉理解场景 |
多模态与生成类 | 图像 / 动效生成 | Stable Diffusion、Wan-Animate(动画生成模型) | 支持边缘端生成类任务 |
多模态与生成类 | 音频生成 | MiniMax-Music3(音乐创作大模型) | 支持边缘端音频创作 |
垂直领域专用 | 计算机视觉类 | PaddleOCR(通用文字识别) | 面向行业边缘识别场景 |
垂直领域专用 | 行业垂类模型 | LTX 等垂直方向大模型 | 面向具体行业边缘部署 |
二、边缘部署能力补充
2.1 模型规模支持
搭配 16GB / 32GB 显存规格。
INT4 量化下,单卡可流畅运行 30B 参数级别的 MoE 大模型(如 Qwen3-30B-A3B)。
INT8 精度下,可稳定部署 7B–14B 级通用大模型,满足边缘侧本地问答、实时推理等核心需求。
2.2 生态与框架
兼容 PyTorch、CUDA 软件生态,模型迁移成本低。
支持 vLLM、LMDeploy 等主流推理框架。
适配 Linux / Windows / Android 多操作系统。
2.3 硬件形态
支持 PCIe、MXM、M.2 多种硬件形态。
可灵活嵌入边缘盒子、工控机、AI 终端等各类边缘设备。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部