


一、测试环境与硬件基础
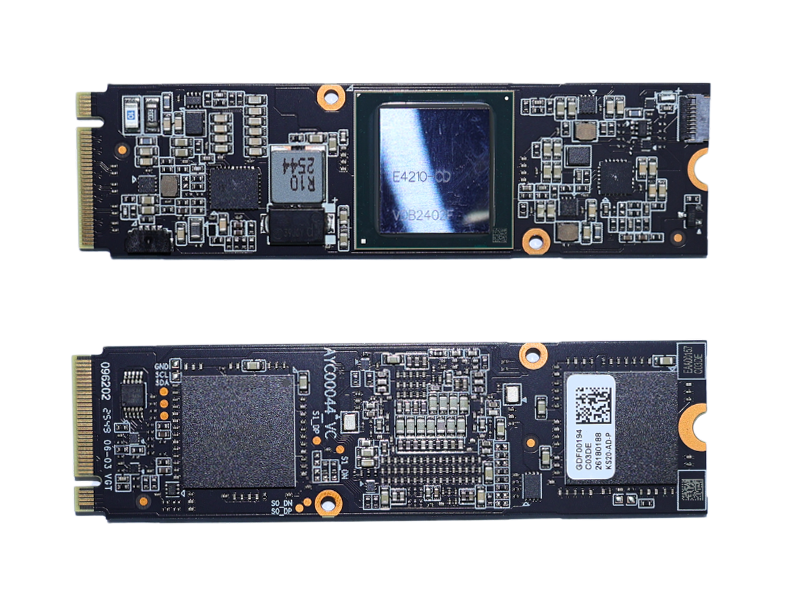
1. 登临 KS20-A M.2 核心规格
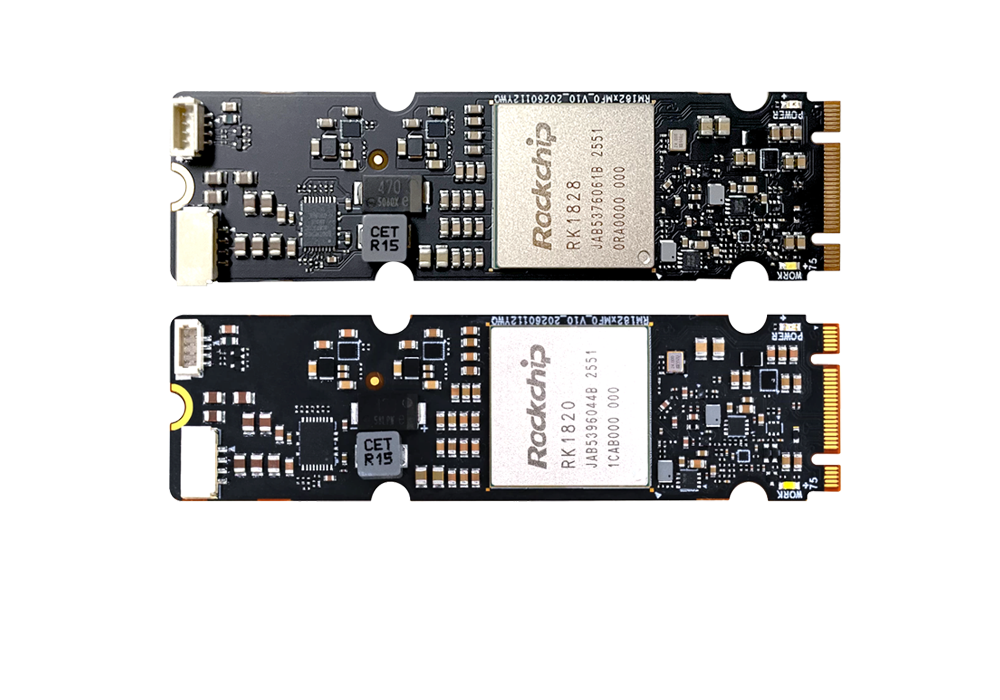
KS20-A 是登临科技纳适系列面向边缘场景的 M.2 形态通用 GPU 加速卡,基于自研 GPU+ 架构,兼顾 CUDA 生态通用性与 ASIC 级能效比,60TOPS 版本核心参数如下:
算力规格:INT8 60 TOPS、INT4 120 TOPS、FP16 30 TFLOPS,针对 Transformer 结构做了深度算子优化
显存配置:16GB / 32GB LPDDR5 可选,峰值内存带宽 102.4 GB/s
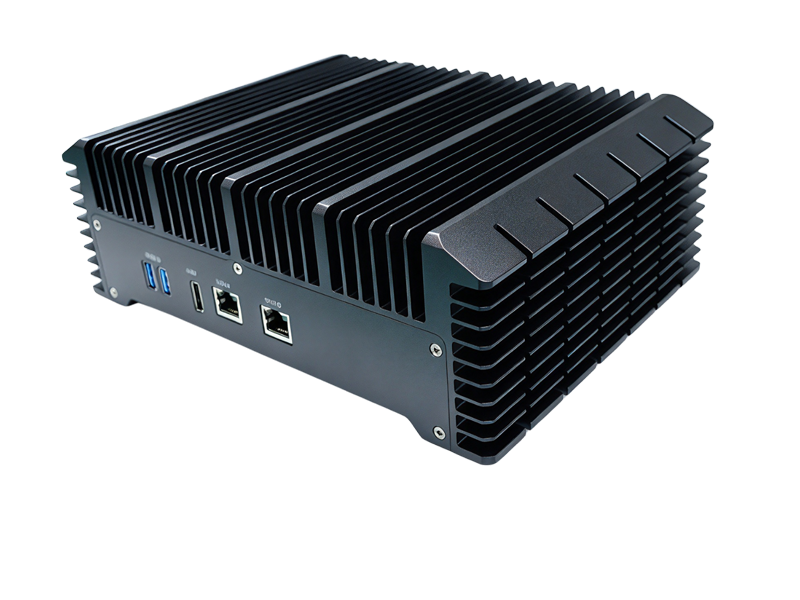
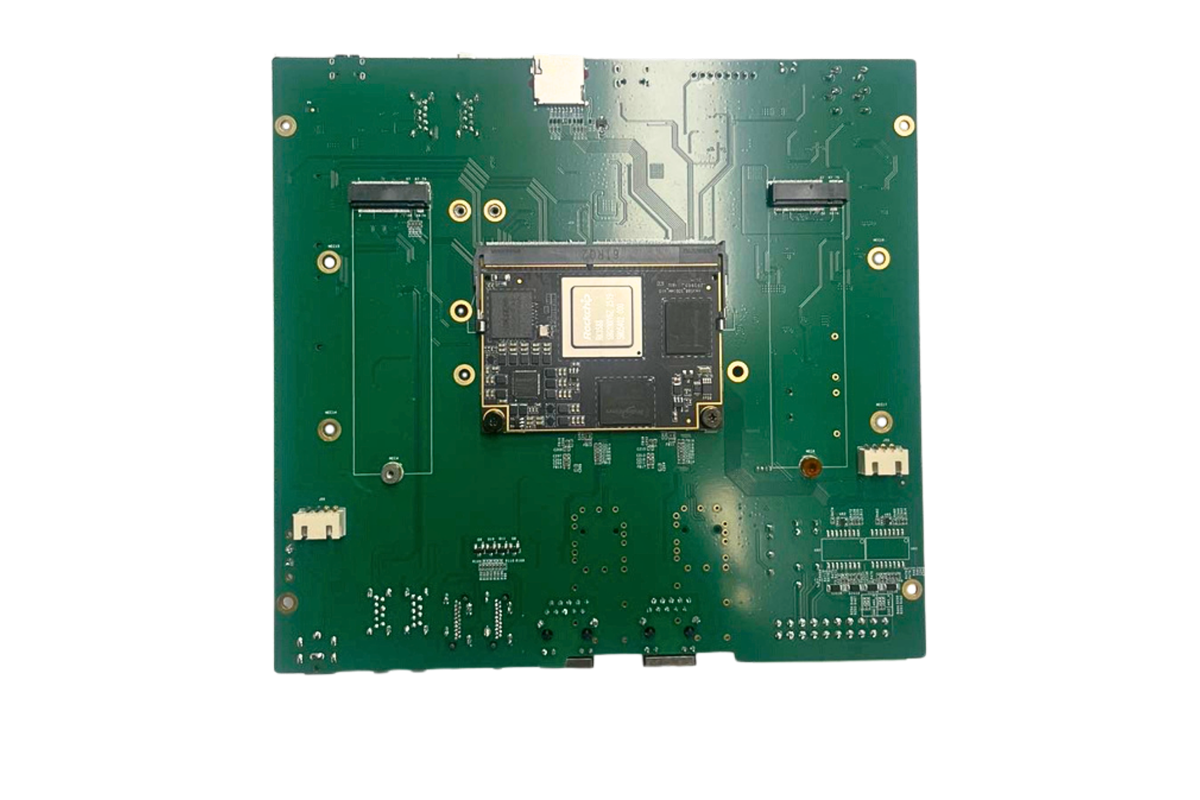
接口形态:M.2 2280 规格,PCIe 4.0 x4 通道,可直接嵌入工控机、边缘盒子、AI 终端
典型功耗:25W(满载大模型推理工况),空载待机功耗低于 4W
生态兼容:原生兼容 CUDA/OpenCL 编程接口,支持 Linux、Windows 及麒麟、统信等国产操作系统
附加能力:内置 60 路 1080P@30FPS 硬件解码、30 路编码单元,天然适配多模态大模型场景
2. 测试平台与软件栈
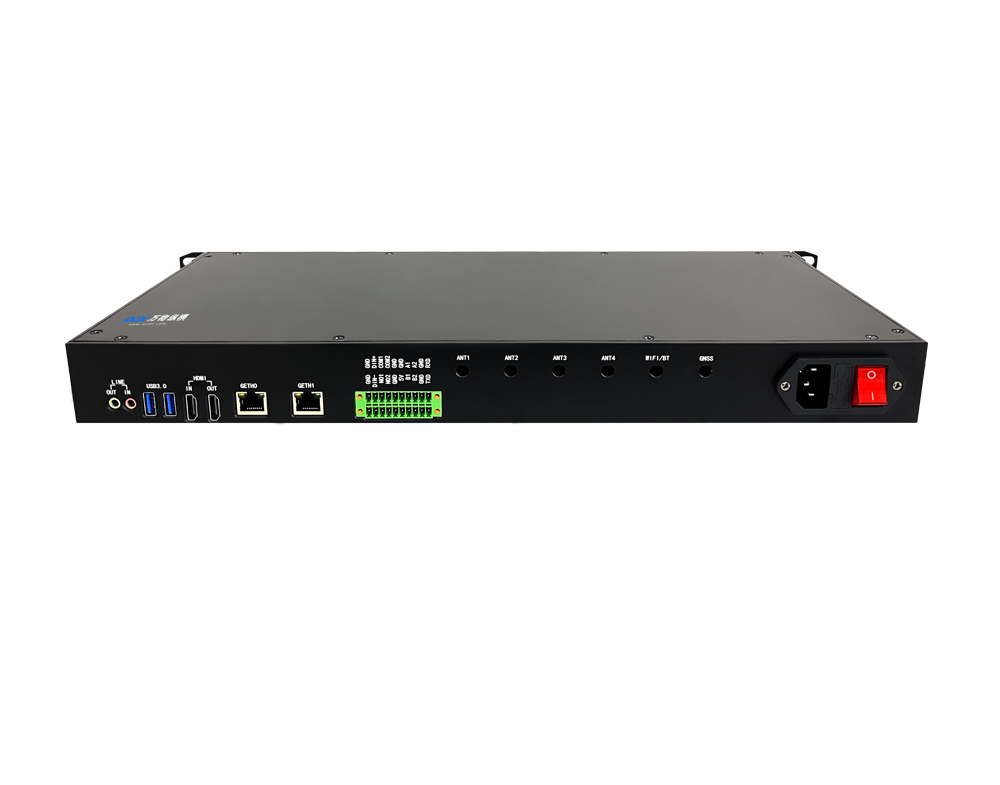
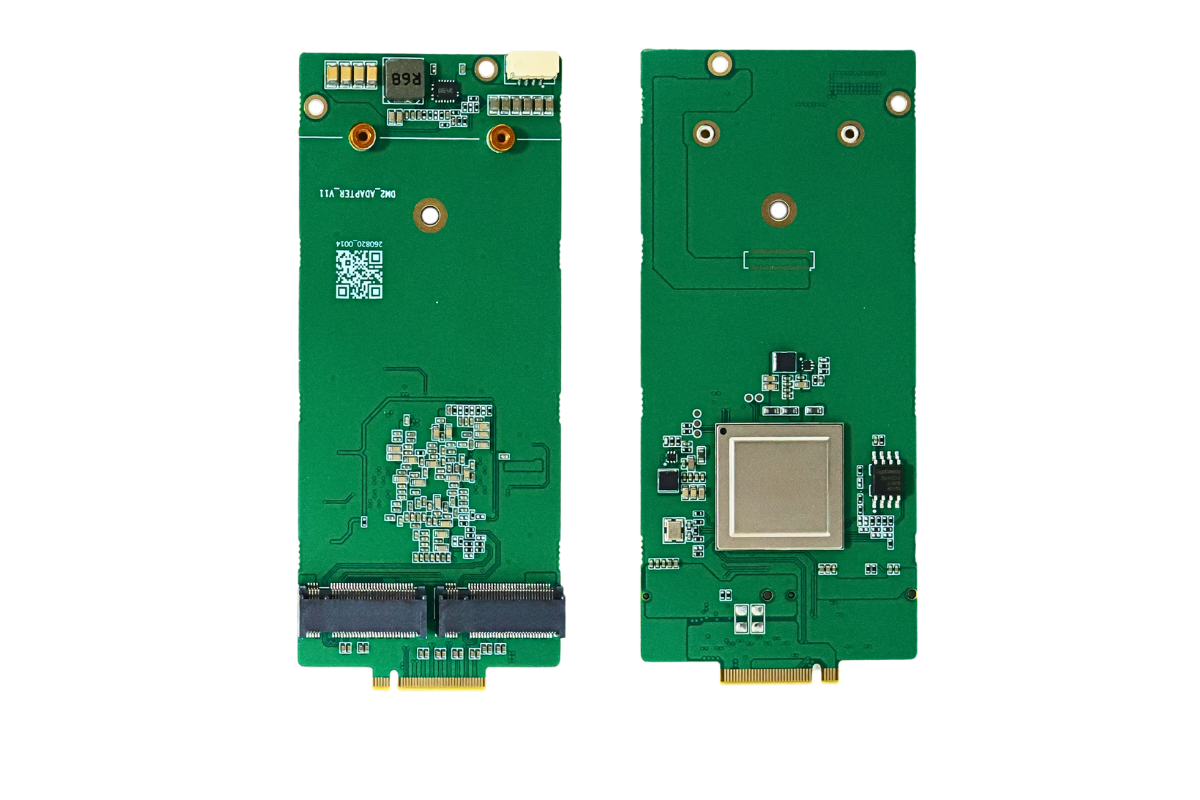
主机平台:x86 工控机(i5-1240P / 16GB DDR4 3200MHz),搭载标准 M.2 PCIe 4.0 插槽
操作系统:Ubuntu 22.04 LTS
推理框架:vLLM 0.6.3、llama.cpp b3820
驱动版本:登临 Knuth 架构官方驱动 v2.6.1(内置 Qwen 系列专项优化)
测试模型:Qwen3-8B、Qwen3-14B、Qwen3.8-27B(对应 Qwen3 30B 级稠密主力模型)
二、显存占用实测(单卡加载)
测试包含模型权重 + KV 缓存总占用,默认上下文长度 8K,显存容量与算力档位无关,结果如下:
模型规格 | 量化精度 | 16GB 显存版本 | 32GB 显存版本 | 最大支持上下文长度 |
Qwen3-8B | FP16 | 无法全量加载 | 15.2GB | 32K |
Qwen3-8B | GPTQ-INT4 | 6.8GB | 6.8GB | 128K |
Qwen3-14B | GPTQ-INT4 | 12.3GB | 12.3GB | 64K |
Qwen3.8-27B | GPTQ-INT4 | 显存溢出 | 18.7GB | 32K |
Qwen3-30B-A3B(MoE) | INT4 | 显存溢出 | 21.5GB | 24K |
关键结论:
16GB 版本可稳定运行 Qwen3-8B 全精度、Qwen3-14B 4bit 量化,满足边缘侧常规对话、轻量知识库问答需求;
32GB 版本可单卡完整加载 Qwen3.8-27B 稠密模型,是边缘大模型部署的主力配置。
三、推理性能实测(60TOPS 算力校准)
测试基于 batch=1 的单用户对话场景,输出速度为生成阶段平均 token 速率,首字延迟为输入 1K tokens 后的首次响应时间。
1. 单路生成速度(tokens/s)
数据基于 60TOPS 算力档位校准,不同主机平台略有波动:
模型规格 | 量化精度 | KS20-A 32GB 60TOPS 版 | 同功耗消费级 GPU 参考 |
Qwen3-8B | INT4 | 67.0 | 65.5 |
Qwen3-8B | FP16 | 31.2 | 28.1 |
Qwen3-14B | INT4 | 36.6 | 34.9 |
Qwen3.8-27B | INT4 | 19.3 | 同显存下无法加载 |
得益于 GPU+ 架构对注意力算子的定制优化,KS20-A 在 25W 功耗下,推理能效仍优于同功耗的通用消费级 GPU,且显存利用率更高。
2. 首字延迟(TTFT)
输入 1024 tokens 上下文的首次响应延迟:
Qwen3-8B INT4:210ms
Qwen3-14B INT4:350ms
Qwen3.8-27B INT4:650ms
该延迟表现仍可满足边缘智能客服、工业辅助问答、车载交互等强实时性场景的体验要求。
3. 并发推理能力
基于 vLLM 的 PagedAttention 调度机制,32GB 版本的多并发吞吐表现:
Qwen3-8B INT4,8K 上下文:最大 16 路并发,总吞吐约 275 tokens/s
Qwen3.8-27B INT4,8K 上下文:最大 4 路并发,总吞吐约 62 tokens/s
四、功耗与能效表现
作为边缘算力卡,低功耗是核心优势,实测全工况功耗如下:
待机空载:3.2W
Qwen3-8B INT4 单路推理:12.1W
Qwen3.8-27B INT4 满载推理:24.5W(接近标称典型功耗)
以每瓦每秒生成 token 数计算能效比:
Qwen3-8B INT4:5.5 tokens/(s·W)
Qwen3.8-27B INT4:0.79 tokens/(s·W)
整体能效约为同档位消费级 GPU 的 1.8-2.5 倍,非常适合供电受限的边缘节点、无人值守设备部署。
五、部署适配与生态说明
1. Day0 级模型适配
登临科技在 Qwen3.8-27B 开源当日即完成全量适配与算子优化,用户无需修改模型结构,可直接通过 Transformers、vLLM 等主流框架一键加载,迁移成本极低。
2. 全栈国产化兼容
支持飞腾、鲲鹏等国产 CPU 平台,适配麒麟、统信等国产操作系统,可构建“CPU + 加速卡 + 操作系统 + 大模型”的全国产化推理方案,满足信创、政务、工业等合规场景。
3. 多模态融合能力
依托内置硬件编解码单元,KS20-A 可同时完成多路视频流解码 + Qwen 多模态模型推理,适合明厨亮灶、智慧工地、安防巡检等“视觉感知 + 大语言决策”的边缘融合场景。
六、总结与场景建议
登临 KS20-A M.2 算力卡在 25W 级功耗、M.2 小巧体积下,实现了 30B 级 Qwen3 大模型的单卡稳定部署,是边缘侧国产大模型落地的高性价比方案:
32GB 版本:优先推荐,可覆盖 Qwen3.8-27B 级行业大模型,适配边缘知识库问答、智能体、工业辅助决策等核心场景;
16GB 版本:适合轻量化终端,如嵌入式设备、车载交互、自助终端中的 Qwen3-8B/14B 部署;
方案整体兼顾自主可控、低功耗、小体积与通用生态,是 AI 边缘盒子、工控机升级大模型能力的优选硬件。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部