一、算力卡分类总览(2026 主流在售)1. 国际顶级训练 / 推理 GPU(英伟达 + AMD,商用智算中心主力)英伟达:B200、H300、H200、H10
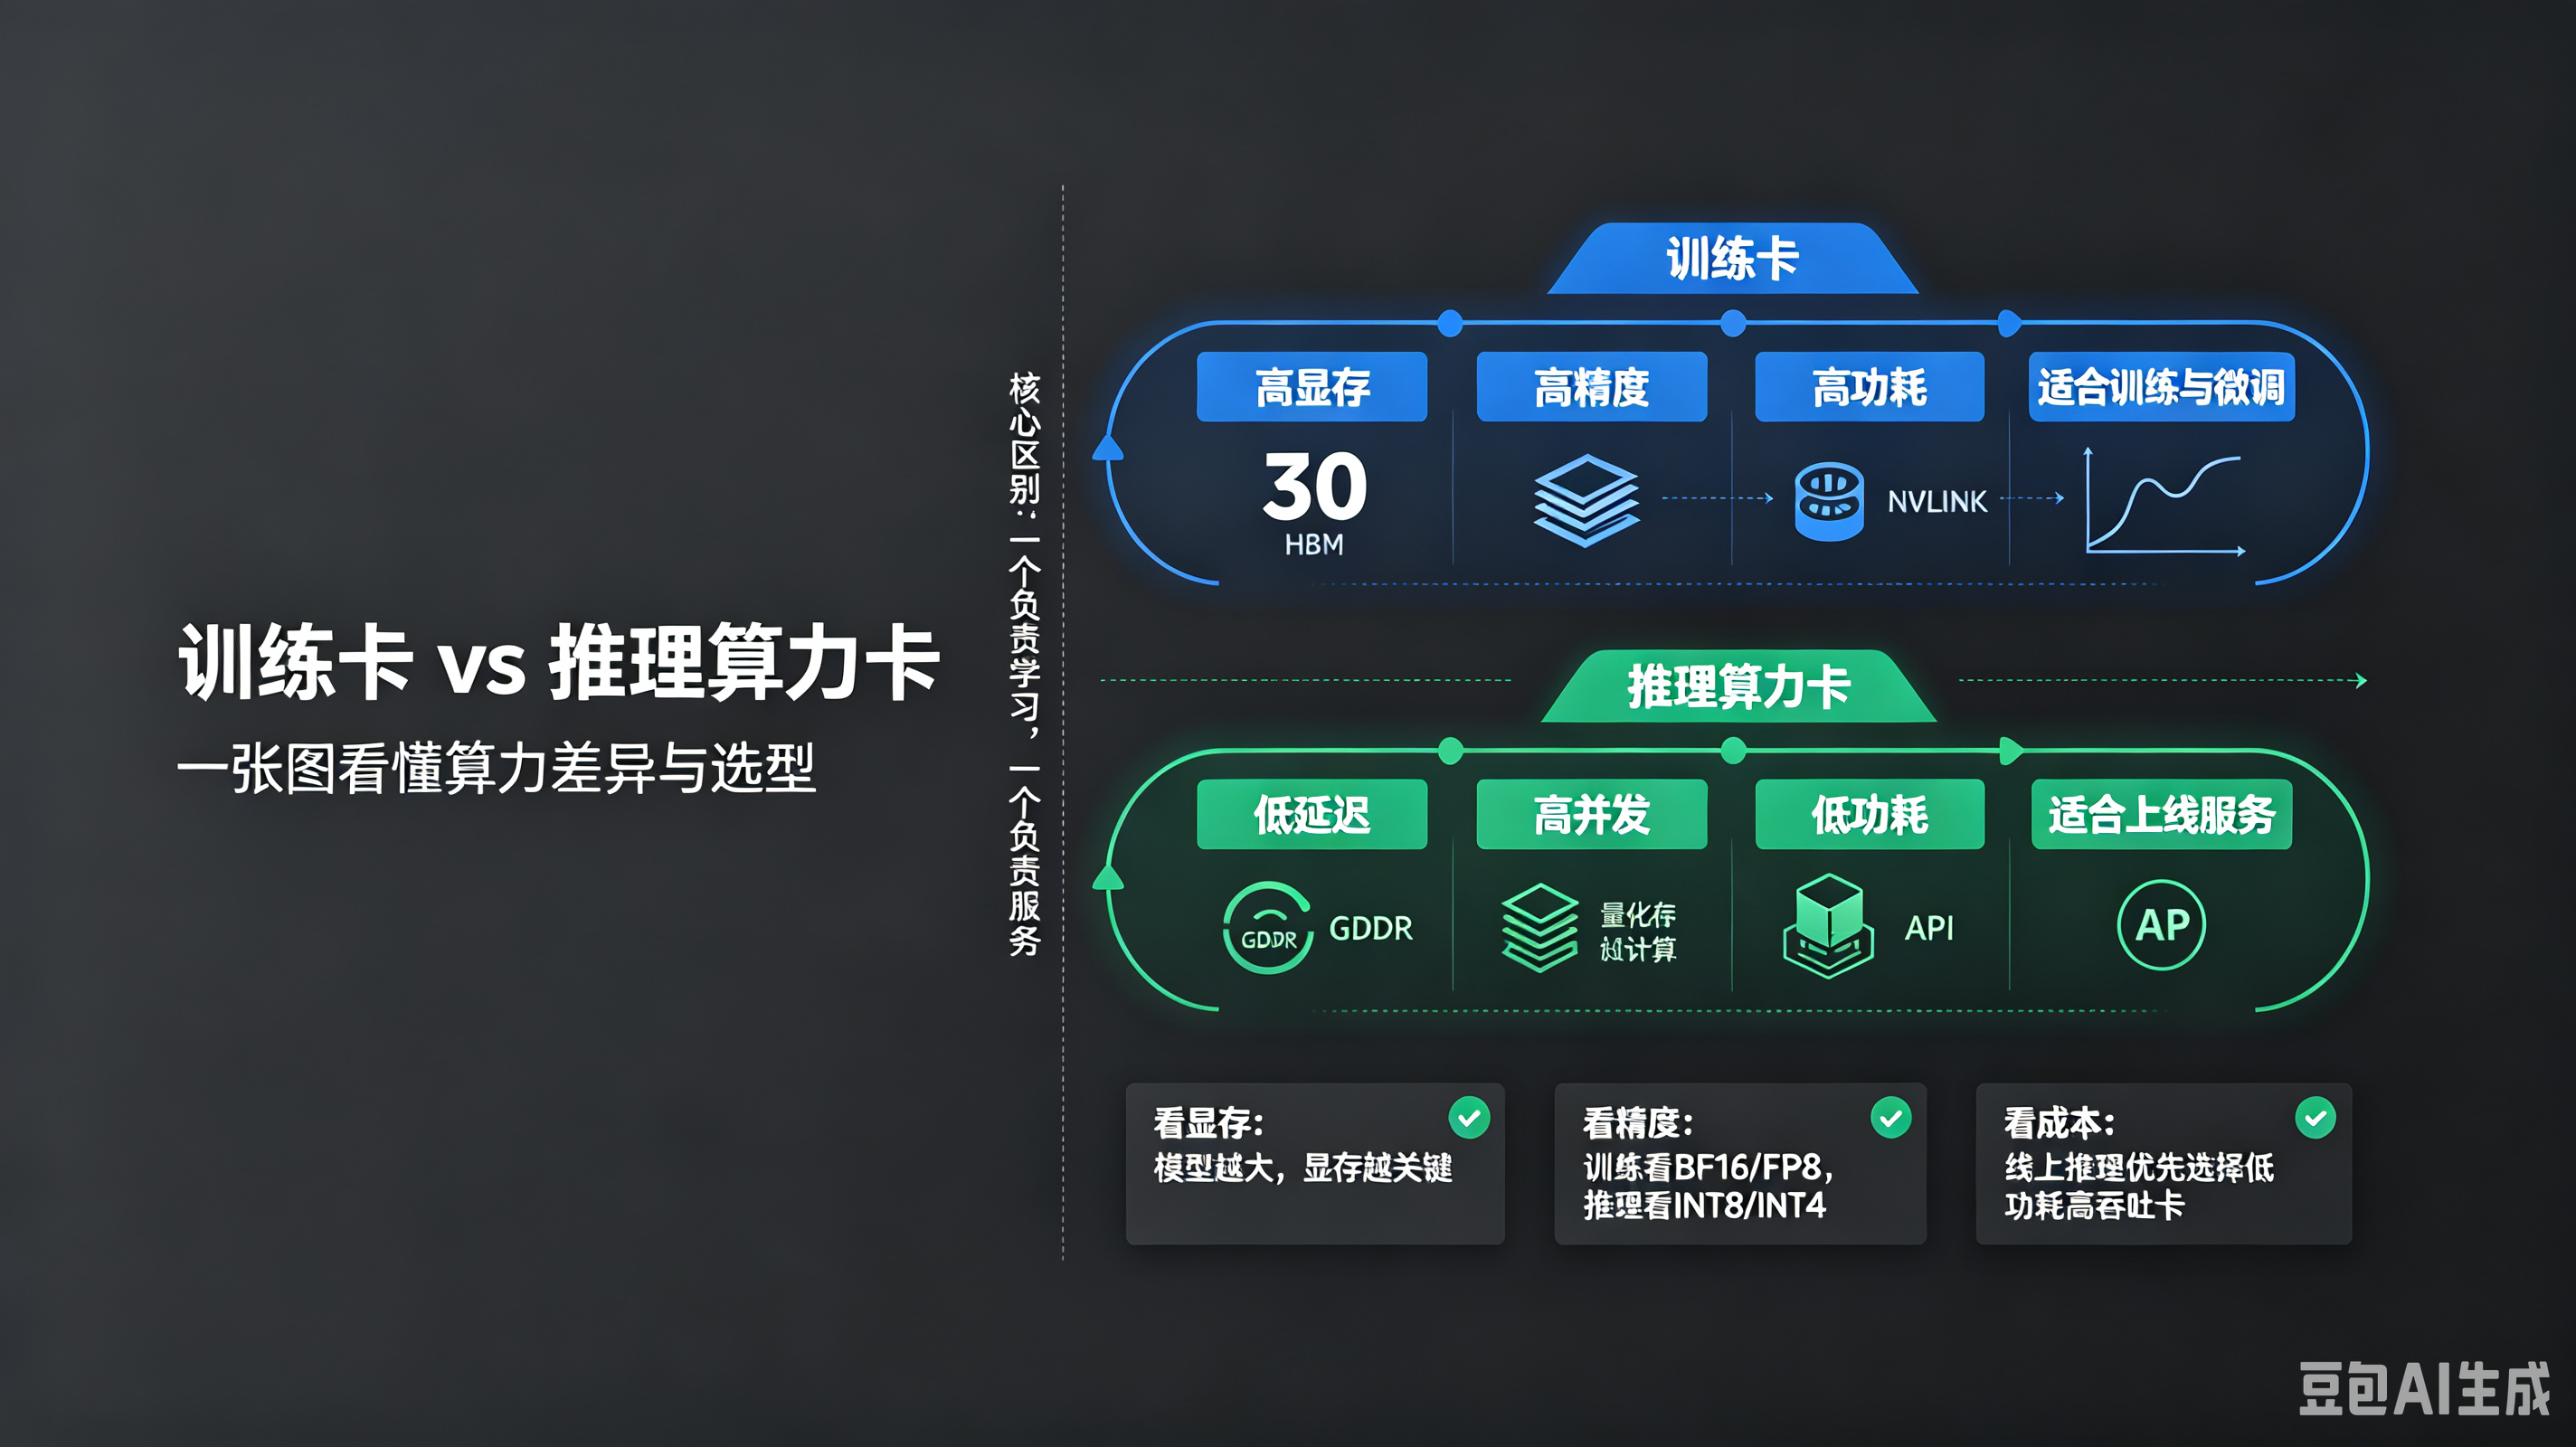
一、核心本质区别(一句话看懂)训练卡:负责模型从零学习,海量数据迭代 + 反向传播梯度更新,追求极限浮点算力、超大 HBM 显存、多卡高速互联,重精度、重吞吐、
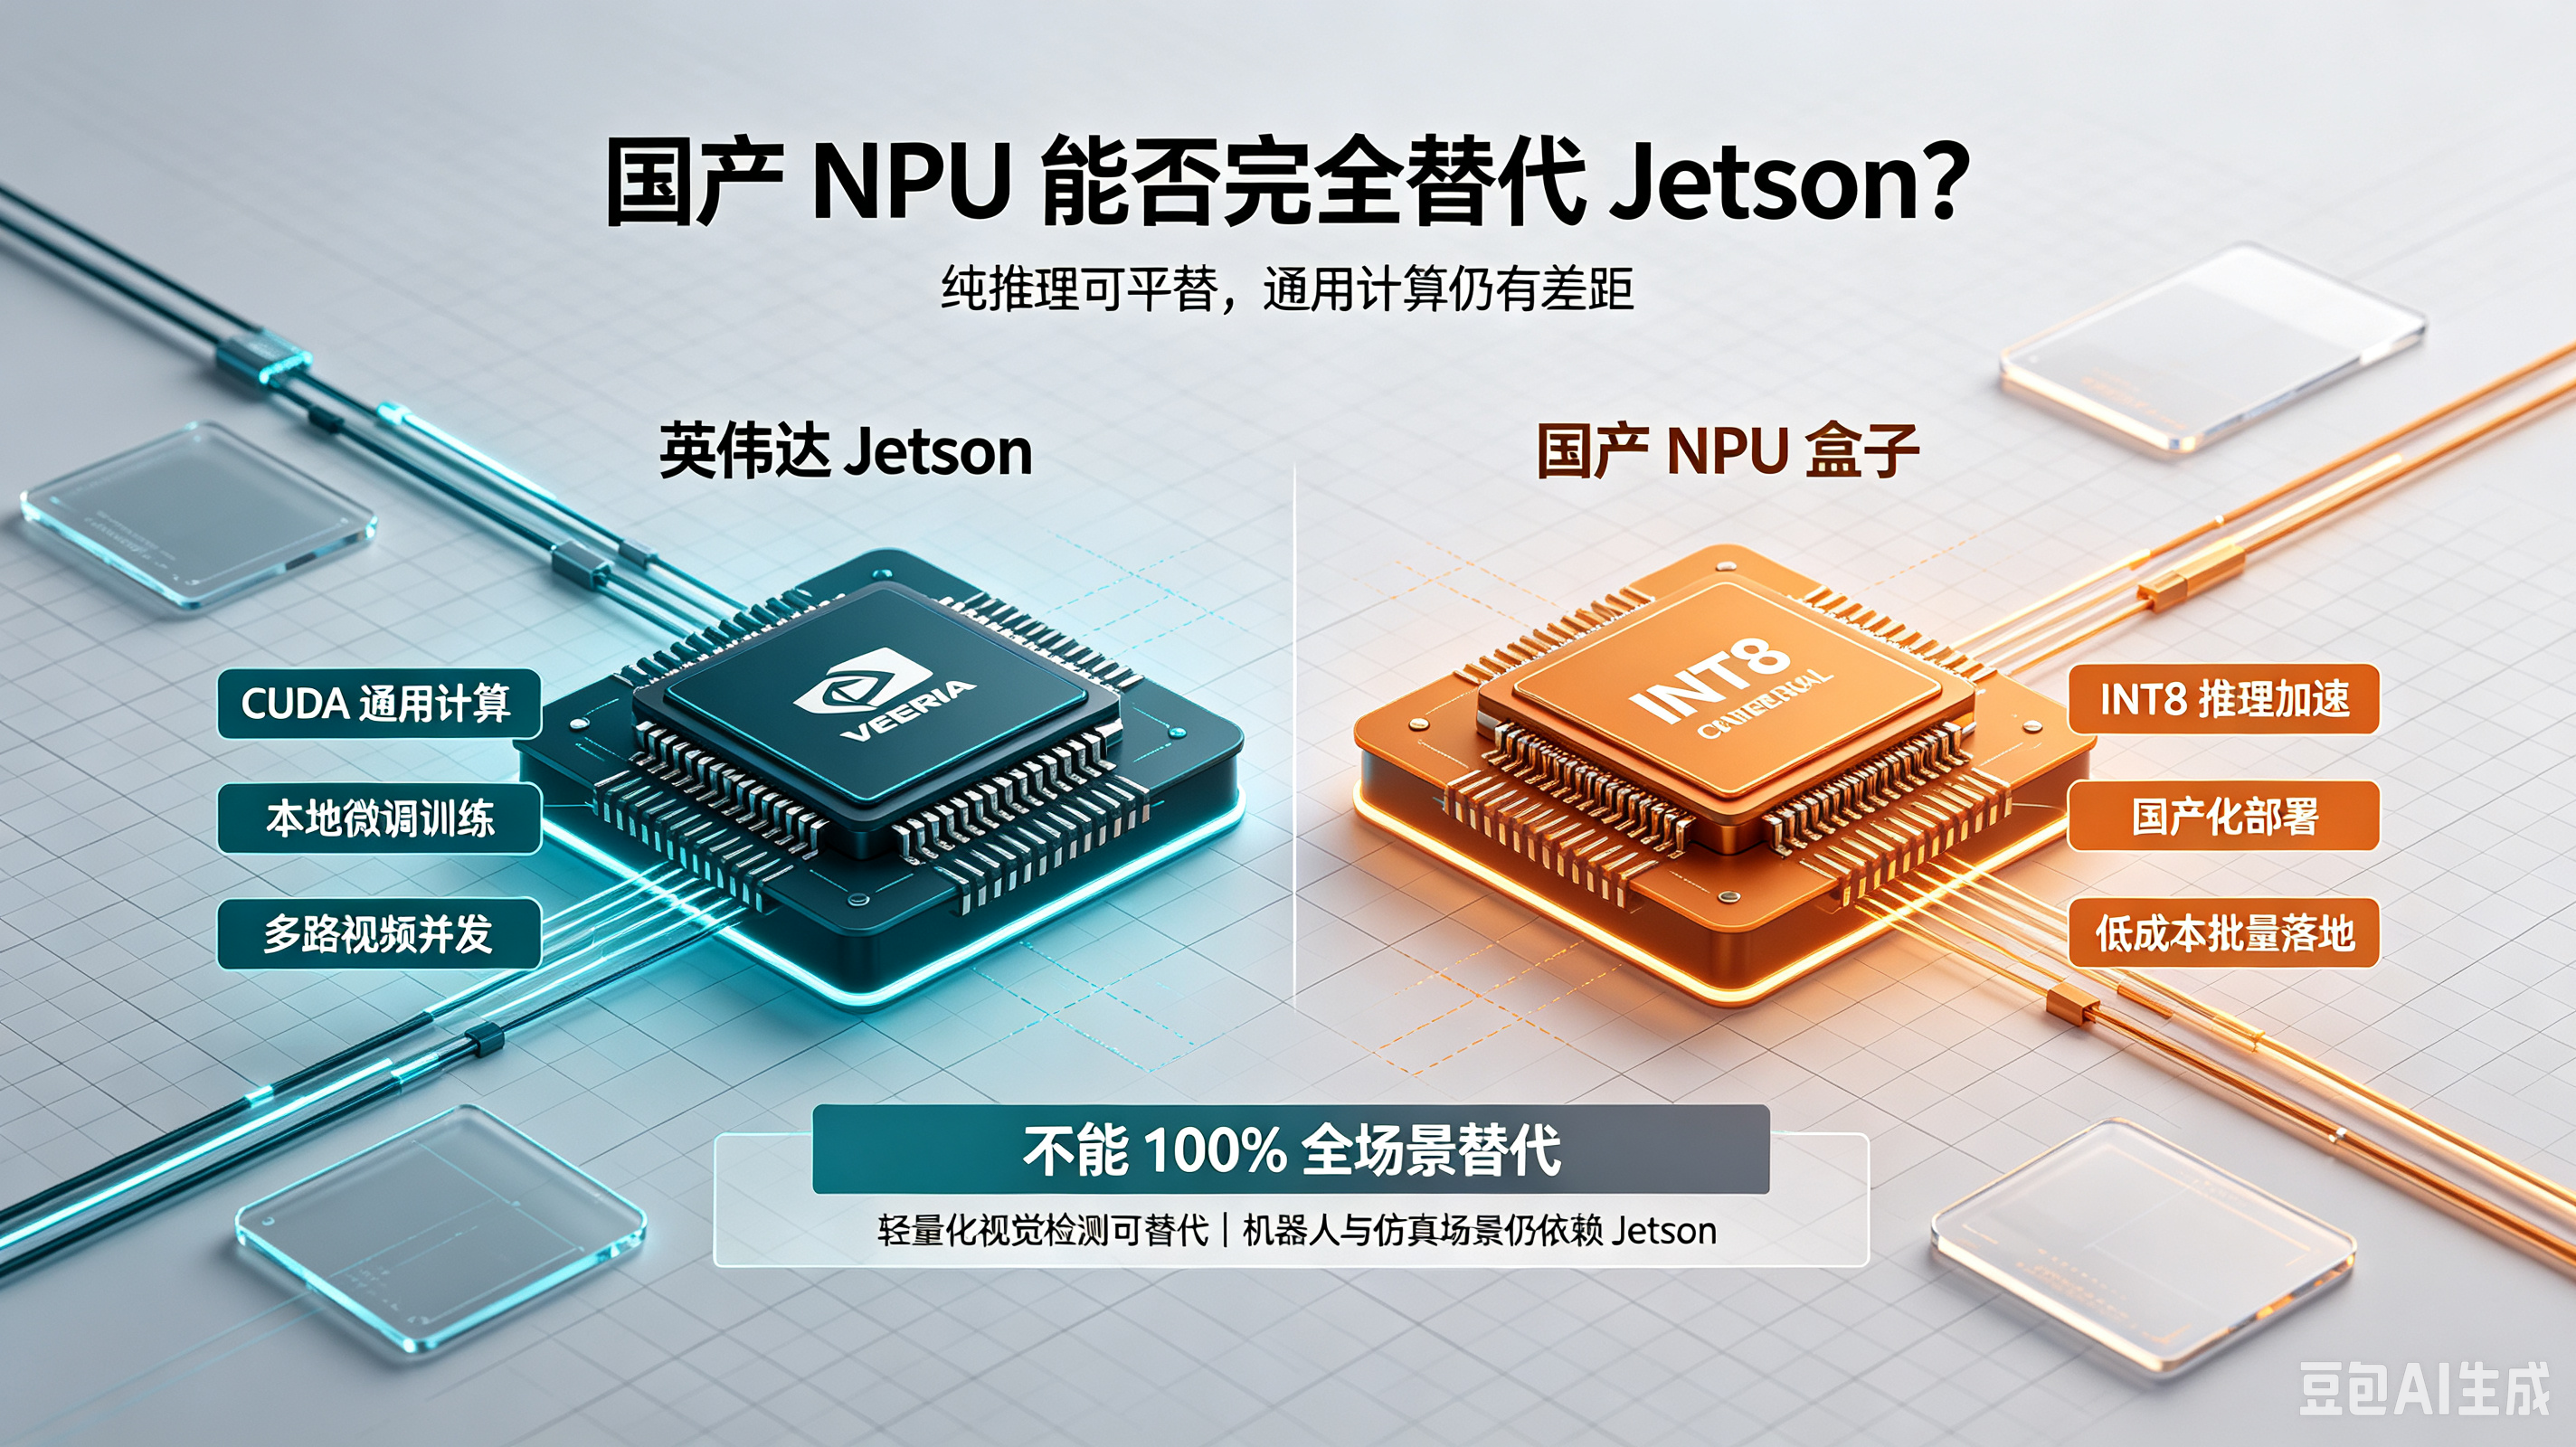
国产 NPU 边缘算力盒子无法 100%、全场景完全替代英伟达 Jetson;仅能在轻量化视觉推理、国产化信创、低成本批量部署场景实现等效替代,高算力、复杂训练
一、实时业务无法接受云端高延迟(最刚需痛点)云端流程:摄像头 / 传感器采集全量数据流上传公网云端 AI 推理指令回传,往返延迟普遍 50–200ms,弱网可达
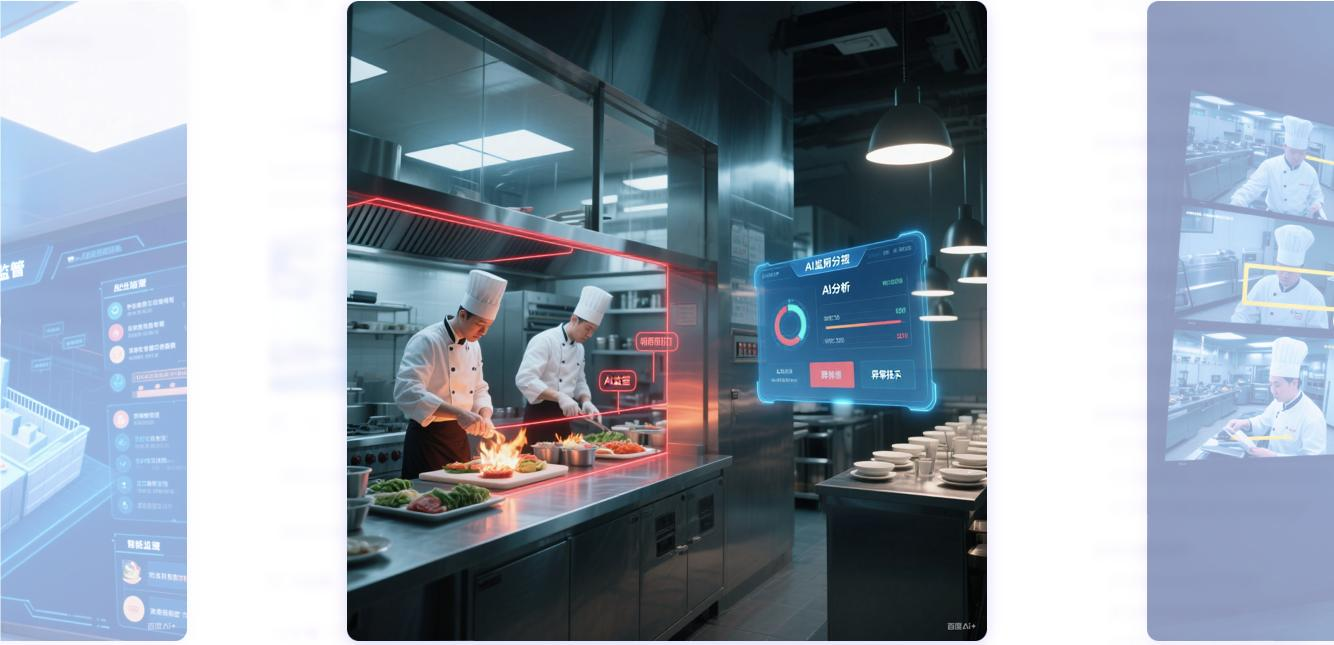
一、行业痛点:传统明厨亮灶监管短板传统后厨监控仅实现视频直播回看,无智能研判能力,存在四大核心问题:1. 人工监管成本高、漏检严重:需专人实时盯屏,后厨吸烟、不
一、核心硬件参数总览对比维度 RV1126BRK3588(工业边缘盒标准版)差距总结CPU4Cortex-A53@1.6GHz+RISC-V MCU4A76@2
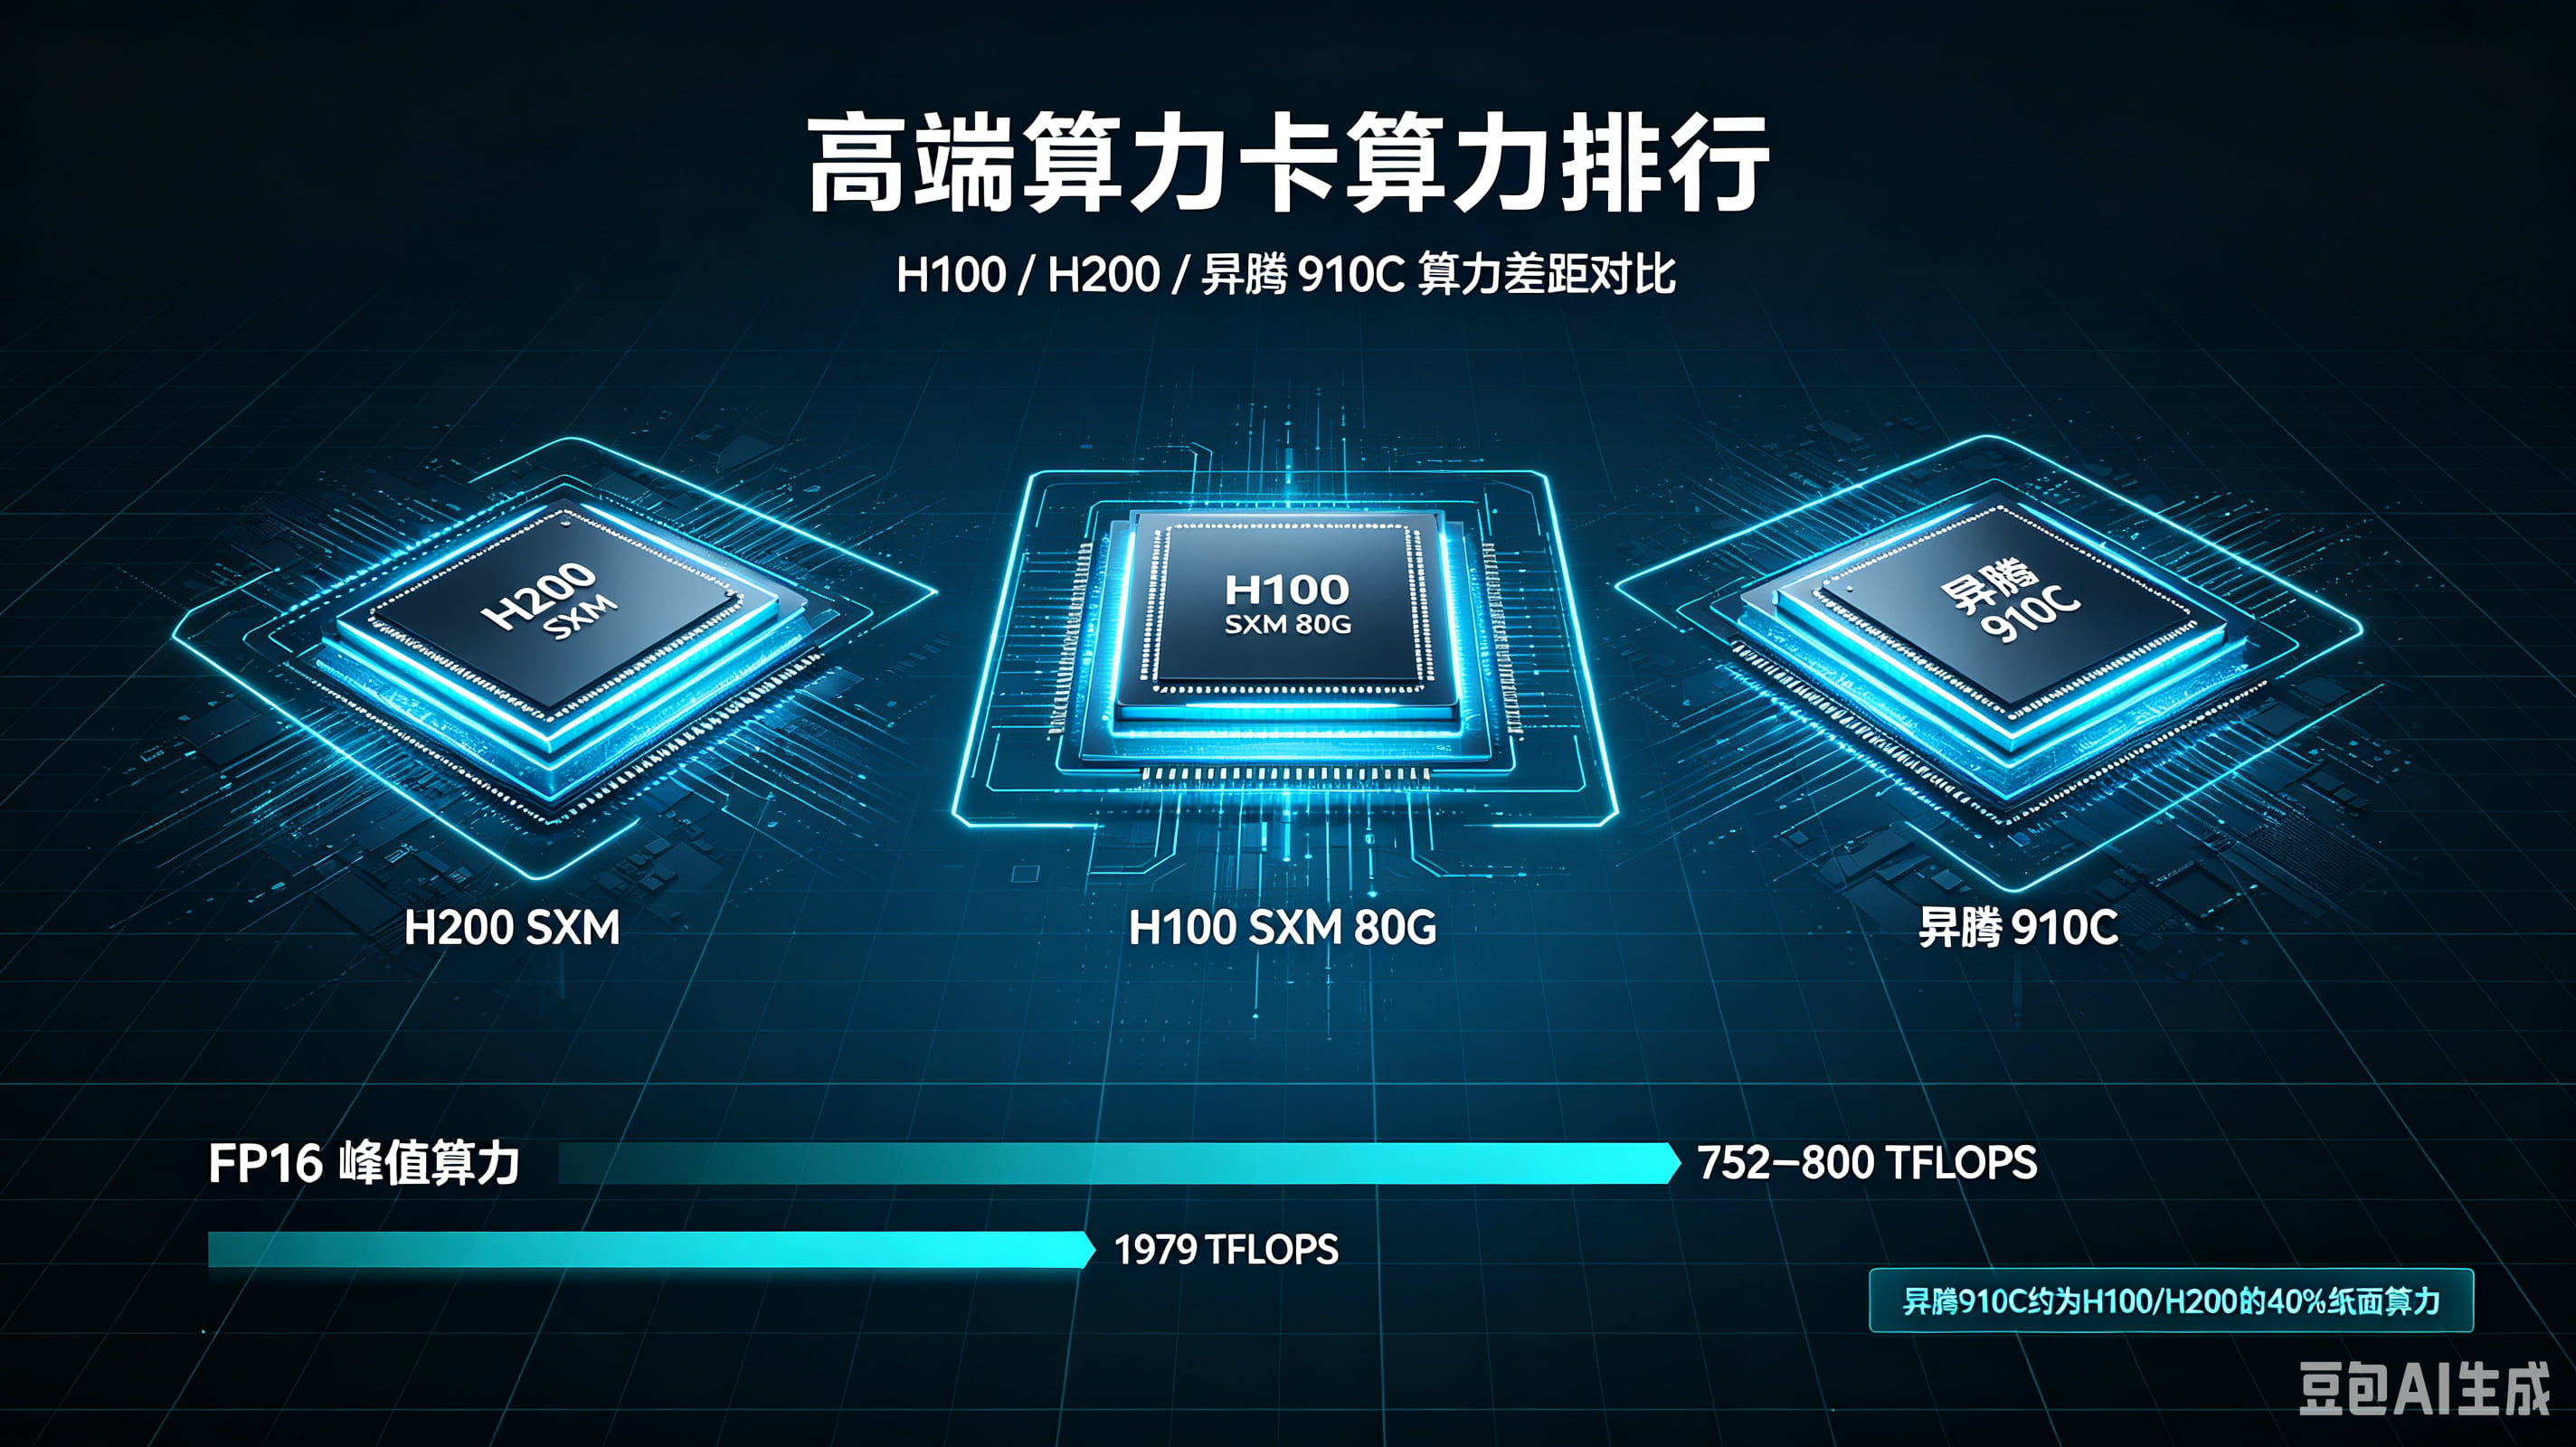
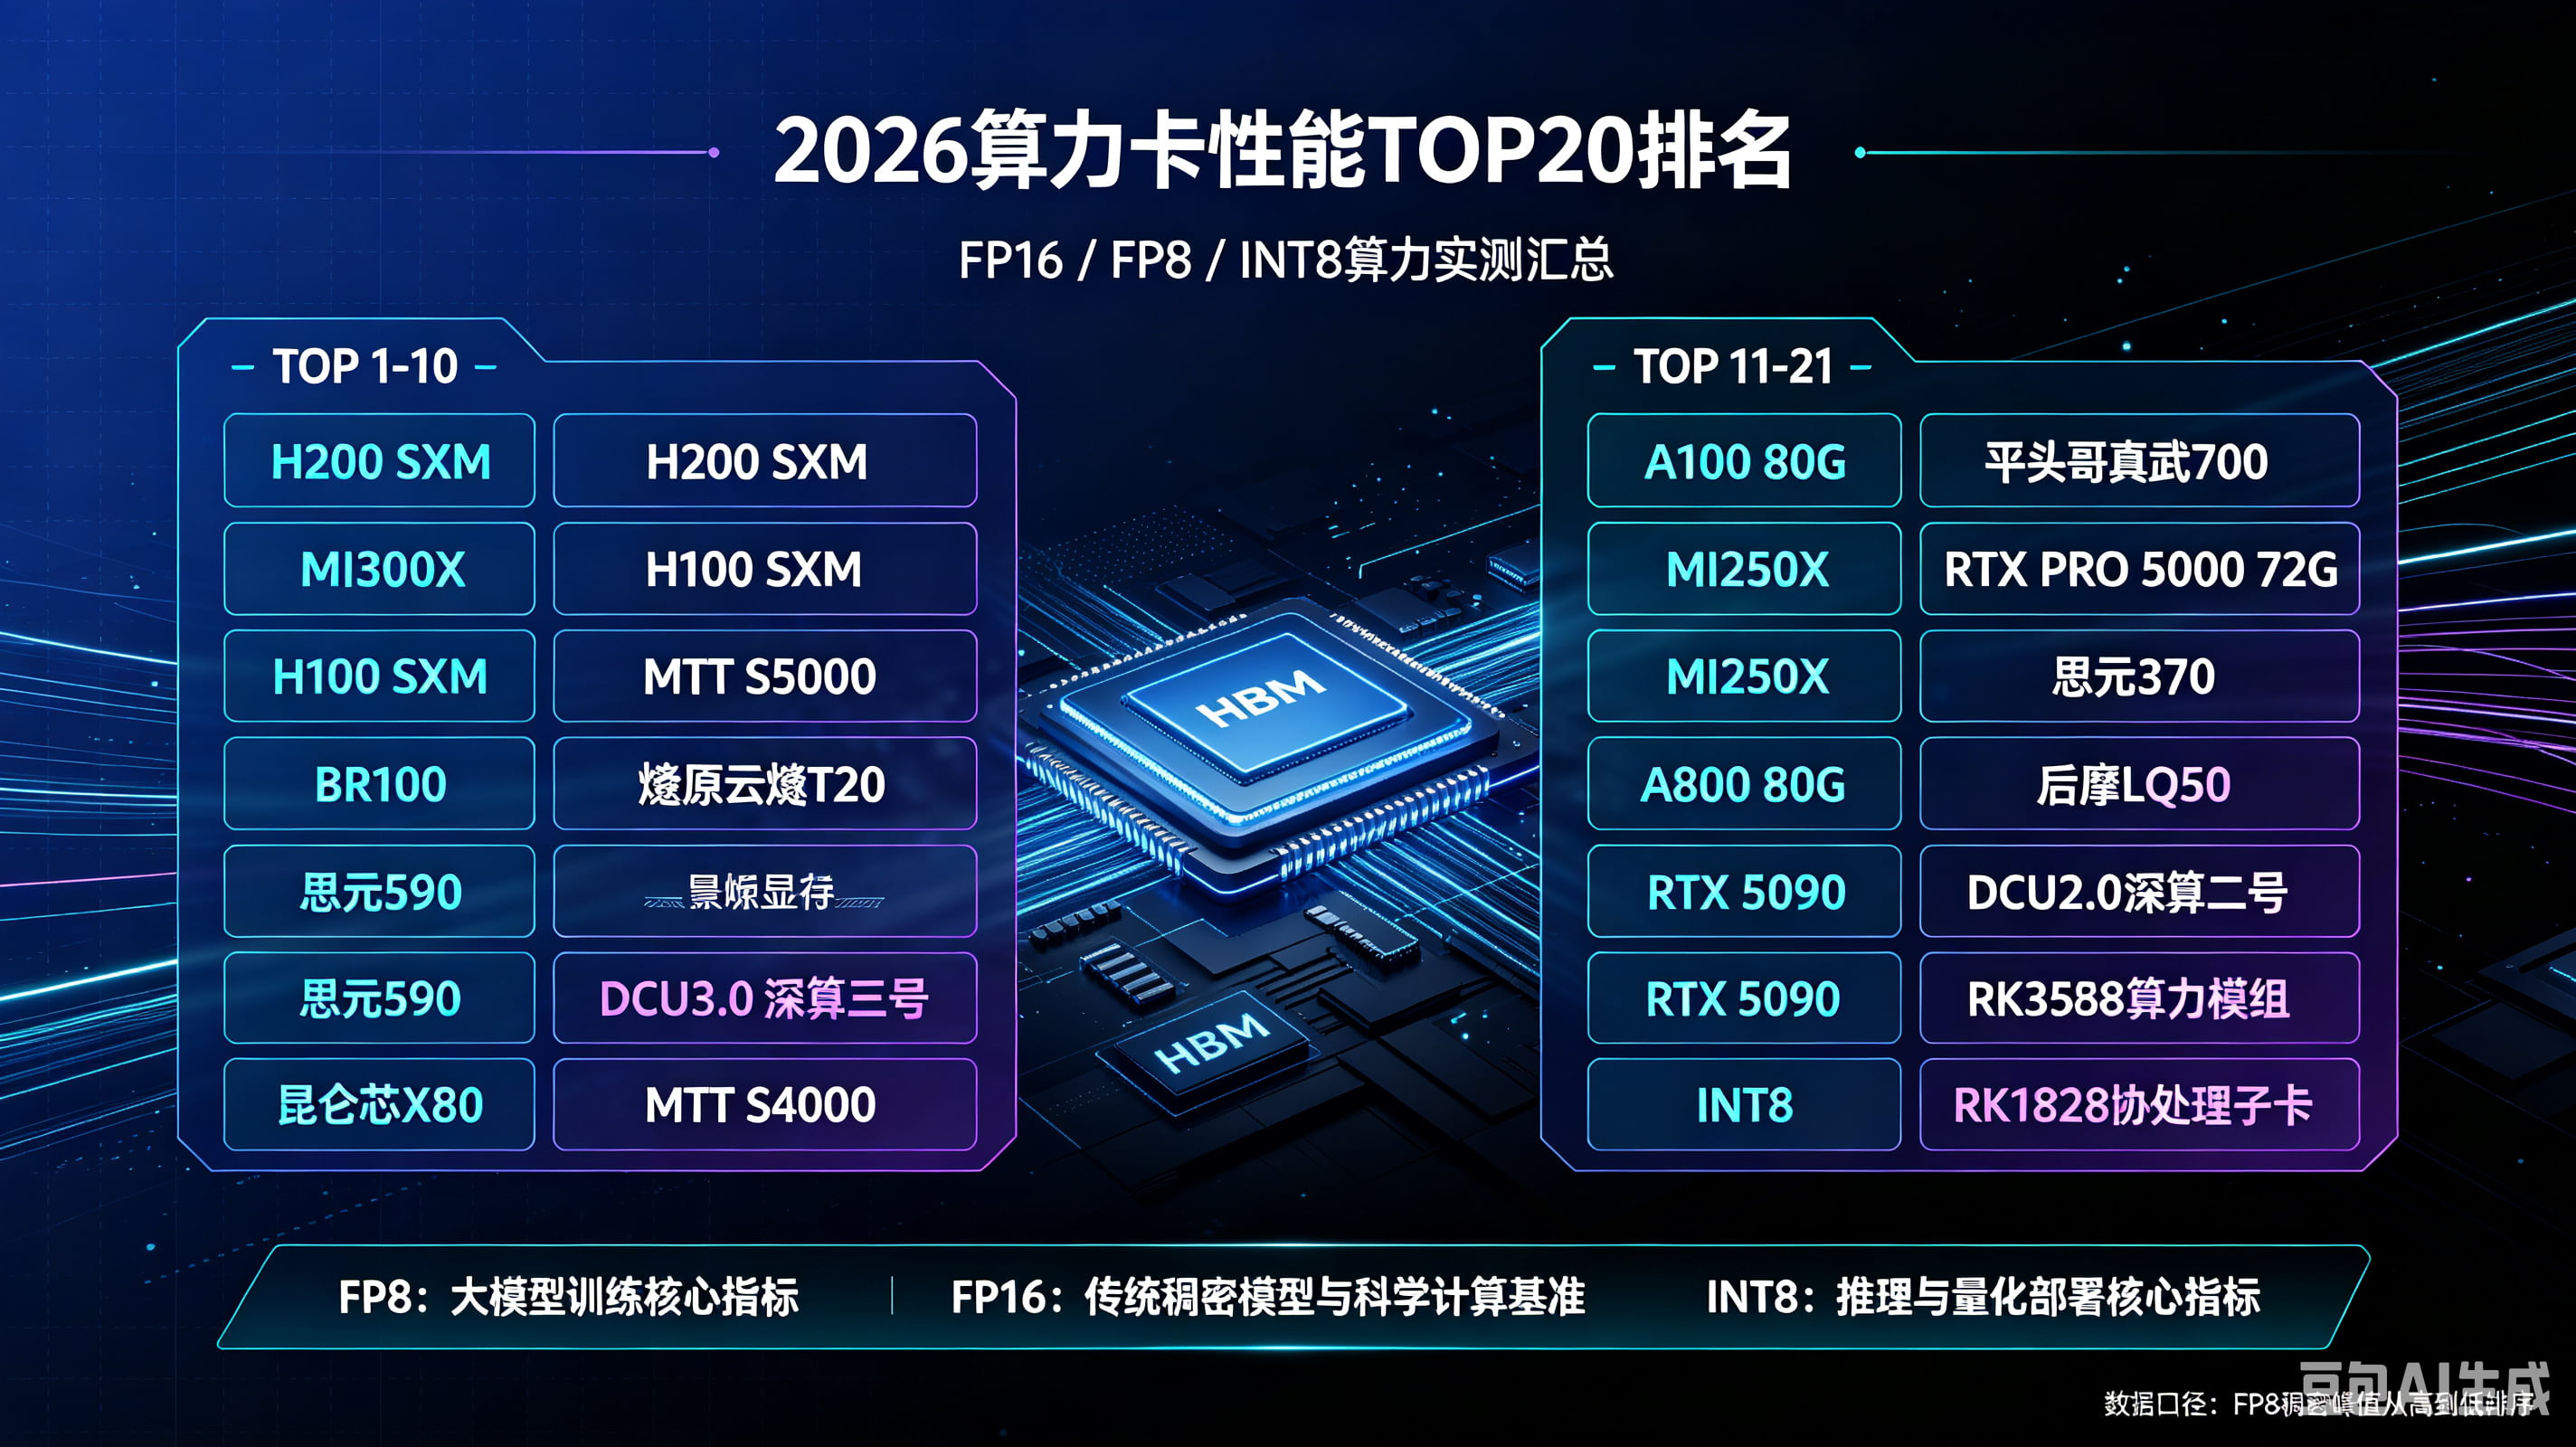
一、2026 主流旗舰算力卡性能排名(按 FP16 稀疏 AI 算力排序)1. B200 / GB200:FP16 2250 TFLOPS2. H200 SXM
1. 排序规则:FP8 稠密峰值算力从高到低排序(2026 大模型训练核心指标);2. 算力单位:FP16/FP8=TFLOPS,INT8=TOPS;3. 实测
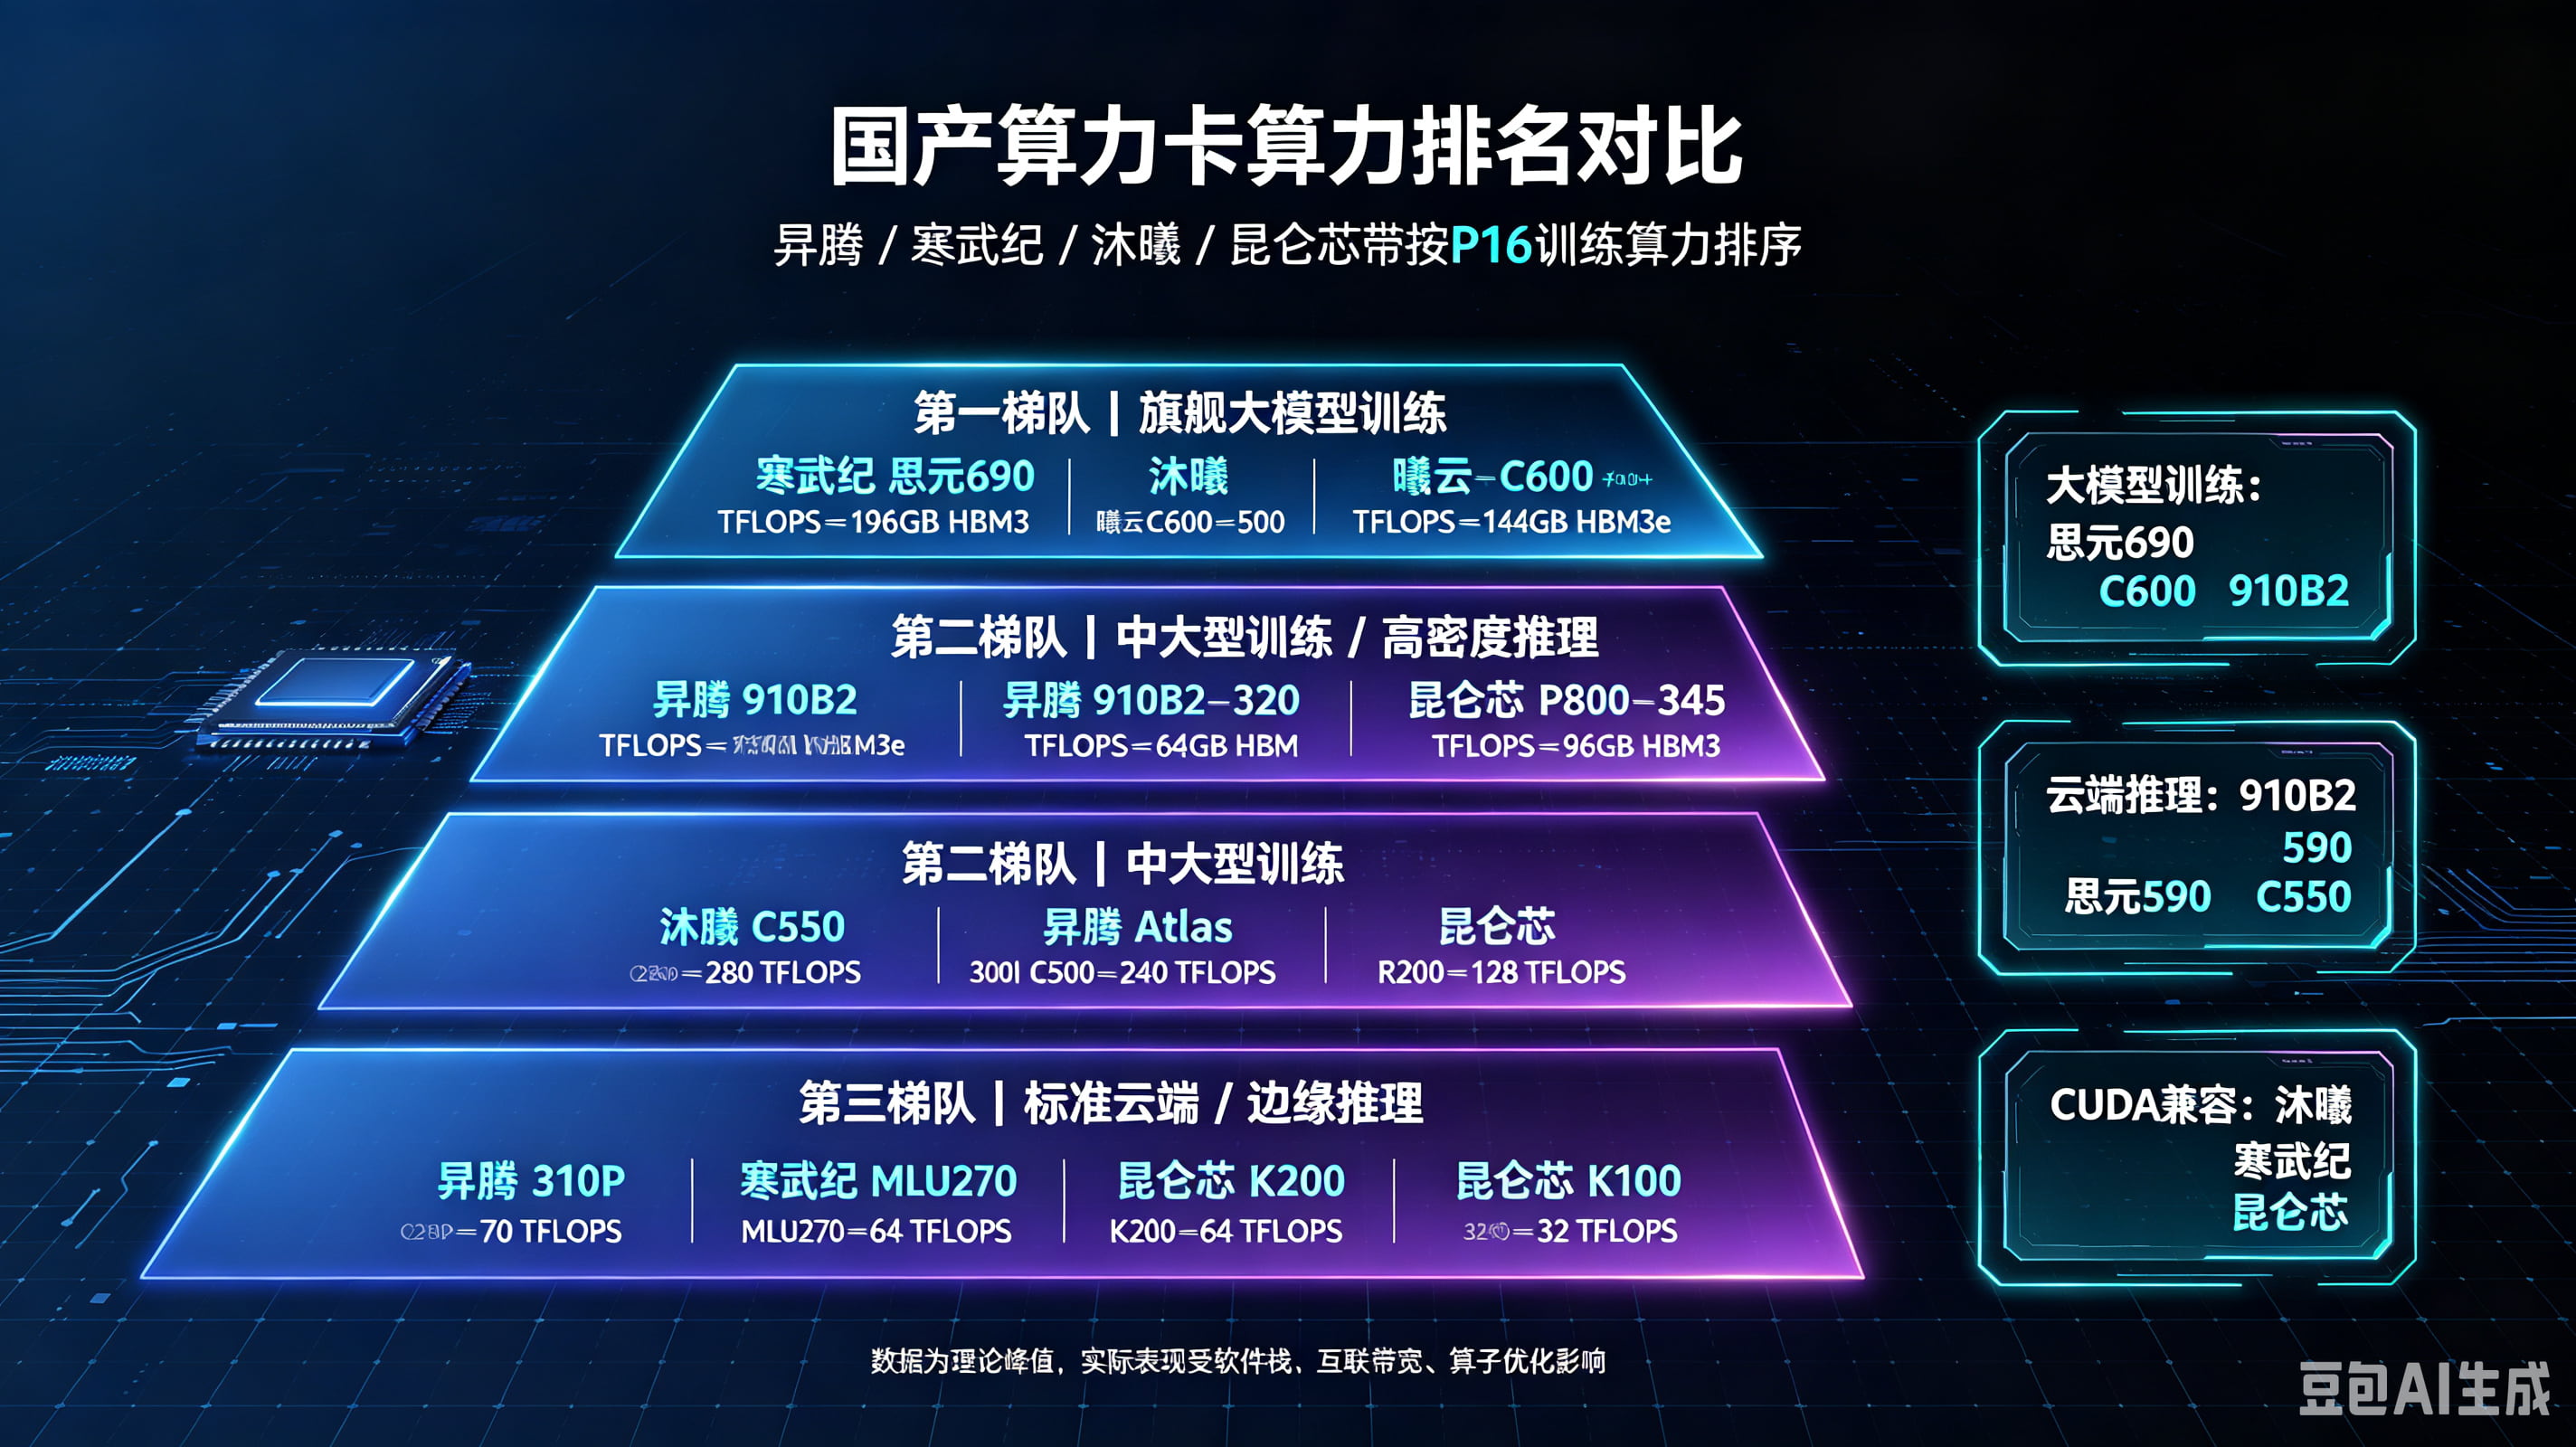
1. 统一采用理论峰值 FP16 TFLOPS(训练核心指标) 为主排序,补充 INT8 TOPS(推理指标);2. 仅统计数据中心标准算力加速卡 / OAM
2026 年,大模型本地私有化部署、工业智能制造、城市物联感知全面落地,国产化边缘一体机成为政企、制造、安防行业刚需。本次十强榜单综合底层芯片国产化适配、边缘大
一、综合头部梯队(芯片 / 整机 / 平台全栈信创适配,政企大规模落地)1. 海康威视核心产品:DS-TP 系列 AI 边缘盒子、边缘推理一体机国产化底座:自研
当前政企、工业、交通、园区项目全面推进信创国产化替代,边缘硬件成为智能感知核心载体。国内源头厂商分为全栈软硬件方案商、安防硬件厂商、纯芯片硬件代工、工业工控厂商
一、2026 国产边缘计算盒子厂商梯队划分结合产品算力覆盖、软硬件自研能力、行业落地案例、国产化适配、云边一体化平台完整度,将国内厂商分为综合头部梯队、垂直专精
一、2026 国产 PCIe 推理算力卡三大技术路线(选型前置判断)2026 年推理负载占 AI 算力总需求 70% 以上,国产 PCIe 加速卡分三条路线,先
一、MTT S4000 / S5000 核心硬件参数差异(官方规格)基础架构定位MTT S4000:第三代 MUSA「曲院」架构 QY102AA,中端训推一体卡
榜单排序依据:单卡 AI 算力、商用出货量、推理落地规模、软件生态、集群适配能力综合评分,区分 ASIC 专用加速卡、通用 GPU PCIe 算力卡两大路线,摩
一、天梯排名总览(综合评分维度:INT8 算力、显存带宽、大模型推理速度、功耗能效、体积、兼容性、国产适配)T0 旗舰级(高性能大模型微型 PCIe 卡,LQ5
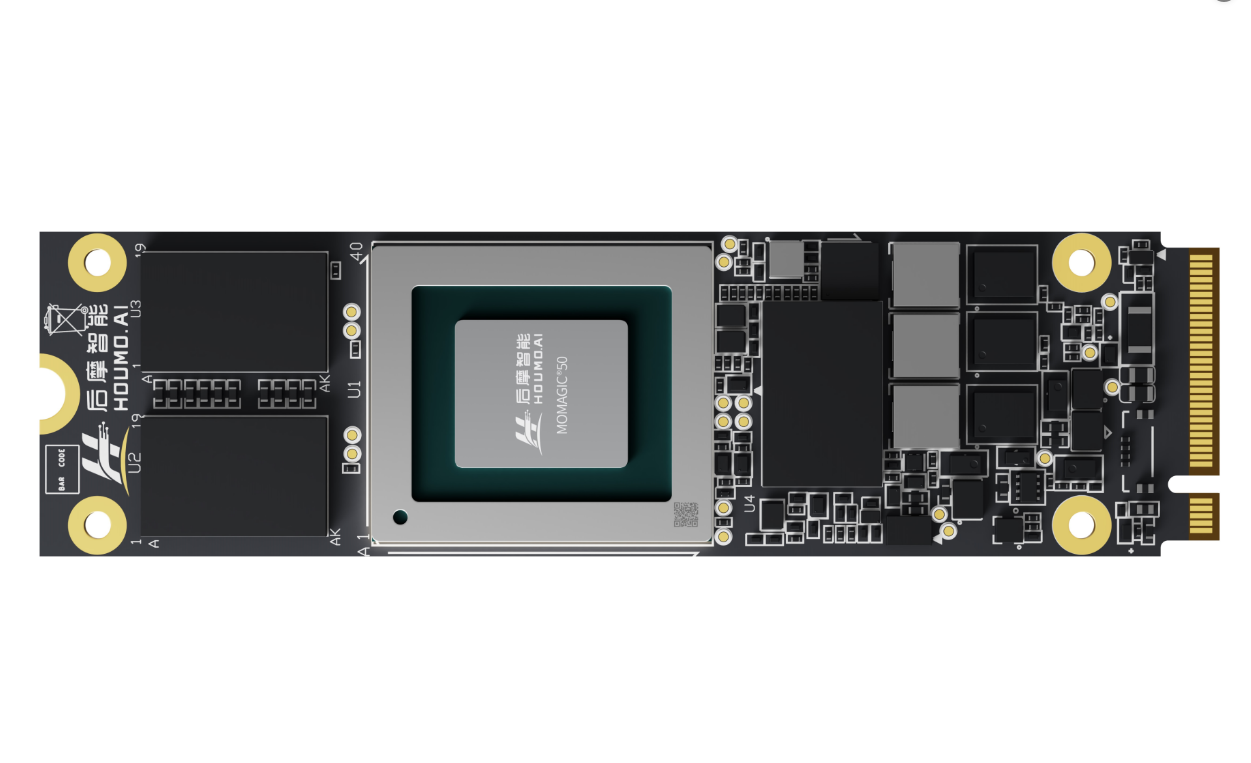
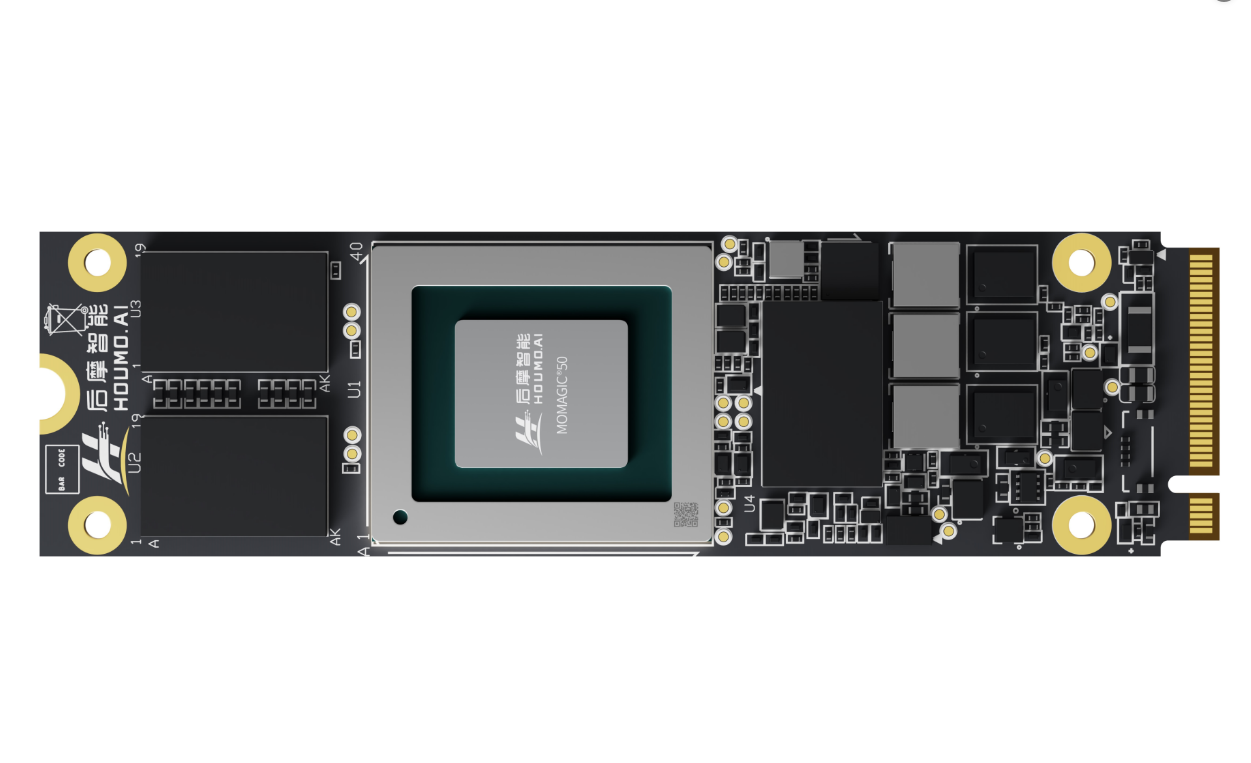
一、核心基础规格对标(统一 M.2 2280 标准尺寸)1. 后摩力擎 LQ50 核心硬件参数(对标基准)外形:M.2 2280(22803.3mm)M-Key
当下大模型落地加速从云端下沉至边缘端,AI PC、工业自动化、视频会议、泛安防设备普遍面临本地算力不足、大模型加载卡顿、设备改造成本高三大痛点。传统长尺寸 PC
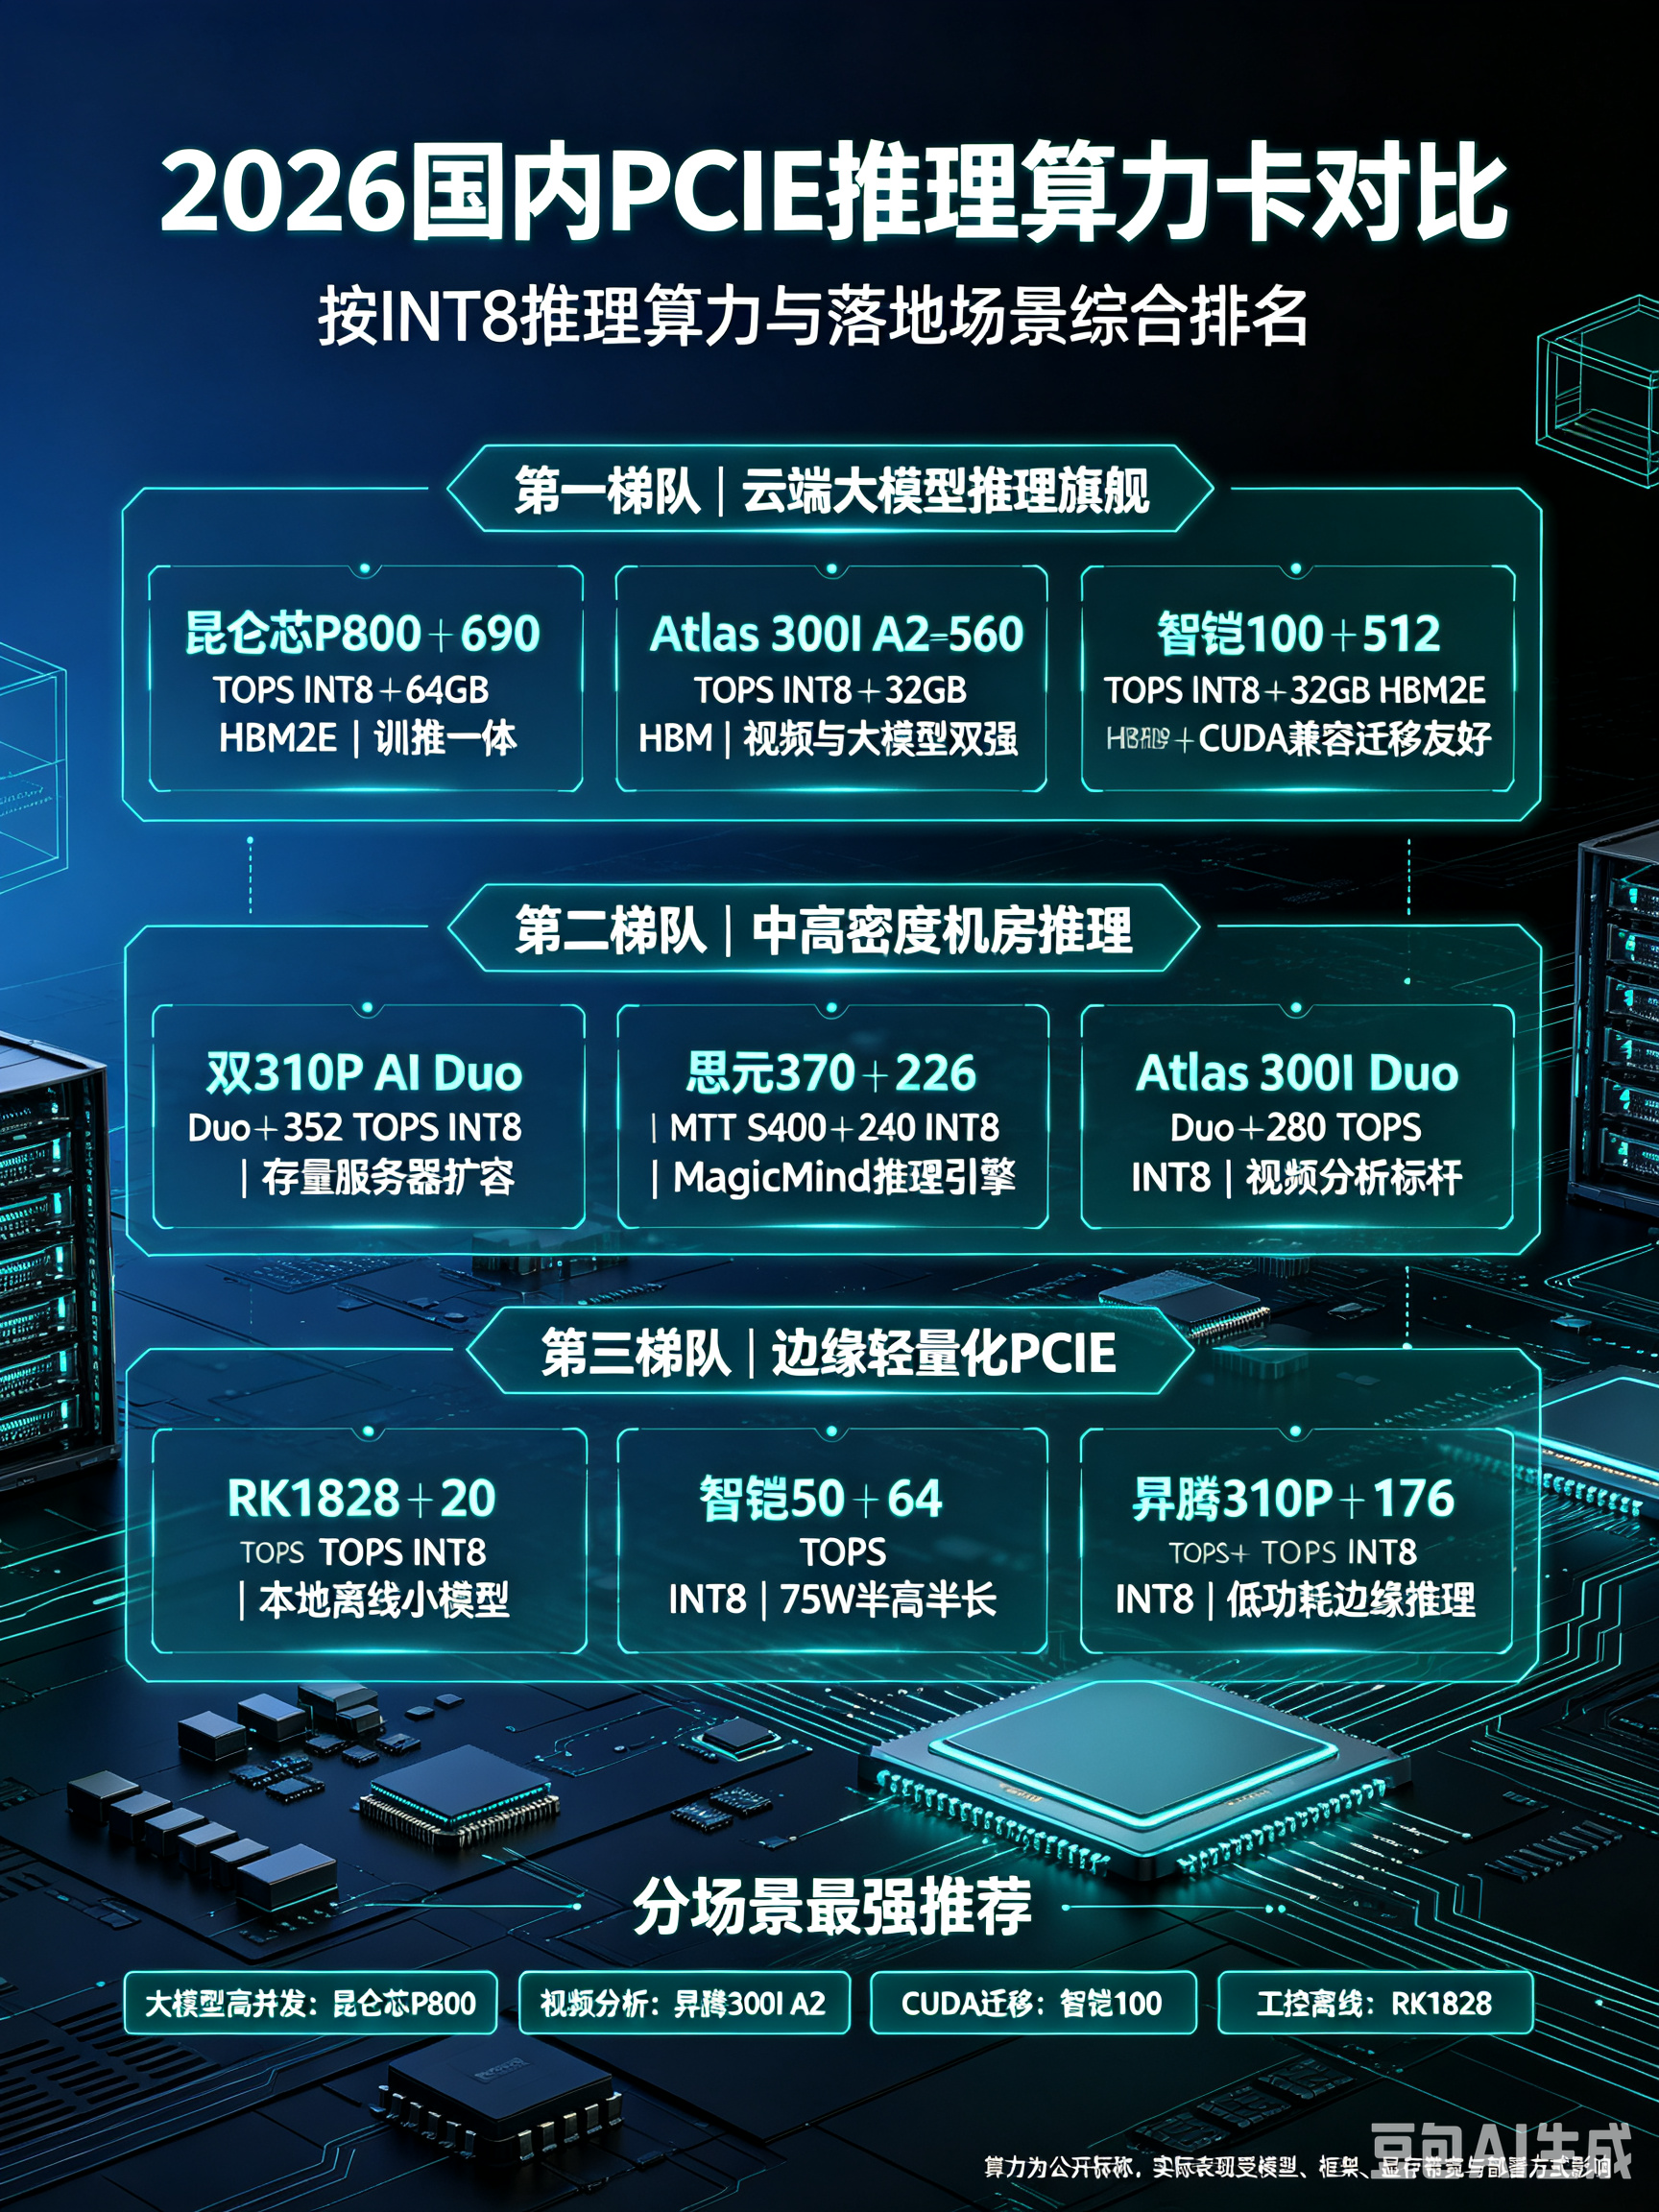
一、核心分级总榜(按 INT8 推理算力从高到低,仅量产 PCIe 标准加速卡)第一梯队:云端大模型推理旗舰(单卡 INT8500TOPS,千亿大模型、高并发云
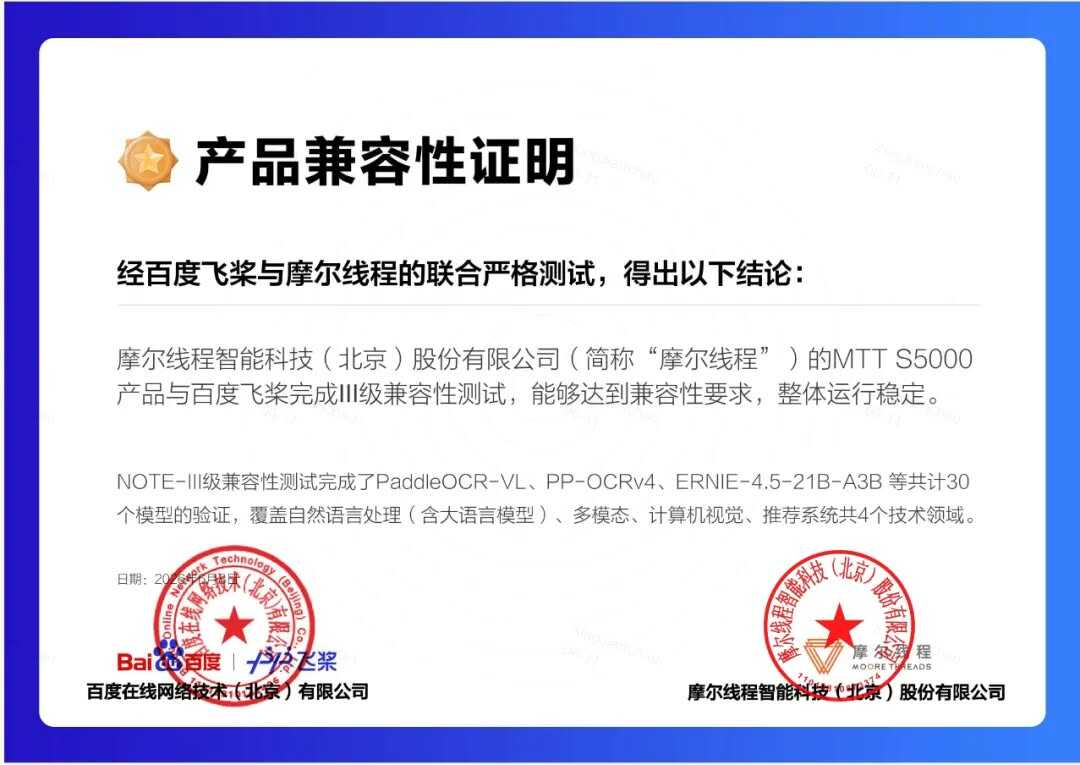
2026 年 7 月 2 日,摩尔线程正式官宣:旗下旗舰级训推一体全功能 GPU 智算卡MTT S5000,通过百度飞桨(PaddlePaddle)最高等级Ⅲ
一、核心定位与底层技术路线(最本质区别)后摩智能(HoumoAI)赛道:存算一体 NPU / 专用 AI 推理芯片,只做 AI 计算,无 3D 图形渲染硬件单元
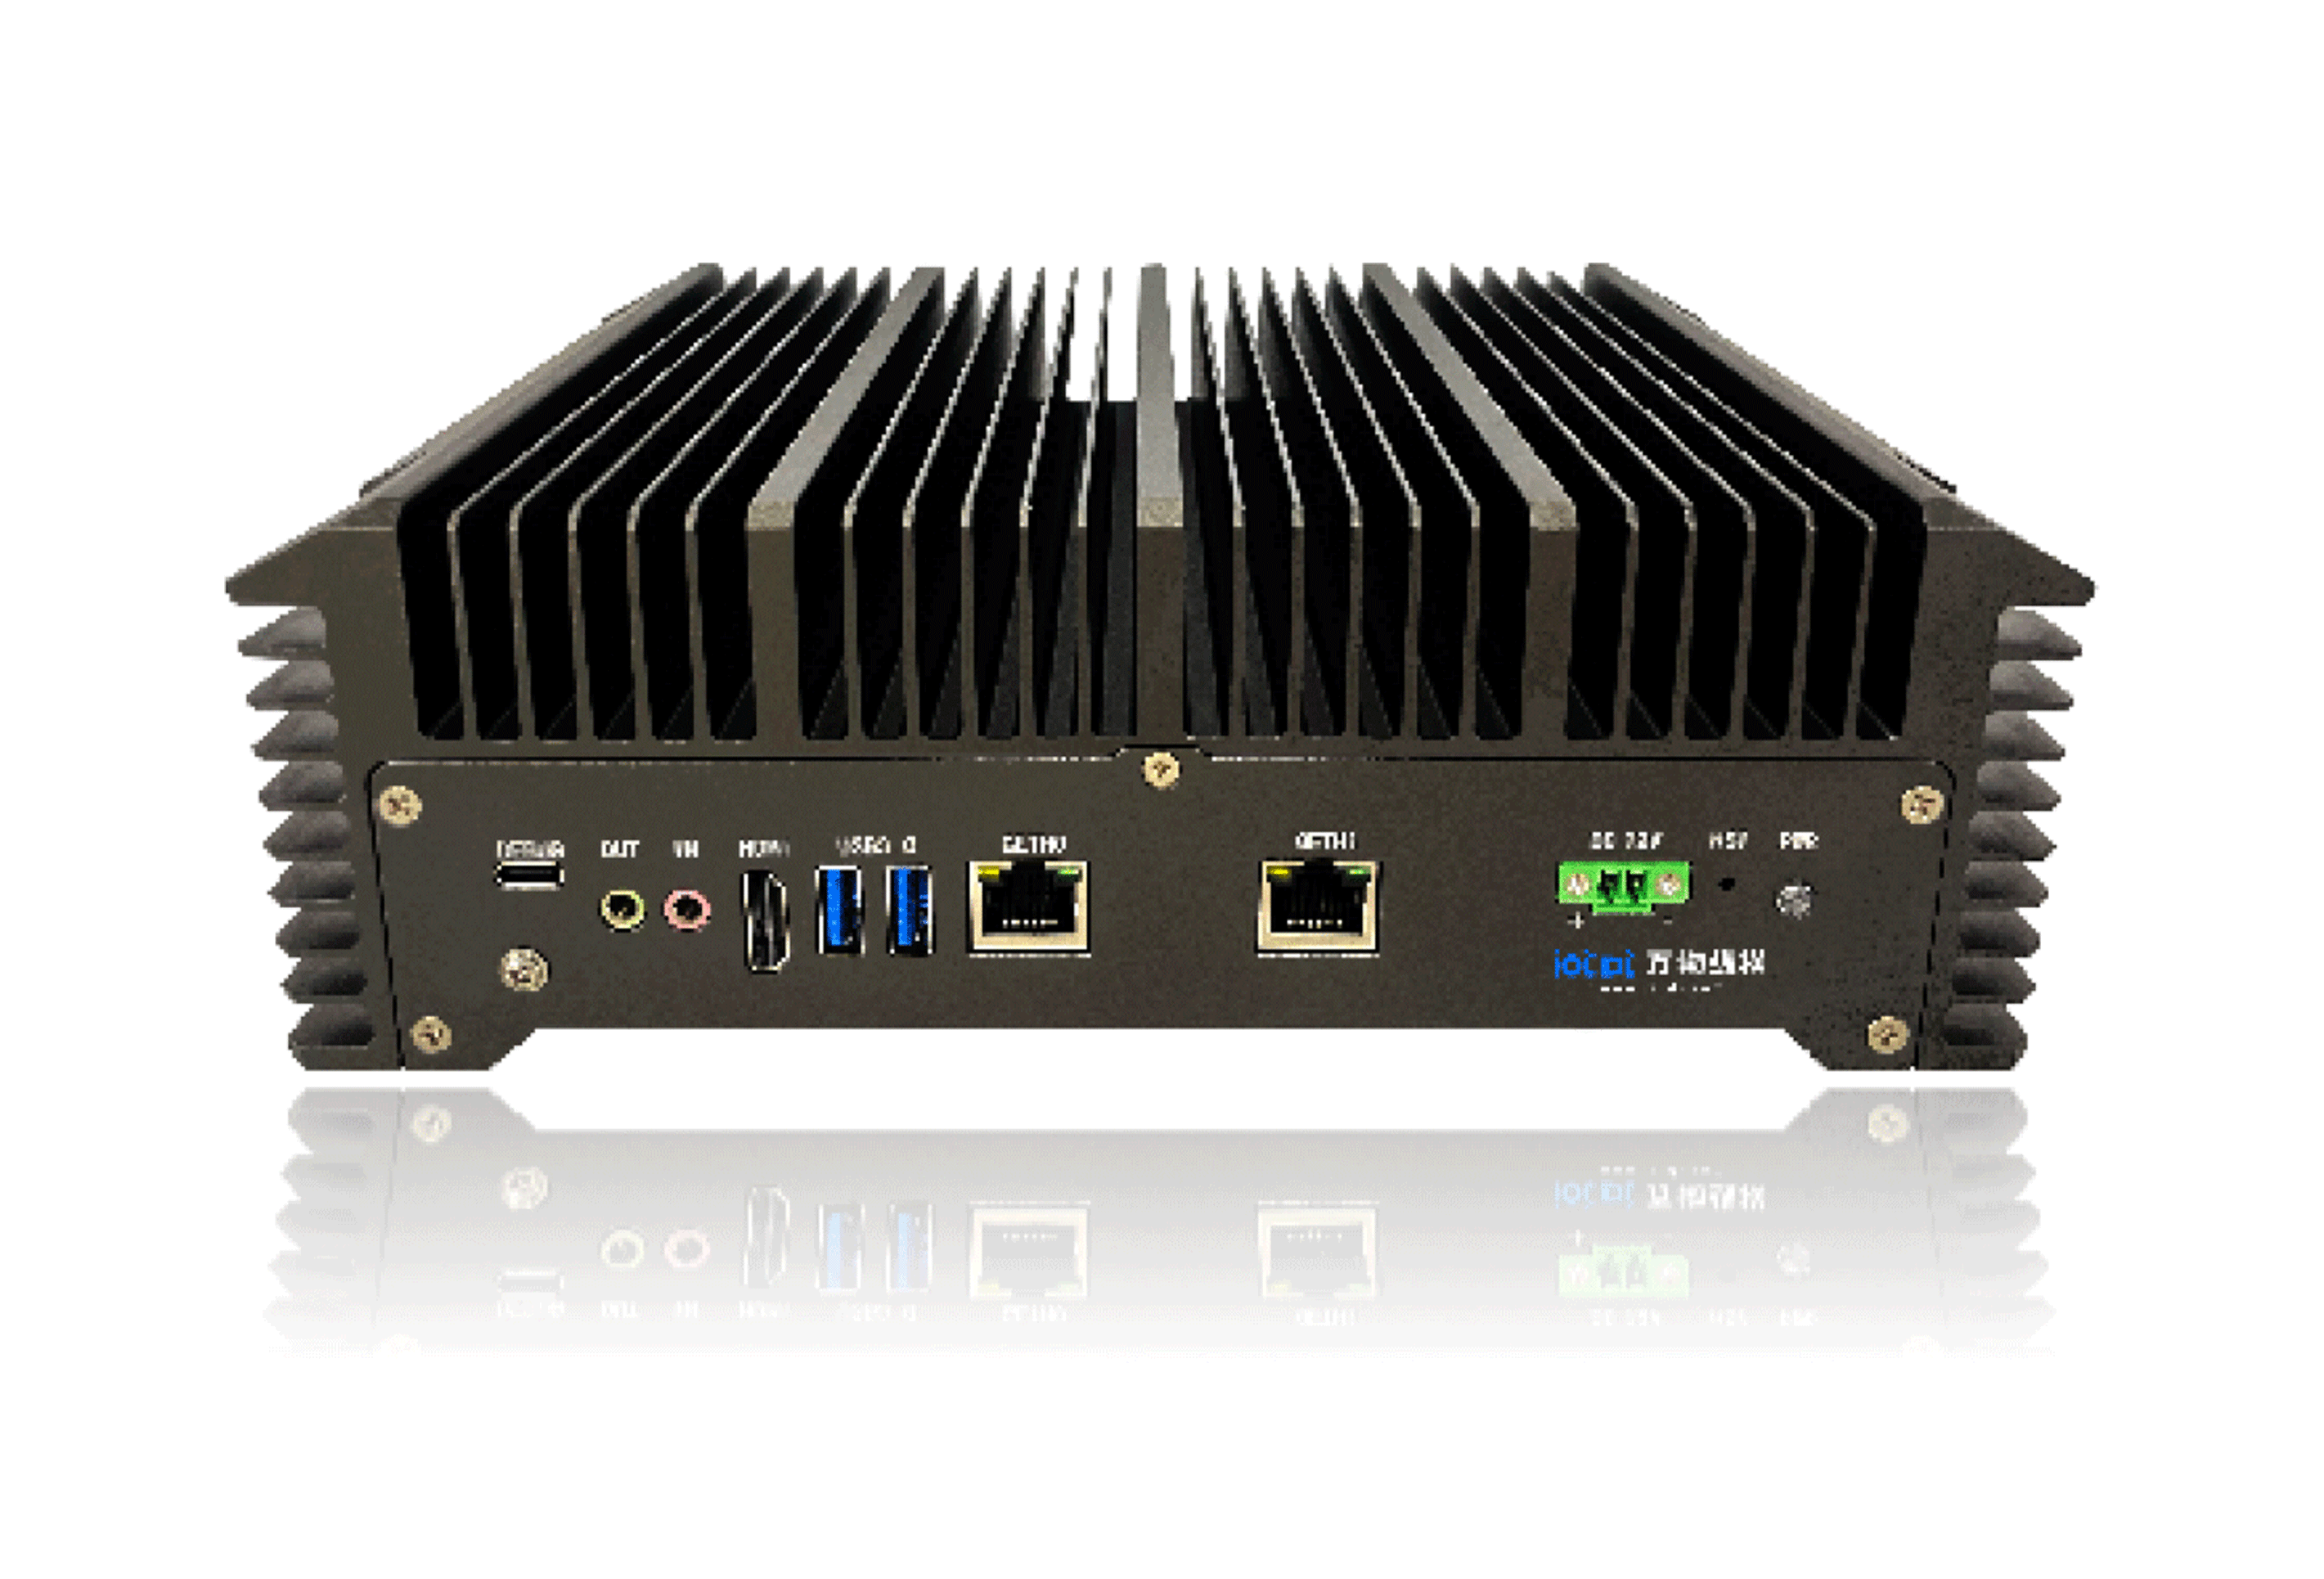
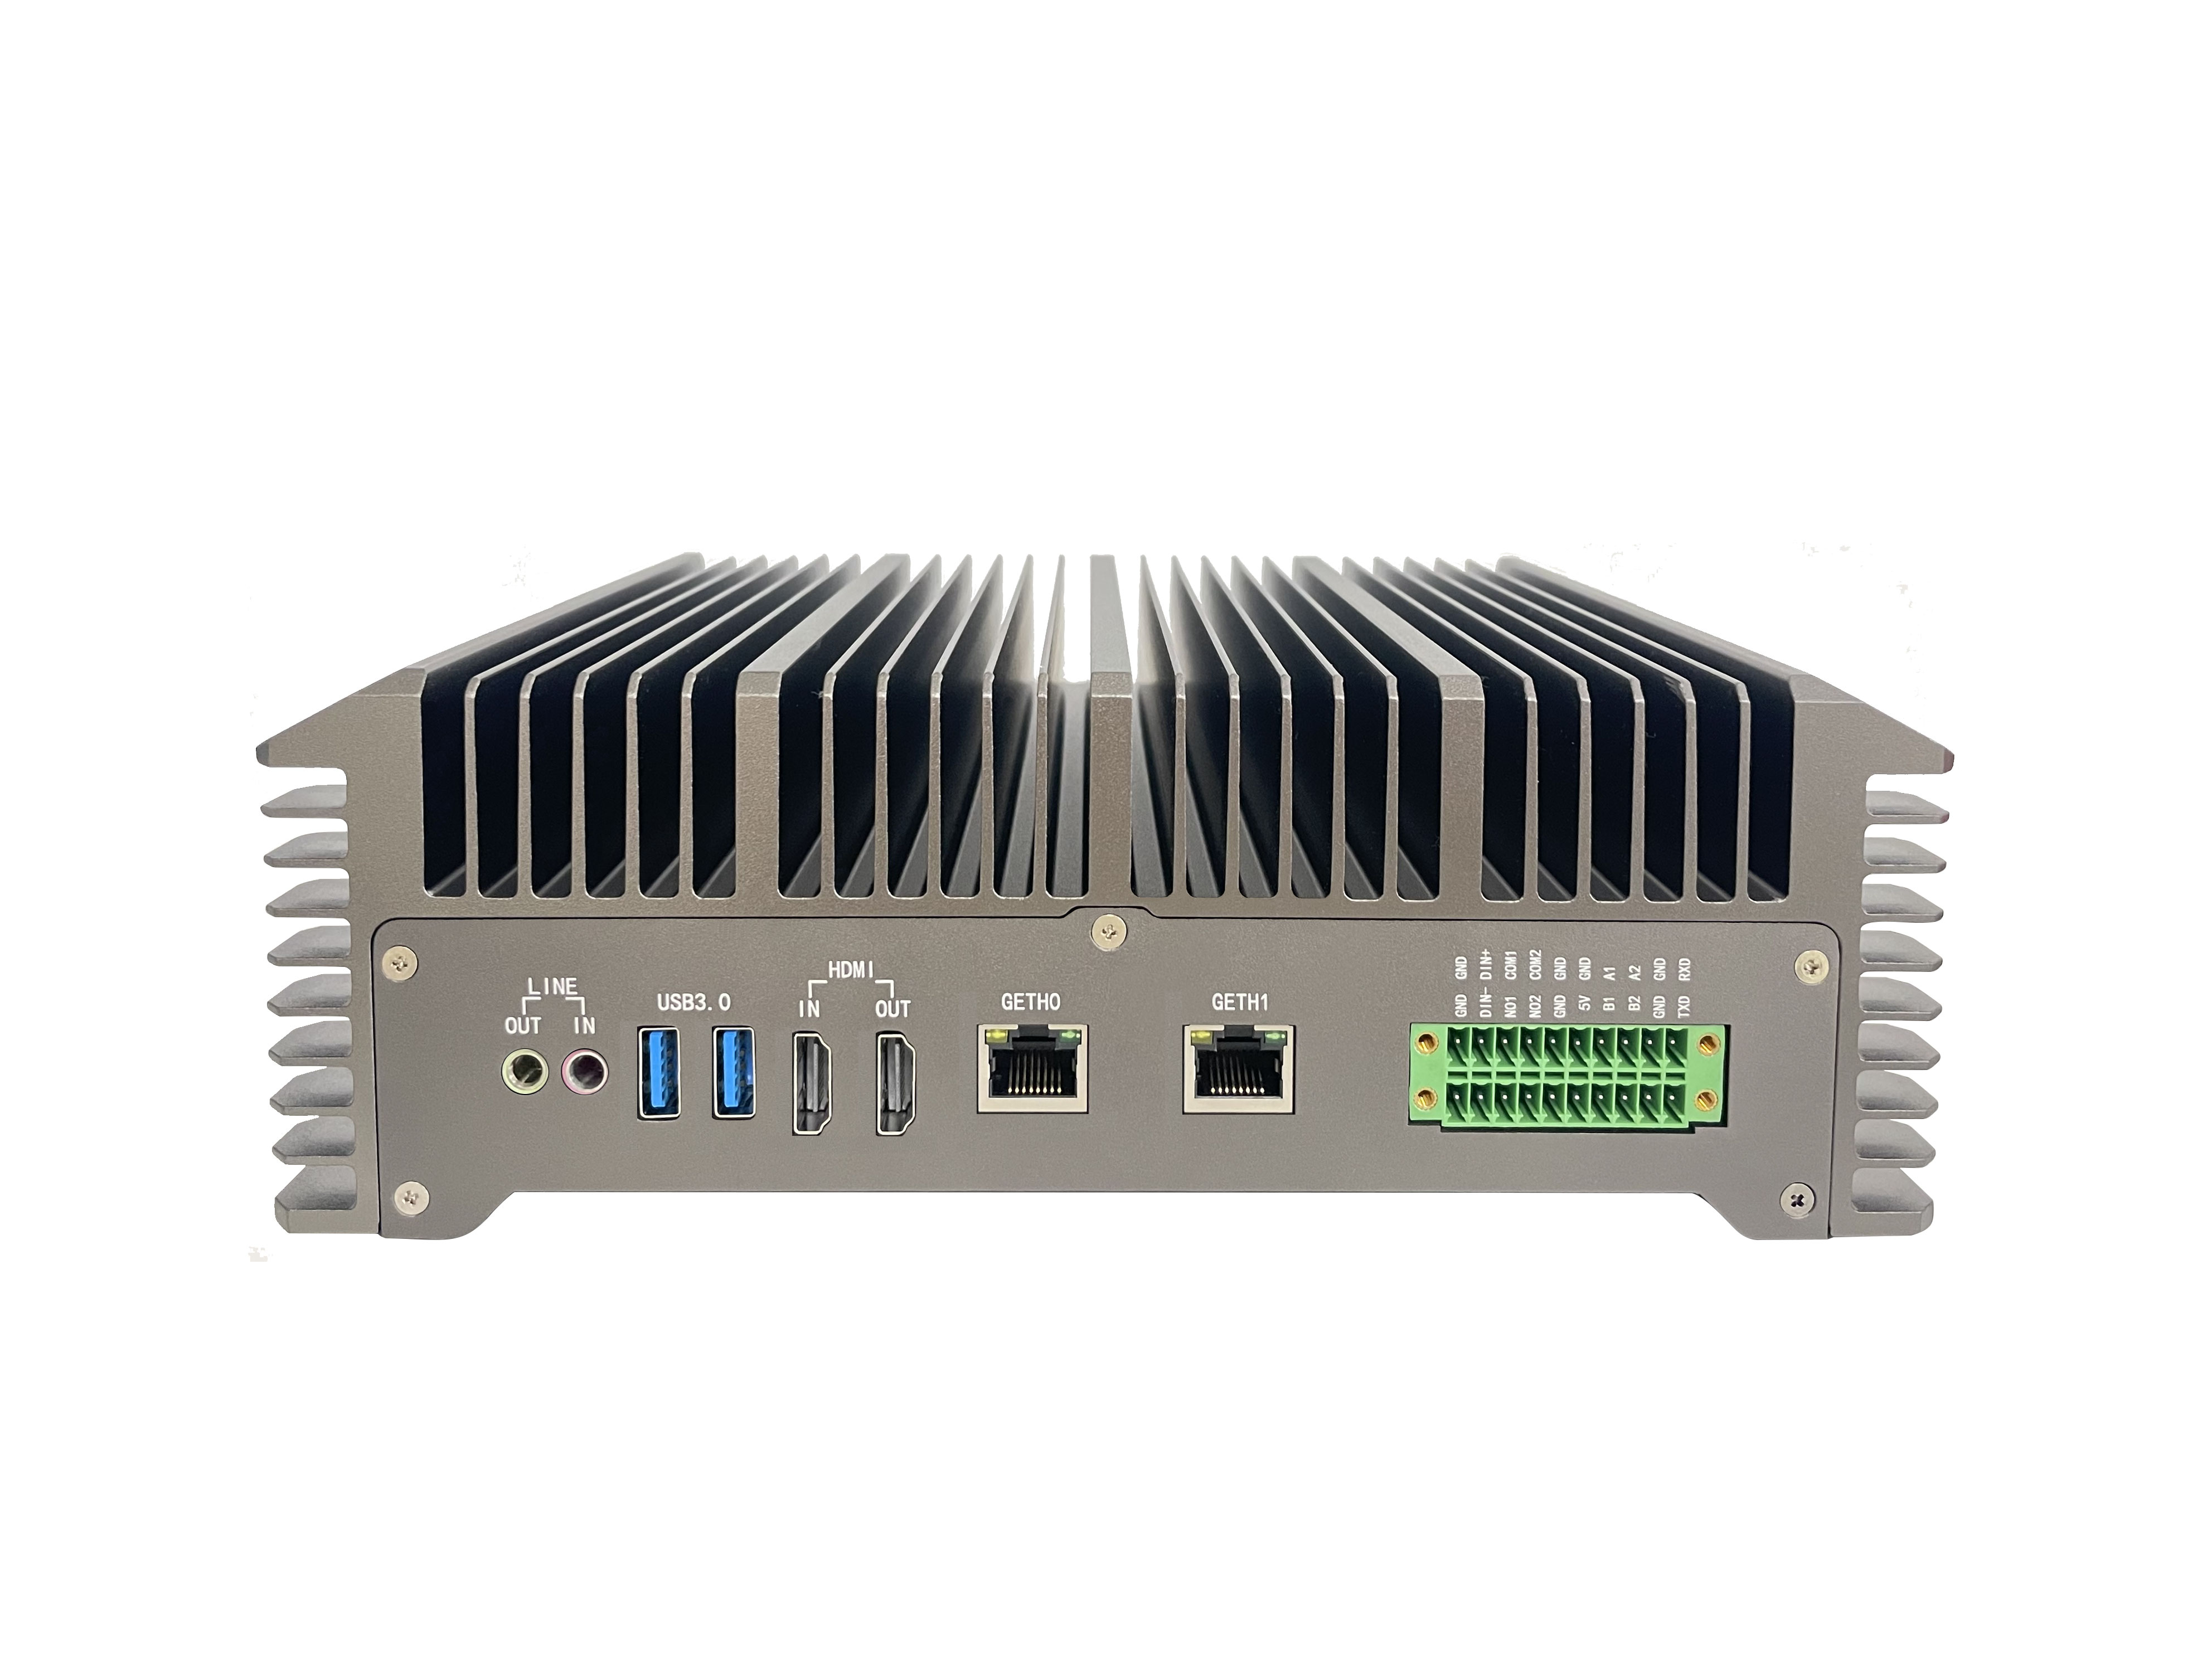
2026 年 AI 大模型落地、多路视频智能分析、工业 / 工地 / 城管全域智能化需求爆发,边缘计算盒子成为行业刚需。市场分化为大厂自研整机、国产算力硬件厂商
2026 年边缘 AI 全面进入端侧大模型落地时代,传统固定算力视频盒子已无法满足本地私有化 LLM/VLM 多模态推理需求,市场分化为两大赛道:通用视频分析型
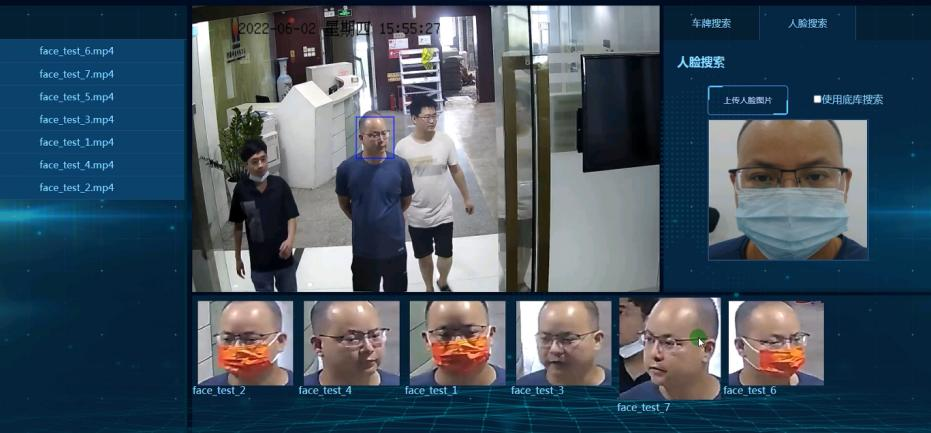
一、硬件能否支持离线人脸算法?完全支持,原生适配本地全离线人脸识别整套流程,无需联网、不上传人脸数据核心硬件基础1. NPU 算力:内置 2.0~3.0TOPS
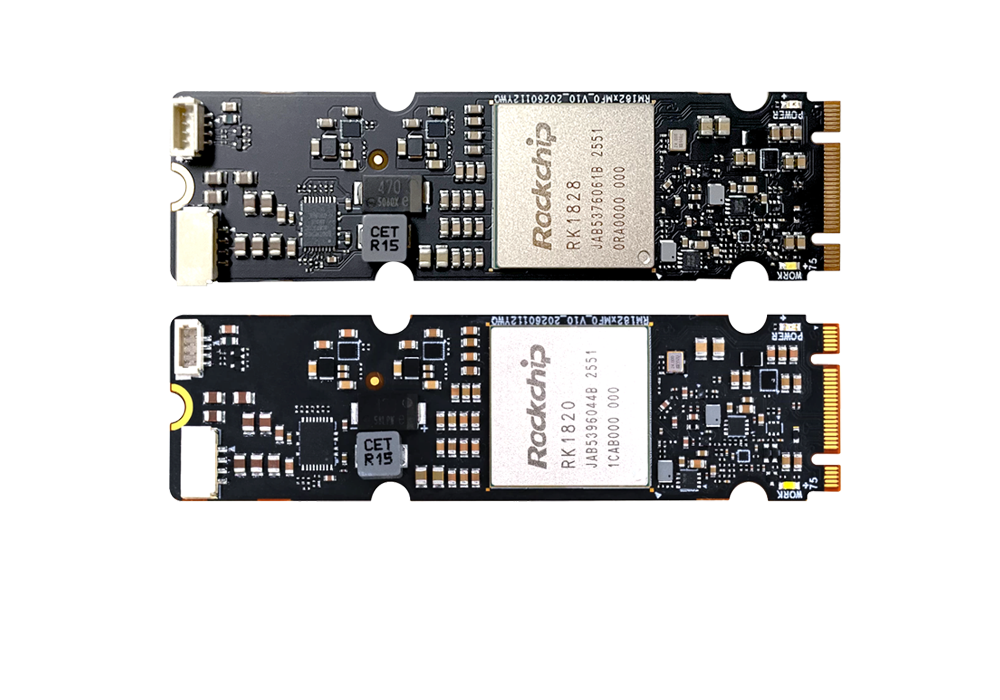
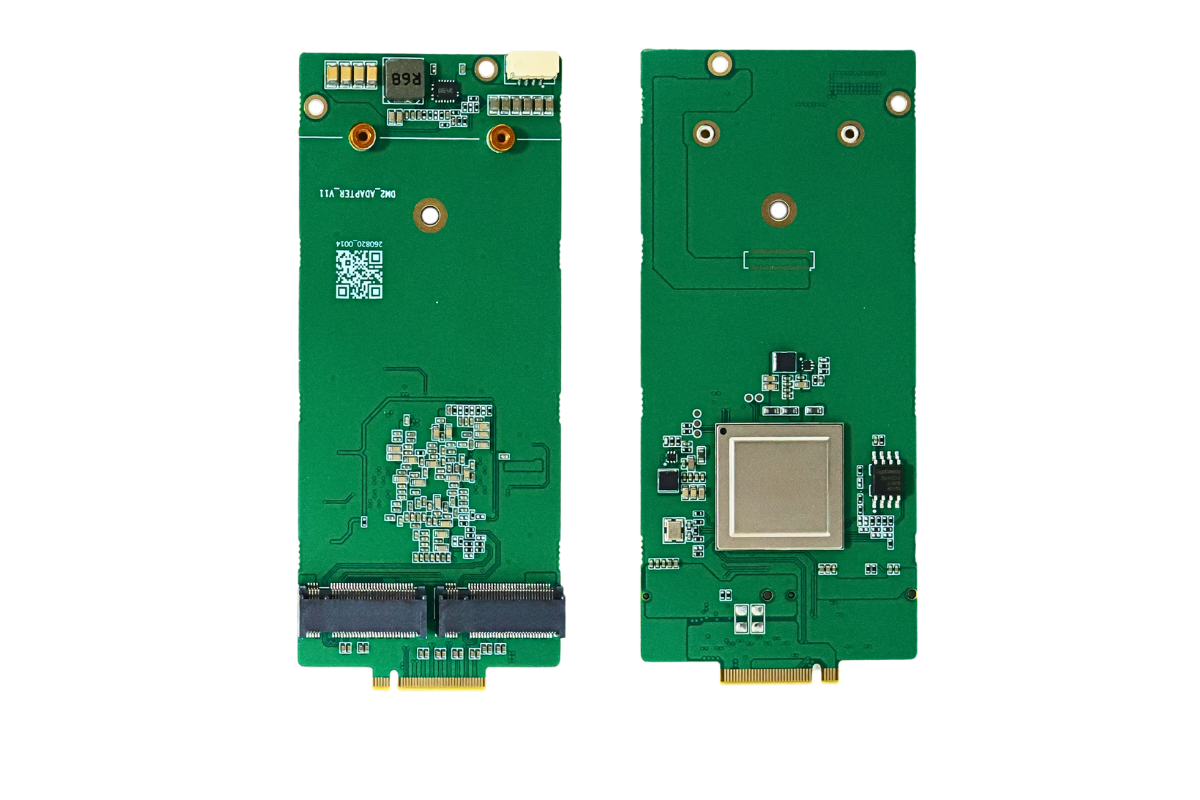
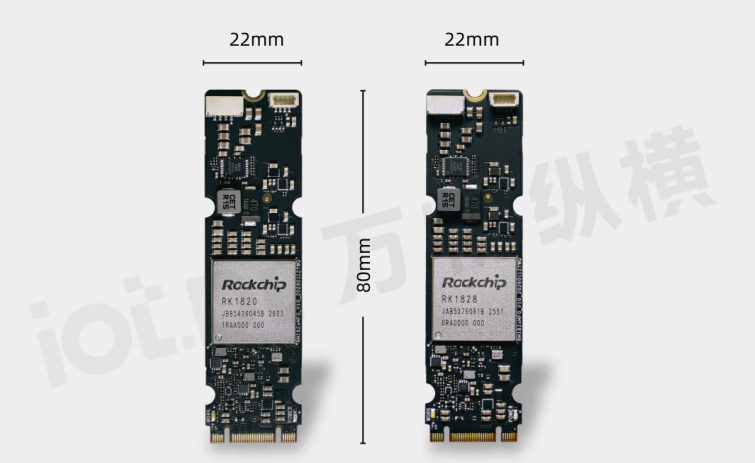
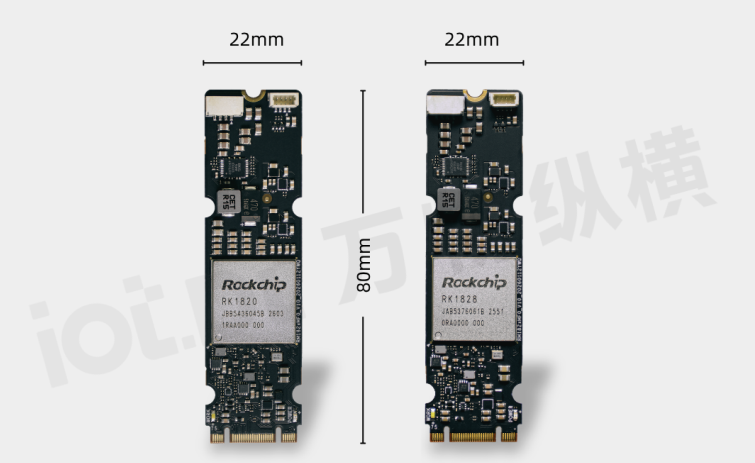
RK1820、RK1828 同属瑞芯微 RK182X 系列 M.2 标准 AI 协算力模组,是专为端侧本地大模型推理打造的 PCIe 扩展加速卡,不能独立做主控
一、硬件算力基准(INT8)RK3588 内置 NPU:6 TOPS,板载 LPDDR 内存,带宽约几十 GB/sRK1828 M.2 协处理器:20 TOPS
*












 试用申请
 产品咨询
 在线客服
 回到顶部