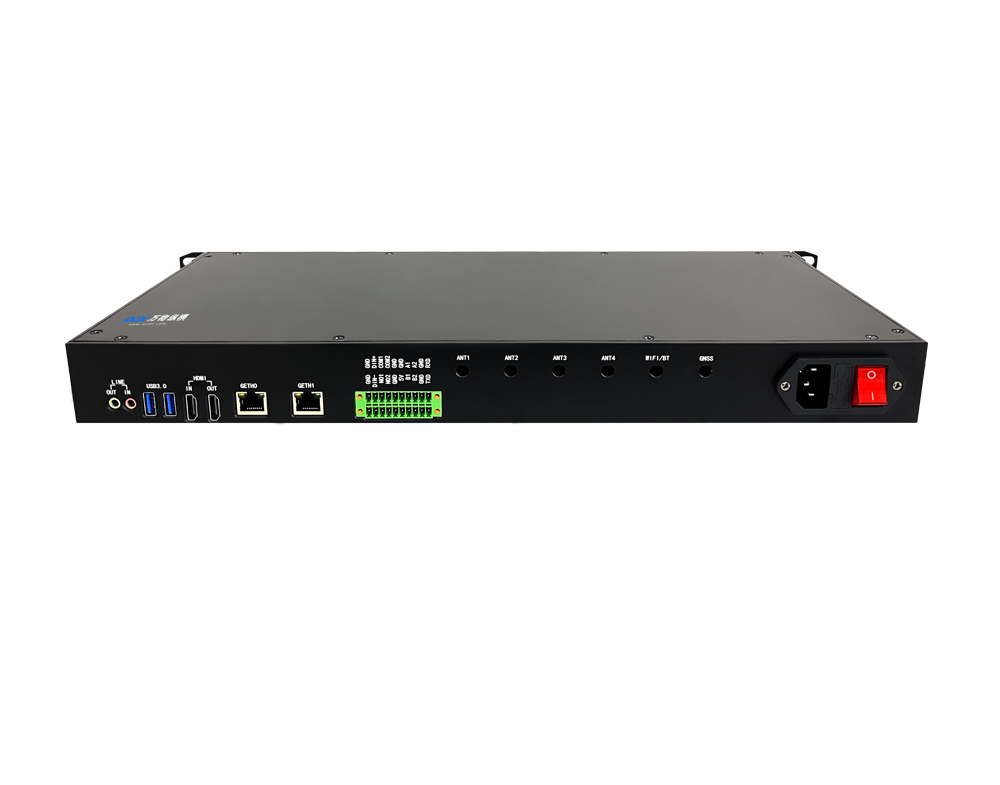
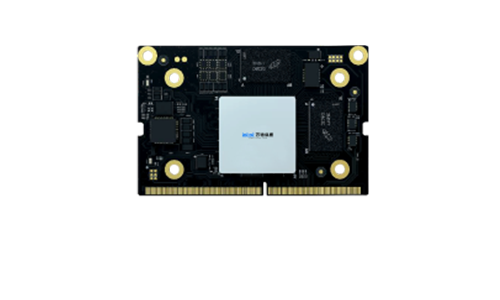
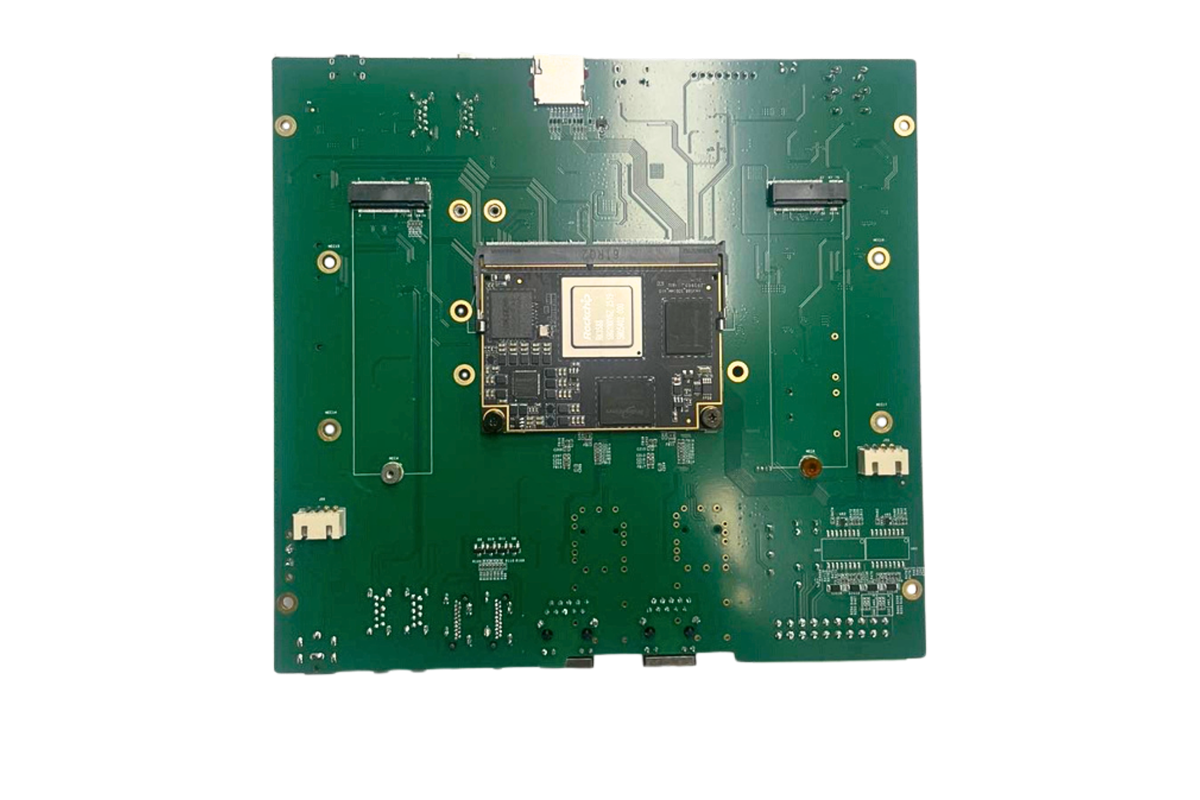
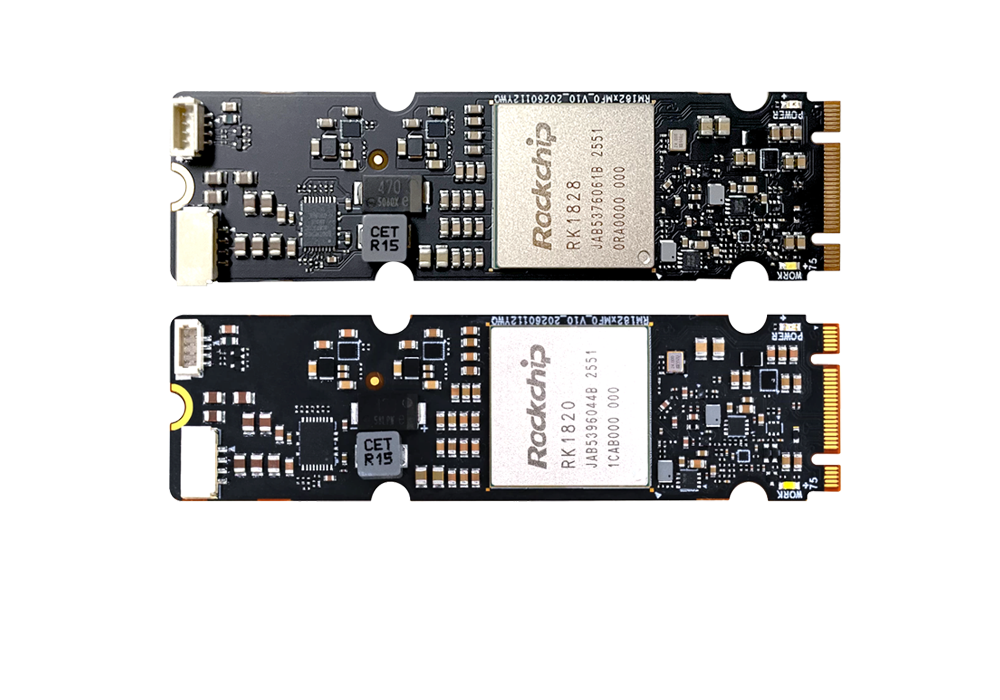
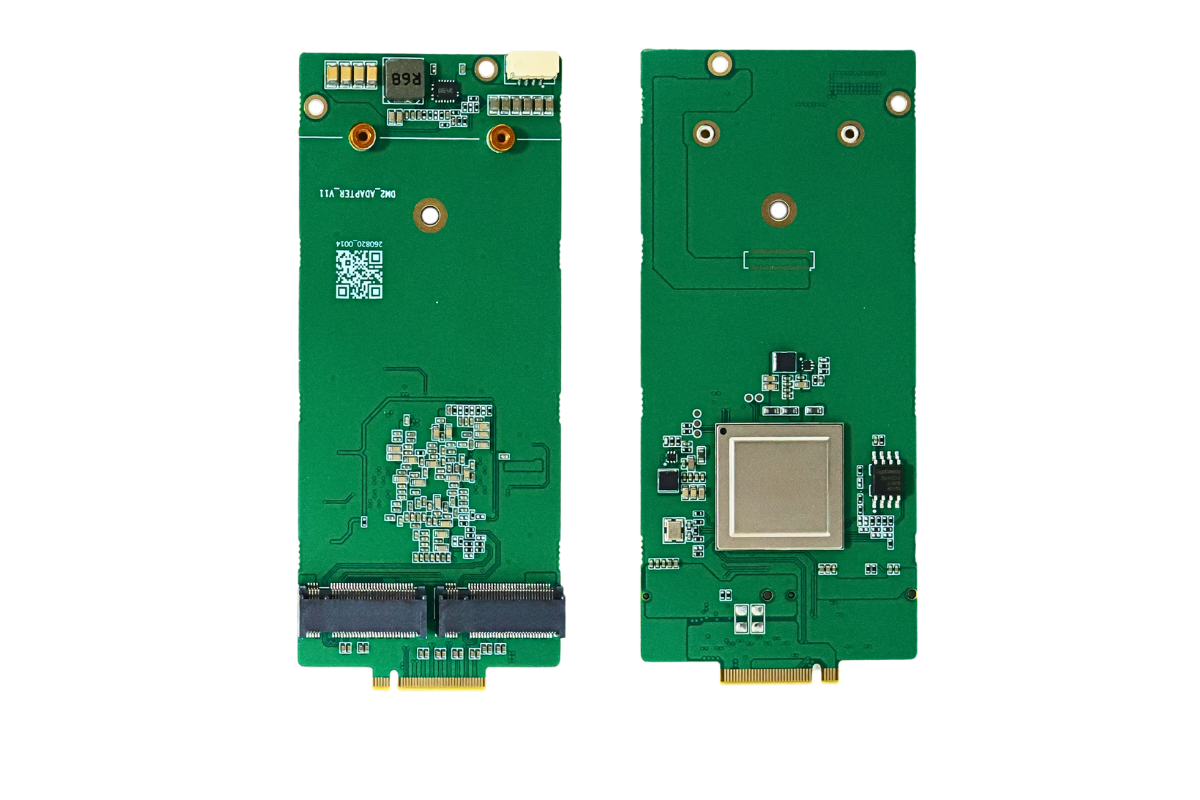
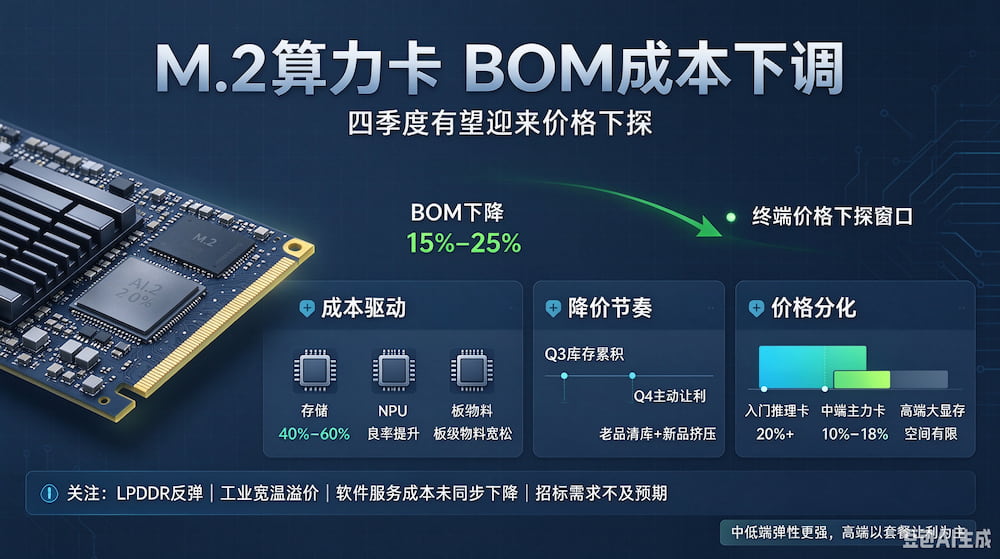
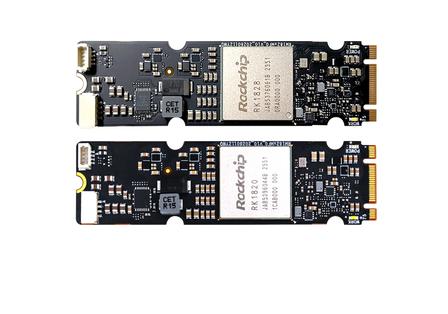
一、核心逻辑:BOM 降本来自三大部件M.2 2280 形态 AI 算力卡(国产 NPU 为主:力擎 LQ50、算能 BM1684X、RK1828、摩尔线程花港
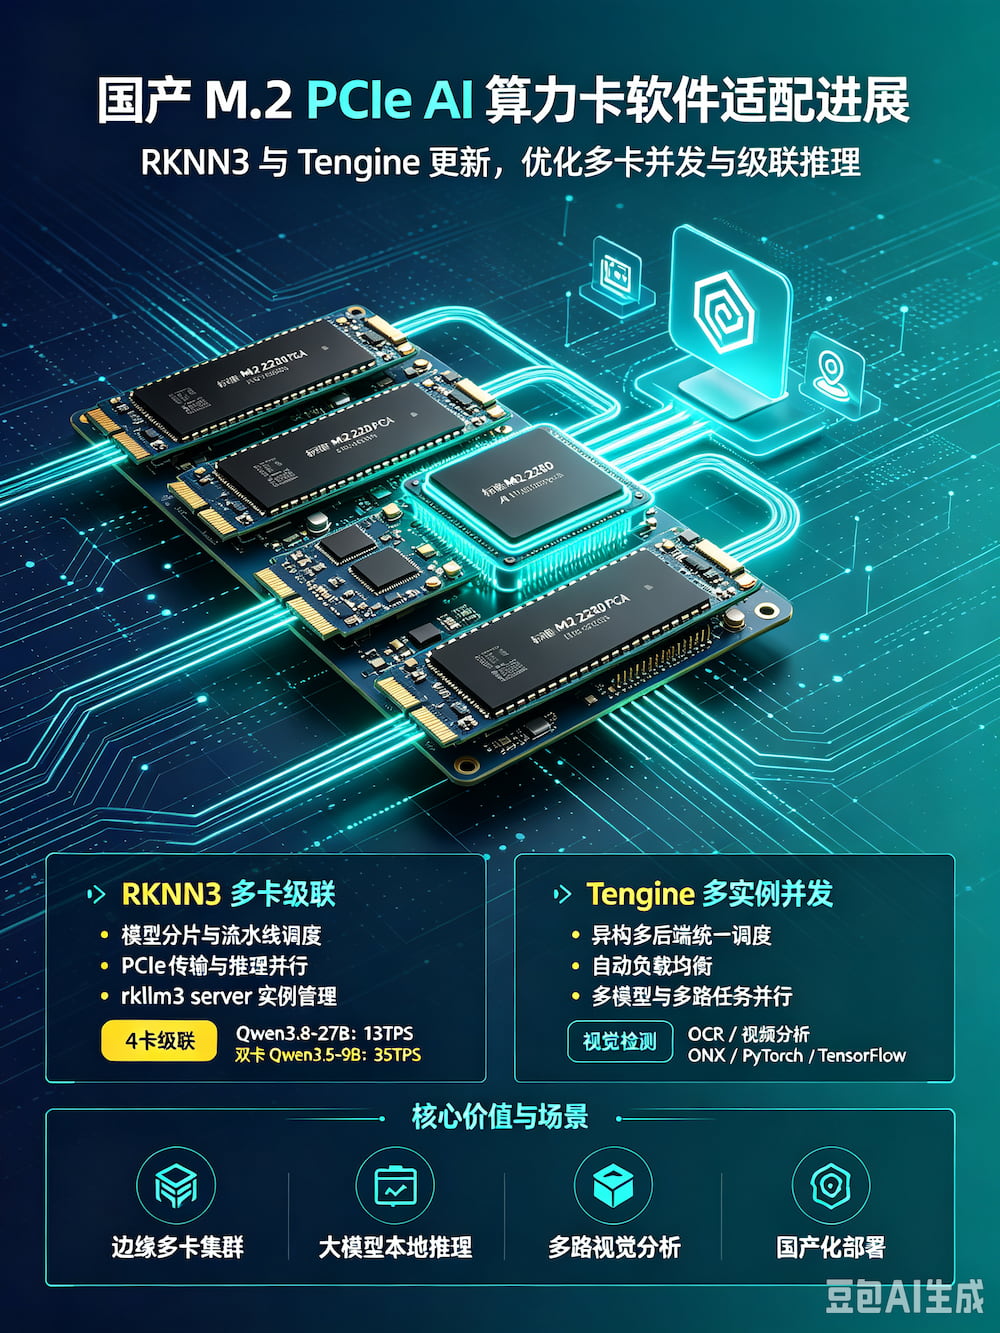
国产 M.2 形态 PCIe AI 算力卡生态持续补齐软件短板,RKNN、Tengine 两大国产推理框架陆续发布新版本,重点针对 M.2 多卡并发、多卡级联推
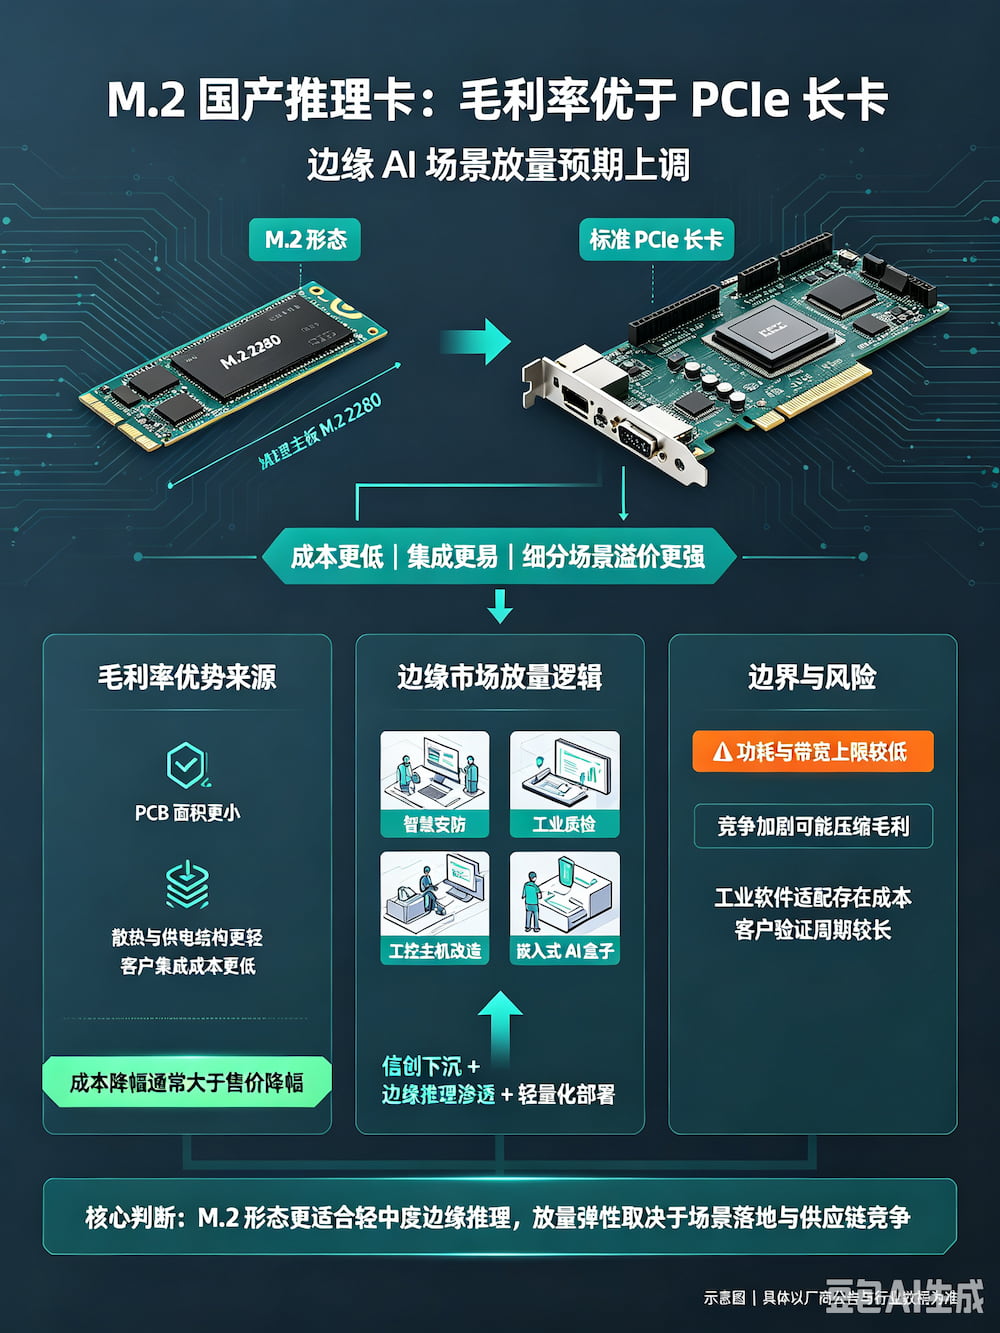
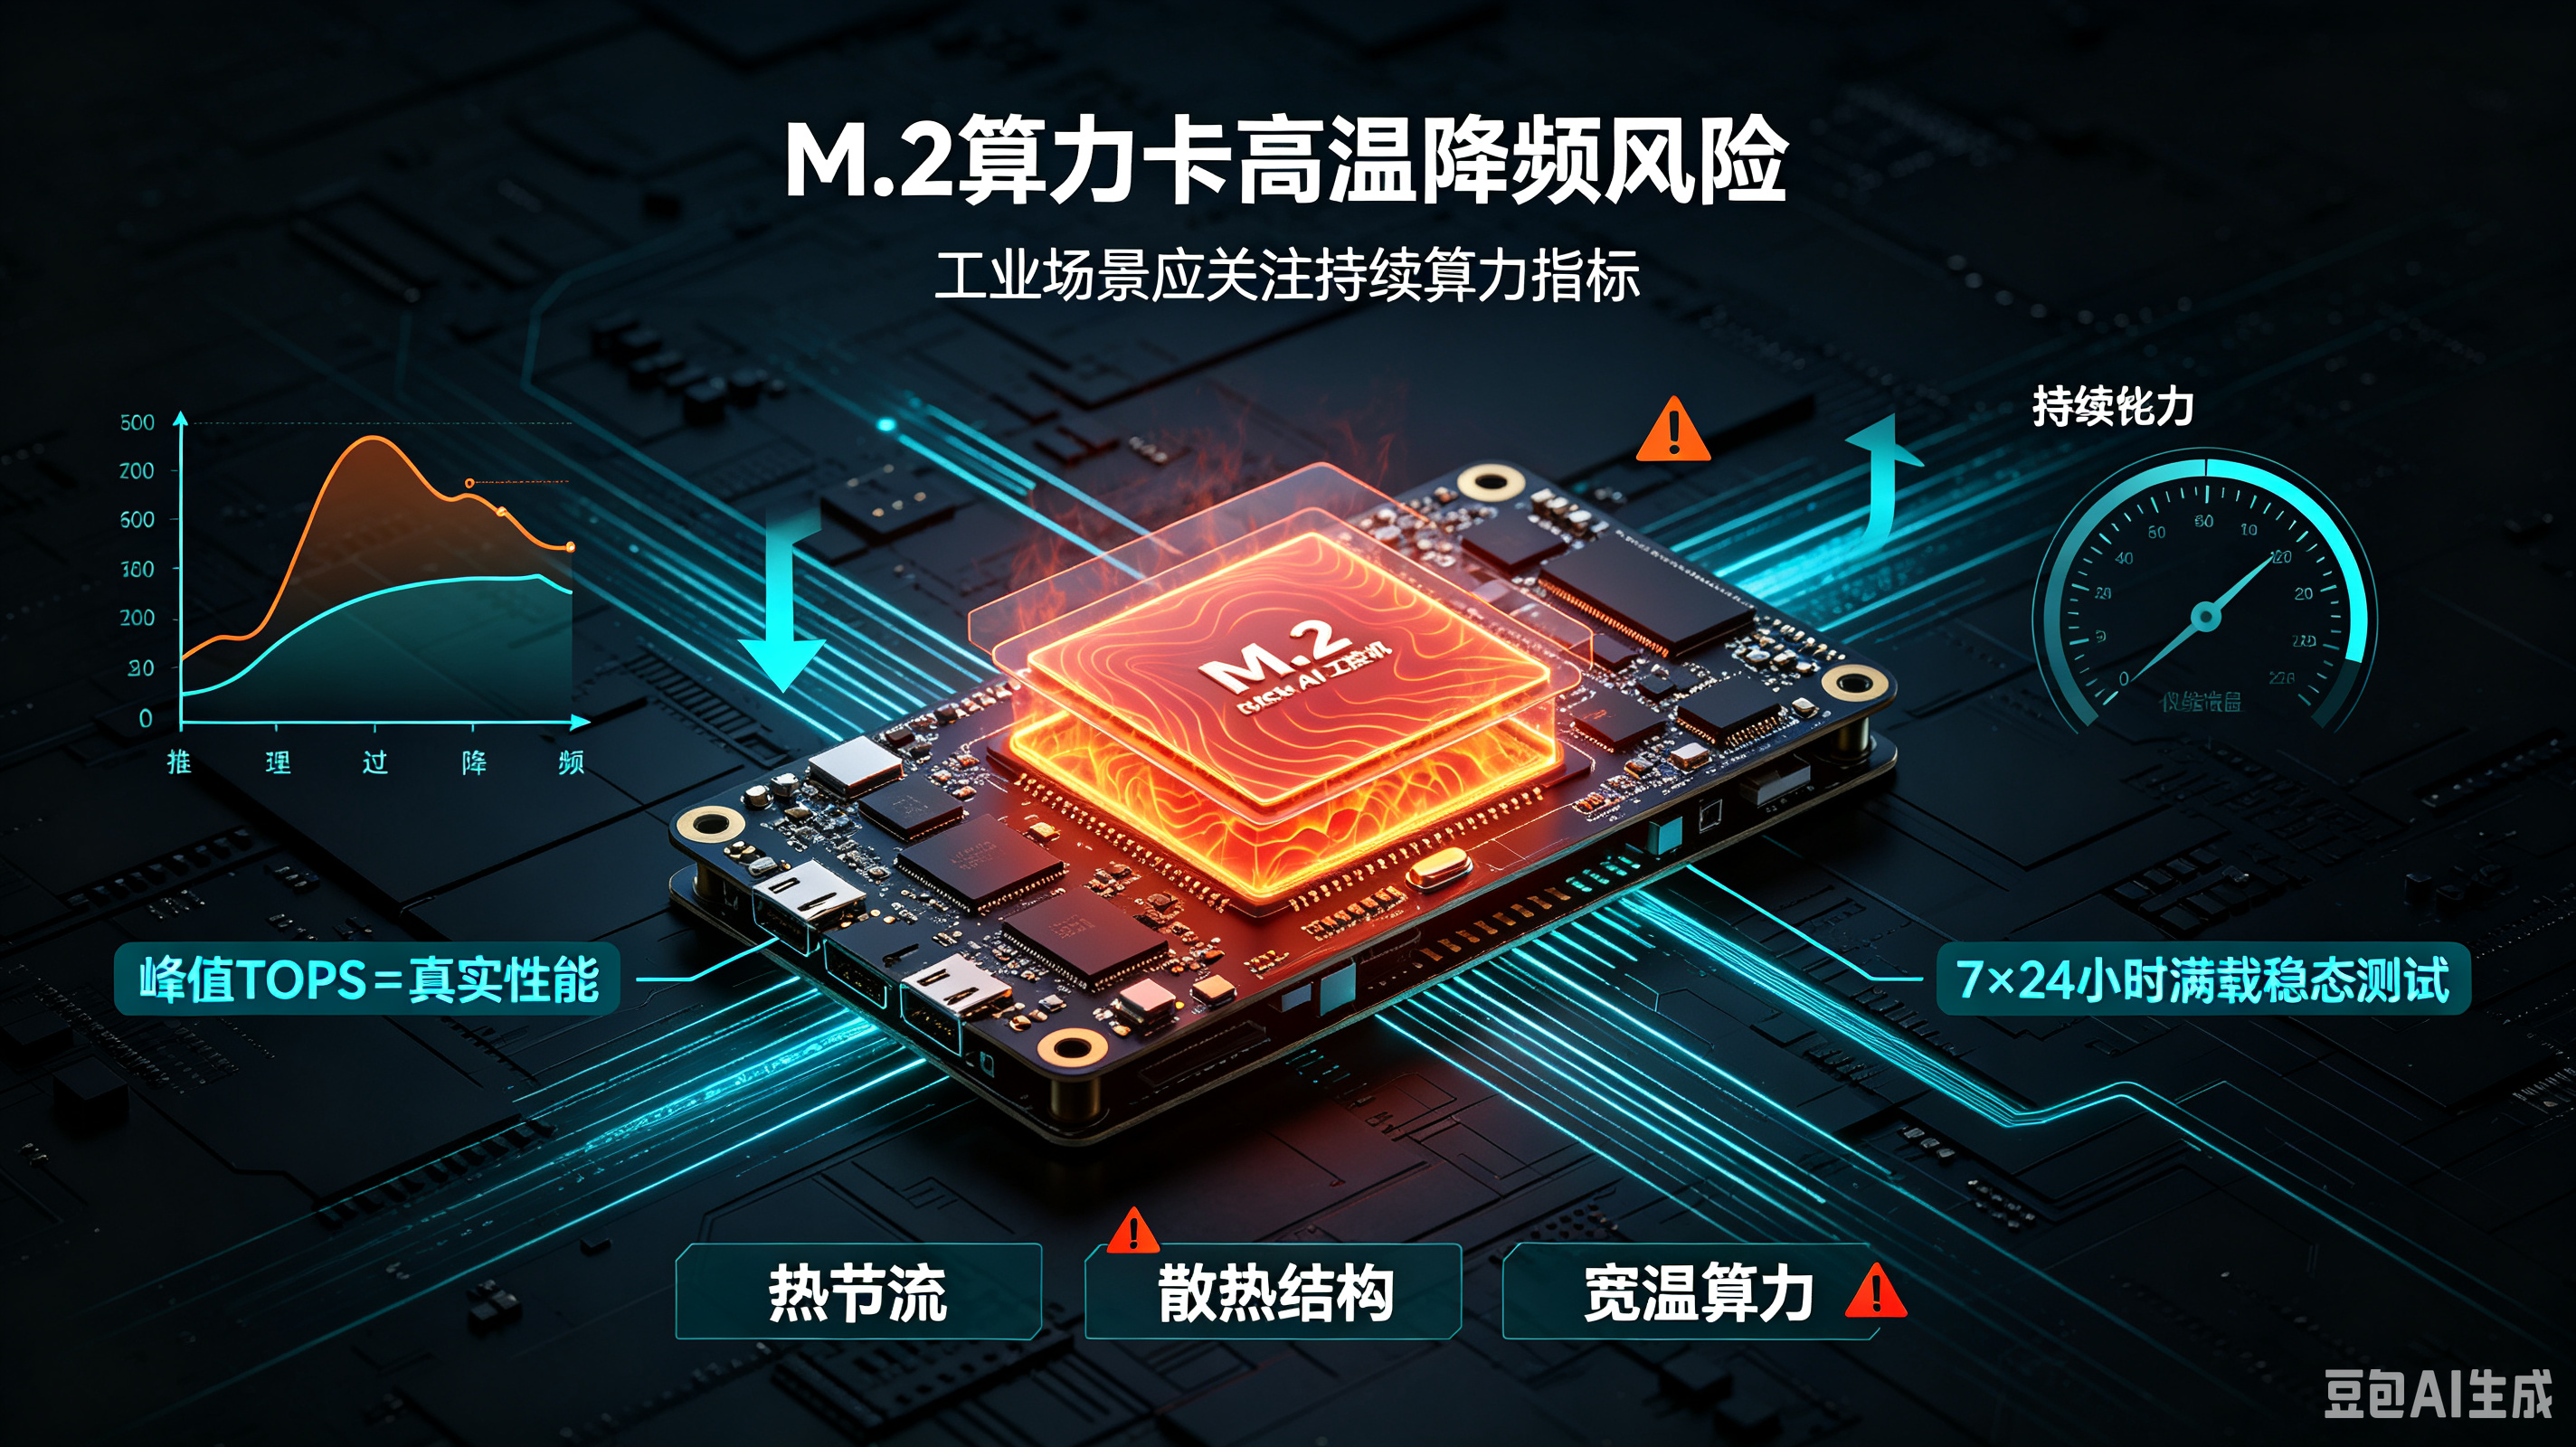
M.2 2280/2260 这类小型化推理卡,硬件 BOM 成本、PCB 面积、散热结构、配套电源 / 机箱改造要求显著低于标准高度 PCIe 长卡;目标场景聚
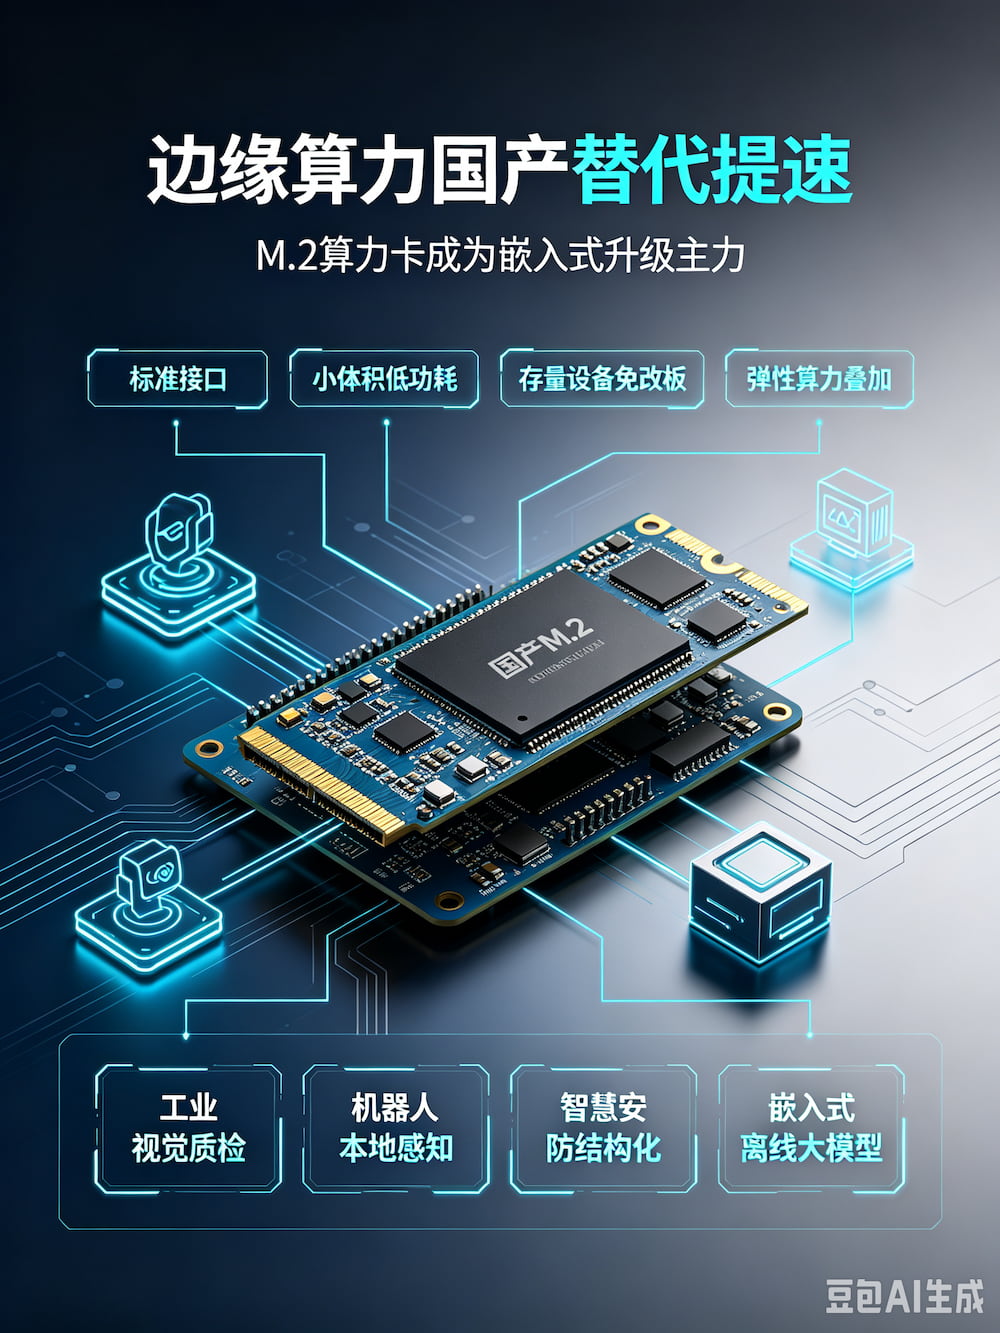
随着工业视觉、机器人、明厨亮灶、智慧工地、电力光伏巡检等边缘场景 AI 需求爆发,叠加信创与供应链自主可控要求,边缘算力国产替代进入加速期。M.2 规格 AI
随着边缘 AI 快速落地,M.2 形态 AI 算力卡凭借体积紧凑、PCIe 即插即用、易于集成的优势,大量应用于智慧工地、明厨亮灶、光伏巡检、车载边缘、工业视觉
核心本质:板载 NPU=SoC 一体化,算力固定、延迟低、省空间;M.2 算力卡 = PCIe 外挂协处理器,算力可扩展,但受 PCIe 带宽、散热、供电约束。
*







 试用申请
 产品咨询
 在线客服
 回到顶部