
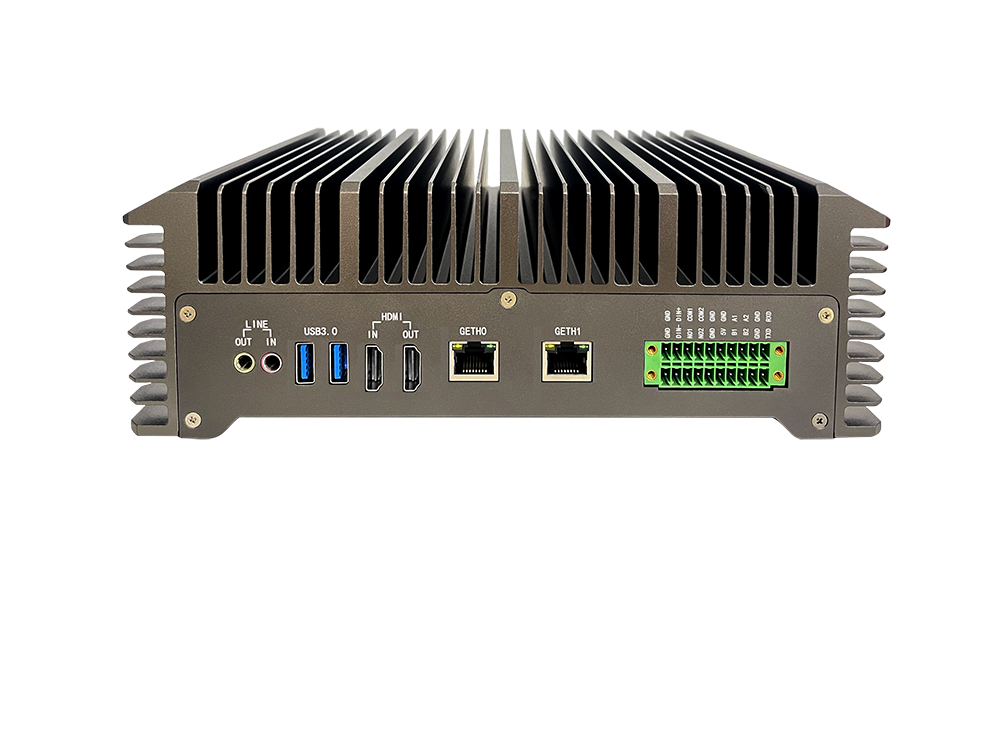
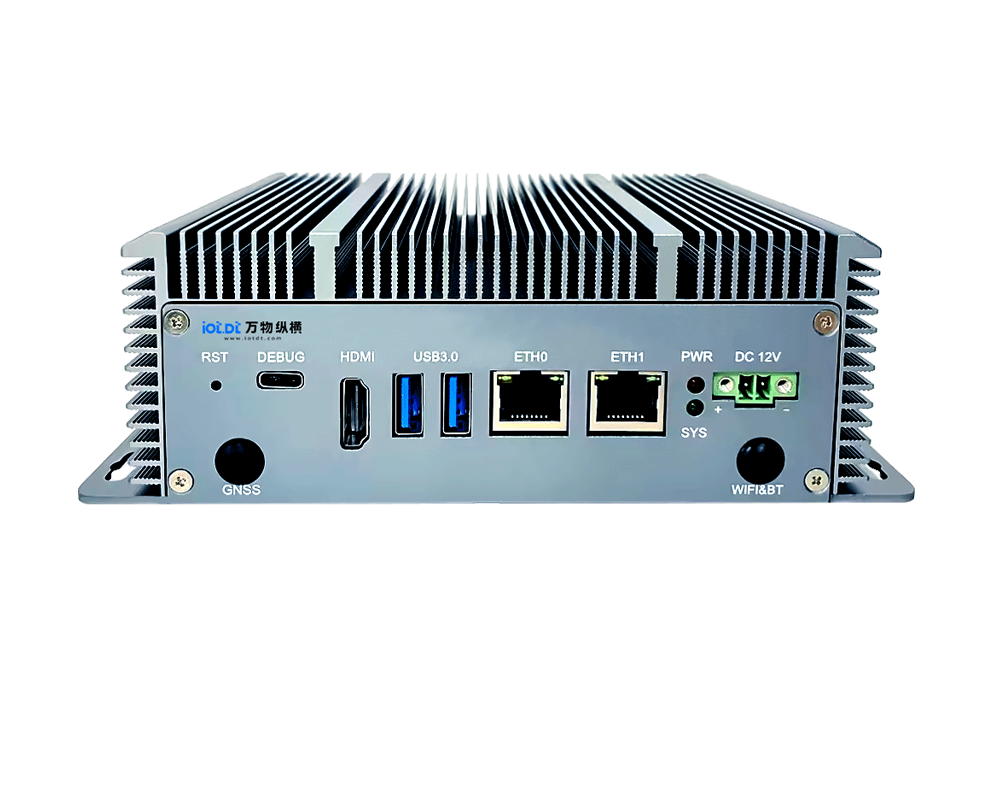
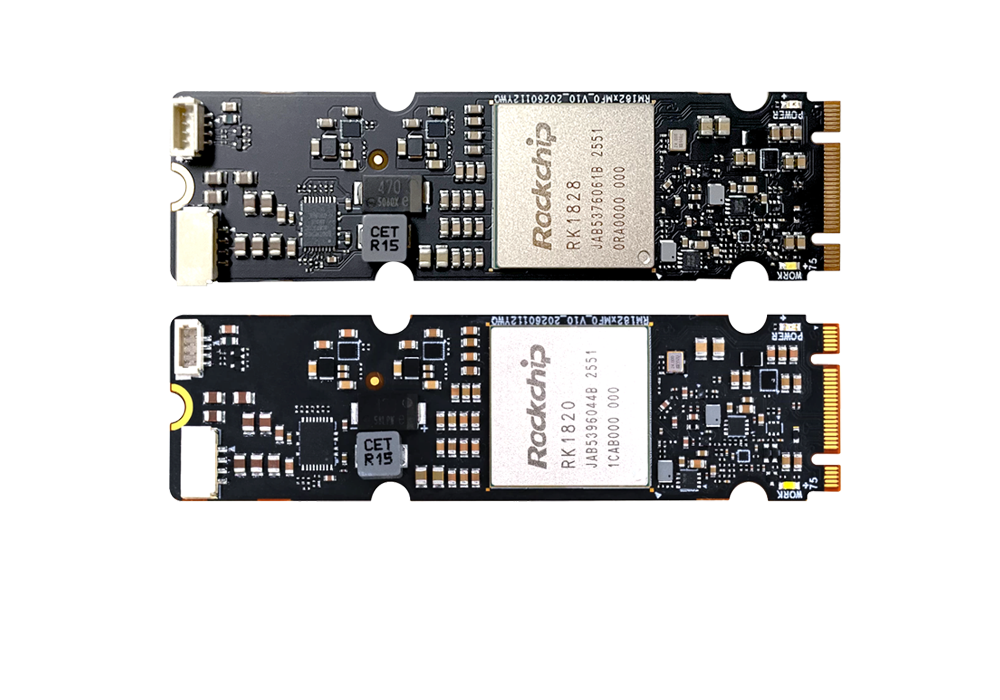
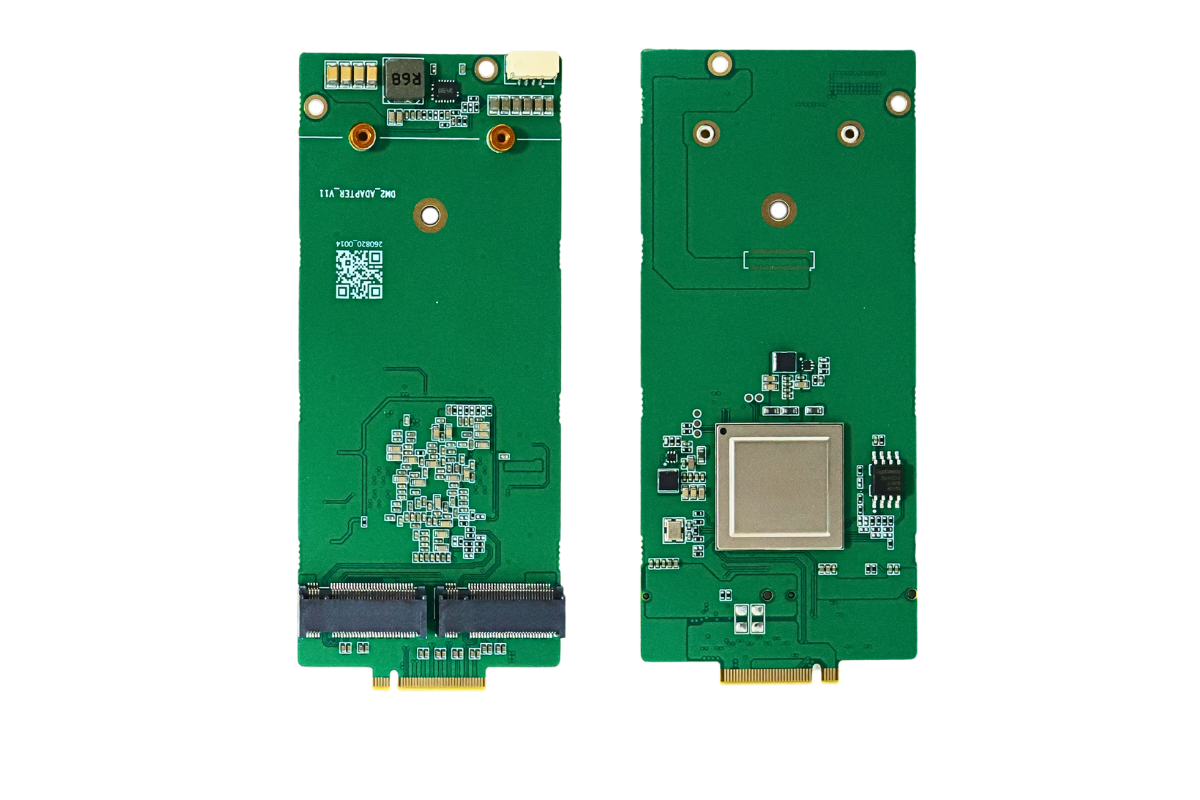


当前边缘 AI 产业正从试点验证进入规模落地阶段,M.2 形态 AI 算力卡快速成为行业主流选型。核心并非单纯的算力提升,而是精准命中了边缘场景的三大底层痛点,核心原因可归纳为三点:
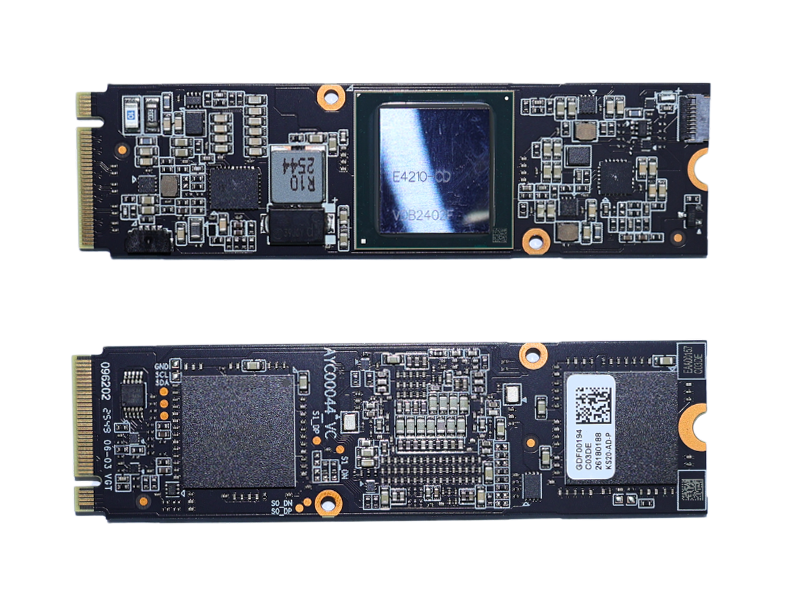
标准化通用接口,存量设备零改造升级
M.2 是消费级与工业级设备早已普及的标准化硬件接口,主流 2280/M-Key 形态兼容 PCIe Gen3/Gen4 传输协议,可直接适配 x86、ARM、RISC-V 等几乎所有架构的嵌入式主板、工业网关、工控机、智能终端的原生 M.2 插槽。
这意味着设备厂商无需重新设计 PCB、无需重构整机结构,甚至已现场部署的存量设备,都能通过插卡的方式完成 AI 算力升级,大幅降低了智能化改造的硬件成本与研发周期,解决了边缘设备碎片化、定制化成本高的行业顽疾。
极致能效比,适配边缘严苛的功耗与散热约束
边缘场景的核心硬件约束从来不是峰值算力,而是功耗、散热与物理空间的三重限制:大量工业网关、安防设备、车载终端、移动机器人都采用无风扇密封设计,依赖电池或窄幅供电,散热能力极其有限。
主流 M.2 AI 算力卡的典型 TDP 仅 2~10W,却能提供 20~40 INT8 TOPS 的推理算力,单位功耗算力效率远高于传统全高 PCIe 算力卡;低热设计可直接适配 -40℃~85℃ 工业宽温环境,支持太阳能供电、电池续航等受限供电场景。这是高功耗算力卡无法渗透边缘侧的核心壁垒,也是 M.2 卡的不可替代优势。
算力解耦模块化,灵活迭代降本抗风险
边缘 AI 模型正处于快速迭代期,从传统视觉检测到大语言模型、多模态模型,算力需求与模型架构变化极快。M.2 算力卡实现了"算力模组"与"主机主板"的物理解耦:
算力可弹性配置:同一款主板可根据场景需求,搭载不同算力档位的 M.2 卡,覆盖从轻量目标检测到 7B 级大模型推理的不同需求;
升级迭代成本低:模型架构升级后无需更换整机,仅替换算力卡即可完成性能迭代,大幅降低硬件淘汰风险;
供应链成熟可控:复用了消费级 SSD 成熟的 M.2 封装与生产供应链,模组采购成本与交付稳定性远优于定制化算力模组。
本质上,M.2 算力卡的普及,是边缘 AI 从"定制化试点"走向"规模化落地"的必然选择——它用标准化、低功耗、模块化的特性,解决了边缘场景碎片化、成本敏感、迭代快的核心矛盾。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部