


M.2 形态算力卡不会成为所有嵌入式设备的强制标配,但会成为中高端嵌入式设备、存量智能化升级场景的标准扩展选项——其定位类似于当下的 M.2 NVMe 固态硬盘:主流设备主板普遍预留插槽,用户可按需选配算力等级,最终形成"主控集成 NPU 做基础推理 + M.2 算力卡做生成式 AI 加速"的分层架构。
随着端侧生成式 AI(LLM/VLM)从概念走向规模化落地,M.2 算力卡正在从"小众扩展配件"向"嵌入式平台常规算力通道"演进。
一、M.2 算力卡借生成式 AI 崛起的核心逻辑
端侧生成式大模型对显存容量、内存带宽、独立算力资源的强需求,恰好击中了传统"主控集成 NPU"方案的短板,而 M.2 形态完美匹配了嵌入式设备的升级需求。
1. 标准接口,零主板改造成本的算力升级
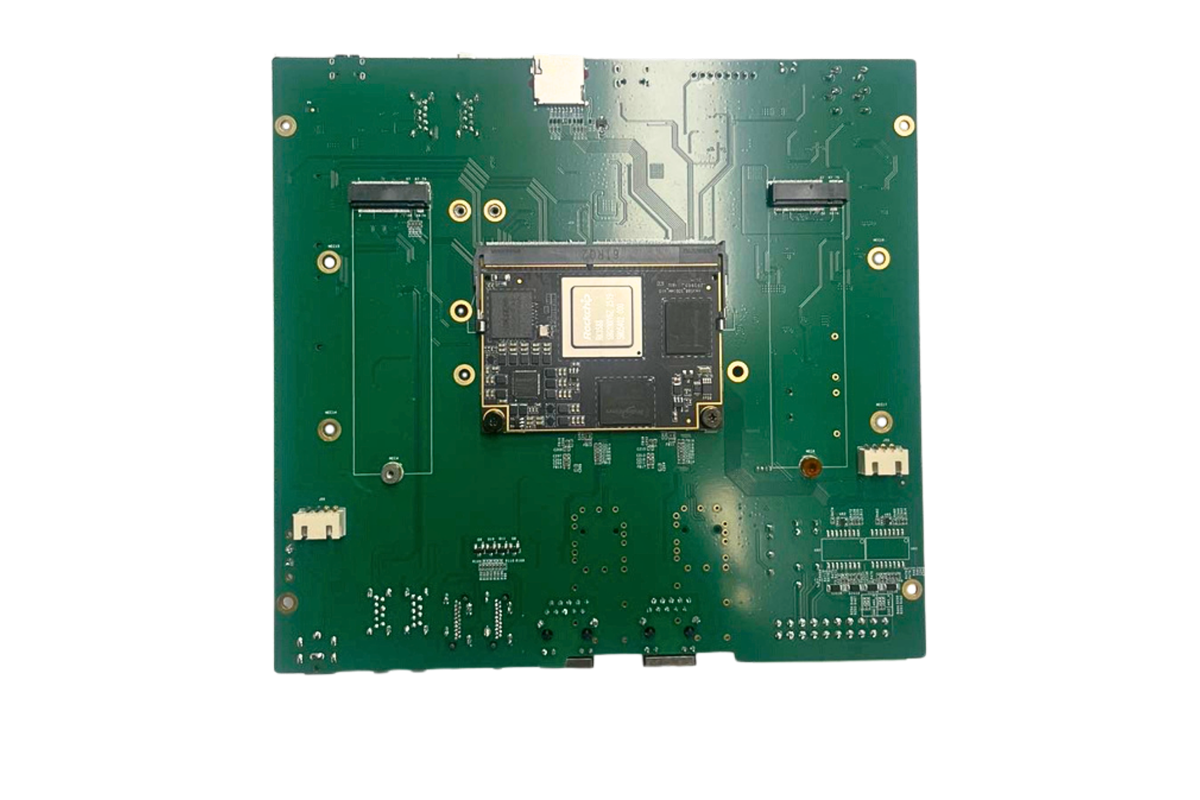
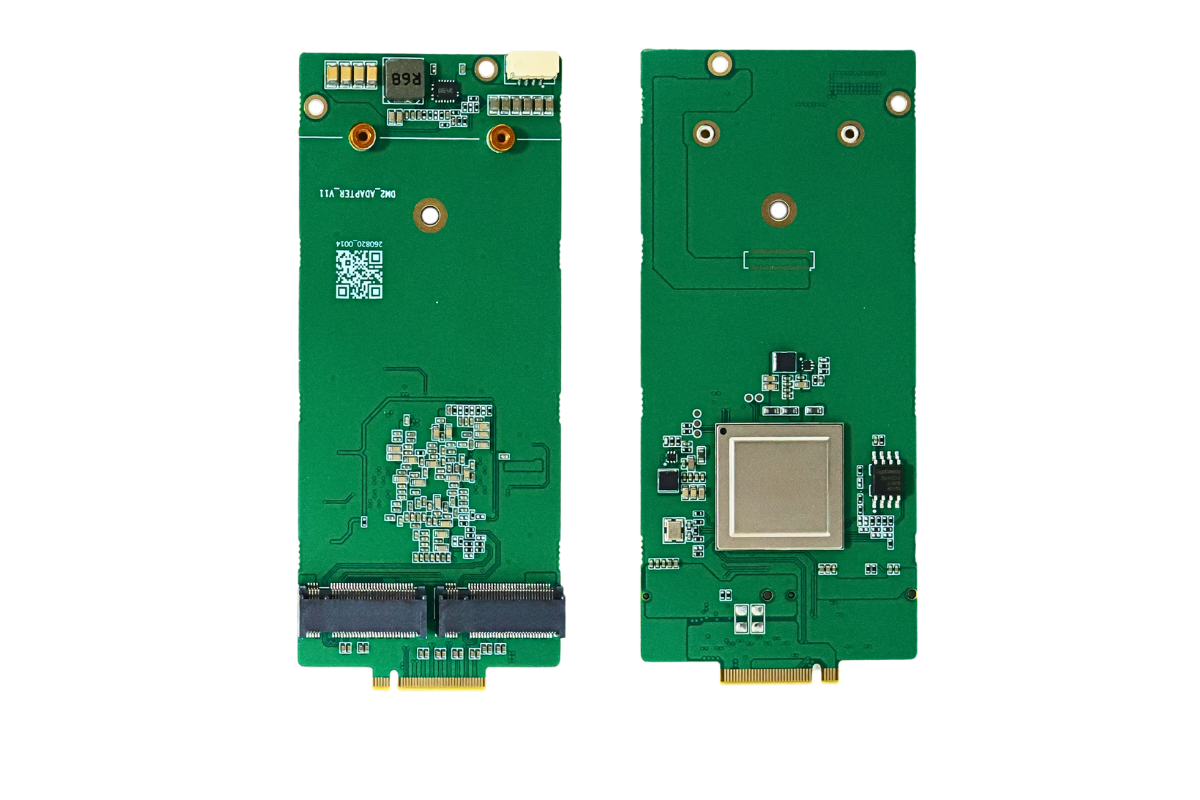
M.2 是嵌入式与 x86 工业平台通用的物理接口,大量存量设备(工控机、边缘网关、NVR、自助终端、工业机器人)已预留 M.2 插槽(原用于存储、4G/5G 模组),无需重新设计主板,插入算力卡即可补齐生成式 AI 能力,硬件改造成本降低 80% 以上。
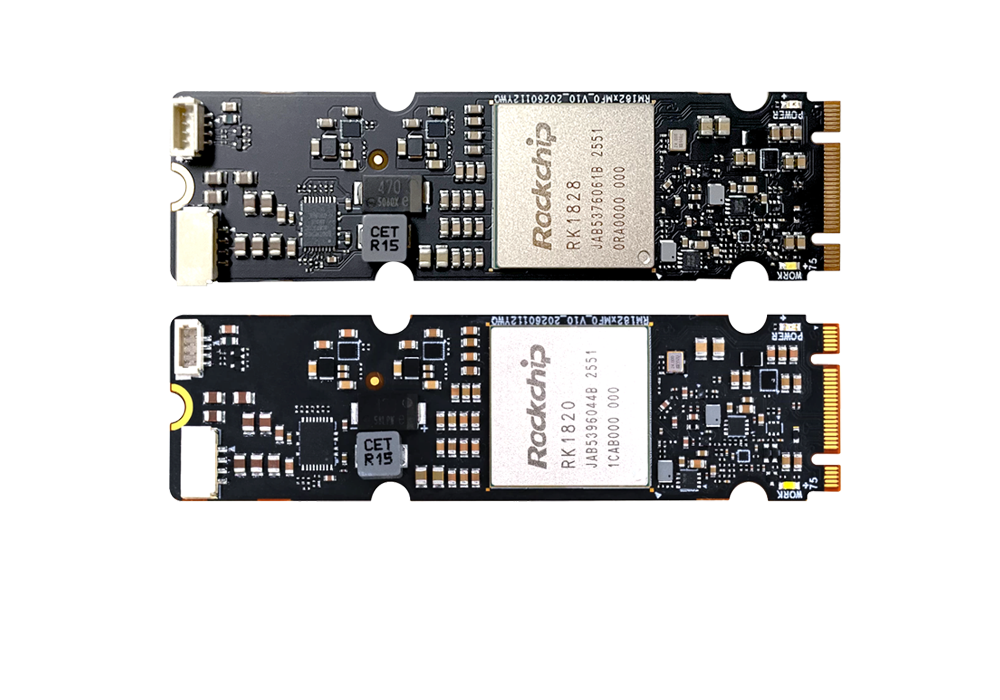
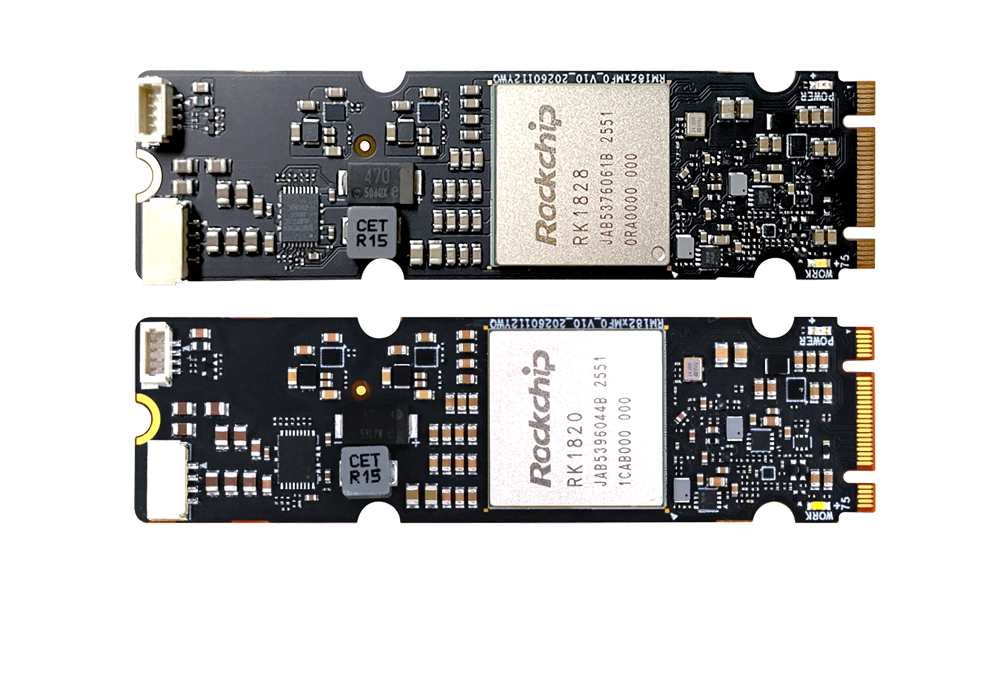
典型如瑞芯微 RK1828 M.2 算力卡,可直接插在 RK3588 开发板的 M.2 插槽上,为主控额外增加 20TOPS INT8 算力与 5GB 独立显存,原生支持 7B 级大模型本地推理,无需改动原有系统设计。
移远通信 QSC600XA-AP 等产品已完成 Intel、AMD、树莓派、瑞芯微等多平台适配,真正实现"即插即用"的算力扩容。
2. 尺寸与功耗精准匹配嵌入式场景
主流 M.2 AI 加速卡均采用 2280/2242 标准尺寸,功耗集中在 2.5W~12W 区间,峰值普遍低于 15W,适配嵌入式设备"空间紧凑、无风扇散热、低功耗长时运行"的核心要求。
产品型号 | 算力(INT8) | 典型功耗 | 显存容量 | 定位 |
Hailo-8 M.2 | 26 TOPS | 2.5~8.65W | — | 视觉+轻量生成式推理 |
瑞芯微 RK1828 | 20 TOPS | 5~10W | 5GB 3D堆叠DRAM | 7B级 LLM/VLM 本地推理 |
DeepX DX-M1 | 25 TOPS | 2~5W | 4GB LPDDR5 | 低功耗边缘推理 |
恩智浦 Ara240 | 40 TOPS | 12W | 16GB LPDDR4 | 高性能边缘生成式 AI |
数据综合自公开产品规格。
3. 独立显存破解生成式 AI 的"内存墙"
传统主控集成 NPU 方案中,NPU 与 CPU 共享系统内存,大模型推理时参数搬运带宽严重不足,6TOPS 的硬件算力往往只能发挥 30% 不到。而 M.2 算力卡普遍搭载独立显存,部分高端型号采用 3D 堆叠封装(如 RK1828),内存带宽远高于主控共享内存,可充分释放大模型推理性能。
例如 RK1828 凭借 5GB 片上堆叠内存,可独立运行 Qwen、LLaMA2 等 7B 级大模型,推理速度达 100+ tokens/s,完全不占用主控系统资源。
4. 模块化算力,灵活匹配场景需求
嵌入式场景算力差异极大:从简单的语音交互到复杂的多模态工业质检,单一算力规格无法覆盖所有需求。M.2 算力卡支持"按需选配、多卡堆叠":
入门场景用 20TOPS 级卡片覆盖 3B 模型,中高端用 40TOPS 级卡片覆盖 7B~13B 模型;
部分方案支持多卡集群,如 RK1828 可通过多卡互联承载 27B 级大模型,实现算力的平滑伸缩。
二、成为"全品类标配"的核心瓶颈
M.2 算力卡的普及仍存在多重产业壁垒,无法覆盖所有嵌入式设备。
1. 软件生态碎片化,开发成本偏高
当前各厂商工具链互不通用:Hailo 用 HailoRT、瑞芯微用 RKNN、Axelera 用自有 SDK、寒武纪用 Cambricon Neuware,模型移植需要单独适配,缺乏统一的编程标准。对于批量出货的嵌入式设备,多硬件适配的开发成本会显著抵消硬件升级的收益。
2. 散热与物理尺寸的矛盾
M.2 形态空间狭小,高负载下散热压力突出:10W 以上算力卡大多需要加装散热片,15W 以上甚至需要微型风扇,这与嵌入式设备"密闭防尘、无风扇可靠运行"的要求存在冲突。在高温工业现场、户外网关等场景,M.2 算力卡的长期稳定性仍需验证。
3. PCIe 带宽限制多模态性能释放
多数嵌入式主控的 M.2 插槽仅提供 PCIe 2.0 x1/x2 带宽(理论速率 500MB/s~1GB/s),在传输多模态大模型的高清图像、长文本上下文时,总线带宽可能成为新瓶颈,限制端到端推理延迟的优化空间。
4. 成本劣势明显
一颗集成 6TOPS NPU 的主控 SoC 溢价仅几十元,而一张 20TOPS 级 M.2 算力卡单价普遍在 150~500 元区间,对于算力需求不高、对成本极度敏感的入门级嵌入式设备(如普通安防摄像头、低端传感器网关),集成 NPU 方案的性价比远高于外挂算力卡。
三、场景分化:哪里会成为"准标配"
M.2 算力卡的普及将呈现极强的场景选择性,而非全面覆盖。
大概率成为标准配置的场景
1. 存量嵌入式设备智能化升级:已部署的工业网关、NVR、自助终端、工控机,通过 M.2 算力卡即可低成本升级生成式 AI 能力,无需更换整机,是当前落地最快的场景。
2. 中高端智能终端:服务机器人、工业视觉质检设备、智能座舱后装、智慧商显等设备,算力需求差异大、产品迭代快,采用"主控+可更换 M.2 算力卡"的架构,可快速匹配不同客户的算力预算,降低供应链风险。
3. 多模态生成式 AI 专用设备:需要同时运行视觉大模型+语言大模型的边缘设备,集成 NPU 的显存与带宽无法满足需求,外挂 M.2 算力卡已成主流设计方案。
不会成为标配的场景
1. 超低成本、低算力终端:入门级摄像头、传感器节点、简单工控终端,算力需求在 4TOPS 以内,主控集成 NPU 完全够用,额外增加算力卡属于成本冗余。
2. 极致空间受限设备:微型传感器、穿戴式设备、嵌入式模组等,物理空间无法容纳 M.2 插槽,只能采用芯片级集成方案。
3. 高性能边缘服务器:算力需求超过 100TOPS 的边缘计算节点,会采用标准 PCIe 全高/半高加速卡,M.2 形态的算力上限无法满足需求。
四、未来趋势
1. 接口与生态逐步标准化:随着 ONNX、通用大模型推理框架的普及,算力卡的软件适配成本会持续下降;同时 M.2 接口的 PCIe 版本会向 3.0 x4 升级,缓解带宽瓶颈。
2. "预留插槽"成为主板常态:未来中高端嵌入式主板会像现在预留 M.2 存储插槽一样,默认预留 AI 算力专用 M.2 通道,算力卡从"选配配件"变成"可选项的标准位"。
3. 算力等级分层固化:形成"10TOPS 级入门、20~40TOPS 主流、80TOPS+ 高端"的分级产品矩阵,对应不同参数规模的端侧大模型,客户可按需选型。
总体而言,M.2 形态算力卡不会替代集成 NPU 成为嵌入式设备的唯一算力方案,但会成为端侧生成式 AI 时代嵌入式平台的标准算力扩展形态,与集成 NPU 形成互补,共同覆盖从低端到高端的全场景需求。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部