


不会完全取代,而是场景分化。在边缘端运行 7B 及以上大模型、多模态模型的核心部署场景中,M.2 算力卡将成为主流方案;但 USB 算力棒不会被彻底淘汰,它会长期存在于轻量级 AI、原型开发、存量设备升级等细分场景,两者是互补而非替代关系。
一、为什么边缘大模型场景,M.2 算力卡优势显著
大模型推理的核心瓶颈是显存容量、数据带宽、持续算力,这三点恰好是 USB 形态的硬伤,也是 M.2 形态的核心优势。
1. 接口带宽差距达数十倍,决定大模型吞吐上限
对比维度 | USB 算力棒 | M.2 算力卡 |
接口协议 | USB 3.0 / 3.1 | PCIe Gen3 x4 / Gen4 x4 |
理论带宽 | 最高 10 Gbps | 32 Gbps(Gen3)~ 64 Gbps(Gen4) |
实际有效吞吐 | 约 400–500 MB/s,且常与其他外设共享总线 | 约 2–8 GB/s,是 USB 的 5–20 倍 |
高负载表现 | 延迟波动明显,并发推理易掉速 | 权重加载、中间张量传输几乎无瓶颈,并发衰减极小 |
2. 独立显存容量决定能跑多大的模型
USB 算力棒:受限于体积和供电,显存普遍偏小,主流产品多为 4–8 GB,仅能流畅运行 1B–7B 量化模型;14B 以上模型基本无法完整加载,性能暴跌。
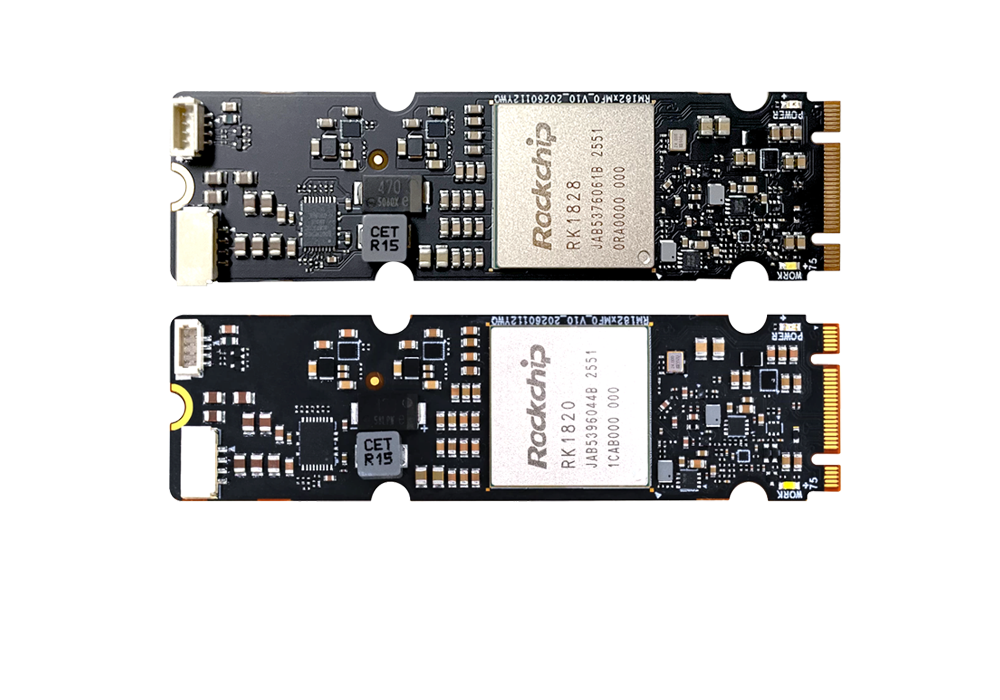
M.2 算力卡:标准 2242 / 2280 尺寸可容纳 8–16 GB 独立显存,高端存算一体方案可达 48 GB,能原生支持 7B–34B 大模型,部分可跑 70B 量化版本。例如后摩智能 M.2 卡可在 15W 功耗下流畅运行 35B 模型,推理速度达 26 tokens/s。
3. 散热与可靠性更匹配工业级量产部署
USB 棒:采用 U 盘式外壳,散热面积小,长时间满负载易热降频,工作温度范围通常仅 0–40°C,难以适应工业现场。
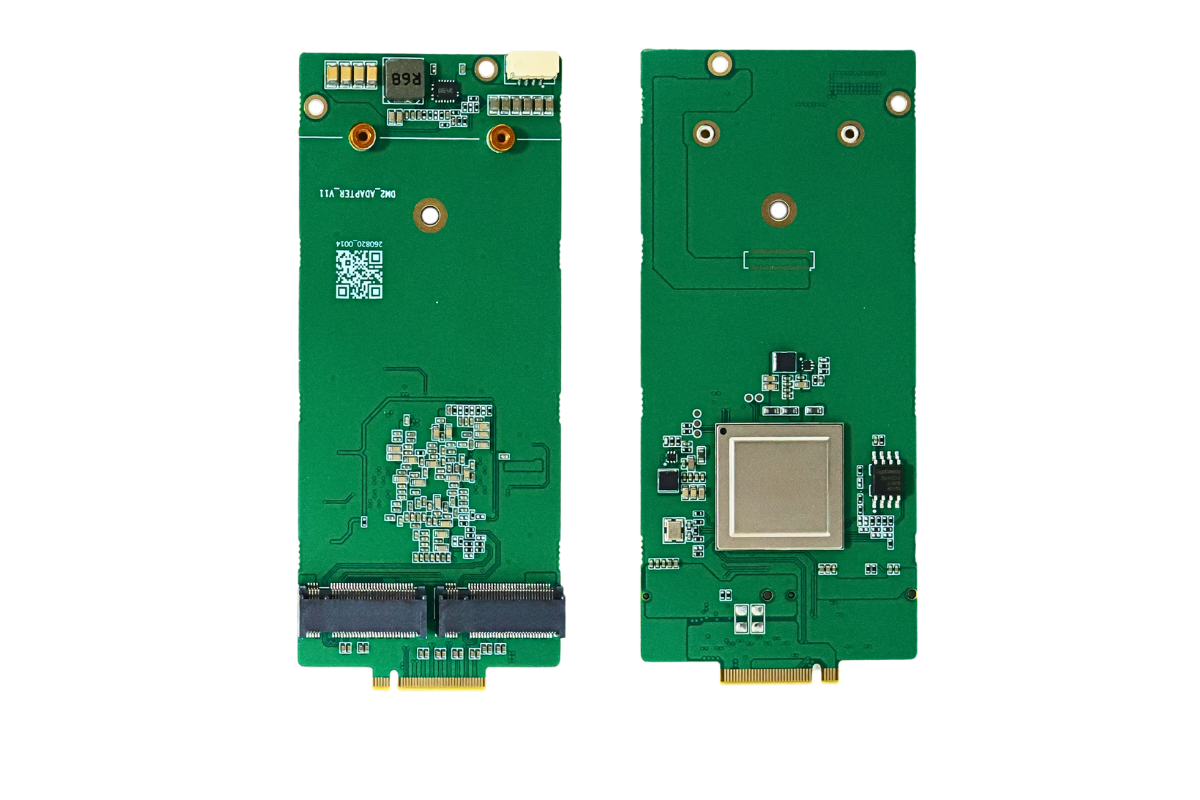
M.2 卡:可内置在设备机箱中,搭配主板风道或独立散热片,工业级型号支持 -40~85°C 宽温,7×24 小时运行稳定性远高于 USB 形态,更符合智慧网关、工控机、AI 相机等量产项目要求。
二、USB 算力棒的不可替代场景
尽管不适合大模型主力部署,但 USB 形态在以下场景仍有明确价值,不会消失:
1. 原型验证与快速开发
开发者在多台设备间切换测试、快速验证算法可行性时,USB 即插即用、无需拆机,迭代效率远高于 M.2。很多厂商的策略是"原型用 USB,量产转 M.2"——同一颗 AI 芯片同时推出两种封装,开发阶段用 USB 棒快速调试,最终产品固化为 M.2 内置方案。
2. 轻量级 AI 与低成本入门
对于 YOLO 目标检测、语音关键词识别、简单图像分类等传统边缘 AI 任务,3–10 TOPS 的 USB 算力棒完全够用,价格仅 400–700 元,入门门槛极低。例如家用安防场景中,Google Coral USB 加速棒搭配 Frigate 仍是最主流的低成本方案。
3. 存量设备升级
大量老旧工控机、迷你主机、树莓派类设备没有空余 M.2 插槽,但都有 USB 接口。USB 算力棒是这类设备增加 AI 能力的唯一低成本途径,无需更换整机。
三、产业趋势:同芯异构,各守边界
从 2026 年的产业动态来看:
1. 大模型下沉推动 M.2 高速增长。边缘 AI 加速卡市场年复合增长率超过 30%,其中 M.2 形态增速显著高于 USB,核心驱动力就是大模型从云端向端边迁移带来的算力升级需求。工业、安防、机器人等领域的量产项目,已普遍将 M.2 AI 卡作为标准配置。
2. USB 形态定位清晰化。不再主打"跑大模型"概念,回归轻量级推理、教育开发、存量改造的定位,市场规模稳定但增速放缓。
3. 芯片厂商双形态并行。算能、爱芯元智、Hailo 等主流厂商均采用"一颗芯片 + 两种模组"的策略,USB 与 M.2 共享软件栈,客户可根据部署阶段灵活选择,而非非此即彼。
四、最终判断
选 M.2 算力卡
如果你要在边缘设备上稳定运行 7B 以上大模型、做工业量产部署,M.2 算力卡是必然选择,它会逐步取代 USB 在该场景的份额。
选 USB 算力棒
如果你只是做算法原型、跑轻量视觉模型、给老设备加 AI 能力,USB 算力棒依然是性价比最高的选择,短期内没有被替代的可能。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部