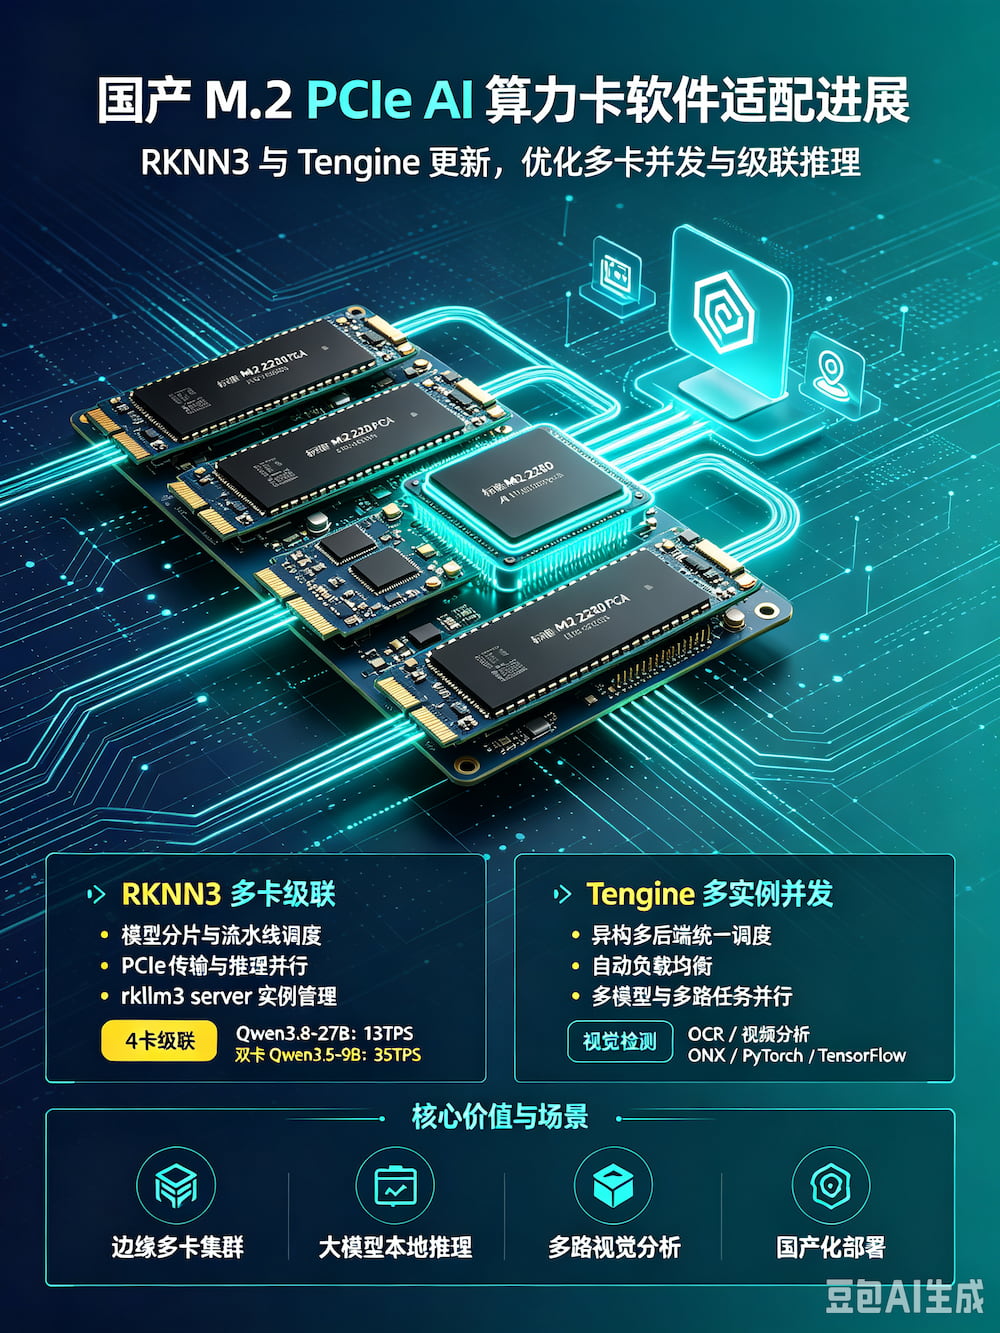
国产 M.2 形态 PCIe AI 算力卡生态持续补齐软件短板,RKNN、Tengine 两大国产推理框架陆续发布新版本,重点针对 M.2 多卡并发、多卡级联推
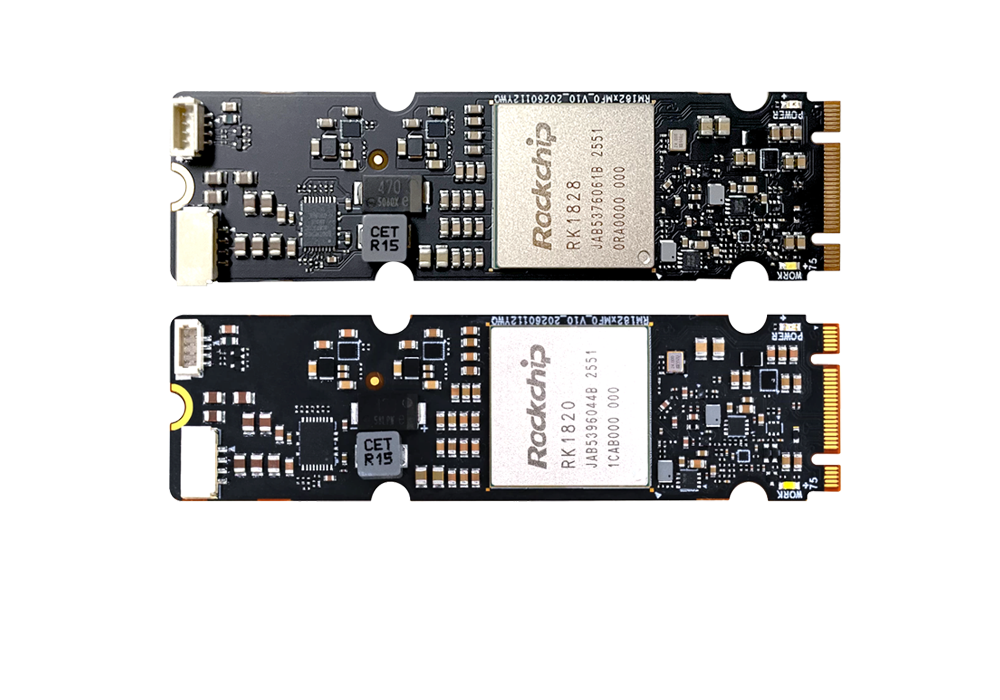
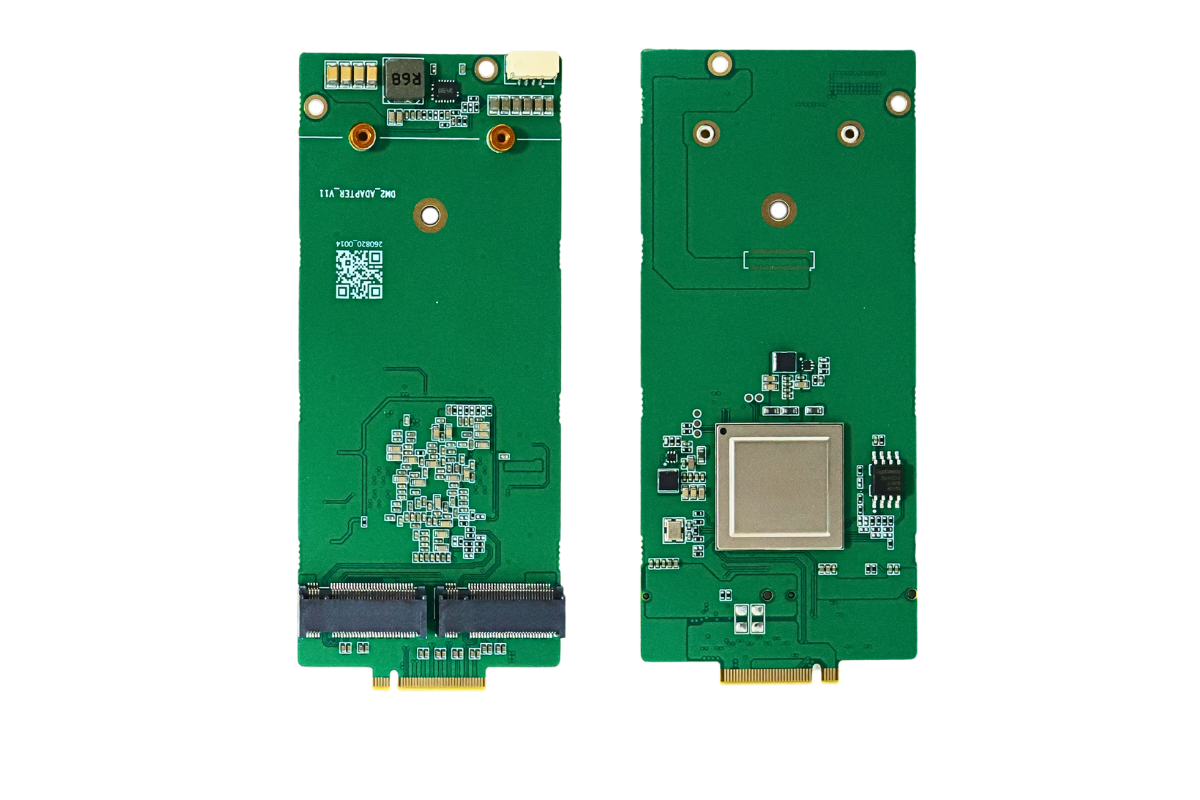
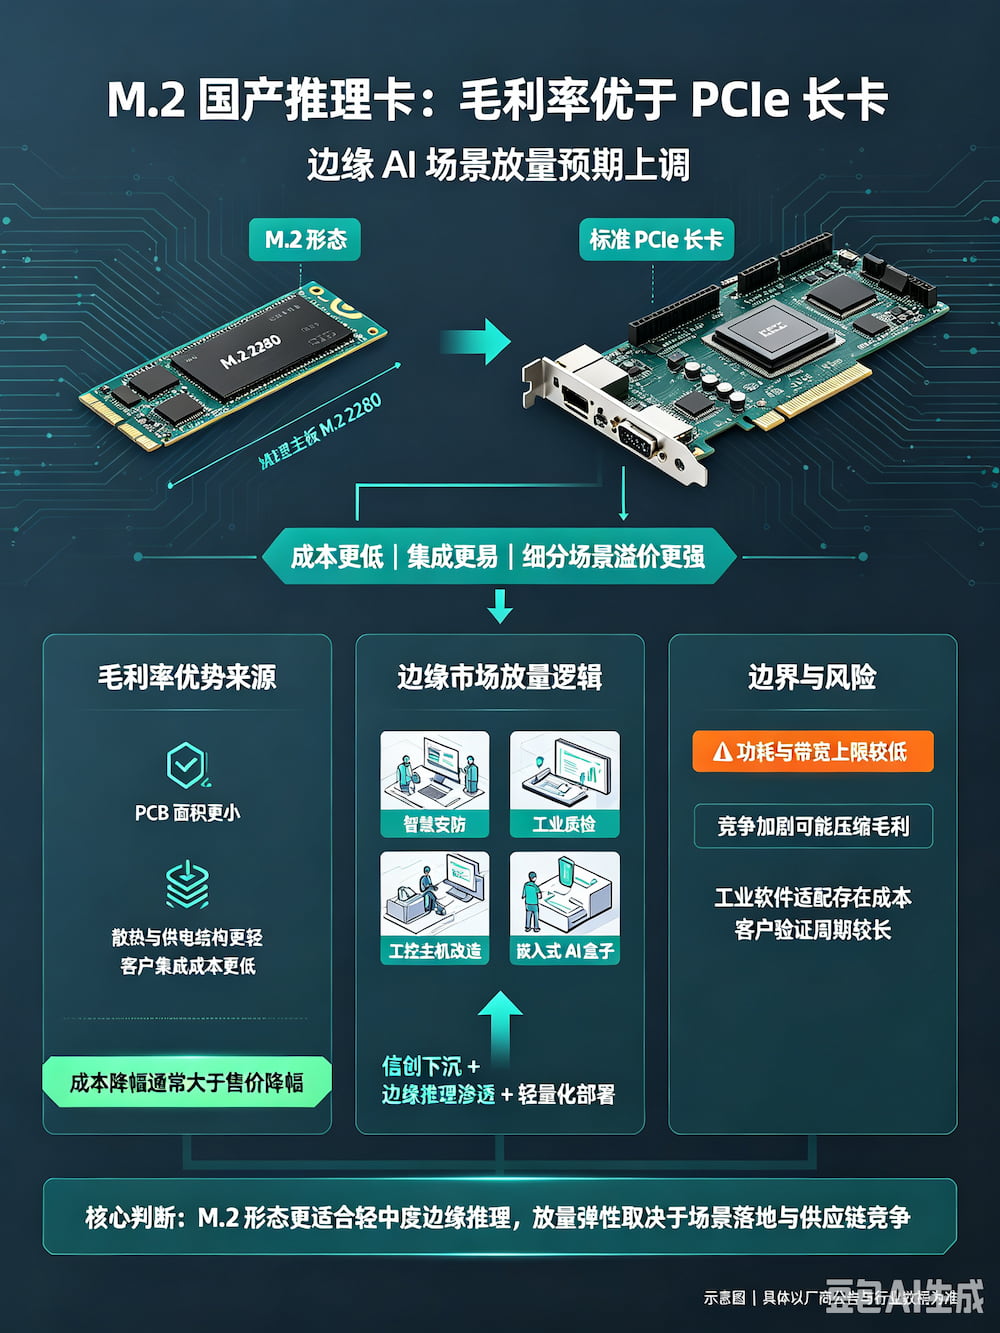
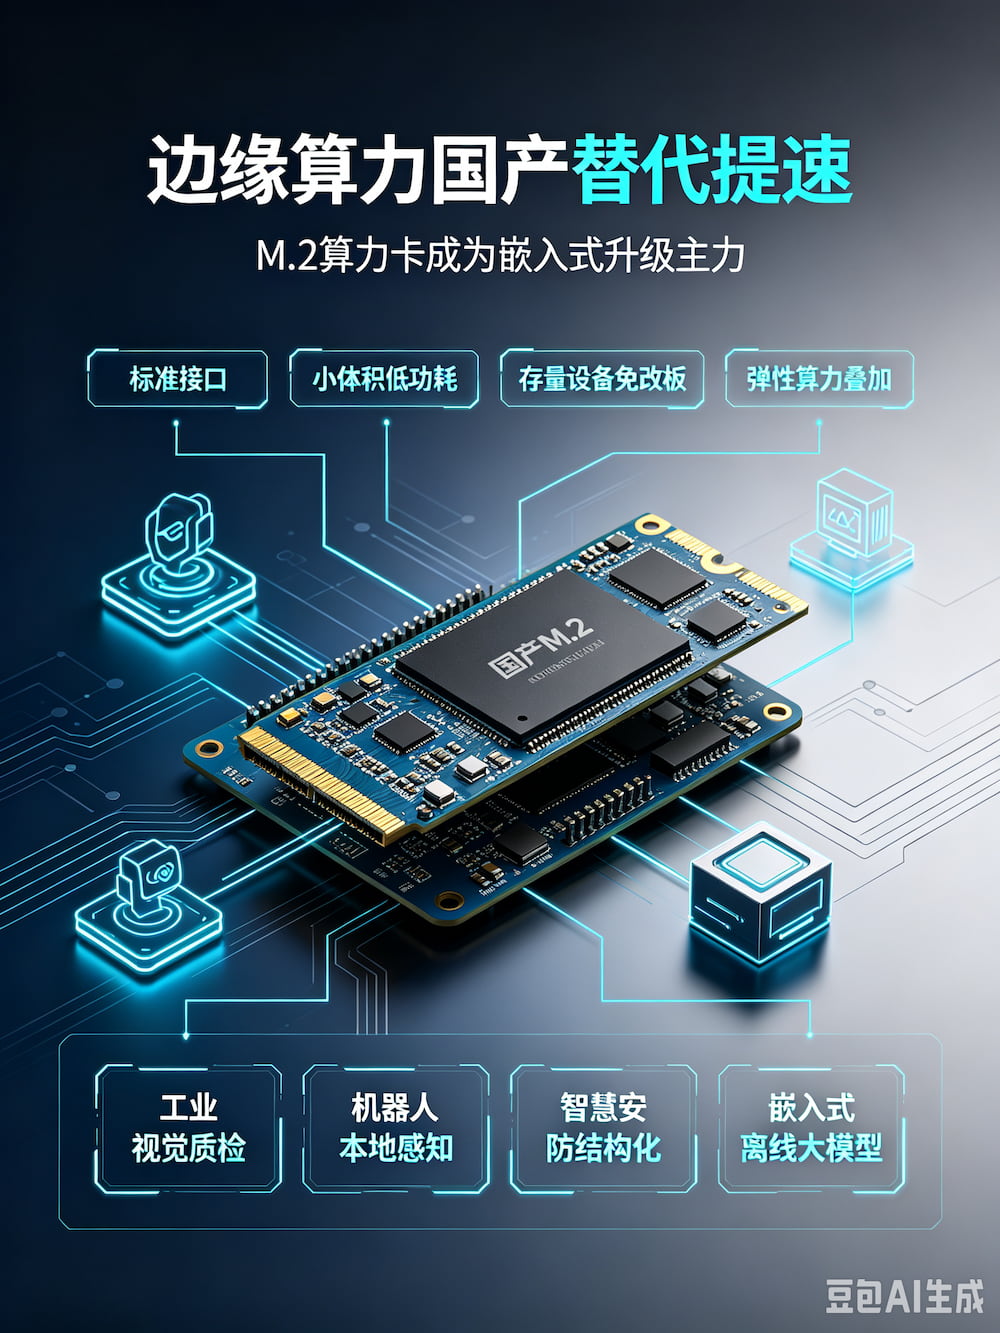
M.2 2280/2260 这类小型化推理卡,硬件 BOM 成本、PCB 面积、散热结构、配套电源 / 机箱改造要求显著低于标准高度 PCIe 长卡;目标场景聚
随着工业视觉、机器人、明厨亮灶、智慧工地、电力光伏巡检等边缘场景 AI 需求爆发,叠加信创与供应链自主可控要求,边缘算力国产替代进入加速期。M.2 规格 AI
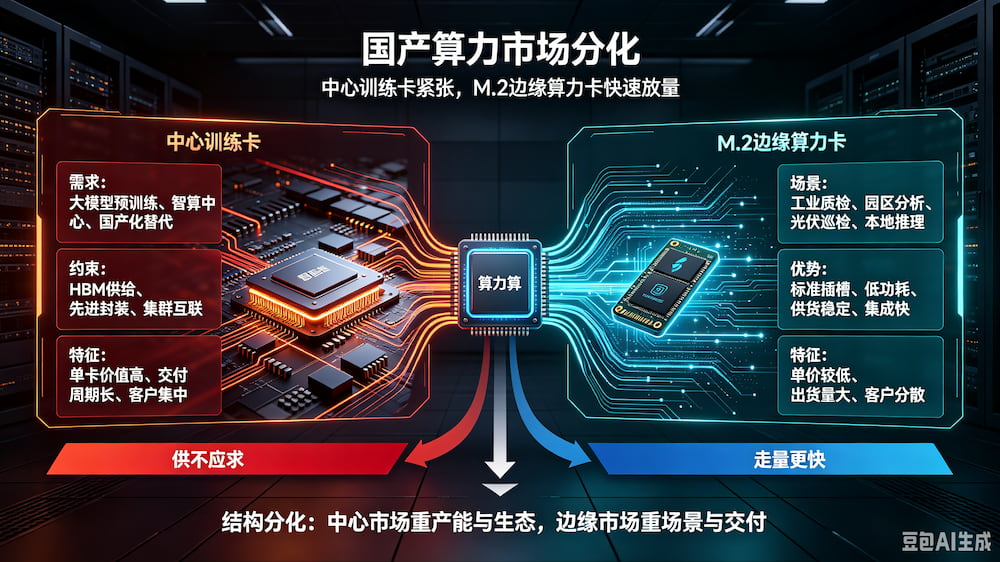
高端中心训练卡是高价值、低出货、产能受限的卖方市场;M.2 形态边缘算力卡是低单价、广场景、快速放量的增量市场,二者形成明显结构性分化。一、中心训练卡:一卡难求
随着 M.2 形态 AI 加速模组成为边缘算力扩展主流方案,市面上模组规格百花齐放,很多研发工程师容易只看峰值 TOPS 参数,忽略显存带宽、功耗、驱动适配、宽
M.2 2280 凭借标准化尺寸、M-Key PCIe 4.04 接口、低功耗、易插拔扩容的优势,正在成为边缘 AI 硬件的主流形态。国产 M.2 算力卡的发展
*









 试用申请
 产品咨询
 在线客服
 回到顶部