
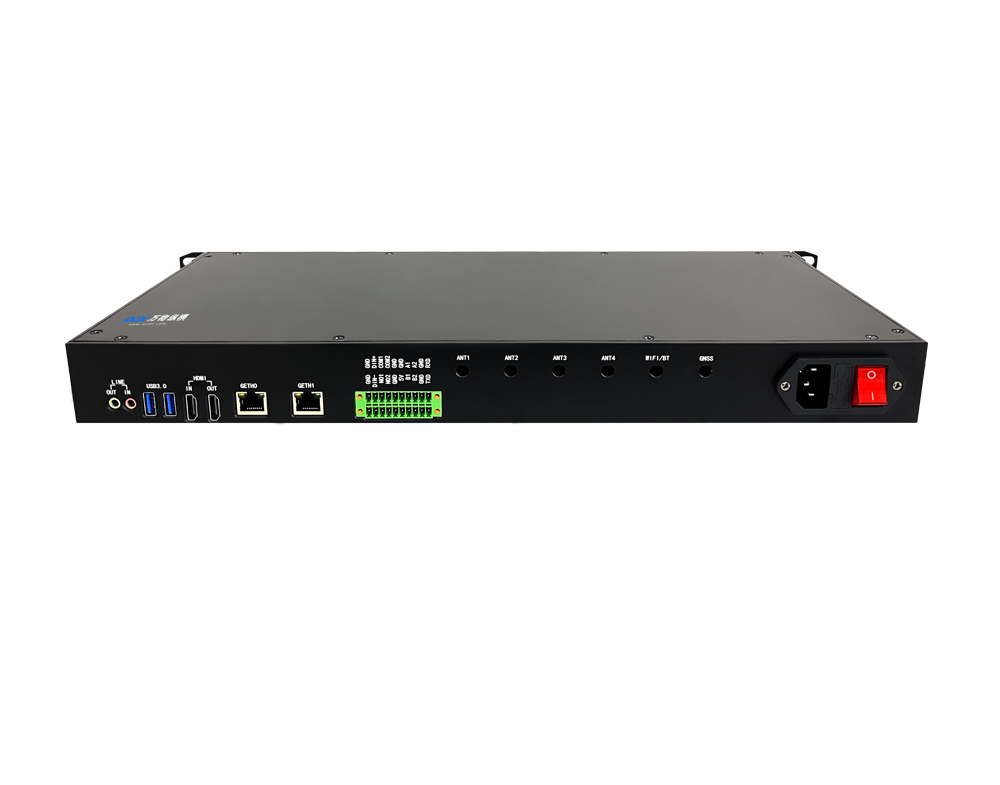
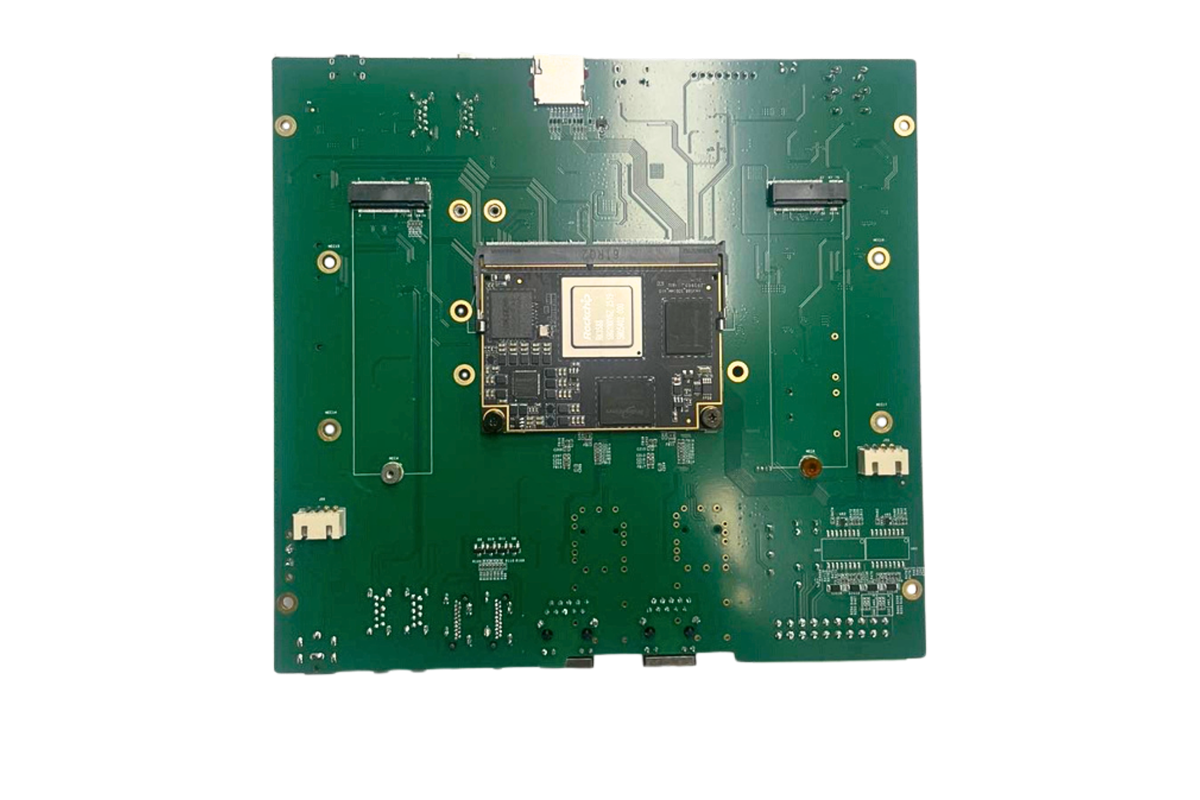
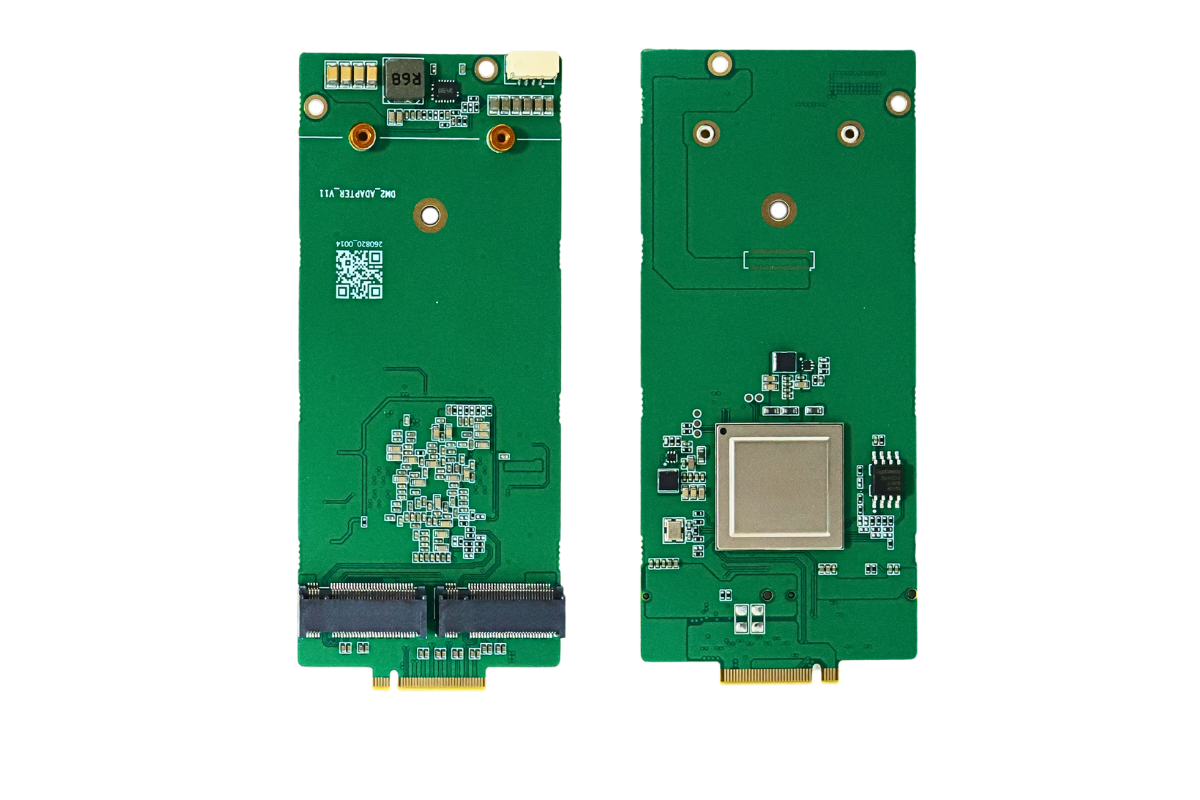


这个趋势本质是边缘场景从纯视觉推理,转向本地 LLM/VLM 多模态生成推理带来的底层范式切换:视觉 CNN 属于高算术强度任务,吃算力;大模型 Transformer 注意力层、token 解码属于低算术强度,瓶颈是访存带宽,不是峰值 TOPS。
一、为什么不再只看算力 TOPS
1. 大模型解码阶段是带宽绑定
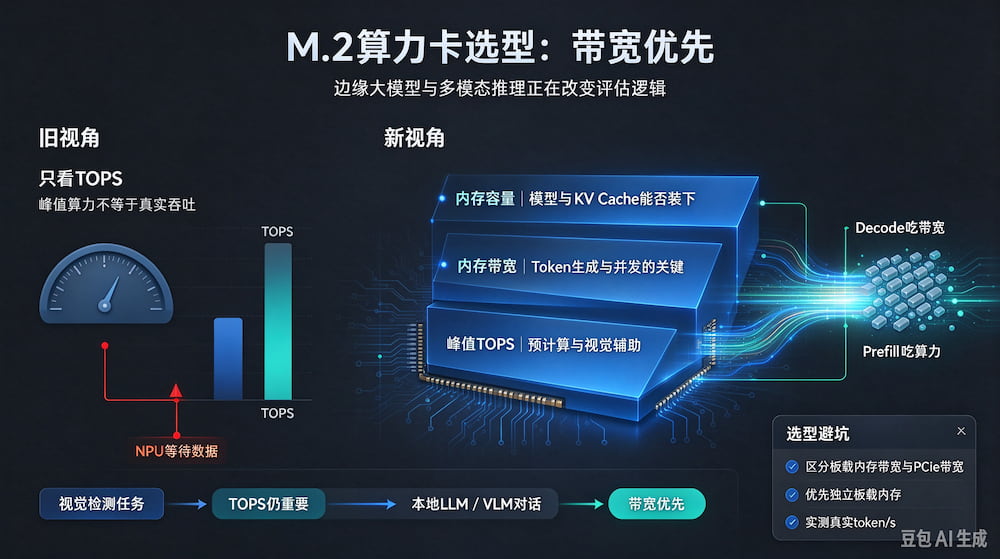
LLM 生成 token 时,需要反复读取权重、读写 KV Cache。NPU 大部分时间不是在计算,而是等待数据从内存搬运过来,哪怕 TOPS 很高,内存带宽不足,NPU 算力大量闲置,实测 token 生成速度远低于纸面参数。
简单一句话:Prefill(预填充)吃算力,Decode(生成)吃带宽;绝大多数本地对话场景,大部分时间都在 Decode。
2. “算力数值竞赛” 是营销指标陷阱
厂商宣传的 TOPS 是理论峰值算力,受算子、量化、片上缓存、内存带宽限制,真实利用率经常只有 10%~30%。
很多 M.2 卡纸面 TOPS 很高,但板载内存带宽小,跑 7B、13B 本地大模型时,并发、长上下文场景直接撞内存墙,吞吐上不去。
二、带宽优先,不等于只看 GB/s,选型三要素优先级
优先级:板载内存容量 → 内存带宽 GB/s → 峰值 TOPS
1. 内存容量:能不能把模型 + KV Cache 装下
容量决定 “能不能跑起来”。容量不够,需要反复在主机内存和算力卡之间搬运权重,PCIe 总线会成为新瓶颈,速度暴跌。
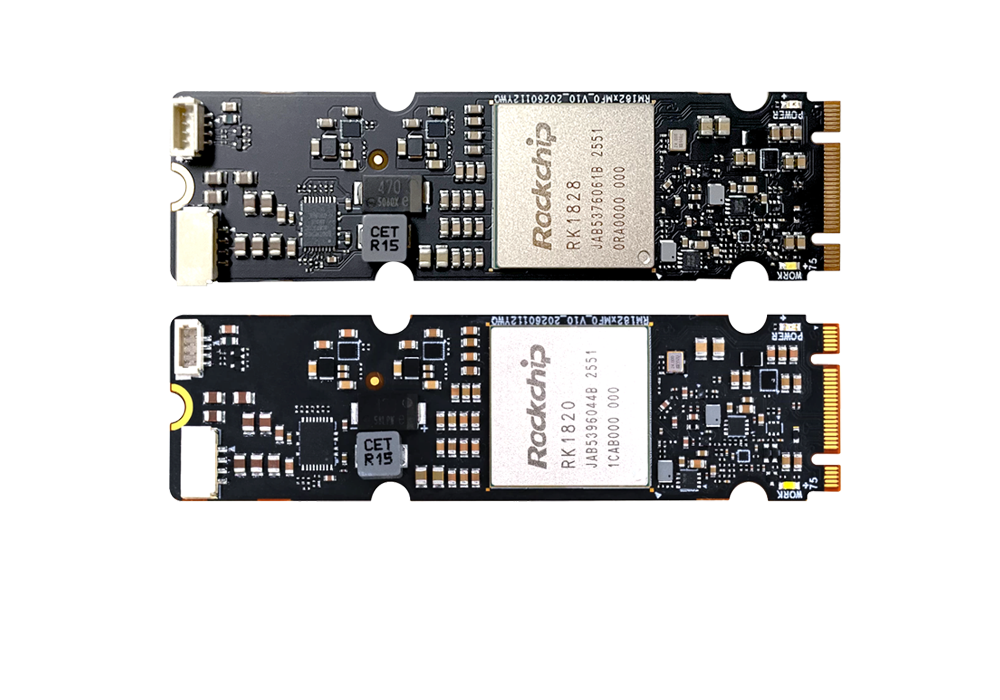
RK1828:5GB 3D 堆叠 DRAM;
BM1684X:最高 16GB LPDDR4x,带宽 68.3GB/s;
力擎 LQ50:最高 48GB LPDDR5X,带宽 153.6GB/s。
2. 内存带宽 GB/s:决定 token 输出速度、并发能力
带宽直接决定多会话、长上下文场景下的生成速率。同模型下,token 吞吐基本和带宽近似线性相关。
重点区分:芯片板载内存带宽 vs PCIe 带宽。PCIe 只是卡和主机之间通道;跑独立本地大模型,核心看算力卡自身板载 DRAM 带宽。RK1828 采用 3D 堆叠封装,片上内存带宽远高于普通 LPDDR 方案,也是它跑 7B 模型的核心优势。
3. TOPS 算力:降为次要参考指标
满足内存容量、带宽基础门槛之后,TOPS 才用来评估 Prefill、多模态图像编码等计算密集环节。
三、M.2 算力卡选型的场景差异
传统安防、明厨亮灶、智慧工地:多路视频检测(YOLO 等视觉任务),算术强度高,TOPS 依然重要,带宽次之;
本地 Agent、嵌入式大模型、多模态 VLM、人机对话:带宽优先,优先选高带宽、独立板载内存的 M.2 算力卡;
多卡级联场景:除单卡带宽,还要考虑多卡之间权重 / KV Cache 互联开销。
四、选型避坑要点
1. 不要把PCIe 带宽当成芯片内存带宽;
2. 确认是板载独立内存,还是共享主机内存;共享内存方案带宽低,跑大模型极易卡顿;
3. 不要只看单精度 TOPS,优先看 INT4/INT8 量化算力(边缘大模型主流量化);
4. 实测验证:相同模型、相同量化、相同上下文长度下,测真实 token/s,纸面参数只能做初步筛选。
小结
M.2 算力卡市场已经分化:视觉场景仍看算力,生成式 AI 边缘场景,带宽为王。
选型逻辑从 “挑 TOPS 最高的卡”,变成:先保证内存容量装下模型与 KV 缓存,再对比板载内存带宽,最后看算力作为补充。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部