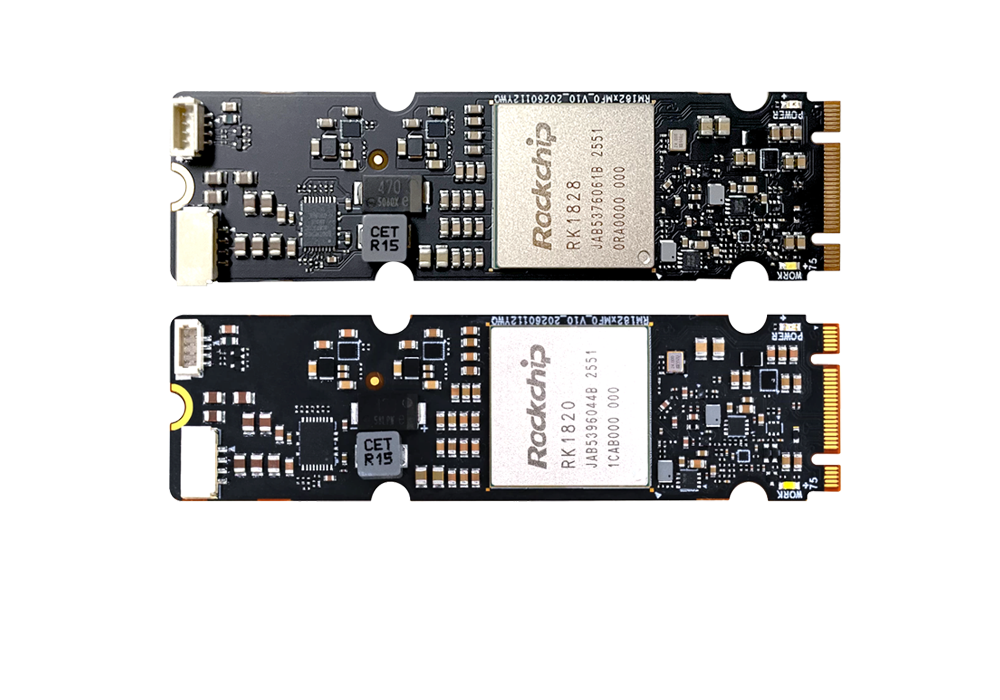
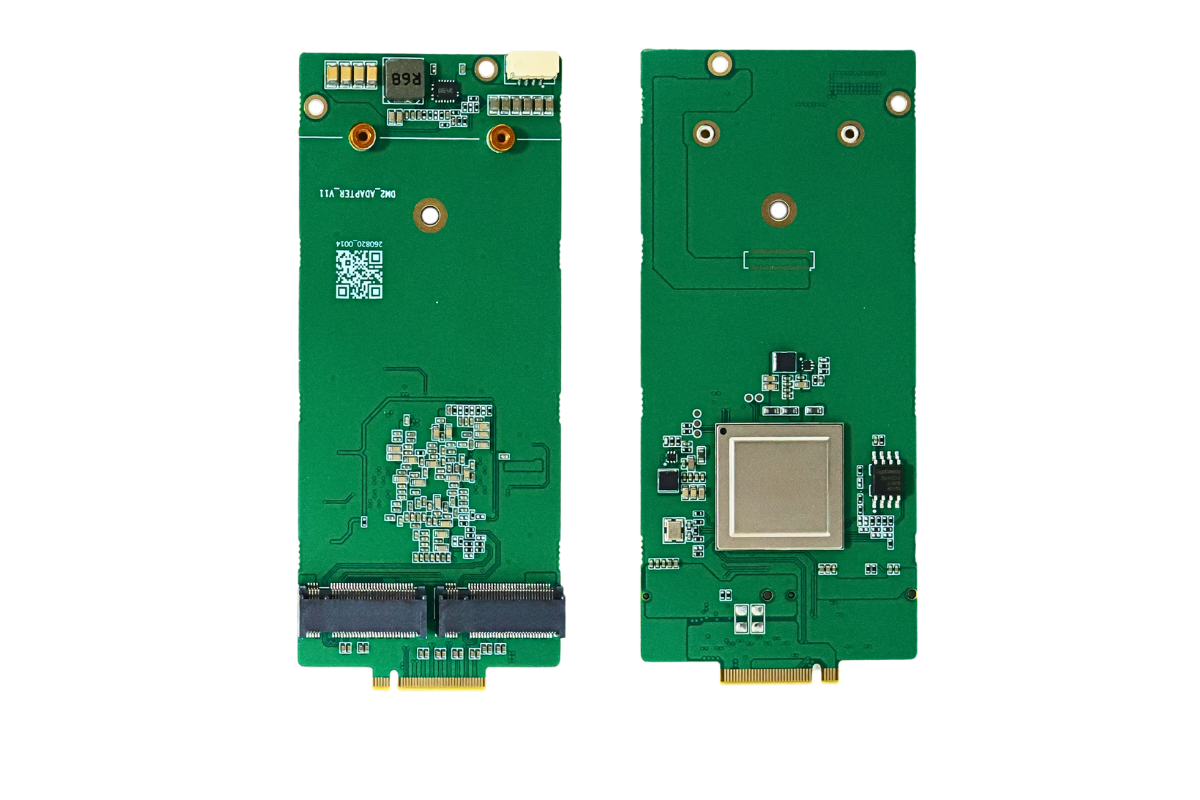
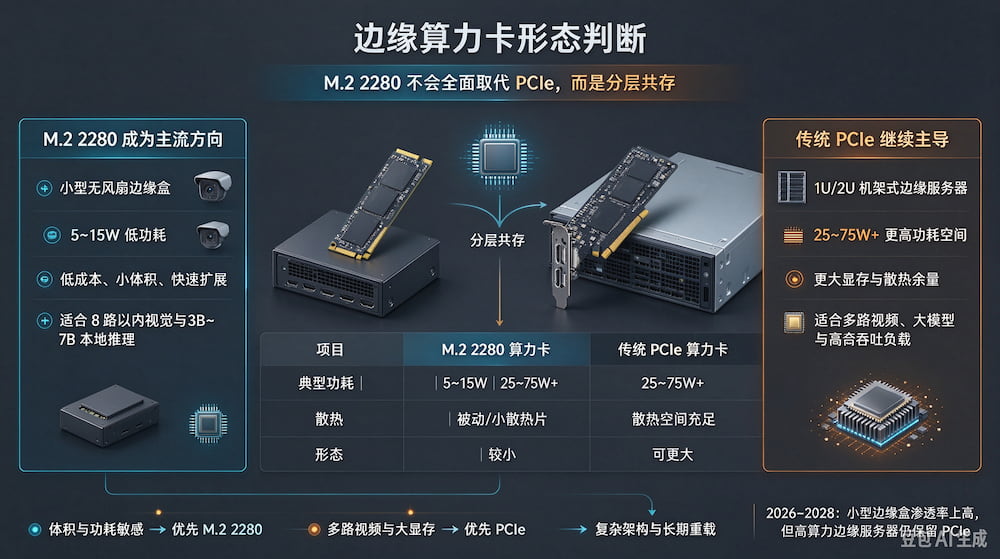
M.2 2280 算力卡不会完全取代传统 PCIe 算力卡,但会成为中小算力、紧凑型边缘盒子的主流扩展形态;高算力、多卡高密度边缘盒子依然会保留 PCIe 全高
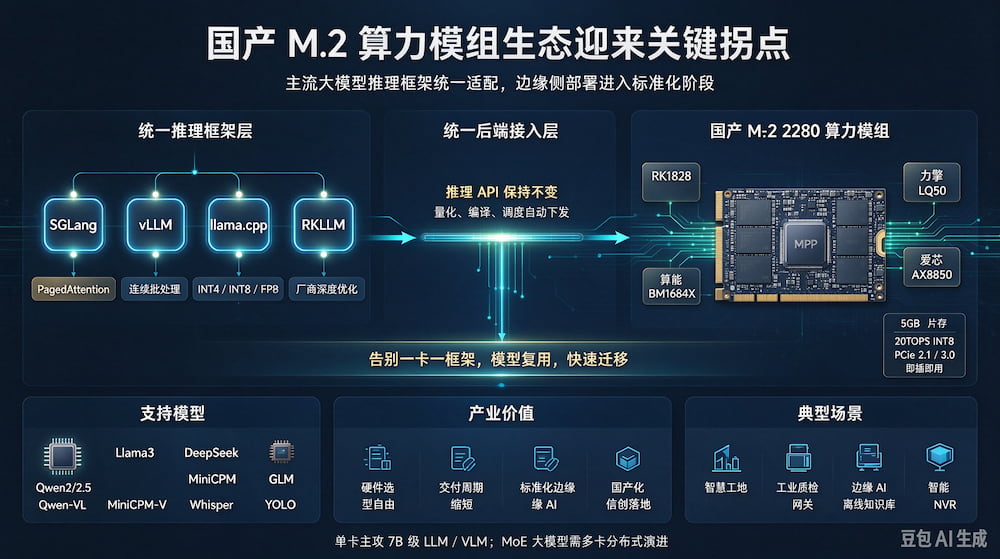
国产 M.2 形态 AI 算力模组生态迎来关键拐点,SGLang、vLLM、llama.cpp、RKLLM等主流大模型推理框架,已完成对 RK1828、力擎 L
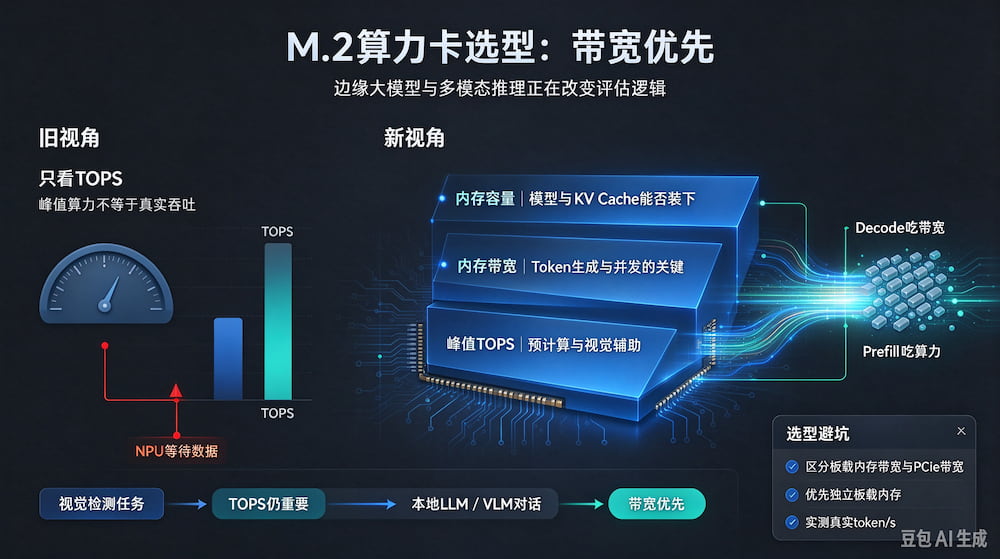
这个趋势本质是边缘场景从纯视觉推理,转向本地 LLM/VLM 多模态生成推理带来的底层范式切换:视觉 CNN 属于高算术强度任务,吃算力;大模型 Transfo
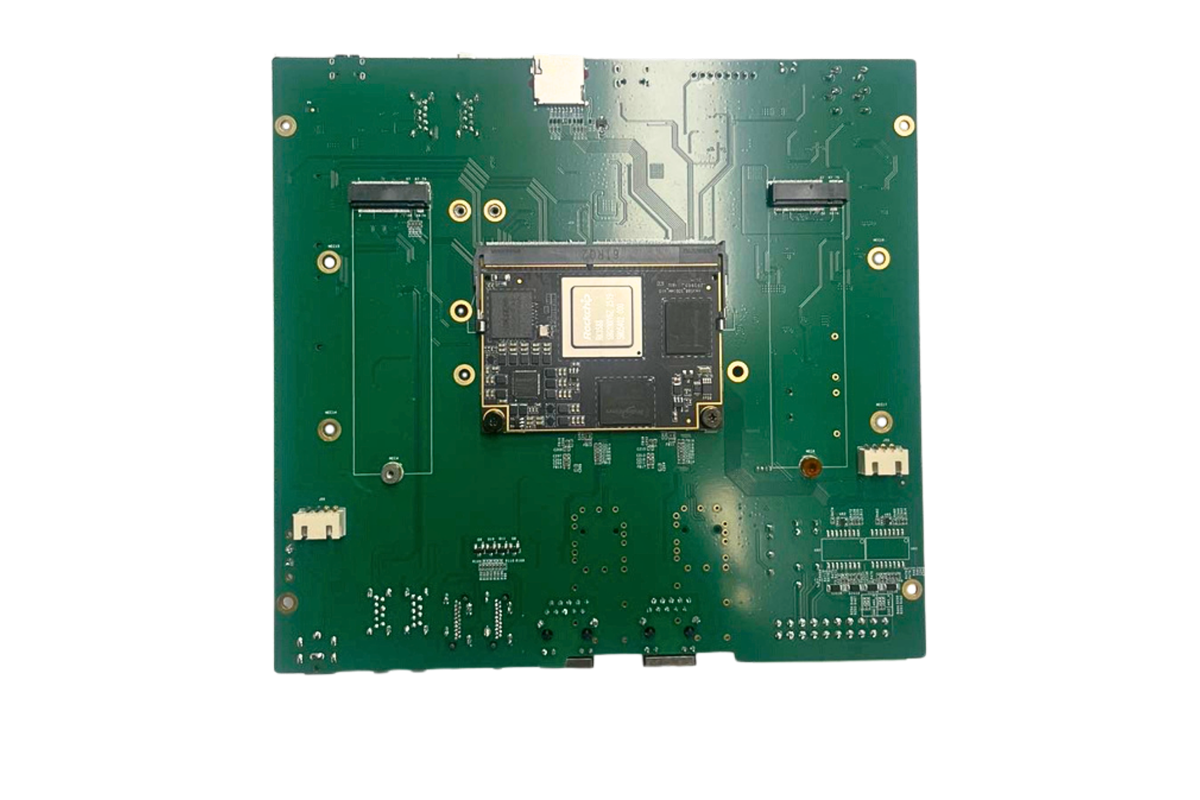
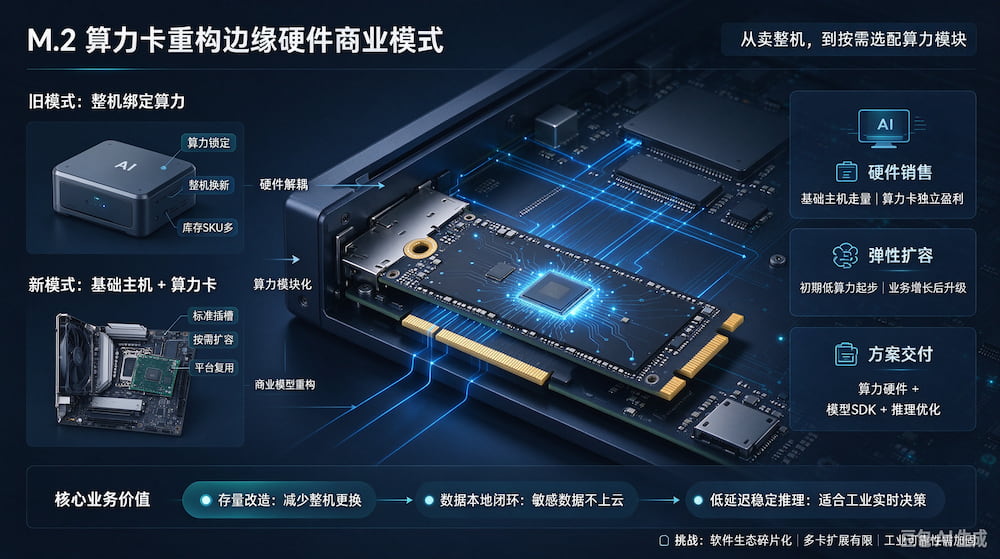
传统边缘硬件的商业模式,长期是整机打包销售、硬件一次性交付、算力固定不可改:工控机、AI 盒子出厂算力锁定,客户算力不足只能整机换新;方案商需要深度定制主板,项
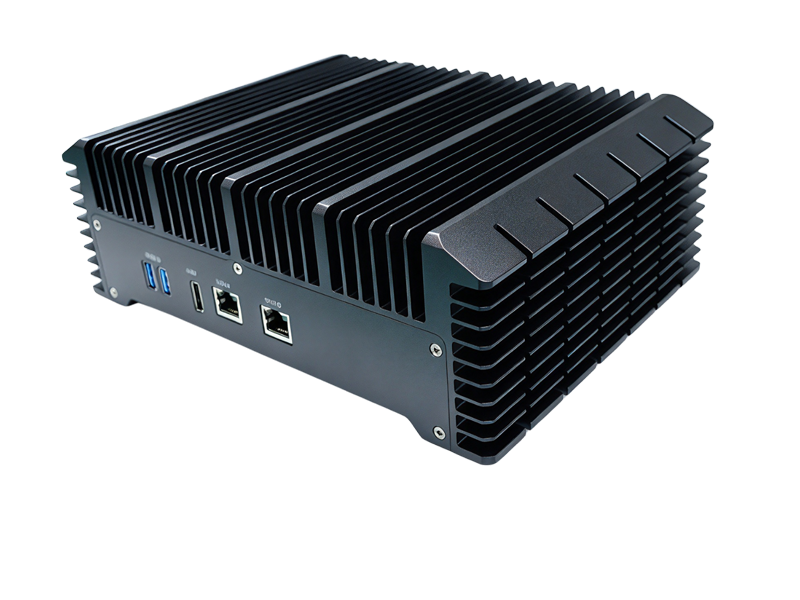
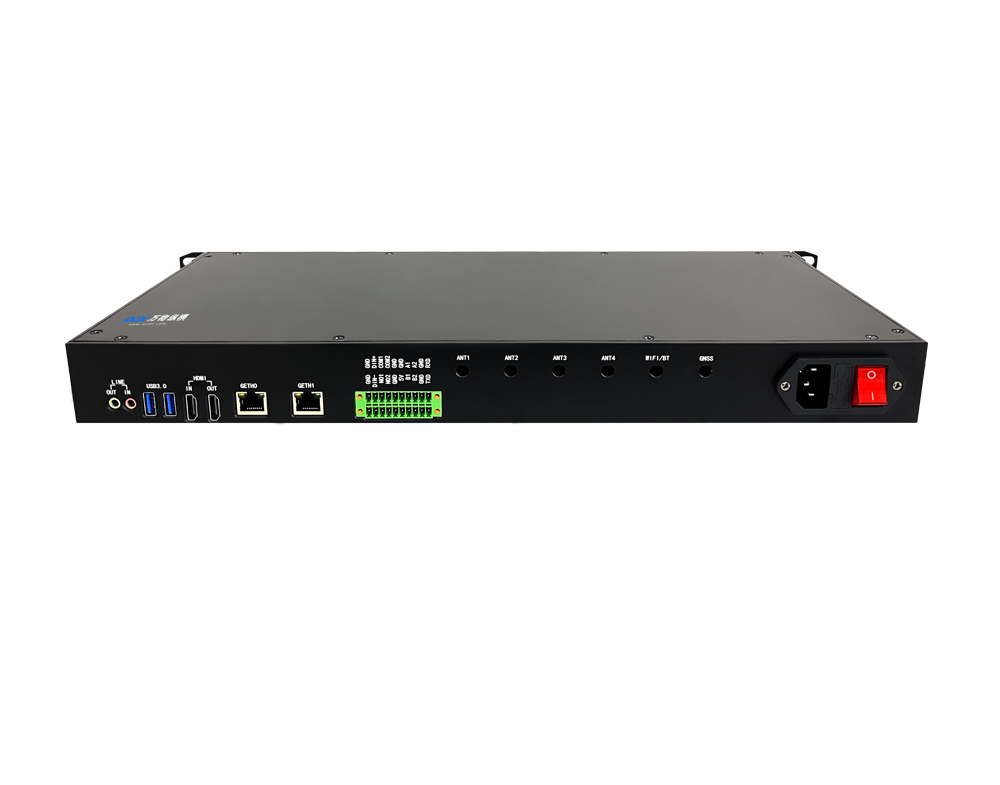
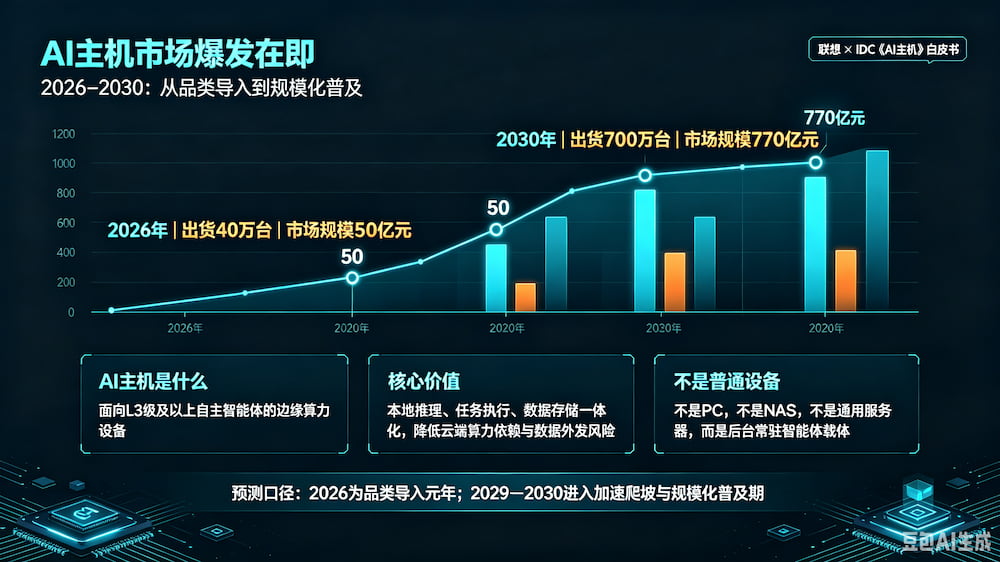
AI 主机定义:专为 L3 级及以上自主智能体设计的边缘算力设备,支持 724 小时常驻运行,集本地推理、任务执行、数据存储一体化,作为端 - 边 - 云架构里
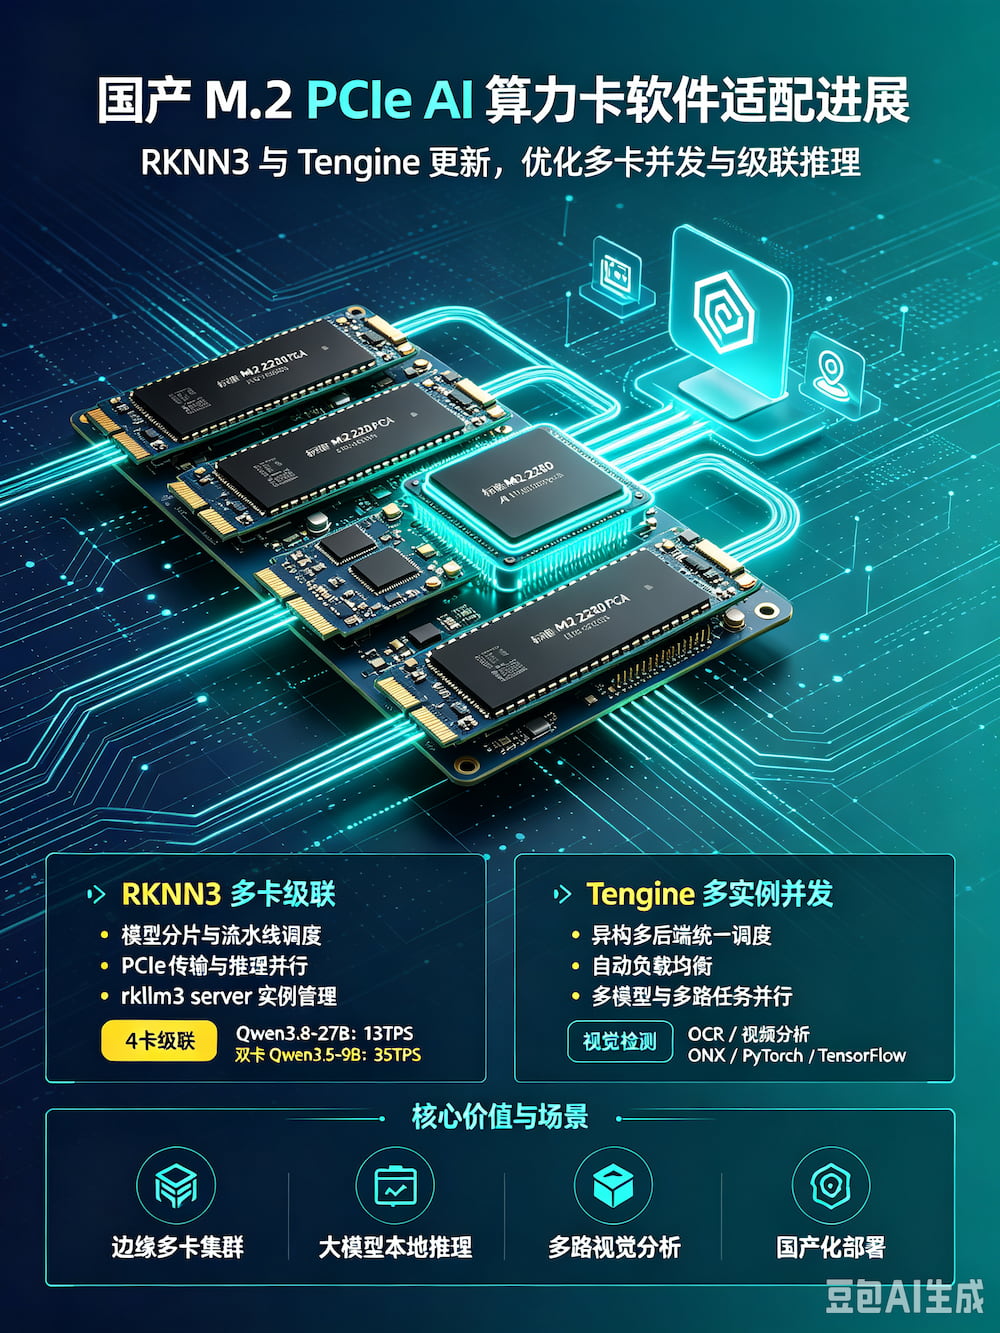
国产 M.2 形态 PCIe AI 算力卡生态持续补齐软件短板,RKNN、Tengine 两大国产推理框架陆续发布新版本,重点针对 M.2 多卡并发、多卡级联推
*







 试用申请
 产品咨询
 在线客服
 回到顶部