
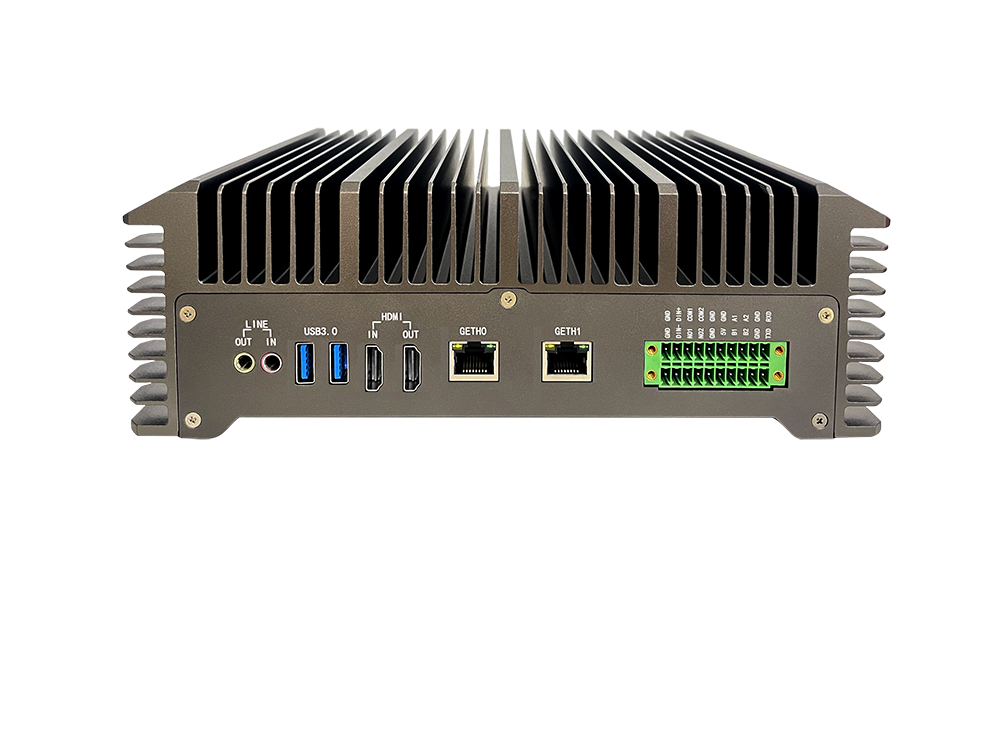
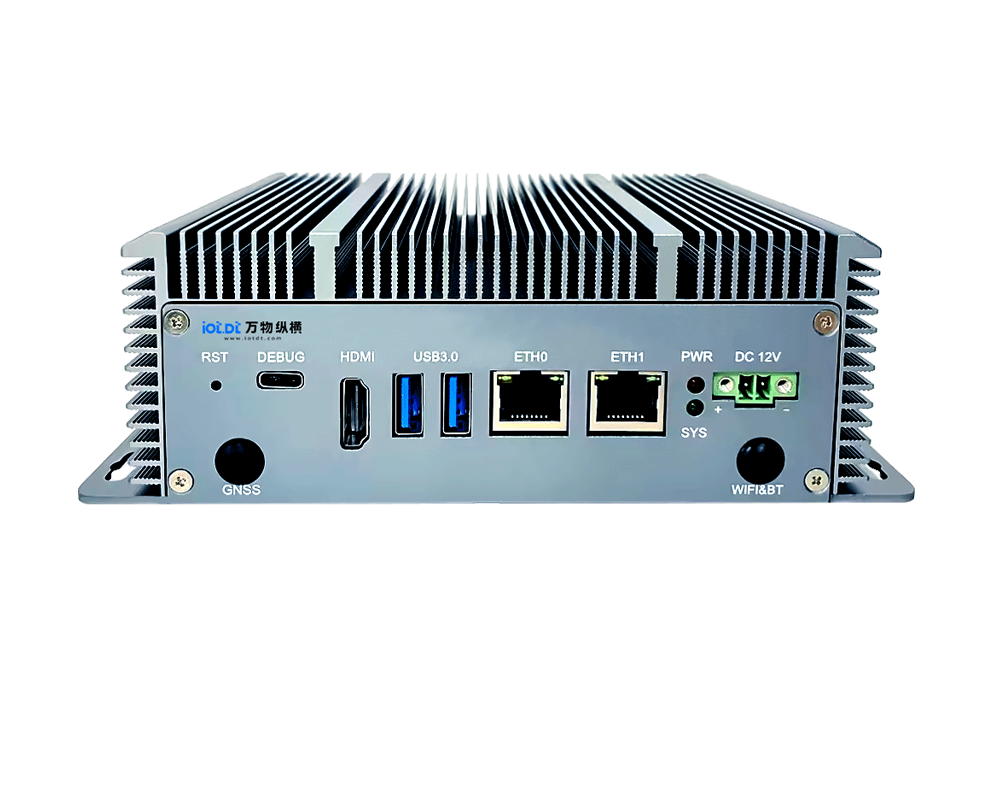
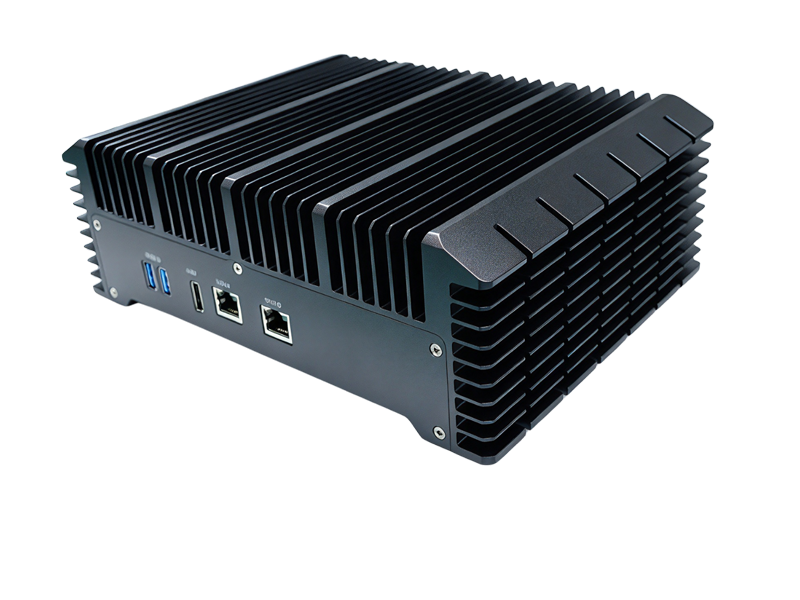
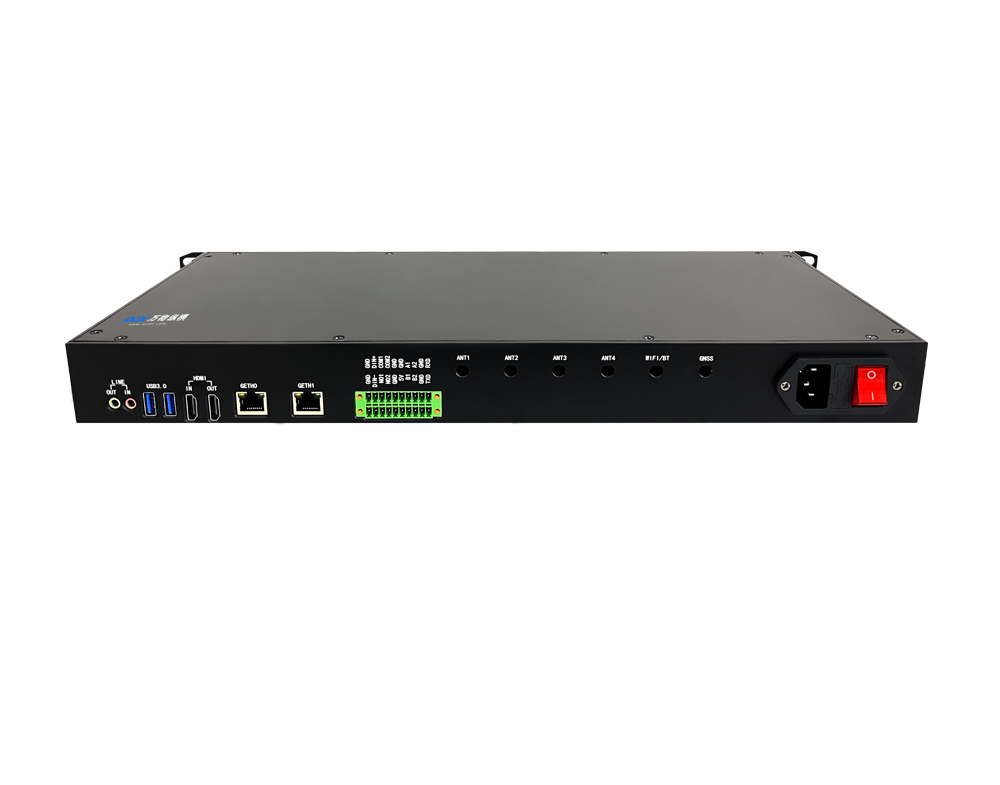
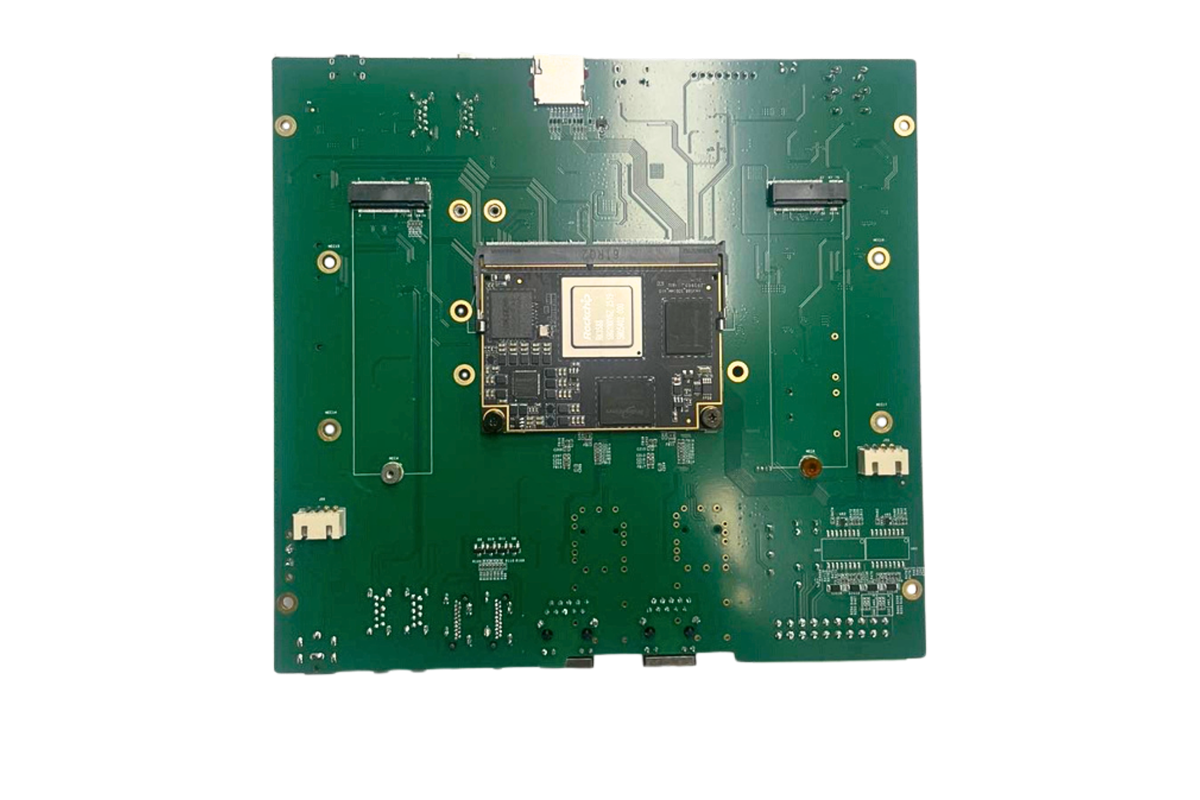
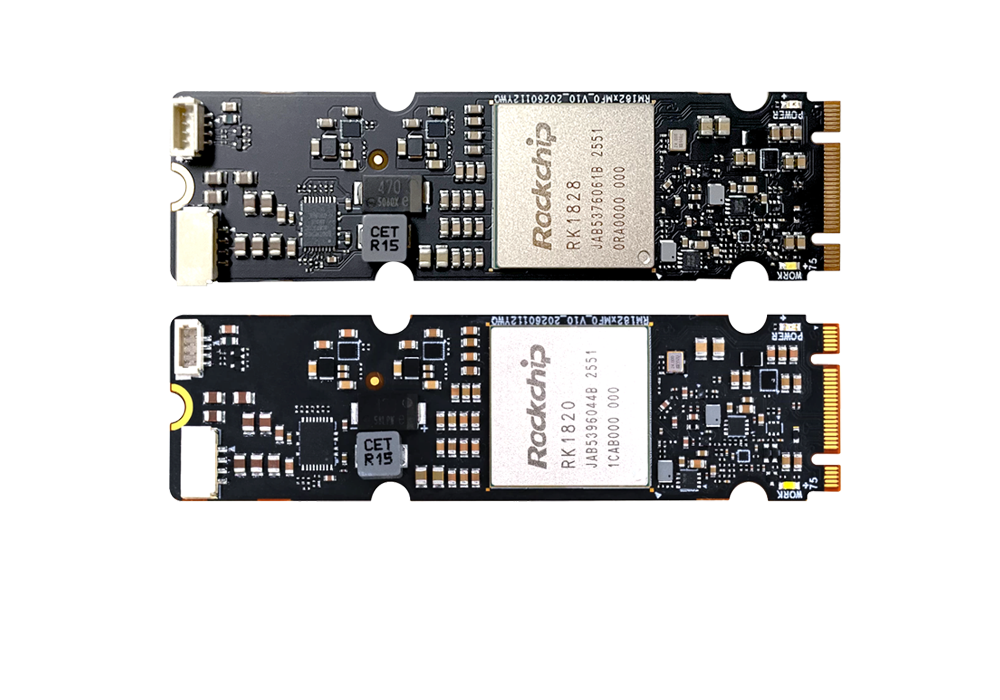


核心前提:LQ50 Duo 板载两颗独立 M50 芯片,硬件上双芯是独立算力单元、独立显存。目标是把每一颗 M50 作为独立可调度资源,实现芯级硬隔离——Pod 独占单芯,A 芯负载不会抢占 B 芯算力/显存,不是同芯内分时切片。
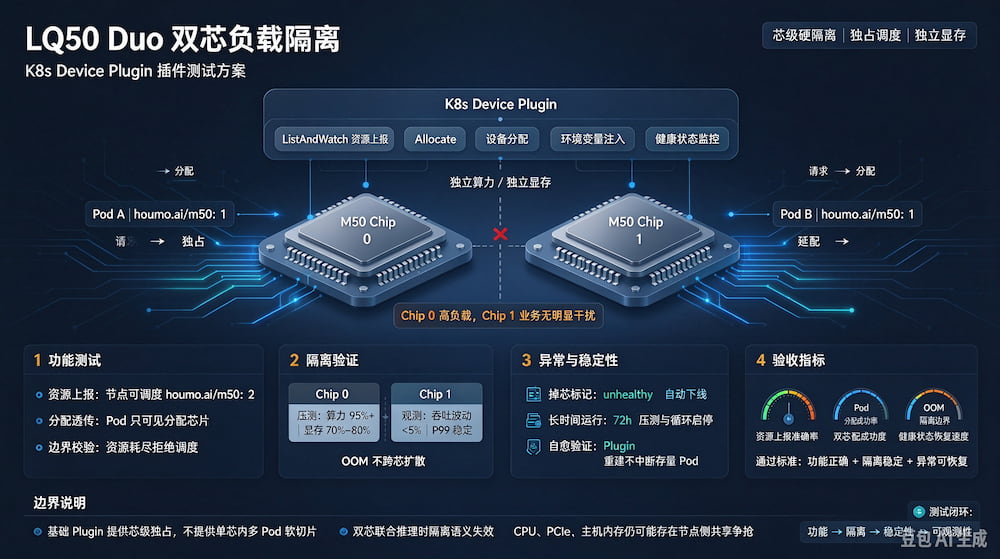
资源名约定:houmo.ai/m50,1 个资源 = 1 颗 M50 芯;LQ50 Duo 单节点上报容量:houmo.ai/m50: 2
一、测试环境
项目 | 说明 |
硬件 | LQ50 Duo(2×M50,48GB 总 LPDDR5),M.2 2280 Dual 模组 |
OS | Ubuntu 22.04 / Kylin V10 |
内核 | 适配后摩大道驱动内核模块 |
K8s | 1.24+(推荐 1.26~1.30,Device Plugin 稳定版) |
驱动栈 | 后摩大道 SDK + 内核驱动 + lq50-smi 设备管理工具 |
Device Plugin | 自研 houmo-device-plugin,DaemonSet 部署,基于 K8s Device Plugin Framework |
监控 | Prometheus + 自定义 exporter(读取 lq50-smi 算力、显存、温度、利用率) |
负载 | Qwen、Llama 推理,固定 batch、固定 prompt,测吞吐、延迟、OOM、抢占干扰 |
环境前置检查(节点侧):
# 确认两颗 M50 识别正常
lq50-smi list
# 预期输出:chip0、chip1 两个独立设备,各自独立显存、id
# 驱动、固件加载正常
dmesg | grep houmo
# 权限:/dev/houmo/* 设备节点存在
ls /dev/houmo/
二、Device Plugin 基础能力测试(功能测试)
用例 1:插件注册 & ListAndWatch 资源上报
步骤:
1. 部署 DaemonSet houmo-device-plugin
2. 查看 plugin 日志:成功连接 kubelet,上报 2 个 device ID(chip-0、chip-1)
3. kubectl describe node <node-name>,确认 Allocatable 出现 houmo.ai/m50: 2
预期:资源上报正确;单芯故障时自动标记 unhealthy,从可调度列表剔除
判定标准:节点 allocatable 正确,异常芯片自动下线,不参与调度
用例 2:Allocate 分配、设备透传、环境变量注入
Pod 示例 yaml:
resources:
limits:
houmo.ai/m50: 1
requests:
houmo.ai/m50: 1
步骤:启动 2 个 Pod,各申请 1 个 m50 资源
预期:两个 Pod 被调度到该节点;容器内只能看到分配到的那颗 M50(chip0 / chip1),看不到另一颗;环境变量注入 HOUMO_VISIBLE_DEVICES=chip0;设备节点正确 mount 进入容器
重点:不能出现 Pod 同时看到两颗芯(隔离失败)
用例 3:资源耗尽调度拒绝
步骤:节点只有 2 颗 M50,连续提交 3 个 Pod,每个申请 houmo.ai/m50:1
预期:第 3 个 Pod 处于 Pending,事件提示 Insufficient houmo.ai/m50,不会超分
用例 4:Pod 删除,资源自动回收
步骤:删除其中一个推理 Pod,观察 plugin、节点 allocatable、lq50-smi
预期:芯片句柄释放;plugin ListAndWatch 恢复设备健康状态;新 Pod 可再次调度到该芯
用例 5:插件异常自愈
步骤:kill device-plugin pod;等待 DaemonSet 重建
预期:重建后重新注册 kubelet、重新上报两颗芯片;正在运行的存量 Pod 不中断推理(plugin 只负责调度,不接管运行时)
三、【重点】双芯负载隔离验证测试
目标:证明 chip0 高负载时,chip1 上的 Pod 吞吐/延迟稳定,无明显抖动、无显存抢占。
区分:硬件芯隔离 ≠ 同芯内软隔离;本方案是芯粒度独占隔离。
用例 6:双芯并发负载干扰测试
1. Pod-A:绑定 chip0,跑高负载大模型推理(持续压测,显存打满 70%~80%,算力 95%+),采集指标:token/s、P50/P99 延迟、显存占用
2. Pod-B:绑定 chip1,跑相同模型、相同 batch,记录基线指标(单独空载时的吞吐延迟)
3. 两个 Pod 同时持续压测 1h+,持续采集指标
判定标准:
Pod-B 吞吐、P99 延迟和单独空载基线差值 < 5%
Pod-A OOM、异常崩溃不会导致 Pod-B 推理进程 crash
lq50-smi 看两颗芯片利用率独立变化,互不影响
反例(隔离失效):chip0 跑满后 chip1 延迟翻倍、吞吐暴跌。
用例 7:显存隔离边界测试
1. Pod-A(chip0)持续增加输入长度,直到逼近该芯显存上限,触发 OOM
2. 观测 Pod-B(chip1)
预期:Pod-A OOM 退出;Pod-B 推理链路正常,显存、吞吐无突变。
用例 8:拓扑亲和测试(可选,适合多 LQ50 Duo 节点集群)
给设备注入 device 拓扑信息,配合 kubelet 拓扑感知;验证 Pod 不会跨芯错误绑定;适合后续多卡集群调度
四、异常与稳定性测试
用例 9:芯片热异常/掉芯模拟
1. 模拟 chip1 固件报错、过热降频(或通过工具标记 unhealthy)
2. 观察 plugin ListAndWatch 回调
预期:chip1 标记不健康,节点可调度资源变为 1;新 Pod 不再分配到 chip1;已在 chip1 上运行的 Pod 由业务侧自行处理,plugin 不主动杀 Pod。
用例 10:长时间稳定性(72h 稳定性)
双芯持续跑推理负载,循环启停 Pod(反复分配释放),采集:
Device Plugin 内存泄漏、goroutine 泄漏
内核驱动句柄泄漏、dmesg 报错
芯片温度、功耗长期曲线
预期:无泄漏、无内核 panic、资源回收正常。
用例 11:镜像、驱动版本兼容性
不同后摩 SDK 版本、不同容器基础镜像(ubuntu/麒麟),验证容器内 SDK 识别分配到的单芯,无权限失败。
五、监控指标与验收观测点
plugin 需要暴露 metrics(/metrics):
houmo_device_healthy{chip_id="chip0"} 1/0 设备健康状态
houmo_device_allocated{chip_id="chip0"} 1/0 是否被 Pod 占用
houmo_device_memory_total_bytes、houmo_device_memory_used_bytes
houmo_device_utilization 算力利用率
业务侧指标:单 Pod 推理吞吐、P50/P99 latency、OOM 计数。
六、风险与边界说明(测试报告里一定要写)
1. 本方案是芯级独占隔离:1 Pod 独占整颗 M50;不支持单颗 M50 内部再切分多 Pod 共享(M50 内部 IPU 核、显存软切片需要大道 SDK 虚拟化层,不在基础 device-plugin 能力范围内)
2. C-to-C 互联是双芯协同通道:当模型开启双芯联合推理(模型并行)时,隔离语义失效,两颗芯属于同一个任务
3. 隔离边界:芯片内部硬件资源隔离,但节点侧 CPU、PCIe 带宽、主机内存属于共享资源,高并发下仍会有主机侧争抢,不属于 NPU 芯隔离问题
七、测试交付物清单
1. 测试报告:测试用例、pass/fail、基线对比数据、延迟吞吐图表
2. 压测脚本(推理压测、循环创建删除 Pod)
3. 设备 Plugin 日志、kubelet 事件、lq50-smi 采样日志
4. 监控大盘截图(Prometheus/Grafana)
5. 问题清单:隔离抖动、上报延迟、资源回收失败等 bug 记录
八、可选扩展:单芯内共享隔离
如果后续需求从【芯独占】升级为【单 M50 内多 Pod 算力显存切片】,就需要叠加类似 HAMi 的虚拟化层,在 Allocate 阶段注入配额、preload 拦截库,和当前纯 device-plugin 芯隔离方案架构不一样。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部