
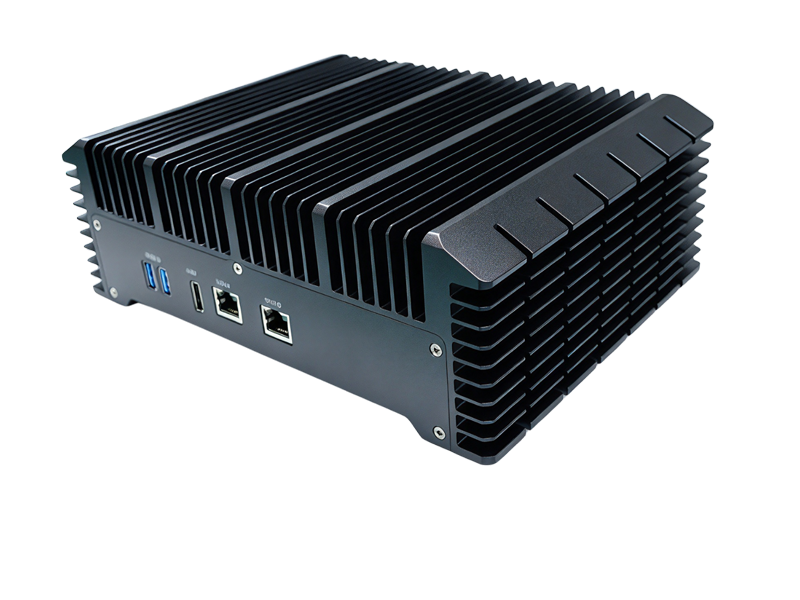
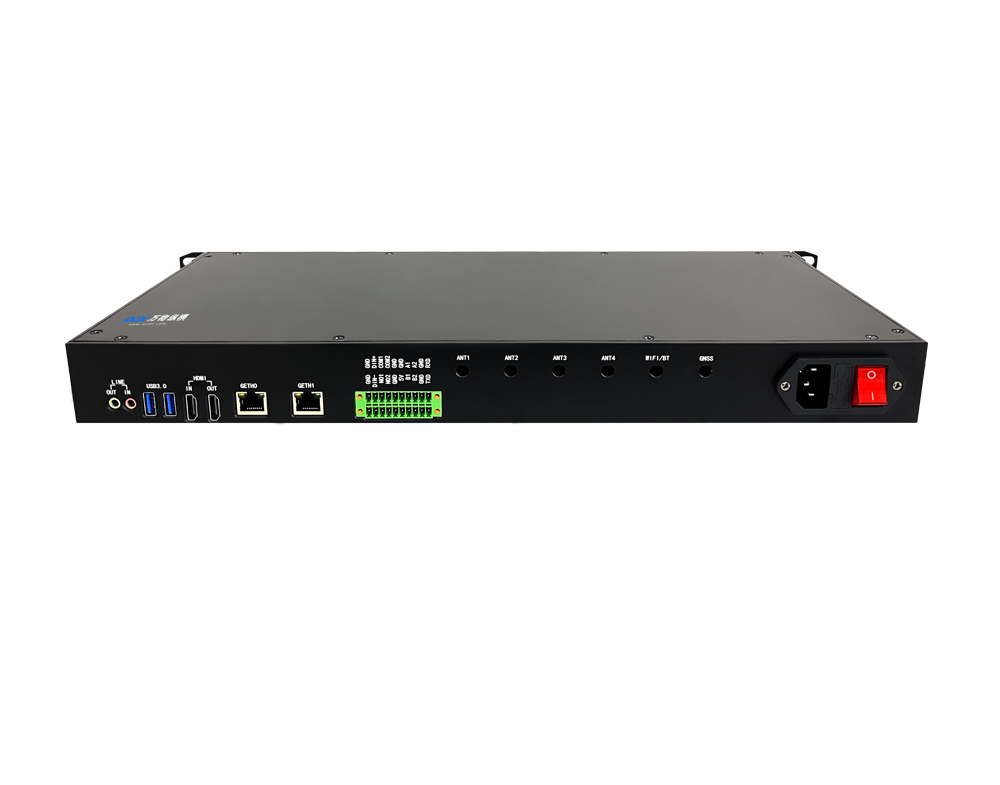
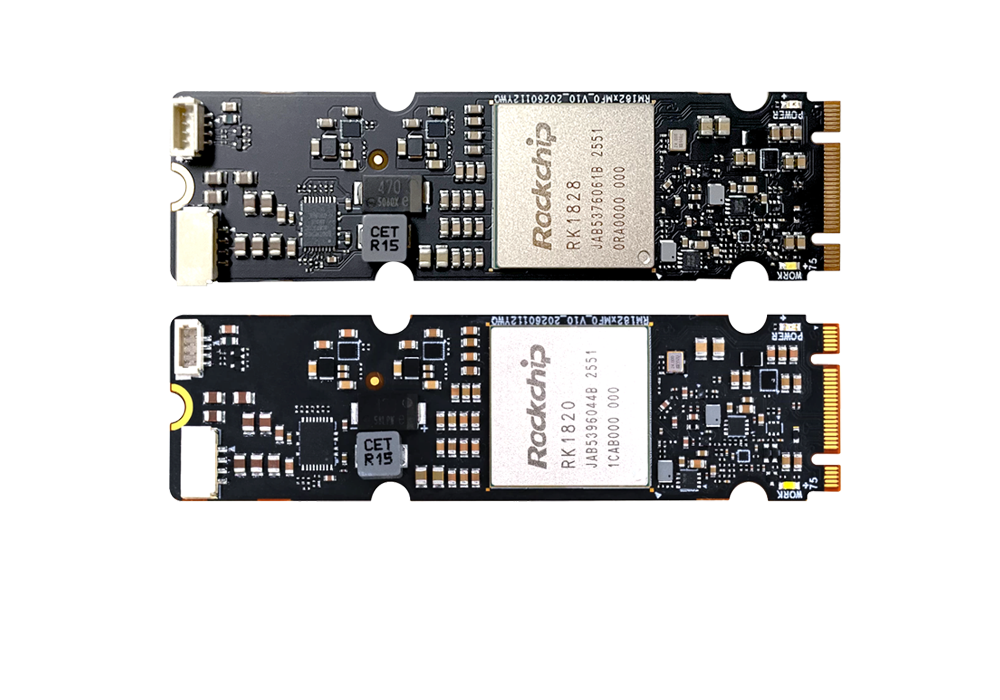
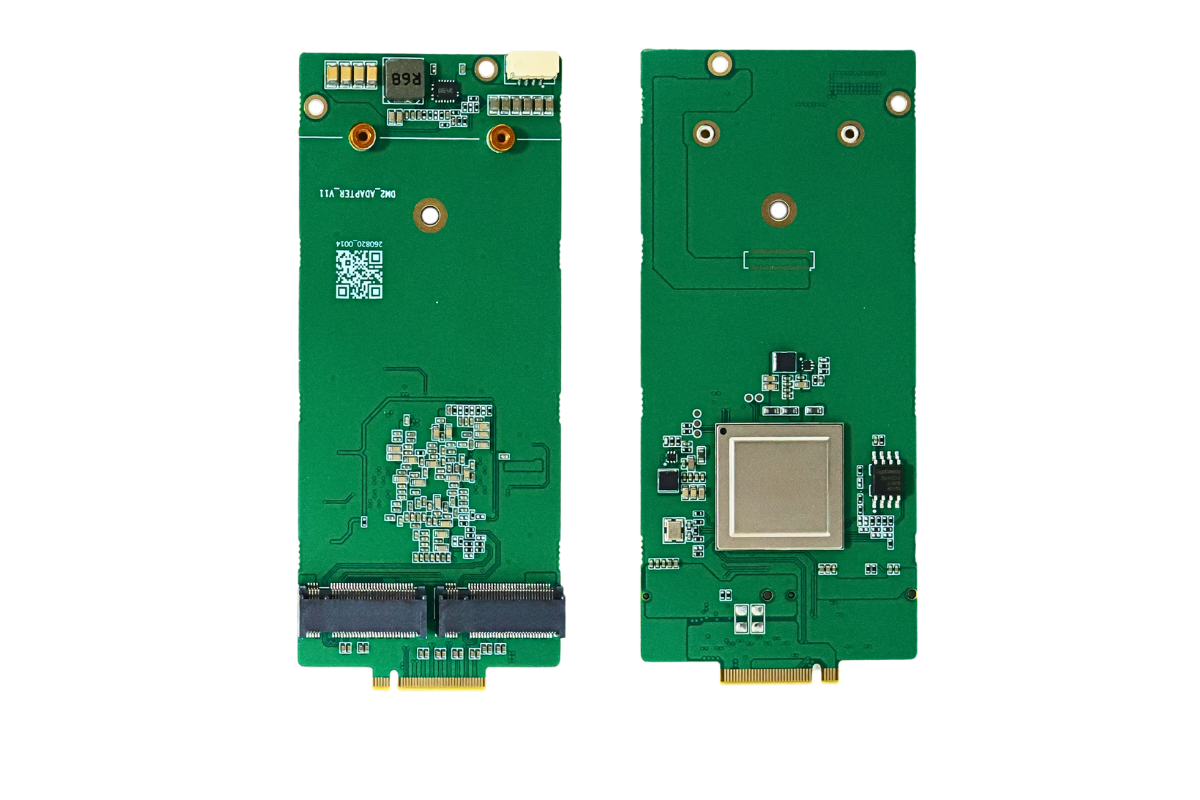


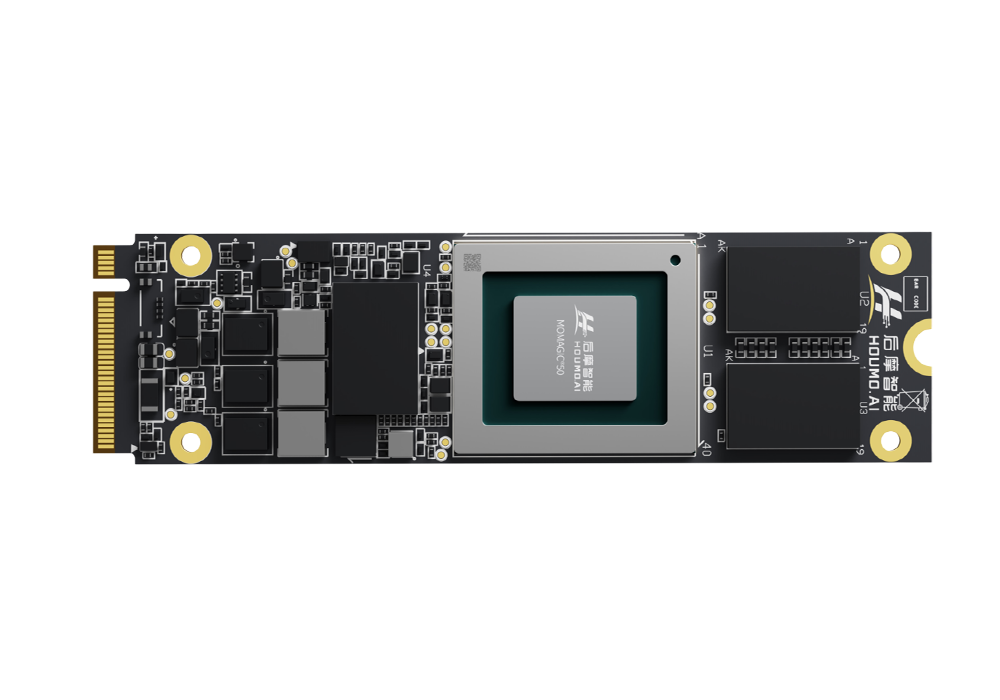
力擎® LQ50 Duo 是后摩智能基于漫界® M50 存算一体架构推出的双芯片边缘加速模组,单卡最高 160 TOPS 弹性算力、48GB LPDDR5 显存,原生支持 YOLO 全系列视觉模型部署。本文以 YOLOv8s 目标检测模型为例,完整讲解从模型导出、量化编译到板端推理、性能调优的全流程,充分释放双芯存算架构的推理能效。
一、部署前期准备
1.1 硬件与系统环境
硬件:LQ50 Duo M.2 加速卡(双 M50 芯片,PCIe 3.0 x4 接口)
宿主系统:Ubuntu 22.04 LTS(x86_64 架构,推荐内核 5.15+)
最低配置:4 核 CPU、8GB 内存、50GB 可用磁盘空间
1.2 软件栈安装
LQ50 Duo 依托后摩大道® 软件平台完成全流程开发,核心组件包括驱动、量化工具、编译器、运行时推理引擎。
1. 驱动与固件安装
从后摩开发者中心下载对应版本驱动包,执行安装并验证设备识别:
sudo dpkg -i postmo-driver_*.deb
sudo reboot
# 验证设备识别,正常应输出 1f6b:0c00 设备
lspci | grep 1f6b
2. 开发环境部署
官方提供 Docker 开发镜像,内置 HMQuantool 量化工具、TCIM 编译器、Python/C++ SDK:
docker pull houmoai/m50-sdk:latest
docker run -it --privileged -v /dev:/dev -v /your/workspace:/workspace houmoai/m50-sdk:latest
二、YOLO 模型准备与 ONNX 导出
2.1 模型训练与导出规范
以 Ultralytics YOLOv8 为例,导出 ONNX 模型时需适配后摩工具链的算子支持范围,避免自定义算子导致编译失败。
from ultralytics import YOLO
# 加载训练好的模型
model = YOLO("yolov8s.pt")
# 导出 ONNX,关键参数说明
# opset=12:兼容后摩量化工具的算子集
# simplify=True:简化计算图,移除冗余节点
# dynamic=False:关闭动态尺寸,静态尺寸推理性能最优
model.export(
format="onnx",
opset=12,
simplify=True,
dynamic=False,
imgsz=640
)
2.2 导出后校验
使用 onnx.checker 验证模型合法性,并确认输入输出节点:
输入节点:images,shape [1, 3, 640, 640],数据类型 FP32
输出节点:output0,shape [1, 84, 8400](检测头输出)
移除 NMS 后处理算子:后摩工具链建议将 NMS 放在 CPU 端执行,避免算子不兼容导致性能下降
三、模型 PTQ 量化(HMQuantool 工具)
LQ50 Duo 存算架构原生支持 INT8 精度推理,通过训练后量化(PTQ)可将 FP32 模型体积压缩 4 倍,推理速度提升 2~3 倍,精度损失控制在 1% 以内。
3.1 量化流程
后摩 HMQuantool 量化工具输入标准 ONNX 模型,输出 HMONNX 格式量化模型,流程如下:
1. 准备校准数据集
选取 100~300 张与部署场景一致的图片作为校准集,放入 calib_data/ 目录,无需标注。
2. 编写量化脚本
from hmquantool import xhquant_init, convert_onnx_to_hmonnx
import numpy as np
from pathlib import Path
# 初始化量化环境,指定目标设备为 M50(LQ50 Duo)
xhquant_init(target_device="xh2a")
# 配置量化参数
onnx_path = "yolov8s.onnx"
calib_data_dir = "calib_data/"
output_path = "yolov8s_int8.hmonnx"
# 执行 PTQ 量化
convert_onnx_to_hmonnx(
onnx_model=onnx_path,
output_hmonnx=output_path,
calib_data_dir=calib_data_dir,
calib_batch_size=8,
quant_format="mxint8", # 后摩专属 MXINT8 量化格式,存算效率最优
mix_precision_enable=False # 精度敏感场景可开启混合精度
)
3.2 量化精度调优
若量化后 mAP 下降超过 2%,可通过以下方式优化:
增加校准图片数量,覆盖场景全部分布
对检测头、上采样层等敏感层跳过量化:在量化配置中添加 skip_quant_layers
开启 mix_search 自动搜索最优量化策略,平衡精度与性能
四、模型编译(TCIM 编译器)
量化后的 HMONNX 模型需通过 TCIM(PostMo-Compiler)编译为 M50 芯片可执行的二进制模型文件(.hmm),编译器会自动完成算子融合、内存排布、双芯调度优化。
4.1 基础编译命令
import tcim
# 创建编译配置
config = tcim.CompileConfig()
config.target_device = "xh2a"
config.model_path = "yolov8s_int8.hmonnx"
config.output_path = "yolov8s_int8.hmm"
# 性能优化配置
config.optimize_level = "O3" # 最高优化等级,开启算子融合、常量折叠、内存复用
config.enable_multi_core = True # 启用 LQ50 Duo 双芯片并行推理
config.input_layout = "NCHW"
config.input_dtype = "int8"
# 执行编译
compiler = tcim.Compiler(config)
compiler.compile()
print("模型编译完成,输出文件:yolov8s_int8.hmm")
4.2 双芯片编译配置
LQ50 Duo 集成 2 颗 M50 芯片,编译时可配置两种调度模式:
单模型双芯流水:将单模型推理拆分到两个芯片流水执行,降低单帧延迟,适合低延迟场景
双模型双芯并发:两个芯片分别运行不同模型(如检测+分类),适合多任务场景
五、板端推理部署
编译完成的 .hmm 模型可通过 PostMo-Runtime(原 TCIM Runtime)在 LQ50 Duo 上执行推理,支持 C++ 和 Python 两种接口。
5.1 Python 接口单图推理示例
import postmo_runtime as runtime
import cv2
import numpy as np
# 1. 初始化运行时,加载模型
ctx = runtime.RuntimeContext()
ctx.load_model("yolov8s_int8.hmm")
model = ctx.get_model(0)
# 2. 图像预处理
img = cv2.imread("test.jpg")
img = cv2.resize(img, (640, 640))
img = img.transpose(2, 0, 1) # HWC -> CHW
img = np.expand_dims(img, axis=0).astype(np.int8) # 量化模型输入为 INT8
# 3. 执行推理
input_tensor = model.get_input(0)
input_tensor.from_numpy(img)
model.run()
# 4. 获取输出并后处理
output_tensor = model.get_output(0)
output = output_tensor.to_numpy()
# 执行 NMS、坐标还原等后处理
boxes, scores, classes = post_process(output, conf_thres=0.25, iou_thres=0.45)
5.2 视频流高性能推理架构
针对安防、工业质检等视频流场景,推荐采用解码-预处理-推理-后处理四阶段流水线架构,充分利用双芯片算力:
解码线程:使用硬件解码器解码 RTSP/视频文件,输出 NV12 格式帧
预处理线程:完成 resize、归一化、格式转换,可复用内存池
推理线程:绑定双芯片,批量提交推理任务,支持 batch 堆叠
后处理线程:CPU 并行执行 NMS、结果绘制、业务逻辑
官方 SDK 提供 yolov5s_dynamic 视频流示例,可直接基于其二次开发。
六、推理性能深度优化
6.1 模型层面优化
1. 量化精度选择
优先使用 MXINT8 量化,存算架构下能效比最高
高精度场景可选用 bFP16 浮点推理,LQ50 Duo 原生支持 100 TFLOPS bFP16 算力
2. 模型结构裁剪
根据业务场景调整输入尺寸,如 416x416 比 640x640 帧率提升约 60%
使用 YOLOv8n/YOLOv10n 等轻量版本,或对模型进行结构化剪枝
移除不必要的检测头与分支,减少计算量
6.2 硬件与调度优化
1. 双芯片负载均衡
单路高帧率场景:开启双芯流水,延迟降低 30%~40%
多路视频场景:每颗芯片绑定 2~4 路视频流,避免跨芯片数据搬运
使用 runtime.set_core_affinity() 手动绑定推理任务到指定芯片
2. 内存带宽优化
输入输出张量使用零拷贝内存(runtime.allocate_pinned_memory),减少 PCIe 数据搬运开销
开启内存复用,多模型共享显存空间,降低内存占用
优先使用 NV12 格式输入,避免 RGB 格式转换的带宽损耗
6.3 工程层面优化
1. 算子融合与图优化:编译时开启 O3 优化等级,编译器会自动融合 Conv+BN+ReLU、concat 等连续算子,减少内核启动开销与内存访问次数。
2. 批量推理(Batch 堆叠):多路视频场景下,将多帧图片拼成 batch 一次性提交推理,可显著提升吞吐。LQ50 Duo 推荐 batch=4~8,吞吐收益最高。
3. 后处理加速:
将 NMS 替换为快速 NMS 或类内 NMS,减少 CPU 耗时
使用 OpenCV 并行计算、多线程后处理,与推理流水线重叠
低置信度过滤前置,减少后续计算量
七、性能测试与精度验证
7.1 基准性能参考(YOLOv8s,640x640,INT8)
配置模式 | 单帧延迟 | 帧率(FPS) | 功耗 |
单芯片推理 | ~6ms | ~160 | ~12W |
双芯片流水 | ~3.5ms | ~280 | ~22W |
双芯片并发(batch=4) | ~12ms | ~330 | ~23W |
7.2 精度验证方法
1. 使用官方 PostMo-Bench 工具,在 COCO 验证集上测试量化前后 mAP 变化
2. 部署场景下采集 500 张实测图片,对比 FP32 与 INT8 模型的检测结果一致性
3. 若小目标检测精度下降,可针对性调整校准集,增加小目标样本占比
7.3 常见问题排查
编译失败:检查 ONNX opset 版本,移除自定义算子,使用 onnx-simplifier 简化模型
推理帧率低:确认是否开启双芯、优化等级是否为 O3、输入是否为静态尺寸
精度下降明显:增加校准样本,对检测头层跳过量化,降低量化比特数
八、总结
LQ50 Duo 凭借存算一体架构与双芯片设计,在边缘端具备极高的视觉推理能效比。完整部署流程遵循 ONNX 导出 → PTQ 量化 → TCIM 编译 → 运行时推理四步,配合双芯调度、内存优化、流水线架构等调优手段,可在 20W 级功耗下实现 300+ FPS 的 YOLOv8s 检测性能,适配智慧安防、工业质检、低空安防等多类边缘场景。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部