


1. 硬件平台概述
1.1 LQ50 Duo 核心规格
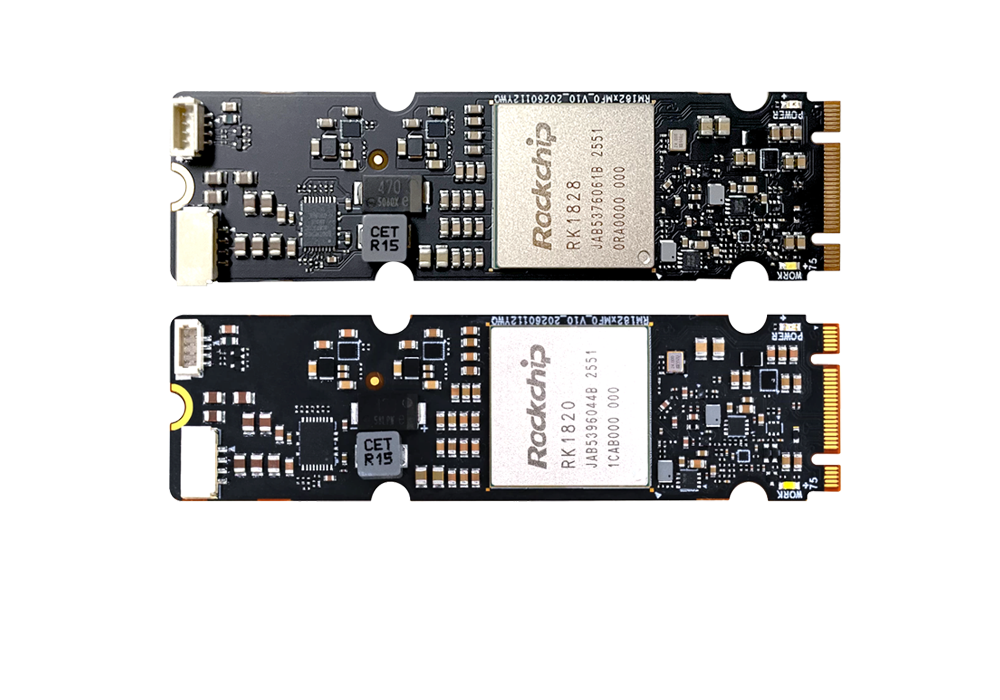
力擎® LQ50 Duo M.2 卡是后摩智能面向边缘端大模型推理的旗舰产品,基于存算一体架构设计:
参数项 | 规格 |
AI 加速器 | 2× 后摩漫界® M50 芯片 |
物理算力 | 320 TOPS @INT8,200 TFLOPS @bFP16 |
内存容量 | 48 GB LPDDR5/LPDDR5X |
内存带宽 | 307.2 GB/s |
接口 | PCIe Gen4 ×8,M.2 M-Key |
典型功耗 | ≤ 26W |
工作温度 | -20~60℃ |
尺寸 | 46×80mm |
双芯片架构为多模态模型提供充足的算力与内存空间,视觉编码与语言生成可并行调度,实现端侧高效推理。
1.1 部署形态说明
LQ50 Duo 支持两种部署形态:
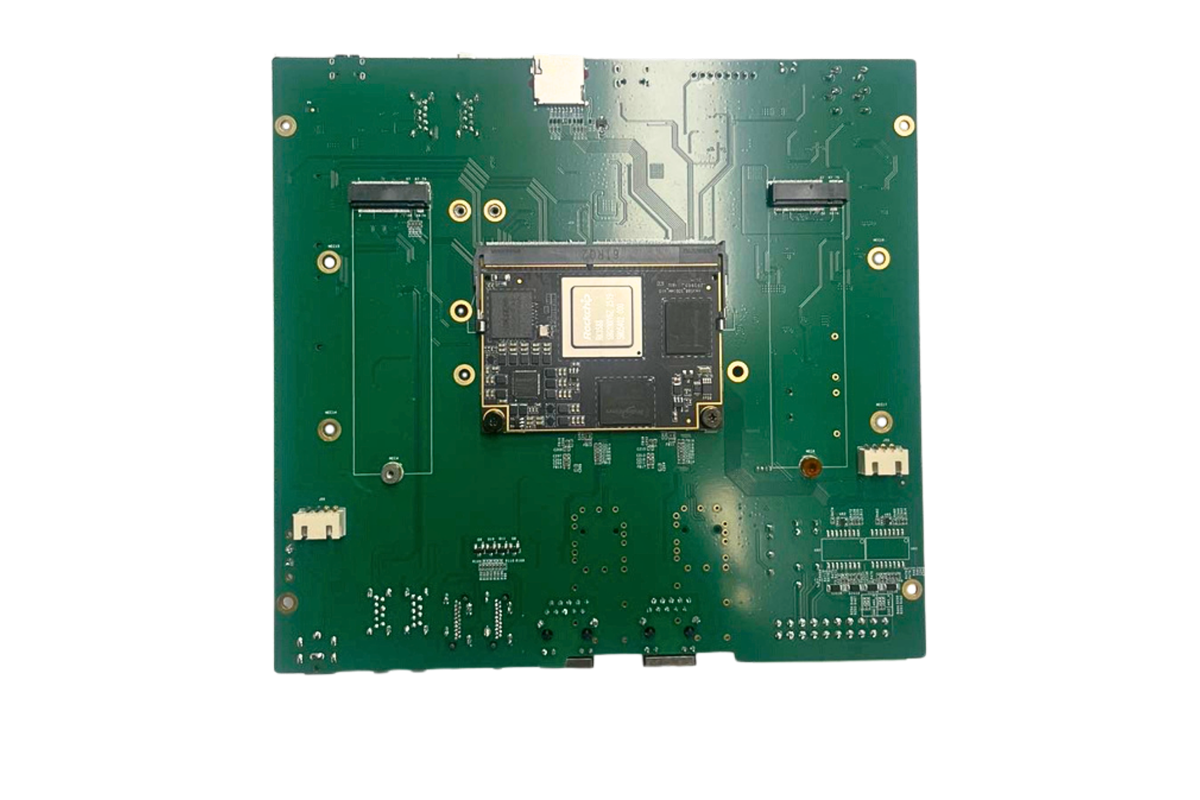
x86 主机 + M.2 加速卡:台式机/工作站 PCIe 扩展,适合开发调试。
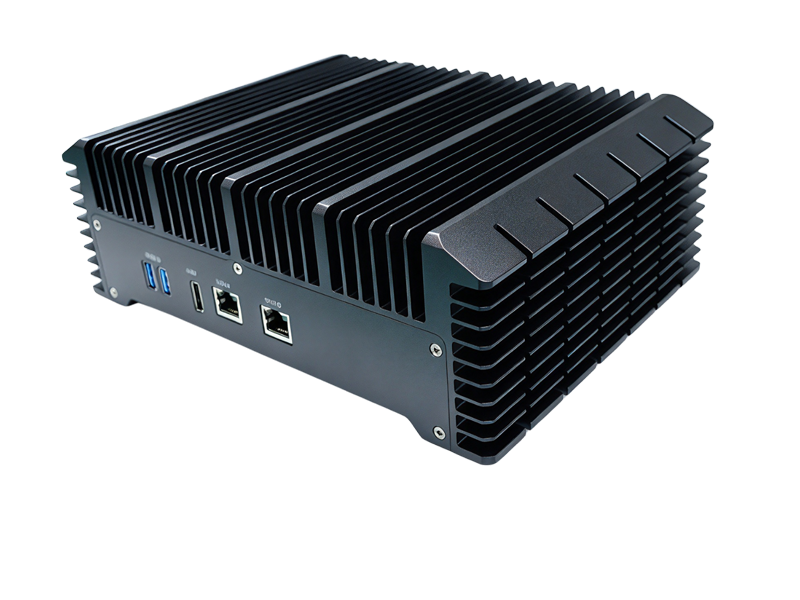
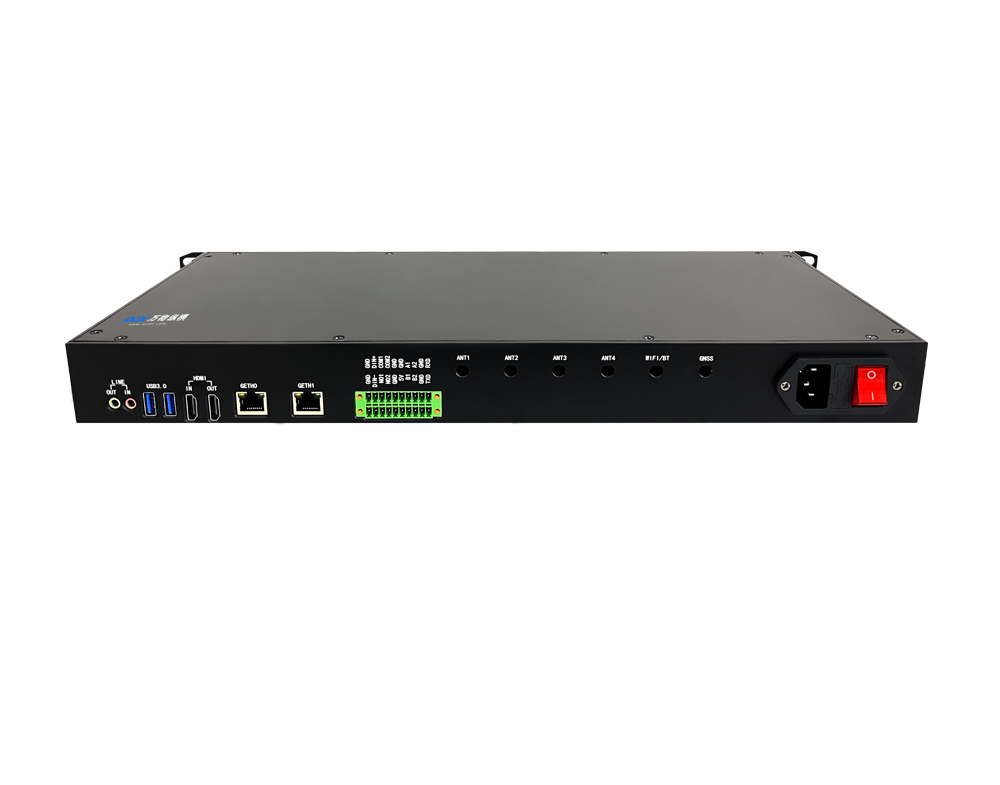
边缘盒子 + M.2 模组:如 Firefly AIBOX-Pro 等异构计算平台,RK3588 主控 + M50 协处理。
AI PC 内置:笔记本/一体机 M.2 插槽,端侧本地推理。
2. 软件环境搭建
2.1 系统与驱动准备
前置条件:
操作系统:Ubuntu 24.04 x86_64(推荐)
Docker 环境已安装
LQ50 Duo 硬件已正确安装并识别
步骤 1:安装驱动与固件
# 1. 登录后摩开发者社区下载驱动包
# https://developer.houmoai.com
# 选择:板级类别=LQ50-DUO-M2,版本=最新正式版
# 2. 安装 PostMo-Driver 驱动
sudo dpkg -i postmo-driver_*.deb
# 3. 升级设备固件
sudo hm_update_tool --firmware firmware_xh2_*.bin
# 4. 验证设备识别
hm_smi
正常输出应显示 2 颗 M50 芯片,状态为 Ready。
1.1 Docker 开发环境部署
后摩大道软件平台提供两种 Docker 镜像:
转换镜像:支持量化、编译、推理全流程,体积较大。
部署镜像:仅支持推理运行时,体积精简。
# 在开发者社区下载应用开发示例包
# 选择:AI 模型类别=VLM,平台架构=x86_64
# 解压示例包
unzip houmo-examples-xh2_v1.5.0.zip
cd houmo-examples-xh2
# 设置环境变量
source env.sh
1.1 获取 ModelZoo 示例包
DeepSeek-VL
├── 视觉编码器 (Vision Encoder)
│ └── ViT-SigLIP 视觉特征提取
├── 投影层 (Projection Layer)
│ └── 视觉特征→词嵌入空间映射
└── 语言主干 (LLM Backbone)
└── DeepSeek 系列大模型
2. DeepSeek-VL 模型适配说明
2.1 官方支持状态说明
截至后摩大道 v1.5.0 版本,PostMo-Quant 量化工具官方已验证支持的多模态模型包括:
Qwen2VL 系列
Qwen3-VL 系列
MiniCPM-V 4.5/4.6/4.7
Gemma4
重要提示:DeepSeek-VL 目前不在 ModelZoo 官方预置模型列表中(v1.5.0 版本已移除 deepseek-r1-qwen3-8b 示例)。但由于 DeepSeek-VL 与 Qwen2VL 架构高度相似(均采用 ViT 视觉编码器 + LLM 语言主干的分离式架构),可参照多模态模型通用量化编译流程进行自定义适配,以下为标准适配方法论。
2.2 DeepSeek-VL 模型架构拆解
DeepSeek-VL 采用典型的双塔架构,部署时需拆分处理:
# 从 HuggingFace 下载模型
huggingface-cli download deepseek-ai/deepseek-vl2-tiny \
--local-dir ./models/deepseek-vl2-tiny \
--local-dir-use-symlinks False
部署时视觉编码器与语言主干分别量化编译,推理时通过前后处理逻辑串联。
2.3 模型版本选型建议
针对 LQ50 Duo 48GB 显存配置,推荐以下规格:
DeepSeek-VL2-Tiny:约 2B 参数,入门首选,流畅运行。
DeepSeek-VL2-Small:约 7B 参数,平衡性能与效果。
DeepSeek-VL2:约 16B 参数,双芯片分布式部署。
量化精度建议:W8A8 或 W4A16,根据精度需求选择。
3. 模型量化流程
3.1 准备原始模型
import os
from xh_model_zoo.xh_llm import LLMConverter
from xh_model_zoo.xh_llm.models.deepseek_vl2 import DeepSeekVL2ConvertConfig
# 配置量化参数
config = DeepSeekVL2ConvertConfig(
model_path="./models/deepseek-vl2-tiny",
output_dir="./quantized/deepseek-vl2-llm",
device_type="XH2a", # M50 芯片目标
w_bit=8, # 权重量化位数
a_bit=8, # 激活量化位数
group_size=128, # 量化分组大小
context_length=32768, # 上下文窗口
prefill_length=256, # prefill 分块大小
)
# 执行量化
converter = LLMConverter(config)
converter.convert()
确保模型为 HuggingFace Transformers 标准格式。
2.1 语言主干量化
使用 PostMo-Quant 工具对 LLM 部分进行量化:
from xh_model_zoo.xh_cv import CVConverter
# 视觉编码器量化配置
vit_config = {
"model_path": "./models/deepseek-vl2-tiny/vision_encoder",
"output_dir": "./quantized/deepseek-vl2-vit",
"quant_type": "int8",
"calibration_dataset": "./calib_images/",
"calibration_num": 128,
}
converter = CVConverter(**vit_config)
converter.quantize()
量化输出包含:prefill 阶段权重、decode 阶段权重、词表与配置文件。
2.1 视觉编码器量化
视觉 ViT 部分使用 CV 模型量化流程:
# 提取并保存 embedding 权重
python scripts/export_embedding.py \
--model_path ./models/deepseek-vl2-tiny \
--output_path ./quantized/embedding.pt
2.1 投影层与 Embedding 处理
多模态模型的投影层和 embedding 权重通常保留 FP16 精度,单独导出:
# 编译 Prefill 阶段
hm_compiler \
--input ./quantized/deepseek-vl2-llm/prefill \
--output ./compiled/deepseek-vl2_prefill.hmm \
--ndevice 2 \
--ncore 2 \
--stage build \
--context_length 32768 \
--prefill_length 256
# 编译 Decode 阶段
hm_compiler \
--input ./quantized/deepseek-vl2-llm/decode \
--output ./compiled/deepseek-vl2_decode.hmm \
--ndevice 2 \
--ncore 2 \
--stage build \
--context_length 32768
3. 模型编译与部署
3.1 编译语言主干
使用 PostMo-Compiler 将量化后的模型编译为 M50 可执行的 .hmm 格式:
hm_compiler \
--input ./quantized/deepseek-vl2-vit \
--output ./compiled/deepseek-vl2_visual.hmm \
--ndevice 1 \
--quant_type int8
关键参数说明:
--ndevice 2:双芯片分布式部署,LQ50 Duo 必填。
--ncore 2:每芯片使用的计算核心数。
--context_length:最大上下文窗口,影响内存分配。
3.1 编译视觉编码器
deepseek-vl2-deploy/
├── tokenizer/ # 分词器文件
├── embedding.pt # 词嵌入权重
├── deepseek-vl2_visual.hmm # 视觉编码器编译文件
├── deepseek-vl2_prefill.hmm # LLM 预填充阶段
└── deepseek-vl2_decode.hmm # LLM 解码阶段
视觉编码器通常单芯片运行即可,另一芯片专注语言生成。
3.1 部署目录结构
编译完成后,部署目录结构如下:
import torch
from PIL import Image
from transformers import AutoTokenizer
from hm_runtime import HMRuntime
class DeepSeekVLInfer:
def __init__(self, model_dir):
# 加载分词器
self.tokenizer = AutoTokenizer.from_pretrained(
f"{model_dir}/tokenizer", trust_remote_code=True
)
# 加载视觉编码器
self.vit_runtime = HMRuntime(
f"{model_dir}/deepseek-vl2_visual.hmm"
)
# 加载 LLM 运行时
self.prefill_runtime = HMRuntime(
f"{model_dir}/deepseek-vl2_prefill.hmm"
)
self.decode_runtime = HMRuntime(
f"{model_dir}/deepseek-vl2_decode.hmm"
)
# 加载 embedding
self.embedding = torch.load(
f"{model_dir}/embedding.pt"
)
def infer(self, image_path, prompt):
# 1. 图像预处理
image = Image.open(image_path).convert("RGB")
pixel_values = self._preprocess_image(image)
# 2. 视觉编码
vision_features = self.vit_runtime.run(pixel_values)
# 3. 投影到词嵌入空间
vision_embeds = self._project_vision_to_llm(vision_features)
# 4. 文本 token 化与嵌入
text_ids = self.tokenizer.encode(prompt)
text_embeds = self.embedding[text_ids]
# 5. 拼接多模态输入
inputs_embeds = torch.cat([vision_embeds, text_embeds], dim=1)
# 6. Prefill 阶段
past_key_values = self.prefill_runtime.run(inputs_embeds)
# 7. 自回归解码
generated_ids = []
for _ in range(max_new_tokens):
next_token, past_key_values = self.decode_runtime.run(
past_key_values
)
generated_ids.append(next_token)
if next_token == self.tokenizer.eos_token_id:
break
# 8. 结果解码
return self.tokenizer.decode(generated_ids)
4. 推理实现
4.1 Python 推理示例
芯片 | 负载 | 说明 |
Chip 0 | 视觉编码器 + Prefill | 计算密集型前置处理 |
Chip 1 | Decode 全程 | 自回归生成主负载 |
4.1 双芯片负载调度
LQ50 Duo 推荐的调度策略:
self.vit_runtime.set_device(0)
self.prefill_runtime.set_device(0)
self.decode_runtime.set_device(1)
通过设备亲和性设置实现:
# 启动推理服务
python -m apps.vlm_service.main \
--config configs/deepseek_vl2.yaml \
--host 0.0.0.0 \
--port 8090
4.2 启动 API 服务
参考后摩智能守护方案的服务化部署方式:
量化方案 | 模型体积 | 内存占用 | 推理速度 | 精度损失 |
FP16 | 100% | 约 32GB | 基准 | 无 |
W8A8 | 约 50% | 约 18GB | +40~60% | <2% |
W4A16 | 约 25% | 约 12GB | +80~100% | 3~5% |
服务提供 OpenAI 兼容的 /v1/chat/completions 接口,支持图文混合输入。
5. 性能优化与调优
5.1 量化精度权衡
LQ50 Duo 48GB 内存可轻松容纳 7B 级 W8A8 模型,推荐优先使用 W8A8 保证精度。
4.3 推理性能优化
1. Prefill 分块优化:长输入场景下,设置合理的 prefill_length 分块大小,256~512 token 为推荐区间。
2. KV Cache 管理:启用流式 KV 缓存复用;设置合理的最大上下文长度避免内存浪费。
3. 并发调度:视觉编码与文本预处理 CPU 流水线并行;双芯片间通过 PCIe peer-to-peer 减少数据搬运。
4.4 典型性能参考
基于 M50 双芯片平台的同量级多模态模型参考数据:
模型 | Prefill 速度 | Decode 速度 | 首包延迟 |
MiniCPM-V 4.7(35B-A3B) | 1433 tokens/s | 38.3 tokens/s | 约 200ms |
Qwen3-VL 4B | 2800+ tokens/s | 60+ tokens/s | 约 150ms |
DeepSeek-VL2-Tiny 预期性能与同参数量级模型接近,双芯片 decode 速度可达 40~60 tokens/s。
5. 常见问题与排错
5.1 设备相关问题
Q:hm_smi 只识别到 1 颗芯片
检查 M.2 插槽是否均为 PCIe Gen4 x4 以上。
确认固件版本匹配双芯片配置。
重新加载驱动:sudo modprobe -r postmo && sudo modprobe postmo。
Q:编译时报 DevSet 校验失败
编译时 --ndevice 参数必须与运行时设备数一致。
LQ50 Duo 必须指定 --ndevice 2。
5.2 模型适配问题
Q:自定义模型量化时出现不支持的算子
参考 Qwen2VL 的适配方式替换对应算子。
提交工单至后摩开发者社区申请算子支持。
临时方案:将不支持算子回退 CPU 执行。
Q:多模态拼接后输出异常
检查视觉特征投影层权重是否正确导出。
验证视觉 token 数量与位置索引是否匹配。
确认 prompt 格式中的 <image> 占位符位置正确。
5.3 性能调优建议
1. 优先保证散热:LQ50 Duo 满载功耗约 26~30W,需良好散热。
2. 使用 PCIe Gen4 插槽:Gen3 会显著影响数据传输速度。
3. 关闭不必要的系统服务,减少 CPU 调度干扰。
4. 启用大页内存:提升内存访问效率。
6. 替代方案与建议
如果 DeepSeek-VL 自定义适配成本较高,推荐优先使用后摩官方已深度优化的多模态模型:
Qwen3-VL:官方全流程支持,性能最优,工具链最完善。
MiniCPM-V 4.7:端侧优化极佳,35B-MoE 规格效果出色。
Gemma4:谷歌官方合作,稳定性有保障。
这些模型均可在 ModelZoo 中直接获取预编译版本,开箱即用,部署成本最低。如需 DeepSeek 系列特定能力,可参照本教程的通用多模态适配流程逐步验证。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:18116674131(王小姐) 17340067106(毛先生)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部