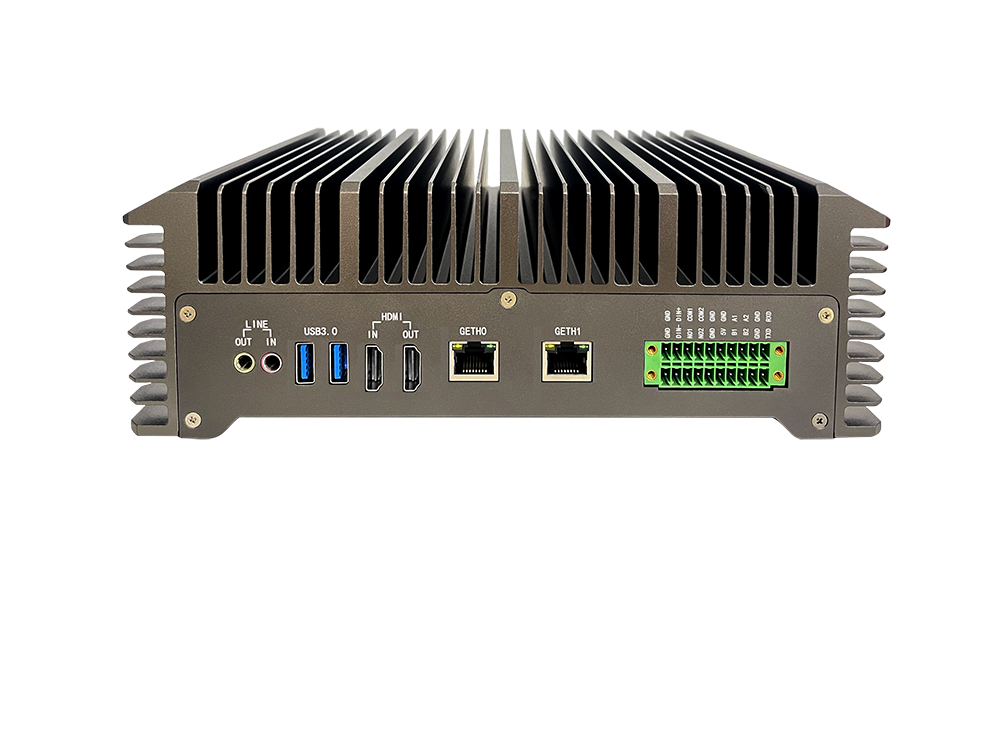
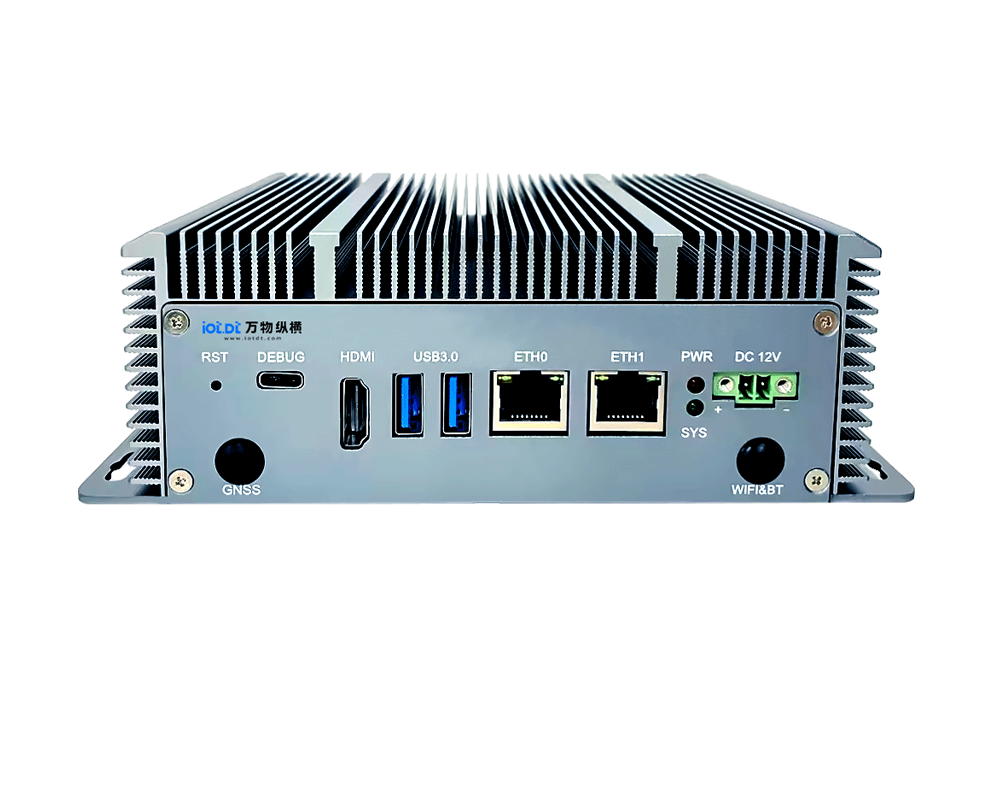
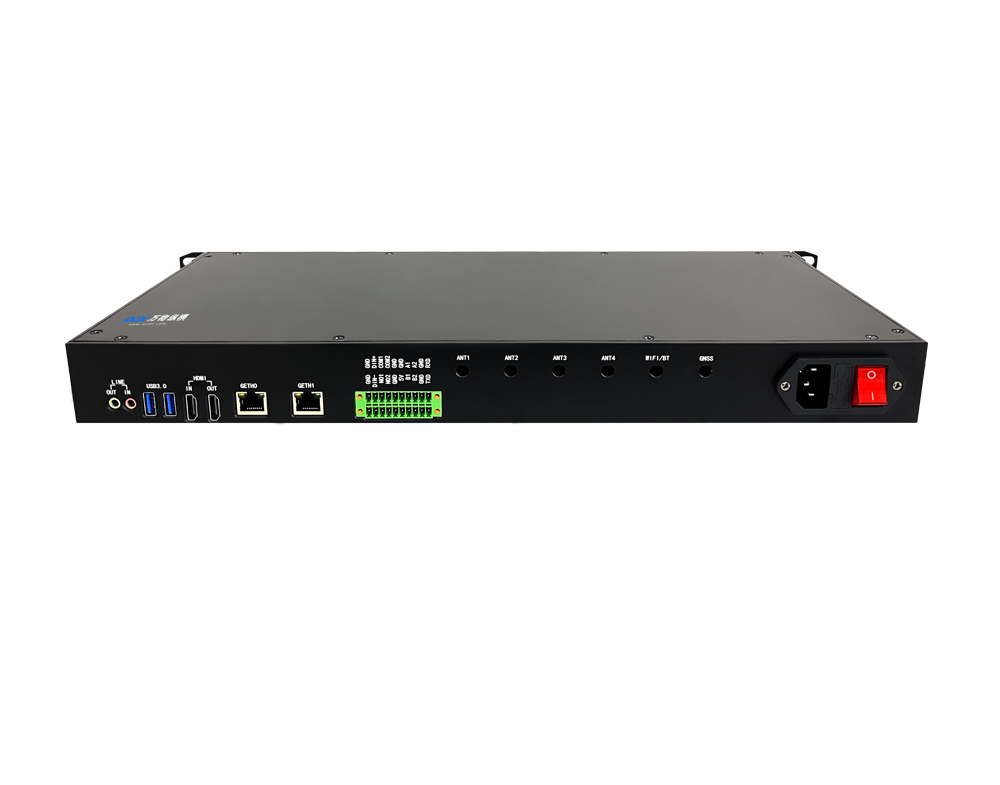
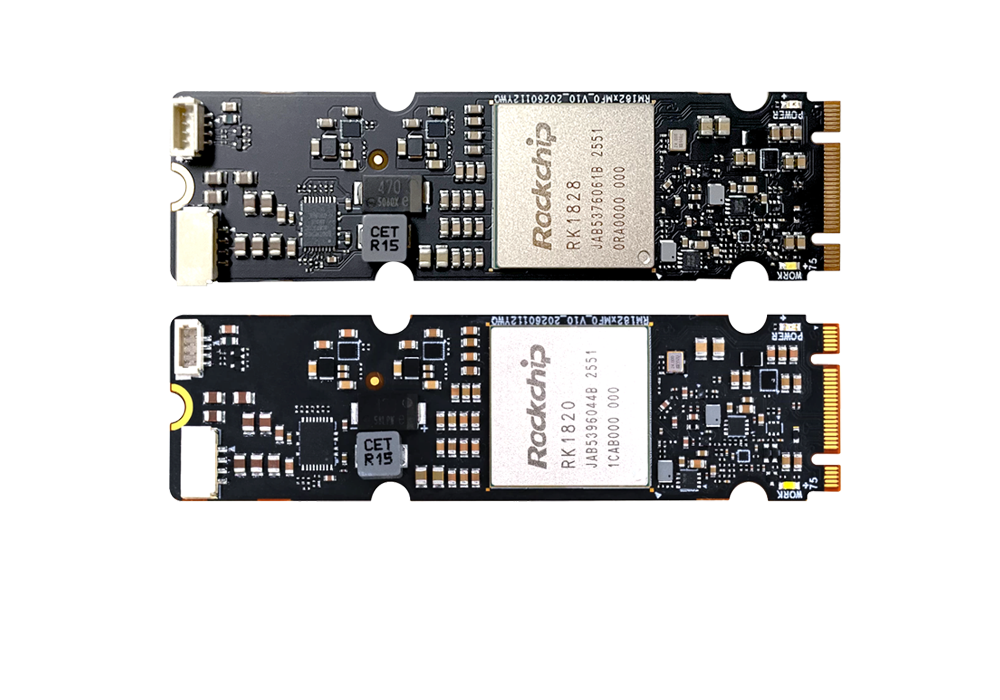
RK1828 多卡级联采用模型层间流水线并行(Pipeline Parallelism),依托 RKNN3 SDK 做调度、显存、KV Cache 与解码循环深度优化,解决边缘端大模型单卡显存不足、解码 token 延迟高的痛点,典型落地为 RK3588 主控 + 多 RK1828 PCIe 级联,跑 Qwen3.8-27B 等稠密 LLM。

一、RK1828多卡级联背后的流水线并行技术
区别于张量并行(单一层拆到多卡),RK1828 这套是流水线并行:按 Transformer 层边界切模型,分成多个 segment,每张卡常驻一个模型段,多卡接力串行推理,主控做流水线调度与 PCIe 数据转发。
1. 模型切分方式
把 LLM 的 Transformer 层切分成 N 段,N 等于 RK1828 卡数量。
例:4 卡级联 → segment0(前若干层)放卡 0,segment1 放卡 1,segment2 放卡 2,segment3(后层 + lm_head)放卡 3
每块 RK1828 的 5GB 堆叠 DRAM 只需要保存自己对应的模型权重 + 本卡 KV Cache,不用完整加载整个大模型,突破单卡显存上限
Prefill(上下文预填充)、Decode(逐 token 生成)两个阶段都由主控 RK3588 调度流水线,在 PCIe 上传递中间 hidden state
2. 流水线并行执行逻辑
1. Prefill 阶段:输入 prompt 一次性进入流水线,依次流过卡 0→卡 1→卡 2→卡 3,一次性计算全部 KV Cache;
2. Decode 阶段(逐 token):每生成 1 个 token,hidden state 沿着多卡流水线传递,各卡依次执行自己的 Transformer segment;
3. 流水线吞吐叠加:当第一组请求在卡 1 计算时,新请求可以送入卡 0,多组请求重叠执行,提升整体 TPS;
短板:单 token 存在流水线穿越延迟(必须走完所有卡),所以 RKNN3 新版本重点优化 Decode 路径,降低这个延迟。
3. 硬件链路与调度
互联:M.2 PCIe 2.0/3.0,RK3588 为主控,负责帧 / 张量分发、卡间数据搬运、任务队列;RK1828 只做 NPU 计算;
显存优势:RK1828 3D 堆叠 DRAM 带宽 1024GB/s,大幅降低 KV Cache 读写瓶颈,是流水线并行能跑起来的硬件底座;
量化配套:RKNN3 支持混合量化,Transformer 层 W4A16,输出层保留高精度,控制权重体积,在多卡分段加载时不损失精度。
4. 流水线并行 vs 张量并行(RK1828 选型要点)
并行方式 | RK1828 实现 | 优点 | 缺点 | 适用场景 |
流水线并行(当前方案) | 按 Transformer 层切分模型到多卡 | 权重分散到各卡,显存压力小;多请求流水线吞吐高 | 单 token 存在跨卡传递延迟 | 边缘大模型,27B/31B 稠密模型 |
张量并行 | 单层矩阵拆分到多卡 | 单 token 延迟更低 | 每张卡都要存全部权重,显存消耗大 | 显存充足的服务器 |
二、RKNN3 SDK 新版本:解码(Decode)延迟优化点
RKNN3 SDK V1.0 + 针对 RK1828 LLM Decode 链路深度优化,官方数据 LLM Decode 性能整体提升 \\>15%\\,重点优化方向如下:
1. KV Cache 本地化与 PCIe 搬运裁剪
多卡流水线场景下,把 KV Cache 保存在对应 RK1828 片上 DRAM,不再反复把 KV Cache 传回主控;只在卡之间传递 hidden state 张量,减少 PCIe 带宽占用与拷贝延迟;
KV Cache 预分配、复用内存池,消除每次 token 生成时的动态内存申请开销,降低时延抖动。
2. Decode 计算图算子融合
对 Attention、RoPE、LayerNorm、Matmul 做算子融合,减少 NPU 指令调用、中间张量落地;
优化 W4A16 权重解码反量化路径,把反量化计算下沉到 NPU 硬件单元,避免 RISC-V 侧 CPU 瓶颈。
3. 流水线调度器优化(多卡级联专属)
主控调度器做流水线气泡(bubble)压缩,减少卡之间等待空闲的时间;
异步 PCIe 数据传输:前一张卡计算的同时,后台预传输 hidden state 到下一张卡,计算与数据搬运重叠,掩盖 PCIe 传输延迟;
支持动态 batch 调度,小 batch 低延迟、大 batch 高吞吐自适应切换。
4. RISC-V 协处理器侧优化
RK1828 内置 3 核 RISC-V,新版本把 Decode 循环里的部分轻量逻辑下沉到卡上 RISC-V,减少主控 CPU 参与,降低主控 CPU 瓶颈带来的 token 延迟。
5. Prefill/Decode 路径分离优化
Prefill 和 Decode 两套独立计算图,Decode 路径做轻量化裁剪,不携带 Prefill 阶段冗余算子,降低单 token 推理耗时。
三、实测效果与边界(RK3588+4×RK1828)
4 卡级联跑 Qwen3.8-27B:13 TPS;2 卡跑 Qwen3.5-9B:35 TPS
功耗:单 RK1828 约 10W,4 卡满载约 40W,适合边缘盒子、工业本地大模型场景;
限制:流水线并行天然存在token latency 与吞吐的权衡;并发请求少时,流水线气泡会拉高首 token 延迟,并发请求上来后吞吐优势释放。
四、典型业务场景
本地边缘大模型、工业视觉 VLM、明厨亮灶 / 智慧工地多摄像头 + LLM 图文理解、本地 Agent,单卡放不下大参数模型,又不能上云端,就用 RK3588+RK1828 多卡流水线级联方案。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部