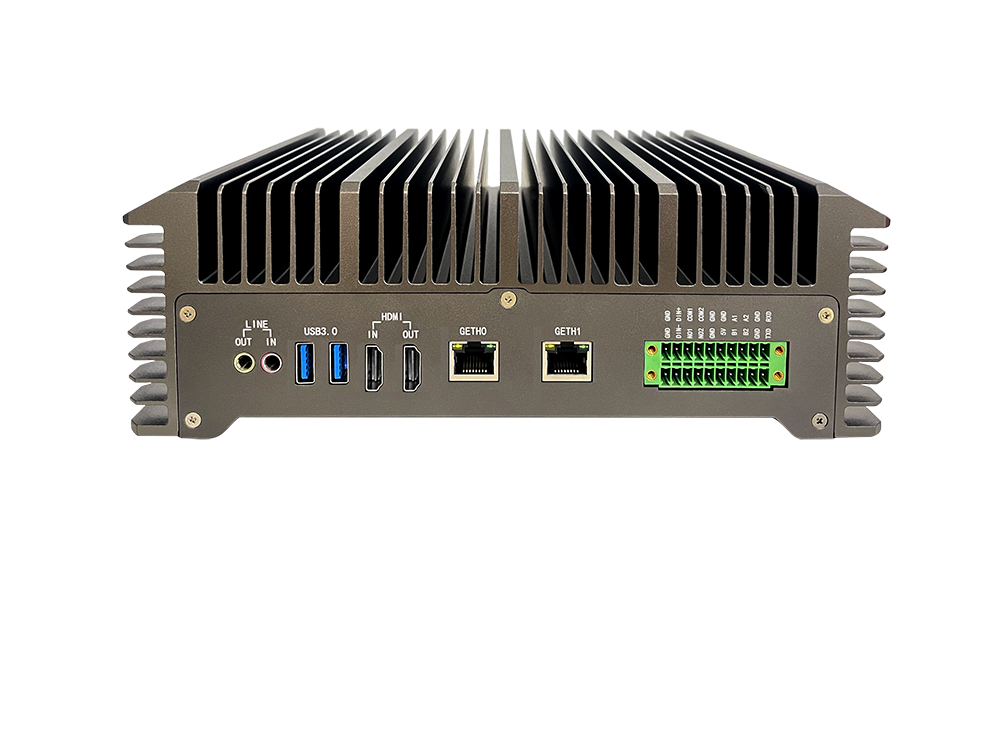
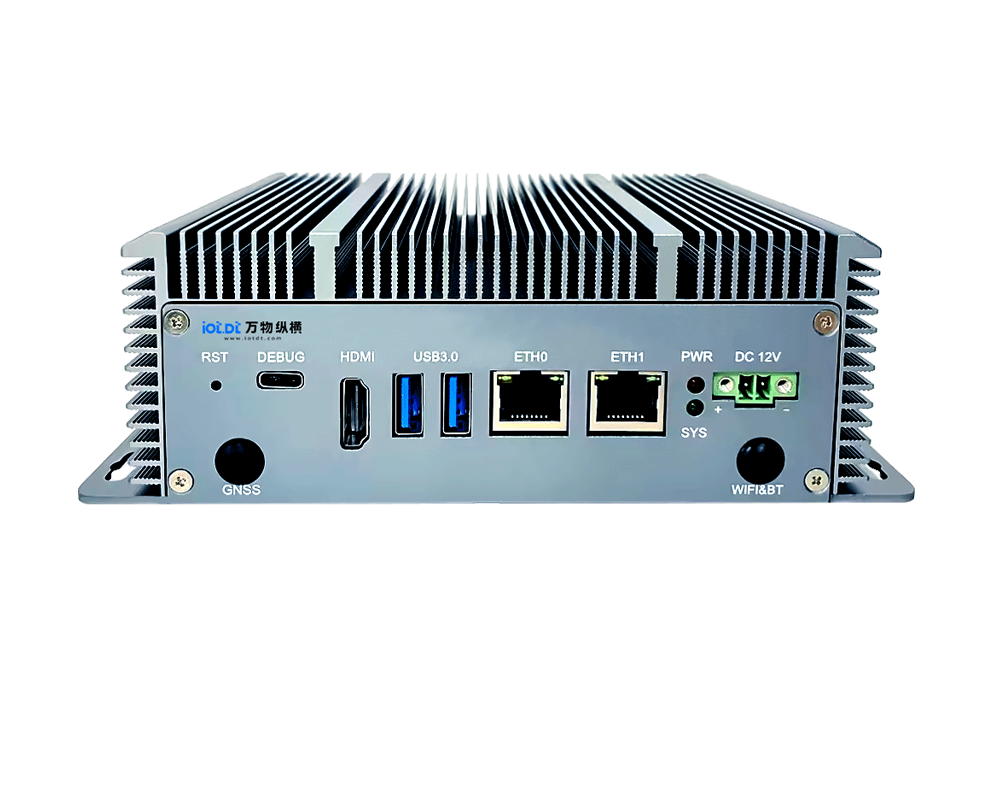
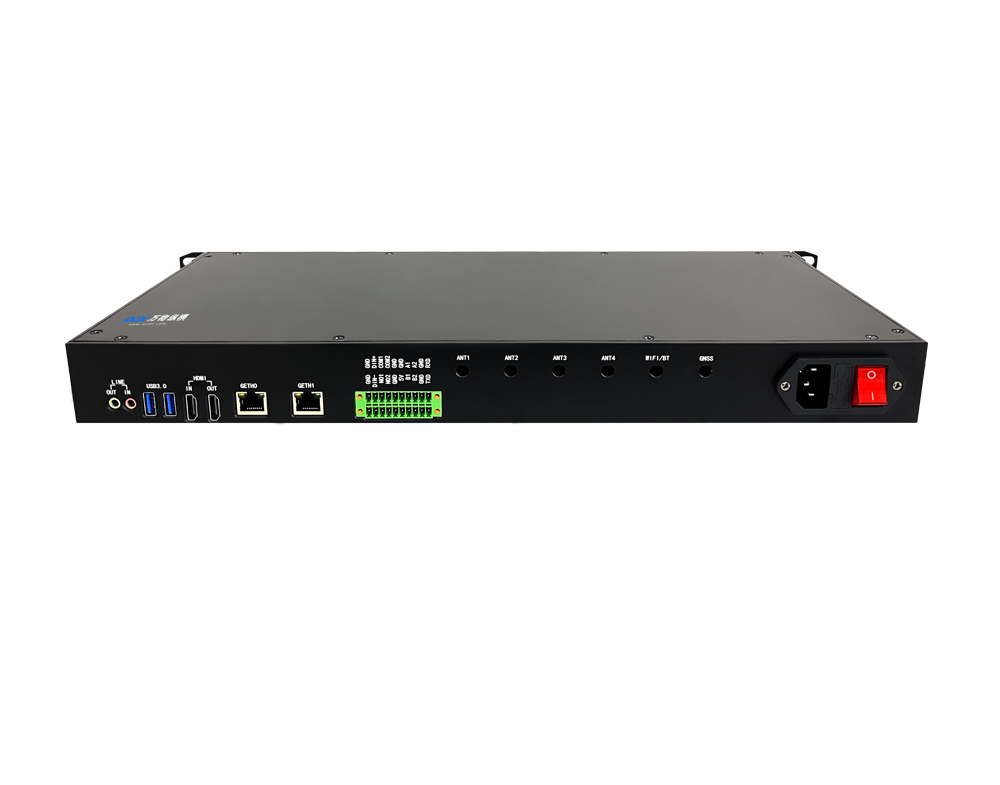
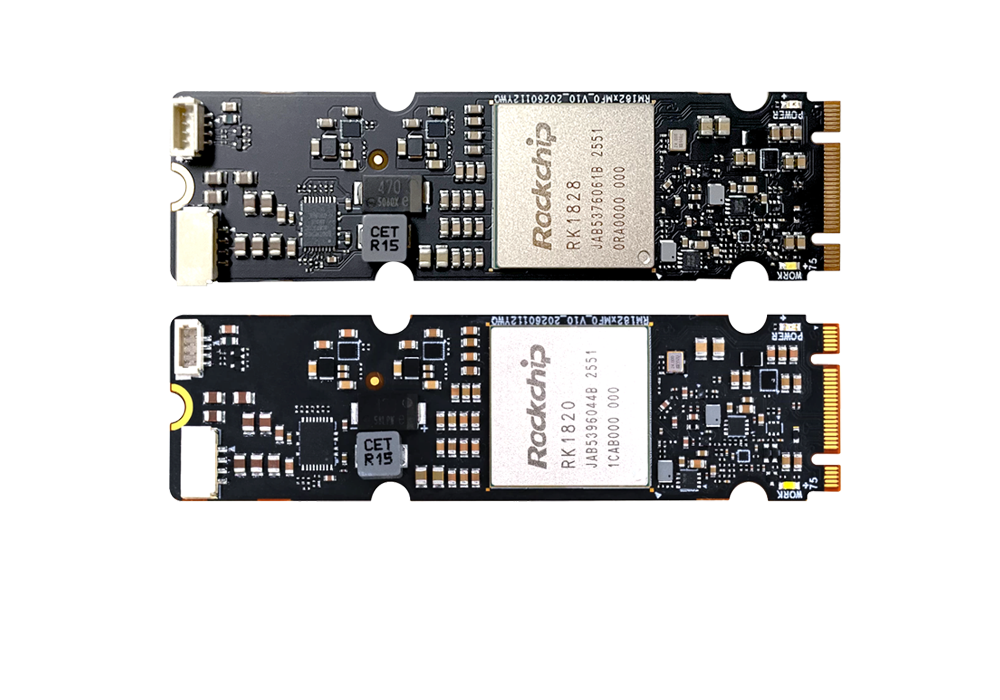
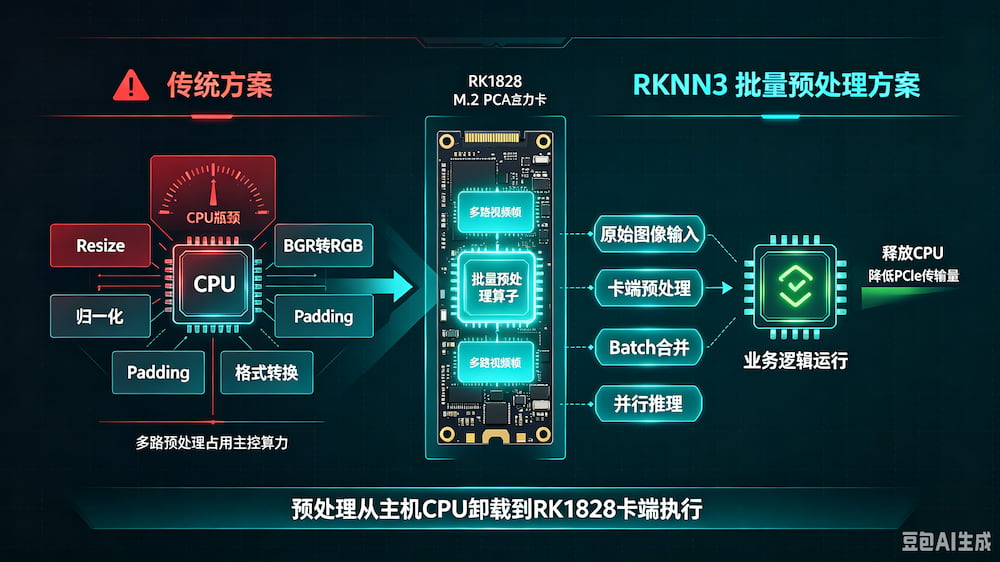
RK1828 M.2 PCIe 算力卡搭配新版 RKNN3 SDK,新增批量预处理算子,把图像缩放、归一化、通道转换、均值方差、数据格式转换等预处理操作,从主控 CPU 迁移到 RK1828 算力卡本地 NPU / 协处理器执行,大幅降低主机 CPU 占用,非常适合多路视频并发场景(明厨亮灶、智慧工地、光伏巡检等)。
一、原方案痛点(RKNN2 及更早)
多路 AI 视觉推理时,图像预处理全部在主控 CPU 完成:
1. 多路视频流(4/8/16 路)同时做 resize、BGR 转 RGB、归一化、padding,CPU 算力被预处理占满;
2. CPU 既要负责视频解码、业务逻辑、网络通信,又要做图像前处理,容易出现卡顿、丢帧;
3. 预处理完成后,再通过 PCIe 把多帧图像数据拷贝到 RK1828 显存,内存拷贝开销大;
4. 高并发场景下,主控 CPU 成为系统瓶颈,NPU 算力无法充分释放。
二、RKNN3 批量预处理算子核心优势
1. 预处理卸载到 RK1828 卡端
批量预处理算子内置在 RKNN3 模型中,多帧图像原始数据送入 RK1828 后,在算力卡内部完成整 batch 预处理,不再占用主控 CPU 资源,主控仅负责采集原始图像,释放 CPU 去跑业务、协议、管理逻辑。
2. 批量并行,减少 PCIe 传输量
直接传输原始图像,不需要 CPU 预处理后再传送;一整个 batch 的原始数据一次性送入卡内,在卡内完成缩放、色域转换、归一化,减少多次小数据 PCIe 交互,降低总线带宽压力。
3. 支持多帧 Batch 并行推理
单轮推理支持多张图片批量预处理 + 批量推理,多路视频场景下,提升 NPU 利用率,降低单帧平均推理时延,提升整体并发路数上限。RK1828 内置 5GB 片上 DRAM,足够缓存多批图像张量,减少主机与卡之间数据来回拷贝。
4. 系统稳定性提升
主控 CPU 负载显著下降,不会因为 AI 路数增加挤压业务程序,工控边缘网关、x86 工控主机、RK3588 主控 + RK1828 扩展方案收益最明显。
三、适用场景
多路视频目标检测、安全帽识别、烟火检测、明厨亮灶
光伏 / 风电巡检图像批量分析
多图向量 Embedding 批量提取
多模态批量图片预处理(Qwen-VL 等多模态模型)
四、开发要点
1. 在 RKNN3 Toolkit 模型转换阶段,把预处理算子嵌入模型,编译到 RKNN3 rknn 模型;
2. Runtime 调用时,直接送入原始图像数据(BGR 原始帧),不需要在代码里写 CPU 预处理逻辑;
3. 支持 Linux/Android,兼容 RK3588、RK3576、x86 主机通过 PCIe 挂载 RK1828 M.2 算力卡;
4. 可以和 RKNN3 其他特性搭配:多模型并发、推理与数据传输重叠、卡端自定义后处理算子。
五、总结
RKNN3 批量预处理算子,将多路图像前处理从主机 CPU 卸载到 RK1828 算力卡内部执行,释放主控算力、减少 PCIe 数据传输,提升边缘多路视觉 AI 并发上限,解决传统方案 CPU 瓶颈问题。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部