在边缘计算领域,如何在有限的功耗和体积下运行更大的大语言模型,一直是开发者关注的痛点。
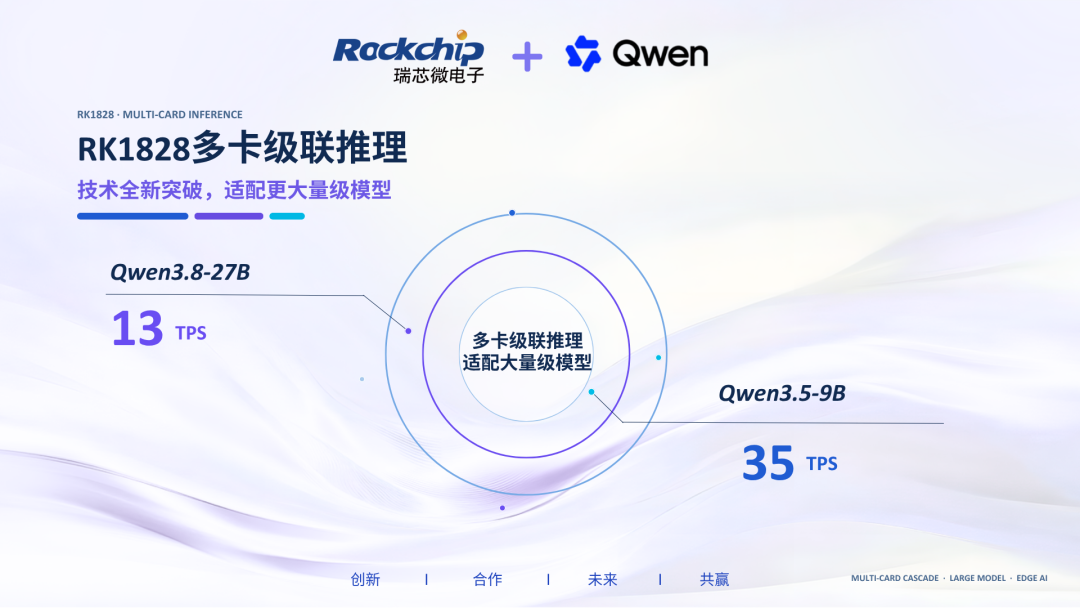
此前,基于瑞芯微 RK182X SDK 1.1.0 的双卡级联方案,已经让 RK3588 平台成功跑通 9B 模型。但面对 27B 甚至 30B+ 参数量的模型,双卡配置往往显得吃力。
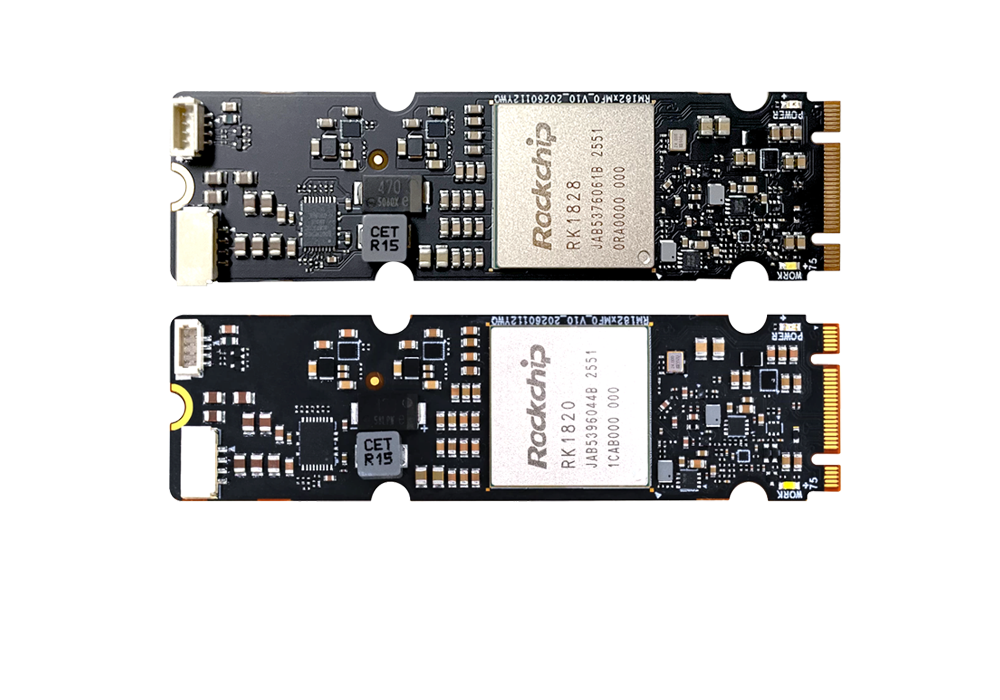
万物纵横带来了更具扩展性的解决方案——基于 PCIe Switch 扩展的 4×RK1828 多卡级联方案,并完成了对 Gemma-4、Qwen3.5/Qwen3.8 系列模型的实测。实测数据现已出炉,这不是简单的硬件堆叠,而是边缘侧大模型推理能力的一次实质性提升。
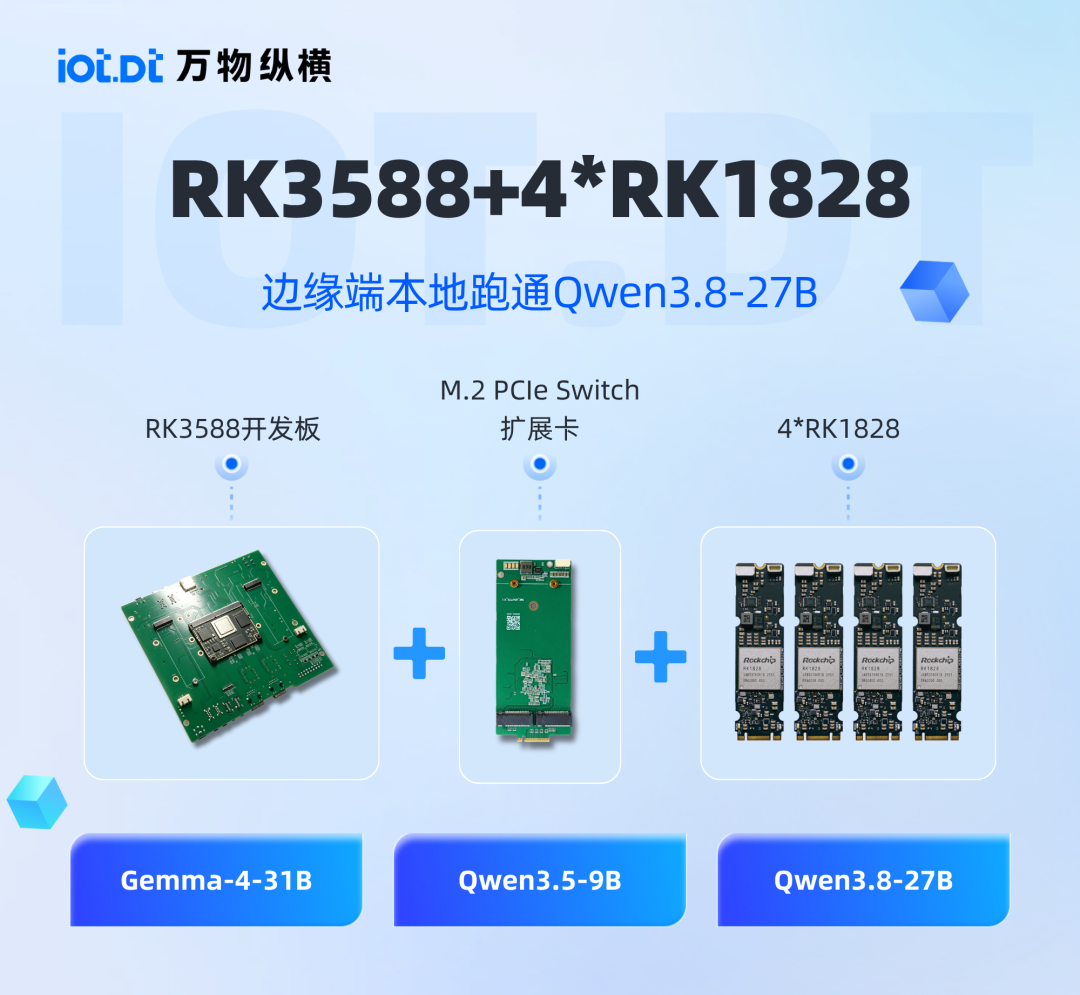
一、硬核架构:PCIe Switch 赋能四卡互联
要实现 4 张 AI 算力卡的稳定并行,普通的扩展方式难以满足带宽和信号完整性的要求。万物纵横的方案采用了专业的 PCIe Switch 扩展架构。
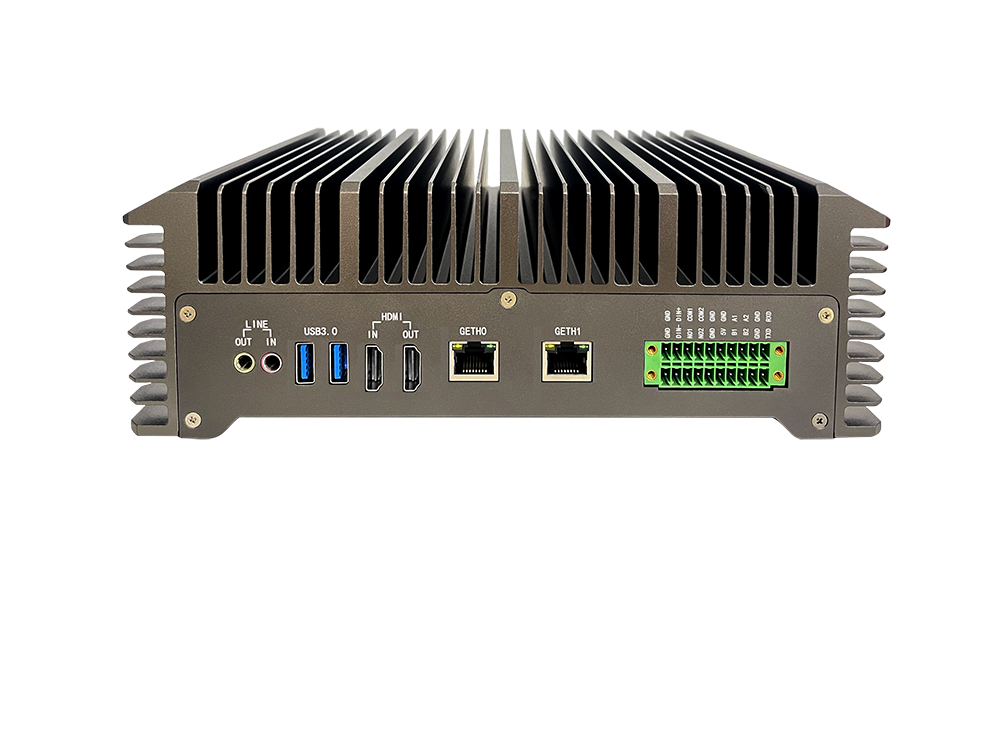
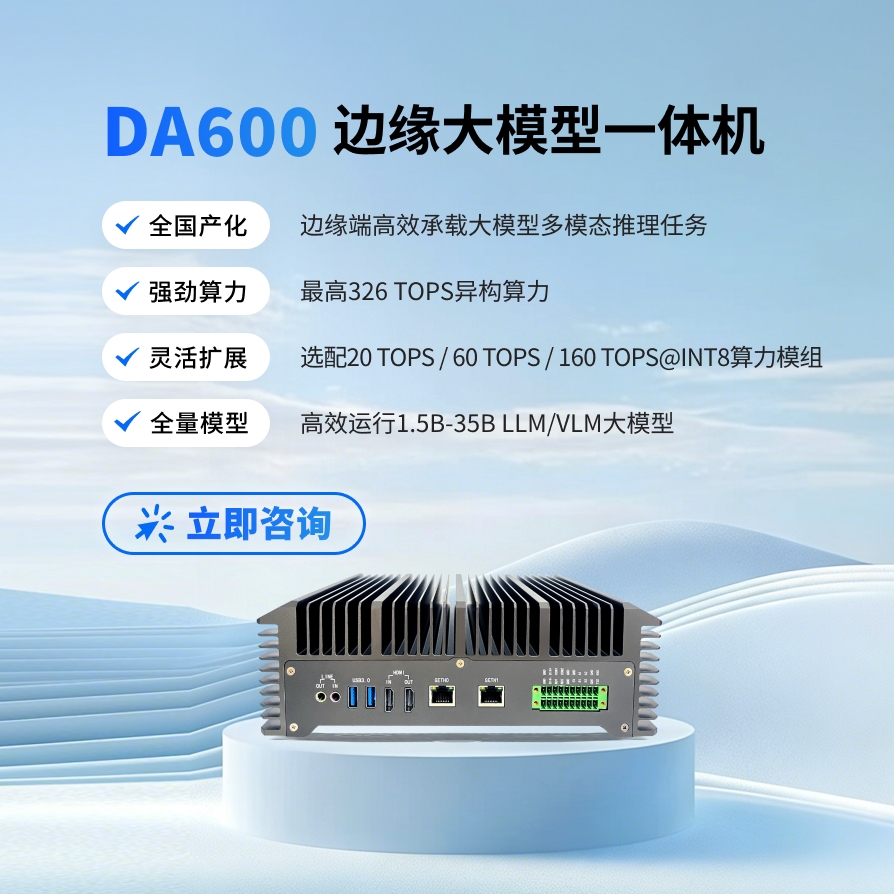
该方案以高性能 RK3588 开发板为核心主控,通过定制的 PCIe Switch 扩展卡,同时挂载 4 张 RK1828 AI 算力加速卡。
高带宽互联:主控与4张加速卡之间、以及卡与卡之间的数据交换保持低延迟,减少阻塞。
统一调度:配合瑞芯微 SDK 1.1.0,可将大模型切分并分配到4个计算单元上协同工作。
扩展灵活:相比普通直连,Switch 架构为未来更复杂的拓扑预留了空间。
二、实测数据:9B 流畅,27B 可用
本次实测条件为 Input Tokens: 5120, New Tokens: 128,测试结果如下:
模型名称 | 加速芯片 | TTFT (ms) | TPOT (ms) | Decode TPS |
Gemma-4-12B | 2× RK1828 | 7576.88 | 31.85 | 31.4 |
Gemma-4-31B | 4× RK1828 | 9077.22 | 70.03 | 14.28 |
Qwen3.5-9B | 2× RK1828 | 5910.11 | 30.23 | 33.08 |
Qwen3.5-27B | 4× RK1828 | 8718.15 | 76.57 | 13.06 |
Qwen3.8-27B | 4× RK1828 | 8699.48 | 76.45 | 13.08 |
1. 挑战超大参数:Gemma-4-31B(4卡)
31B 参数量级的模型,过去通常依赖服务器级显卡。在万物纵横 4 卡方案下,Decode TPS 达到 14.28 tokens/s,首字延迟控制在 9 秒左右。这意味着在边缘端本地部署 30B 级别模型,并保持可用的交互速度,已经成为可能。相比之下,双卡配置在加载该类模型时往往速度极慢,难以满足流畅交互需求。
2. 主流黄金尺寸:Qwen3.5-27B / Qwen3.8-27B(4卡)
27B 是目前开源界兼顾智能与速度的“黄金尺寸”。Qwen3.5-27B 的 Decode TPS 达到 13.06 tokens/s,Qwen3.8-27B 为 13.08 tokens/s,TPOT 约 76ms。这一速度可以满足实时对话、文档摘要等应用场景的需求。
3. 越级表现:Qwen3.5-9B & Gemma-4-12B(2卡)
用双卡跑 9B 或 12B 中型模型时,性能表现更为突出:
Qwen3.5-9B
:Decode TPS 达到 33.08 tokens/s,首字延迟仅约 5.9 秒。
Gemma-4-12B
:Decode TPS 为 31.4 tokens/s。
这种响应速度在部分交互场景下已经接近云端 API 的体验,适合对实时性要求较高的本地应用。
三、方案优势与应用前景
万物纵横的 RK3588 + PCIe Switch + 4×RK1828 方案,为边缘计算解锁了更多可能性:
私有化大模型部署:企业可以在本地运行 27B-30B 级别的私有知识库模型,数据不出域,安全可控。
复杂多模态任务:更充裕的显存和算力,可支持更复杂的 Vision-Language 任务。
高性价比选择:相比购买服务器级 GPU 方案,该方案在满足中等参数模型推理需求的同时,提供了更具竞争力的成本结构。
随着瑞芯微 SDK 的持续迭代(如 V1.1.0 版本对多卡级联的优化),软硬件结合的生态正在逐步成熟。万物纵横此次展示的 4 卡级联方案,为边缘 AI 开发者提供了一个兼顾性能与灵活性的新选择。
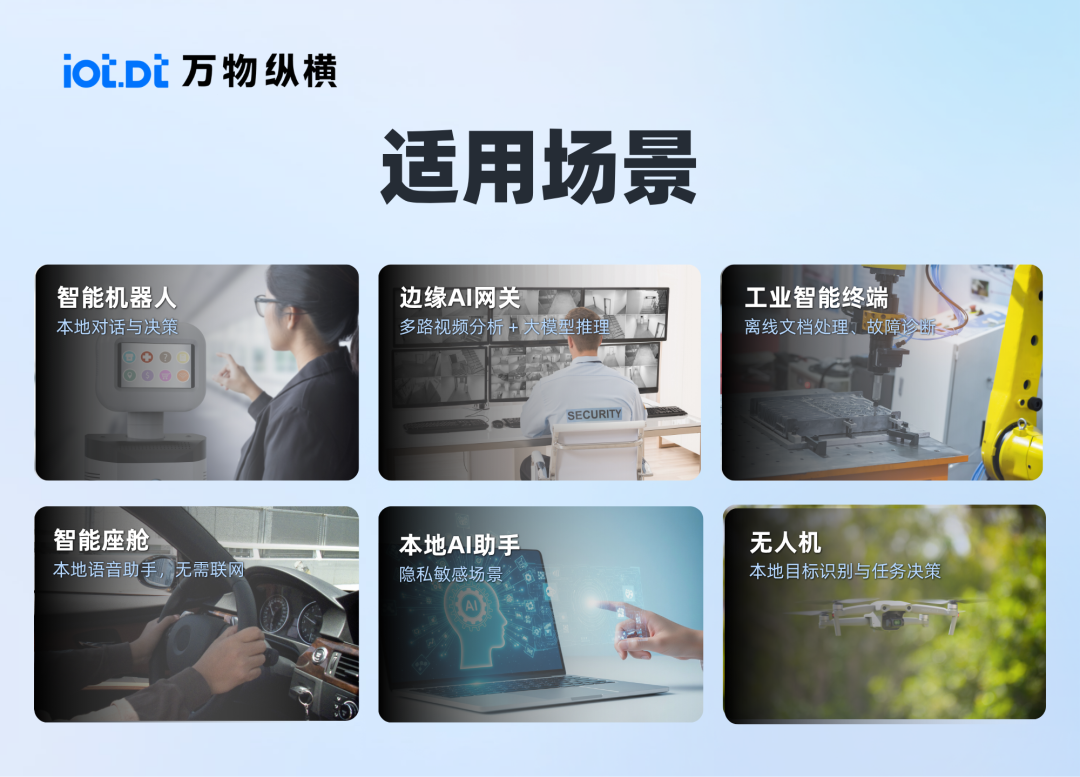
四、适用场景该方案
适合需要“中等参数规模模型 + 视觉 AI + 本地计算”协同的中高阶端侧设备。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部

 商城