
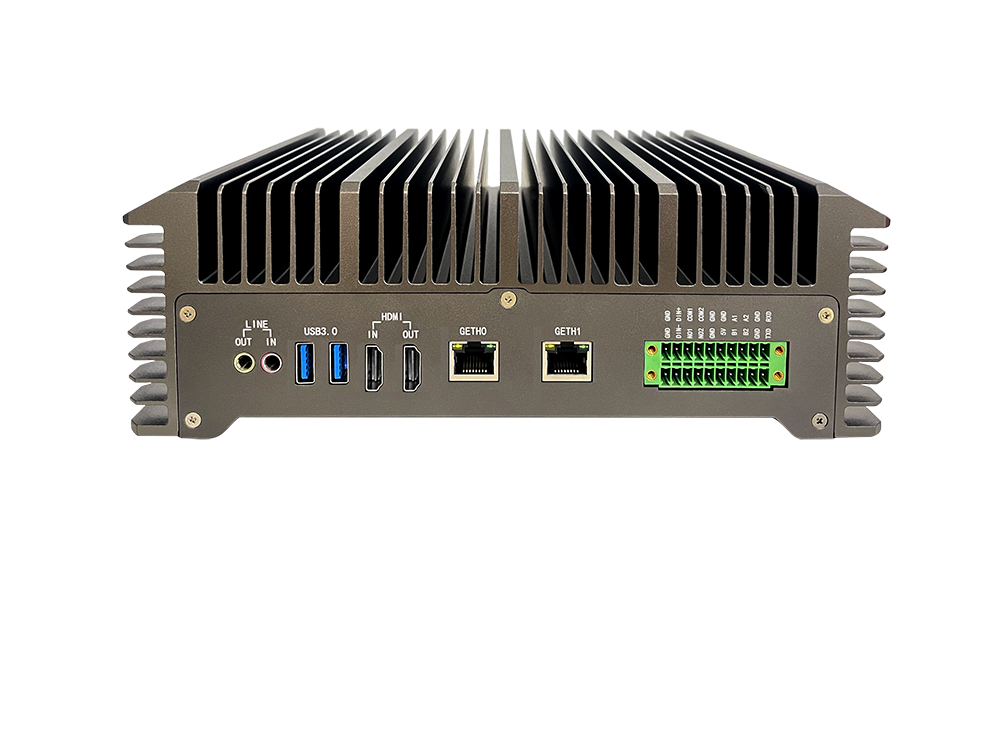
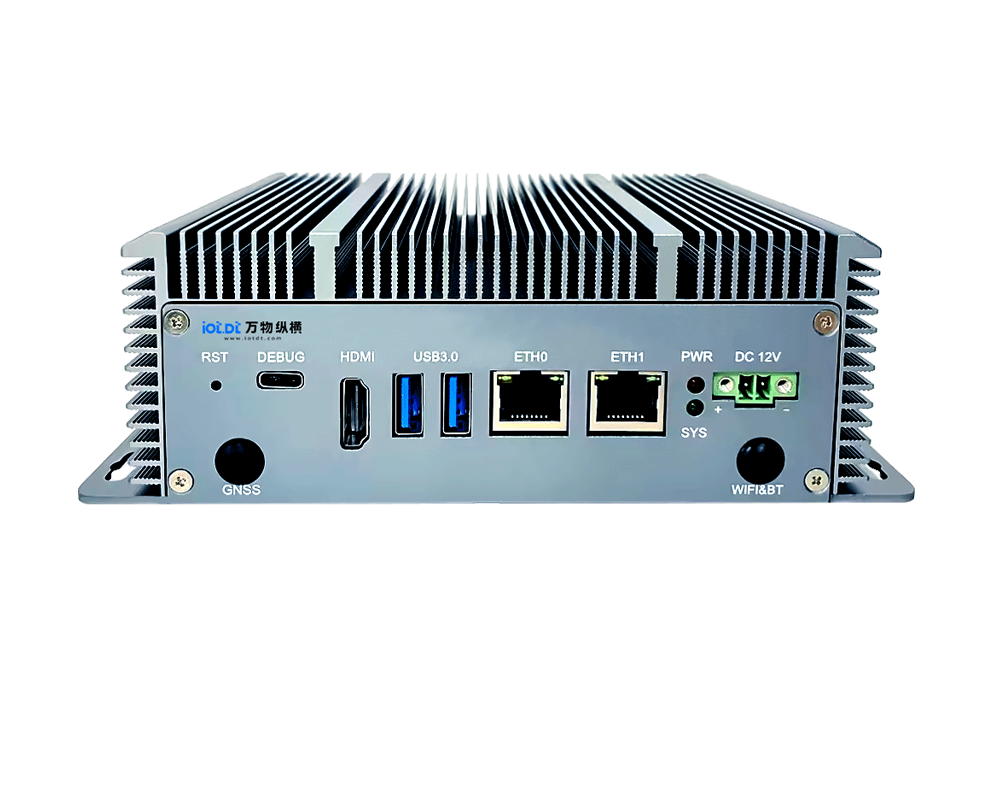
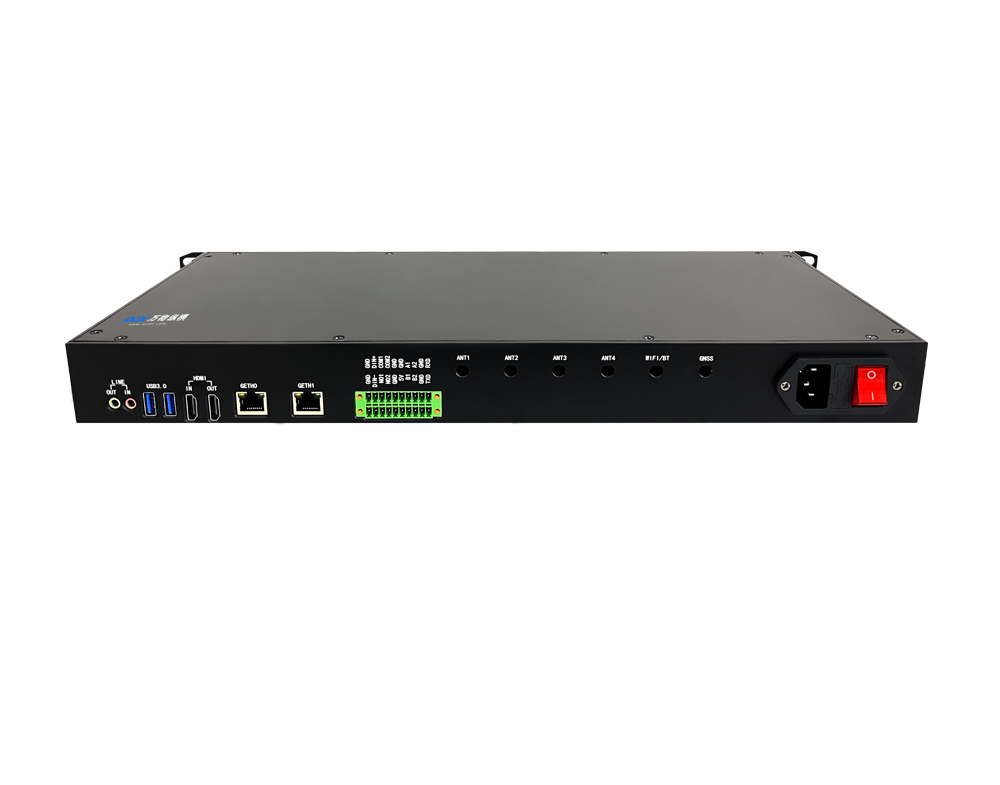
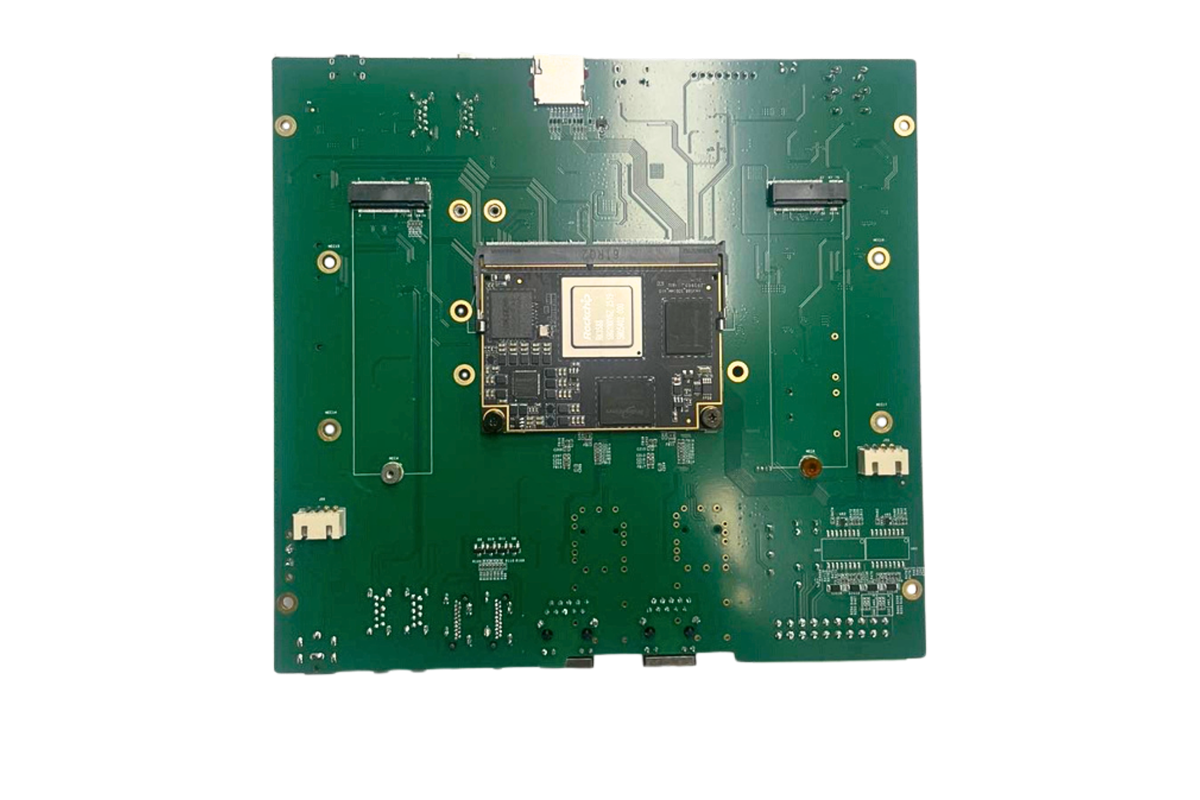
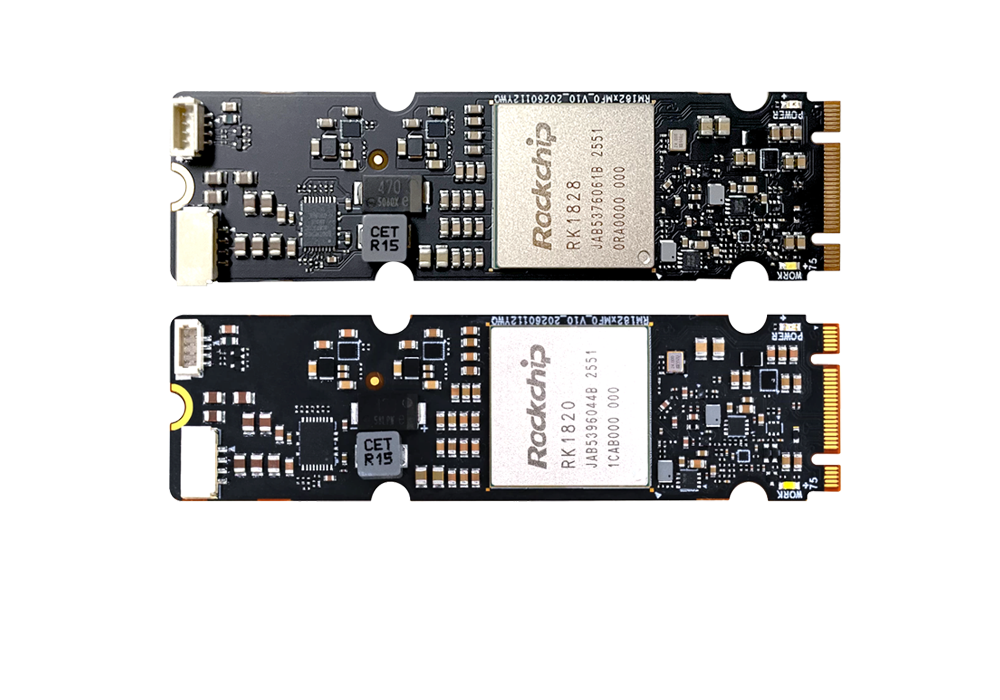


边缘 AI 盒子、算力盒子(RK3588/BM1684X/LQ50等硬件平台)项目交付场景越来越复杂:多算法并行、模型版本迭代、现场环境差异大、客户现场运维能力弱。传统裸机部署(直接在系统装算法、依赖库)存在环境冲突、升级麻烦、迁移困难,Docker 容器化交付快速成为集成商落地项目的标准方案。
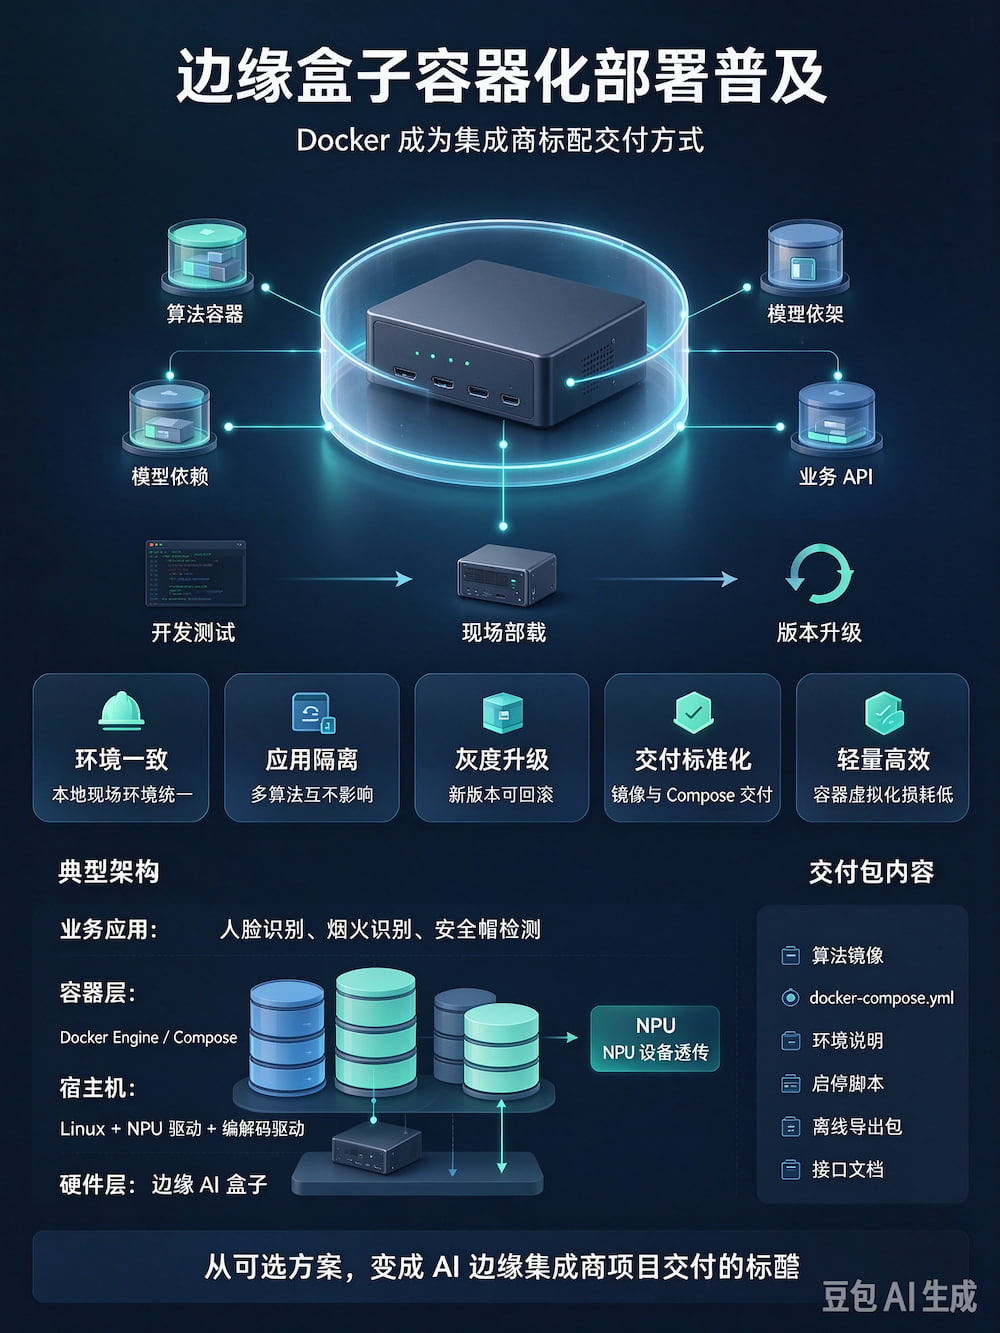
一、为什么边缘盒子开始标配 Docker 交付
1. 环境一致性,解决 “本地能跑,现场不行”
把算法、推理框架、依赖库、模型一起打包进容器镜像。开发、测试、现场盒子运行环境完全一致,规避系统版本、驱动、Python 包版本冲突问题,大幅降低现场调试返工。
边缘硬件异构:ARM 瑞芯微、算能、力擎等芯片架构差异大,容器镜像可针对芯片构建,一套打包流程,批量下发到同型号边缘盒子。
2. 应用隔离,多算法在同一盒子共存
一个边缘盒子常同时跑人脸识别、烟火识别、明厨亮灶、工地安全帽等多个 VLM / 检测算法。容器互相隔离,A 算法崩溃不会影响 B 算法;资源可做 CPU、内存、算力限额,防止单进程占满硬件资源。
3. 版本管理与灰度升级
镜像版本化管理,算法更新只推送新镜像,不需要现场重装系统;支持回滚,新版本异常可一键切回旧镜像。适合大量分布式边缘节点批量运维。
4. 交付标准化,降低集成商实施成本
集成商不再给客户交付一堆脚本、安装包。直接交付镜像 + 启动 compose 配置文件,现场人员只需要拉取镜像、启动容器,交付文档统一,减少技术交底工作量。
5. 适配边缘轻量场景
Docker 本身开销低,边缘盒子算力有限,对比虚拟机,容器几乎无额外虚拟化损耗,适合低功耗边缘硬件。
二、边缘盒子 Docker 交付的典型架构
宿主机:Linux(Ubuntu/Debian),保留硬件驱动(NPU 驱动、编解码驱动)
Docker Engine:宿主机安装,容器通过--device透传 NPU、视频编解码硬件
容器内部:推理服务(TensorRT/TPU-SDK/BMNN/RKNN)+ 业务 API 服务
编排:单盒子多服务一般用 Docker Compose(轻量,边缘首选);大规模集群节点可选 K3s,不适合小单盒。
镜像仓库:自建私有镜像仓库,用来存放算法镜像,批量下发到各地边缘盒子。
重点:边缘容器不能完全硬件隔离,必须透传 NPU 设备,这是和云端容器最大区别。
三、当前落地痛点(集成商真实踩坑点)
1. 异构硬件镜像不能通用
RK、算能、力擎芯片驱动不同,镜像不能跨硬件直接迁移,需要按硬件平台分别构建镜像。
2. NPU 透传、视频流硬编解码兼容性
容器权限、设备挂载参数配置不当,会出现 NPU 无法调用、视频解码失败。
3. 镜像体积偏大
打包模型 + 推理库后镜像几个 GB,边缘现场带宽差,镜像拉取慢;需要镜像分层、模型外置、多阶段构建瘦身。
4. 容器日志、持久化存储
容器默认删除后数据丢失,业务图片、告警记录需要挂载宿主机目录持久化。
5. 安全与资源限制
边缘盒子暴露外网时,容器权限管控容易被忽略;多容器抢占 NPU 算力,需要做好算力调度。
四、集成商标配交付包一般包含什么
1. Docker 镜像(算法推理服务)
2. docker-compose.yml 启动配置(NPU 挂载、端口、资源限制)
3. 环境说明文档(宿主机系统版本、驱动版本)
4. 一键启动 / 停止 / 重启脚本
5. 镜像导出包(离线交付,客户内网无外网仓库场景)
6. 接口文档(HTTP/RTSP 接入、告警回调接口)
五、发展趋势
1. Docker Compose 仍是边缘单盒主流;K3s 用于几十上百台盒子的集群项目。
2. 更多厂商开始采用 OCI 标准镜像,不限于 Docker runtime(containerd)。
3. 镜像轻量化、模型外置、差分镜像推送成为优化方向,解决边缘弱网问题。
4. 容器化交付会从 AI 算法盒子,扩散到工业网关、物联网采集盒子等更多边缘硬件。
总结
边缘项目现场环境复杂、批量节点运维压力大,Docker 容器化把算法业务和底层硬件环境解耦,实现打包交付、一键部署、快速回滚,已经从可选方案,变成 AI 边缘集成商项目交付的标配。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部