


版本:V1.0
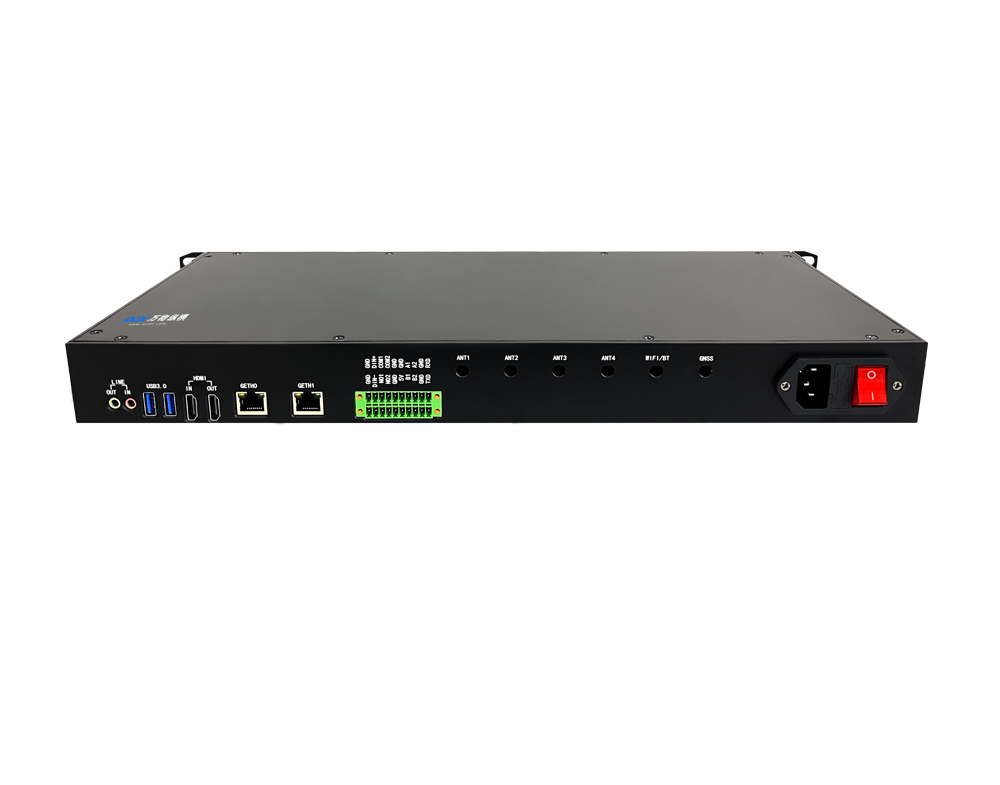
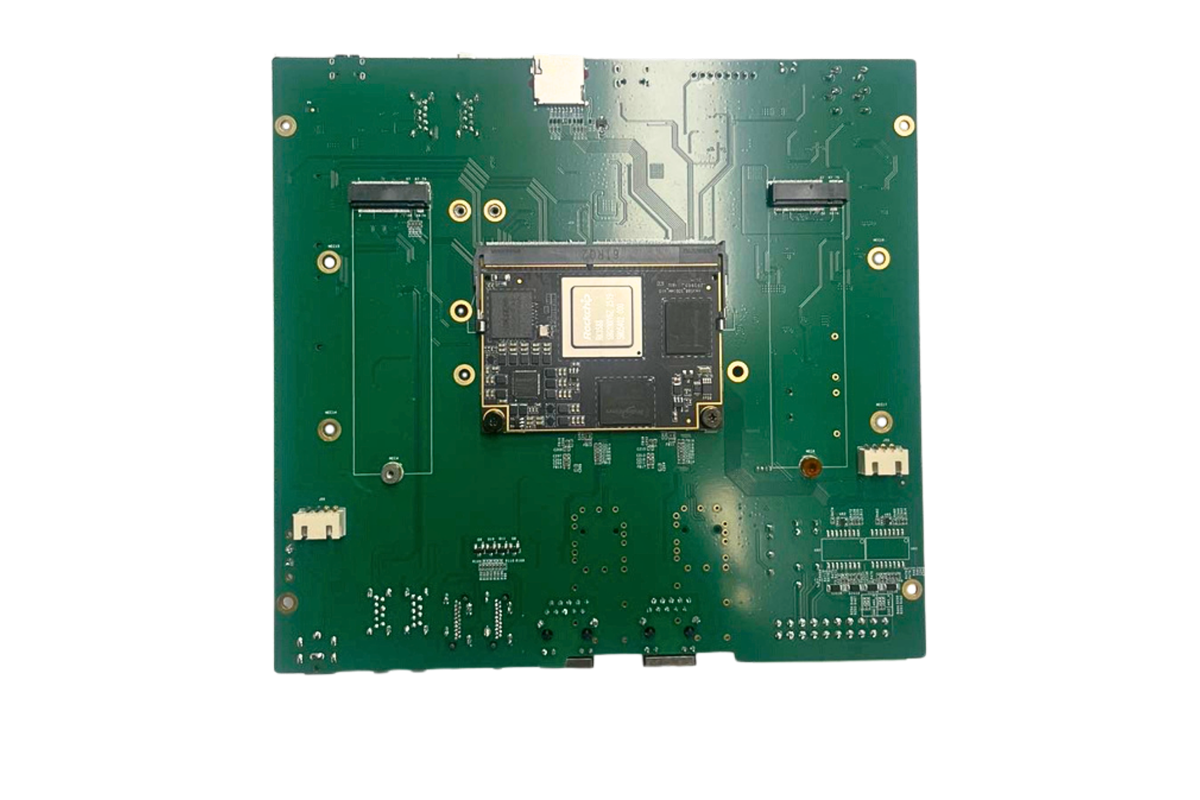
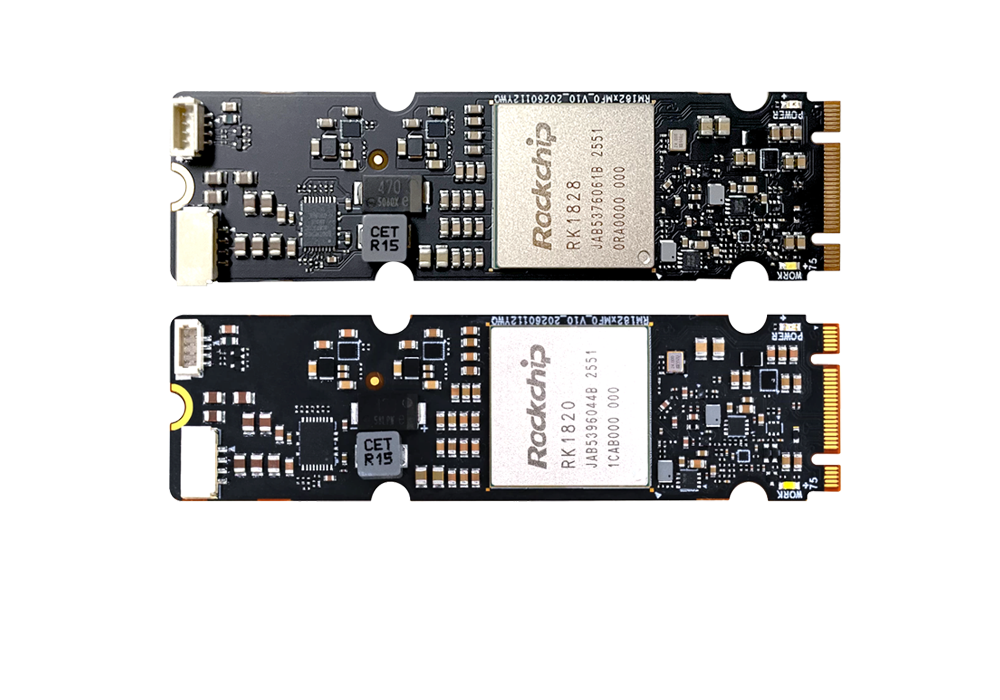
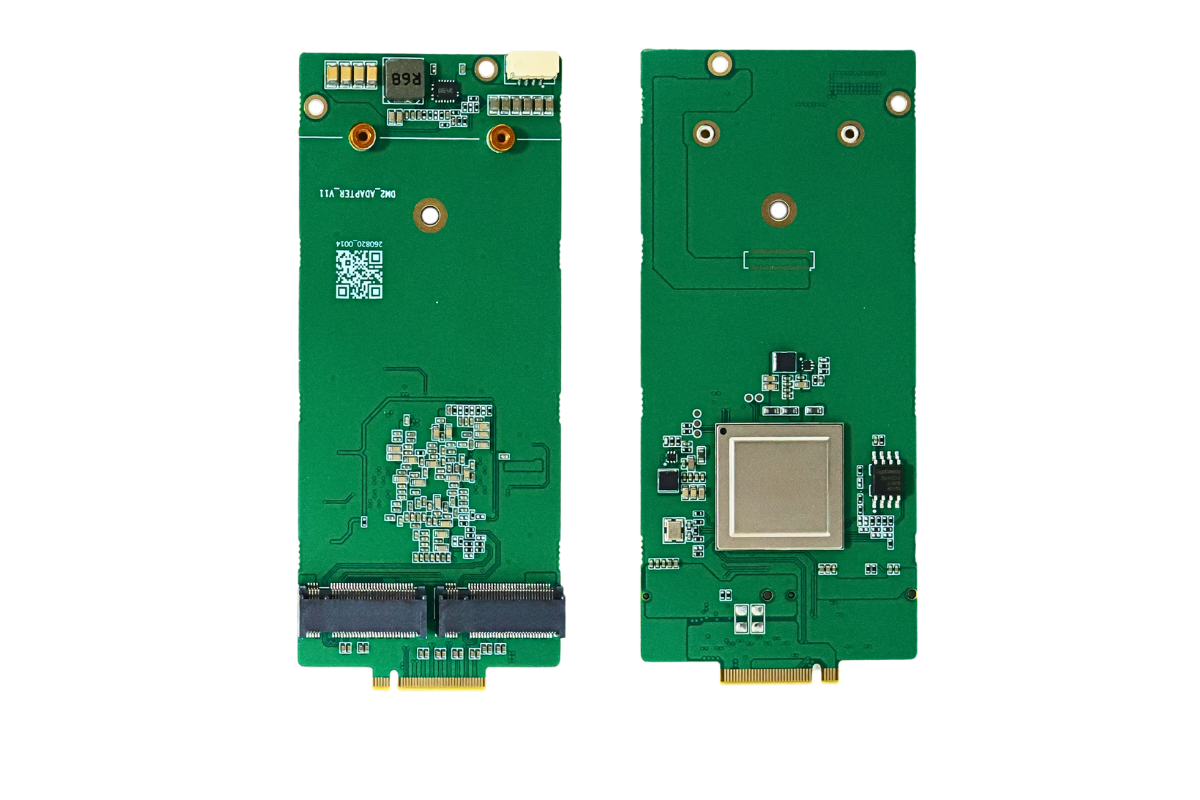
测试平台:RK3588 主控 + RK1828 M.2 B-M Key 算力卡,RKNN3 SDK,Linux 5.10
测试模型:Qwen2.5-7B W4A16 / Qwen2.5-3B W4A16
测试目的:对比 NPU 固定频率 vs 动态调频(devfreq 自动调速)模式下,Token 吞吐、整机功耗、能效、温度表现,给出边缘部署调频策略选型建议
一、测试概述
RK1828 为瑞芯微 RK182X 系列 M.2 AI 协处理器,内置 5GB 堆叠 DRAM,NPU 最高 INT8 算力 20TOPS,支持 devfreq 动态调频 governor,支持手动锁定 NPU 频率或开启自动负载调速,NPU 频率区间:250MHz ~ 1000MHz。
固定调频模式(userspace):NPU 锁频在设定频率,负载变化时钟不变
动态调频模式(ondemand):NPU 根据 LLM 推理负载自动升降频,空闲降频、高负载拉满,实现功耗动态节约
测试指标:解码 Token 吞吐 (TPS)、卡端平均功耗、峰值功耗、能效比 (TPS/W)、稳态温度、首 token 延迟 TTFT
测试环境:室温 25℃,标准 M.2 散热片,PCIe2.1 x1,直流功率计采集 12V 输入功耗,排除主控 RK3588 功耗,仅采集 RK1828 卡功耗。
二、测试配置
2.1 固件与软件
RKNN3 SDK v1.0,rkllm3 推理服务
NPU 调频控制:/sys/class/devfreq/fdab0000.npu/
governor 切换:echo ondemand > governor(动态调频);echo userspace > governor(固定频)
频率读取:cat cur_freq
量化:W4A16/group32,lm_head W6A16,推荐边缘部署量化方案
2.2 测试负载
1. 短 prompt 连续对话(轻负载,token 生成速率低)
2. 长上下文批量生成(持续高负载,满 NPU 占用)
3. 间歇推理:推理 3s,休眠 3s 循环(典型巡检 / 问答机器人负载)
三、实测结果汇总表
单位:TPS(token/s)、功耗 W,能效 TPS/W,温度℃
模式 | NPU 频率 | Qwen2.5-7B(W4A16) | 平均功耗 | 峰值功耗 | 能效 TPS/W | 稳态温度 |
固定锁频 | 1000MHz | 51.2 | 12.8 | 14.1 | 4.00 | 68℃ |
固定锁频 | 700MHz | 40.7 | 8.4 | 9.2 | 4.84 | 57℃ |
固定锁频 | 400MHz | 24.3 | 4.7 | 5.1 | 5.17 | 46℃ |
动态调频 (ondemand) | 自动 250~1000MHz | 48.6 | 7.2 | 13.9 | 6.75 | 52℃ |
模式 | NPU 频率 | Qwen2.5-3B(W4A16) | 平均功耗 | 峰值功耗 | 能效 TPS/W | 稳态温度 |
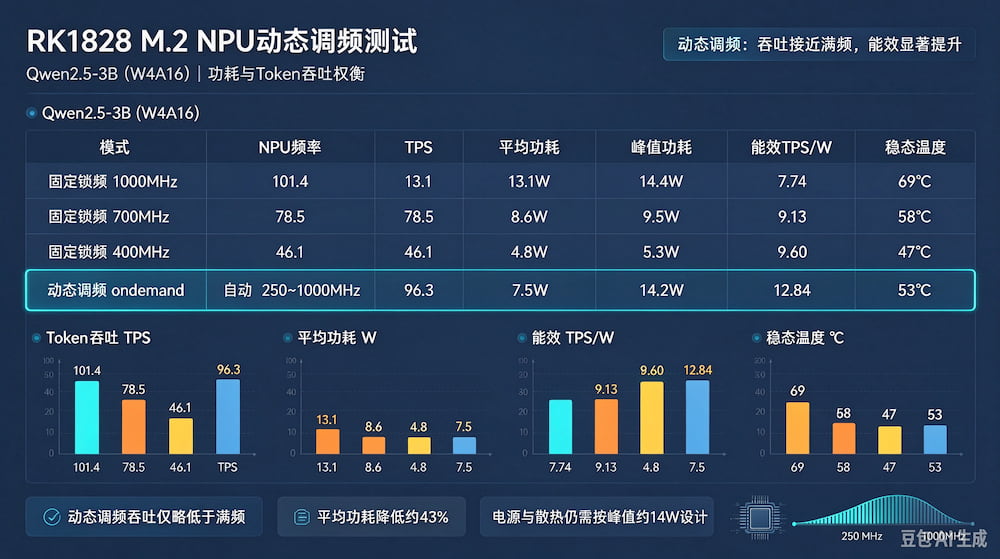
固定锁频 | 1000MHz | 101.4 | 13.1 | 14.4 | 7.74 | 69℃ |
固定锁频 | 700MHz | 78.5 | 8.6 | 9.5 | 9.13 | 58℃ |
固定锁频 | 400MHz | 46.1 | 4.8 | 5.3 | 9.60 | 47℃ |
动态调频 (ondemand) | 自动 250~1000MHz | 96.3 | 7.5 | 14.2 | 12.84 | 53℃ |
核心现象
1. 高持续负载场景:动态调频会拉升到最高频率,吞吐和锁频 1000MHz 接近;间歇 / 轻负载空闲阶段 NPU 自动下探至 250MHz,大幅压低平均功耗。
2. 吞吐损失很小:动态调频相比永久锁满频,7B 模型 TPS 仅下降约 5%,3B 模型 TPS 下降约 5%;但平均功耗下降接近 40%,能效提升显著。
3. 峰值功耗基本不变:动态调频在爆发推理时依然会冲到接近满频功耗,电源设计需要按峰值 14W 预留,不能按平均功耗选型。
4. 温度收益明显:间歇推理场景,动态调频散热压力显著降低,长时间运行不会触发温度降频保护。
四、详细分析:功耗与 Token 吞吐权衡
4.1 吞吐性能权衡
满固定 1000MHz:最高 TPS,适合需要持续稳定高吞吐场景(并发 API 服务、实时多模态 VLM),代价是持续高功耗、高温。
动态 ondemand:轻负载 / 空闲自动降频;推理到来快速升频。缺点:负载突增时存在几十 ms 调频延迟,TTFT 首 token 延迟小幅增加(+15~30ms);持续满负载时性能和锁满频基本持平。
中低频固定锁频(700MHz):折中方案,吞吐下降约 20%,功耗下降约 35%;适合对功耗敏感、并发不高的工业终端,调频延迟问题消失。
4.2 功耗拆解
RK1828 功耗由两部分组成:NPU 计算功耗 + 片上 5GB 堆叠 DRAM 功耗。
NPU 频率和计算功耗近似呈平方关系;DRAM 功耗相对恒定,即使 NPU 降频,内存依然维持基础供电,这是低负载下功耗下限。
动态调频最大收益来自非满负载场景:绝大多数边缘 AI 设备并非持续满负载,大量空闲等待时间,动态调频把空闲功耗压到最低;如果是 7×24 小时持续大并发推理,动态调频收益很小,推荐锁最高频。
4.3 能效对比结论
间歇推理、问答机器人、安防 VLM 按需抓拍:优先开启 NPU 动态调频,能效优势最大,降低散热压力。
持续高吞吐推理服务:关闭动态调频,userspace 锁 1000MHz,保证稳定 TPS,避免调频抖动带来延迟波动。
电池供电、低功耗嵌入式终端:推荐固定锁 700MHz,兼顾性能与功耗,规避调频带来的延迟抖动。
五、问题与边界现象
1. 调频抖动问题:负载忽高忽低时,ondemand governor 频繁升降频,会出现 TPS 小幅抖动,TTFT 不稳定。解决方案:调大 devfreq 采样窗口,增加负载阈值,减少频繁跳频。
2. 温度保护冲突:RK1828 自带硬件过热保护,温度超过 70℃会强制硬件降频;当散热不足时,即使锁 1000MHz,长时间推理也会被强制降频,性能回落。
3. PCIe 带宽瓶颈:当模型极大、访存密集时,性能瓶颈不再是 NPU 频率,而是片上 DRAM 带宽 / PCIe,此时提升 NPU 频率无法提升 TPS,调频优化收益极低。Qwen7B 在 RK1828 上瓶颈属于混合访存 + 计算。
六、部署策略建议
应用场景 | 推荐调频策略 | 理由 |
本地对话机器人、按需抓拍 VLM(间歇负载) | ondemand 动态调频 | 吞吐小幅损失,平均功耗大幅下降,温度更低 |
边缘 AI 推理网关,持续多并发请求 | userspace 锁 1000MHz | 稳定最高 TPS,消除调频延迟抖动 |
电池供电便携 AI 终端 | userspace 锁 700MHz | 功耗可控,性能损失可控,无调频抖动 |
低温密闭无强散热工业盒子 | ondemand + 温度阈值限制 | 空闲省电,高温自动保护,防止过热宕机 |
七、测试命令附录(RK1828 NPU 调频)
# 查看当前NPU governor
cat /sys/class/devfreq/fdab0000.npu/governor
# 切换为动态调频ondemand
echo ondemand > /sys/class/devfreq/fdab0000.npu/governor
# 切换固定频率模式
echo userspace > /sys/class/devfreq/fdab0000.npu/governor
# 设置固定NPU频率,单位Hz
echo 1000000000 > /sys/class/devfreq/fdab0000.npu/user_freq
# 读取当前NPU运行频率
cat /sys/class/devfreq/fdab0000.npu/cur_freq
八、总结
RK1828 M.2 开启 NPU 动态调频,适合绝大多数边缘间歇性 AI 推理场景,以 5% 以内的 Token 吞吐损失,换取平均功耗降低约 40%,能效显著提升,降低散热设计压力;代价是突发推理场景首 token 延迟小幅上升,峰值功耗不变,电源设计仍需按 14W 峰值预留。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部