


一、痛点本质:不是硬件问题,是规模化交付后的运维转移
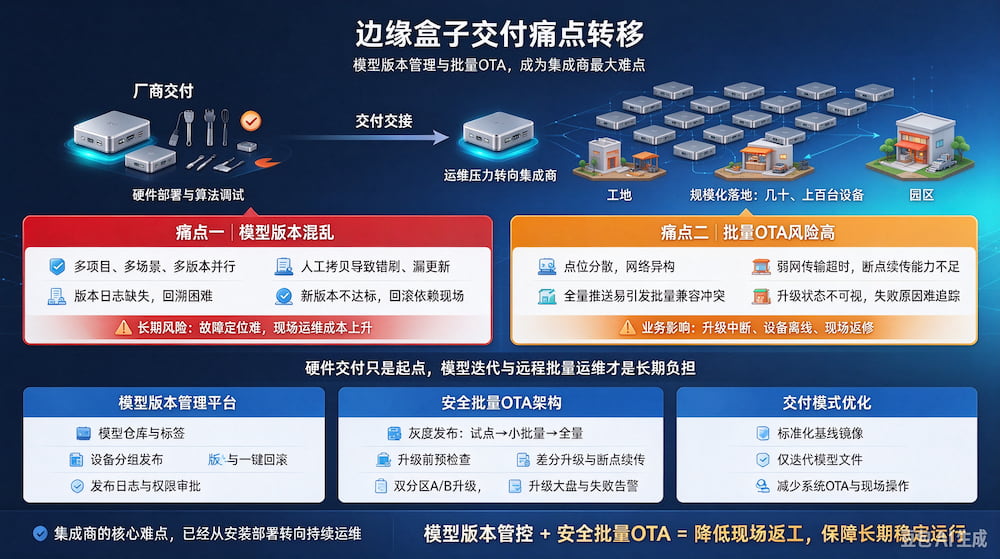
边缘 AI 盒子项目前期硬件部署、算法调试一般由厂商完成;交付给集成商之后,大量运维压力转移到集成商侧。
集成商往往缺少专业 AI 模型运维团队,项目一旦落地几十、上百台边缘盒子,两大难题会快速放大:
1. 模型版本混乱:现场多批次盒子、不同场景(工地 / 明厨亮灶 / 园区)跑不同版本模型;现场人工拷贝模型极易出现版本错刷、漏更新,出问题难以回溯,故障盒子定位困难。
2. 批量 OTA 风险高:边缘设备大多分布在分散点位,网络环境参差不齐(4G / 弱网 / 内网隔离)。批量升级容易出现:升级中断变砖、部分设备升级失败、新旧模型兼容冲突;一旦批量翻车,集成商需要派人到现场返修,成本极高。
一句话总结:硬件交付只是起点,模型迭代 + 远程批量运维,才是集成商最头疼的长期负担。
二、拆解两大核心难点
难点 1:模型版本管理
模型包体积大,包含权重、推理配置、后处理脚本,不只是单纯版本号;
多项目并行,A 项目 v1.2 模型不能误更到 B 项目设备;缺少设备分组、版本灰度、发布审批机制;
缺少版本日志:无法快速查询某台设备当前模型版本、什么时候更新、谁发布;现场出问题很难复现;
回滚困难:新版本模型效果不达标,不能一键切回旧版本,只能现场操作。
难点 2:批量 OTA 升级
1. 网络异构:部分设备在内网,不能直接公网拉包;弱网环境下大模型包传输超时、断点续传差;
2. 升级风险不可控:全量推送,一旦模型和硬件驱动、推理框架不兼容,批量宕机;缺少灰度发布(先升级 10% 试点设备);
3. 升级状态难监控:几百台盒子同时升级,哪些成功、哪些失败、失败原因看不到;
4. 设备资源冲突:升级过程占用算力、内存,打断正在运行的 AI 业务,影响现场业务。
三、集成商侧衍生连锁问题
1. 项目验收后持续的现场运维人力成本飙升;
2. 客户投诉变多:算法效果不稳定、设备离线;
3. 项目利润被后期现场维护吃掉;
4. 多项目复用困难:一套盒子方案,换场景就要重新做模型分发流程。
四、可行解决方案方向
1. 模型版本管理平台
模型仓库:模型包统一托管,打标签(项目、场景、硬件型号、版本号);
设备分组:按项目 / 点位分组,模型发布只推送给指定分组;
版本能力:版本对比、一键回滚、发布日志、模型 MD5 校验,防止包损坏;
权限管控:模型上传、发布审批,避免误操作。
2. 安全批量 OTA 架构
支持灰度发布:试点→小批量→全量;升级前做设备预检查(剩余磁盘、内存、在线状态);
断点续传、差分升级:模型只下发差异包,降低传输流量,适配 4G 弱网;
双分区 A/B 升级:升级失败自动切回旧分区,防设备变砖;
升级过程业务保护:支持业务暂停 / 续跑,避免业务中断;
升级大盘:实时看每台设备升级进度、失败原因告警。
3. 交付模式优化,减轻集成商压力
硬件厂商配套边缘设备管理平台,把模型仓库 + OTA 能力打包进方案,不用集成商自研;
交付阶段做标准化基线镜像:出厂固化基础系统 + 推理环境,后续只迭代模型文件,减少系统 OTA;
内网场景支持本地私有化部署管理节点,内网盒子从本地节点拉模型包,不用上公网。
五、总结
边缘 AI 项目交付重心从硬件部署转向远程运维;模型版本管控与安全批量 OTA,是降低集成商现场返工、保障项目长期稳定运行的核心能力。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部