
 商城
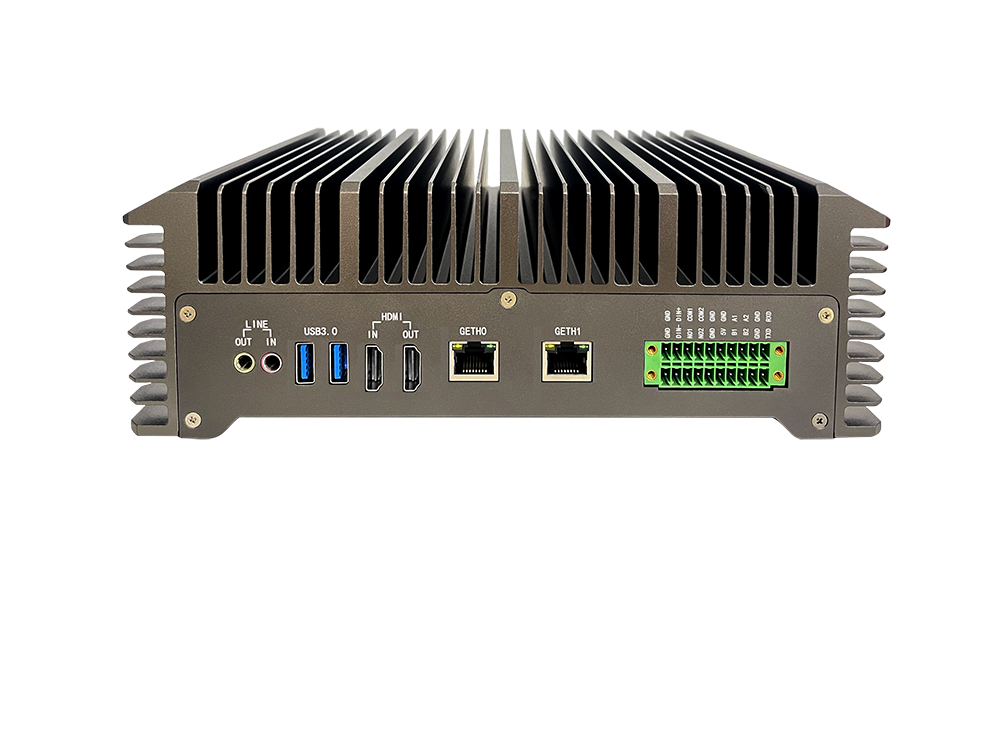
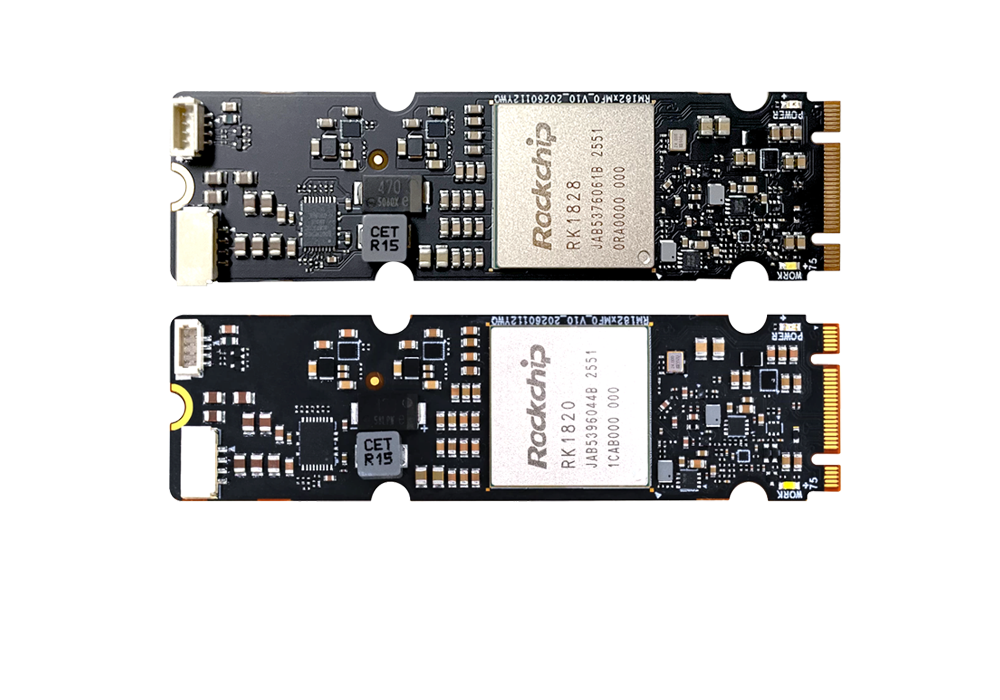
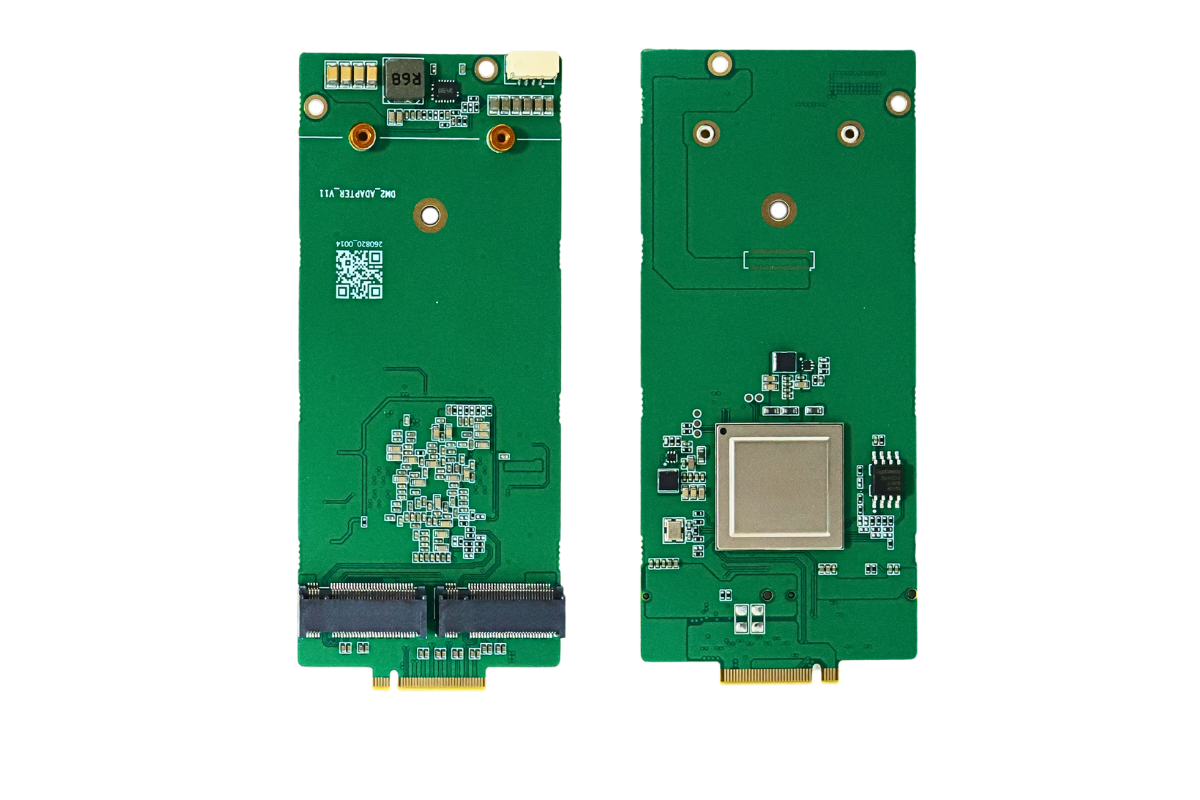


适用:搭载 RK3588/BM1684X / 摩尔线程 / 后摩等芯片的边缘盒子,从模型、算子、硬件调度、系统、业务5 个维度优化,优先做低成本改动。
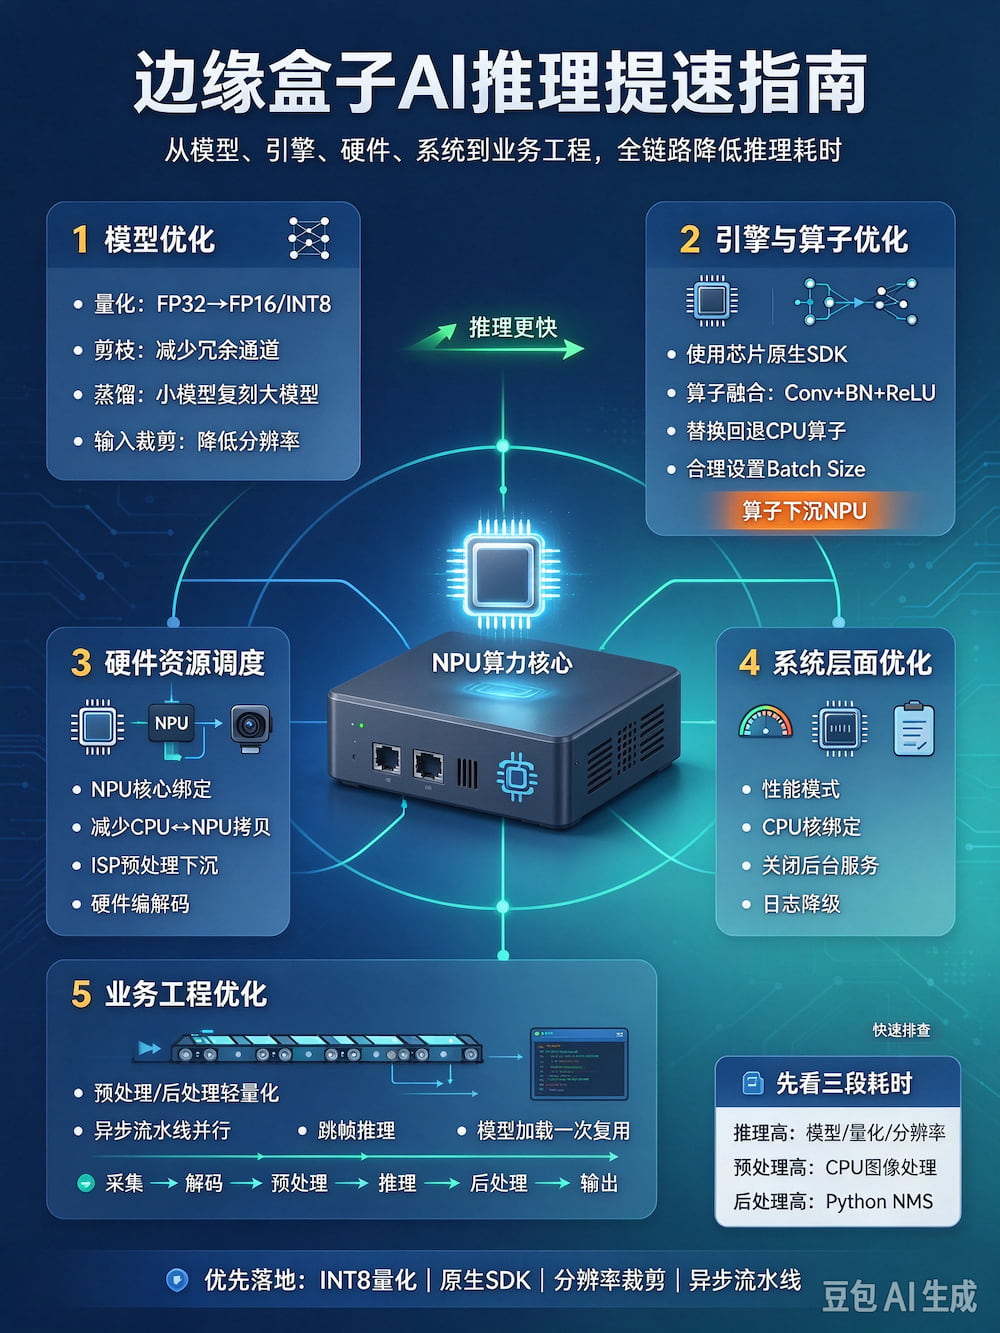
一、模型层面(收益最大,优先做)
1. 模型量化
FP32 → FP16/INT8,部分芯片支持 INT4,推理速度通常提升2~4 倍,功耗下降;
注意:INT8 要做校准,减少精度掉点,不要直接粗暴量化;
工具:RKNN Toolkit、BMNNSDK、ONNX Runtime、TensorRT、TorchAO。
2. 模型剪枝
剪掉冗余通道 / 层,减少参数量与计算量;适合模型过大、通道冗余的场景,一般提速 10%~50%。
3. 模型蒸馏
用大模型(教师)训练小模型(学生),小模型推理更快,尽量保住精度;适合检测、分类、VLM 视觉大模型。
4. 模型结构替换
换成更轻量骨干:MobileNet、ShuffleNet、YOLO-Nano、YOLOv8n、YOLOv10n,代替大版本 YOLO;VLM 选轻量化版本。
5. 输入分辨率裁剪
降低推理图分辨率(例如 640→416,416→320),算力消耗是平方级下降;前提业务可接受检测框不丢失。
坑:不要过小,小目标会漏检。
二、模型转换 & 推理引擎优化(边缘盒子重点)
1. 使用芯片原生 SDK
瑞芯微用 RKNN、算能用 BMNNSDK,不要直接跑 PyTorch/ONNX 原生推理,原生框架在 NPU 上几乎不加速,只跑 CPU。
核心:把模型编译成芯片专属离线模型(.rknn/.bmodel),算子下沉到 NPU。
2. 算子融合
编译时开启算子融合(Conv+BN+ReLU 合并),减少内存读写开销;大部分 SDK 默认开启,检查是否有不支持的算子导致回退 CPU。
3. 算子替换
遇到 NPU 不支持的算子,会回退 CPU,推理直接变慢几倍;
排查:看 SDK 日志,找到 unsupported op,替换为等价可支持算子。
4. 推理引擎参数调优
开启多线程、多 NPU 核;
设置合理 batch size:
单路视频:batch=1;多路可适当调大 batch,不要盲目拉满 batch,会增加首帧延迟。
三、硬件资源调度(边缘盒子特有)
1. NPU 负载绑定
多路任务时,手动绑定 NPU 核心,避免多个任务抢占同一 NPU 核造成排队;
如 RK3588 三 NPU、LQ50 双芯可以分配不同视频流到不同算力单元。
2. 内存优化(瓶颈高发点)
减少 CPU↔NPU 之间数据拷贝:尽量在 NPU 内存内完成图像预处理(resize、归一化、转颜色空间);
预处理放在 NPU 硬件 ISP / 硬件编解码,不要在 CPU 做 resize、色彩转换;
禁用不必要内存交换 swap,swap 会大幅拖慢推理。
3. 硬件编解码
视频流使用硬件 H.264/H.265 解码,把解码输出直接送到 NPU,避免 CPU 解码拷贝,多路视频场景提升明显。
四、系统层面优化
1. CPU 调频 & 性能模式
把盒子设置为性能模式,关闭节能降频;不要用 ondemand 动态调频,推理时频繁升频会增加耗时抖动。
2. 进程隔离、CPU 核绑定
预处理 / 后处理进程绑定指定 CPU 核心,避免和 NPU 推理进程争抢 CPU。
3. 关闭后台服务
关闭无关日志、数据库、远程服务,减少 CPU、内存抢占。
4. 日志降级
关闭 debug 级别打印,高频打印日志会占用 CPU,拉高单帧耗时。
五、业务工程优化(业务逻辑带来的耗时)
1. 预处理 / 后处理轻量化
不要用 Python 循环做解析、NMS;尽量把 NMS、解码放到 C/C++ 或 SDK 内置算子,Python 版后处理是常见瓶颈。
2. 异步流水线(最重要工程手段)
流水线拆分:视频采集 → 解码 → 预处理 → NPU推理 → 后处理 → 结果输出
异步并行,推理的同时采集下一帧,降低端到端延迟,提高 FPS;
同步串行会浪费 NPU 算力。
3. 跳帧策略
业务允许时,做跳帧推理(比如每 2 帧推理 1 次),适合目标变化缓慢场景;注意业务风险。
4. 缓存复用
重复静态背景、固定参数,避免重复初始化模型、重复申请内存;模型只加载一次,不要每帧加载。
快速排查瓶颈步骤(定位耗时在哪)
1. 打印分段耗时:采集 → 预处理 → 推理 → 后处理,定位瓶颈
推理耗时高:模型 / 量化 / 分辨率问题
预处理耗时高:CPU 做图,改用硬件 ISP/NPU 预处理
后处理耗时高:Python NMS,迁移 C++
2. 查看 NPU 利用率:看是否 NPU 跑满,还是卡在 CPU 拷贝
3. 查看日志:是否算子回退 CPU(最常见坑)
简单优先级清单(快速落地)
1. 模型 INT8 量化 + 芯片原生 SDK 编译
2. 降低输入图像分辨率
3. 预处理下沉硬件 ISP/NPU,减少 CPU 图像处理
4. 异步流水线,分离采集与推理
5. 算子排查,消除 CPU 回退算子
6. 系统设性能模式,关闭后台冗余服务
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部