
 商城
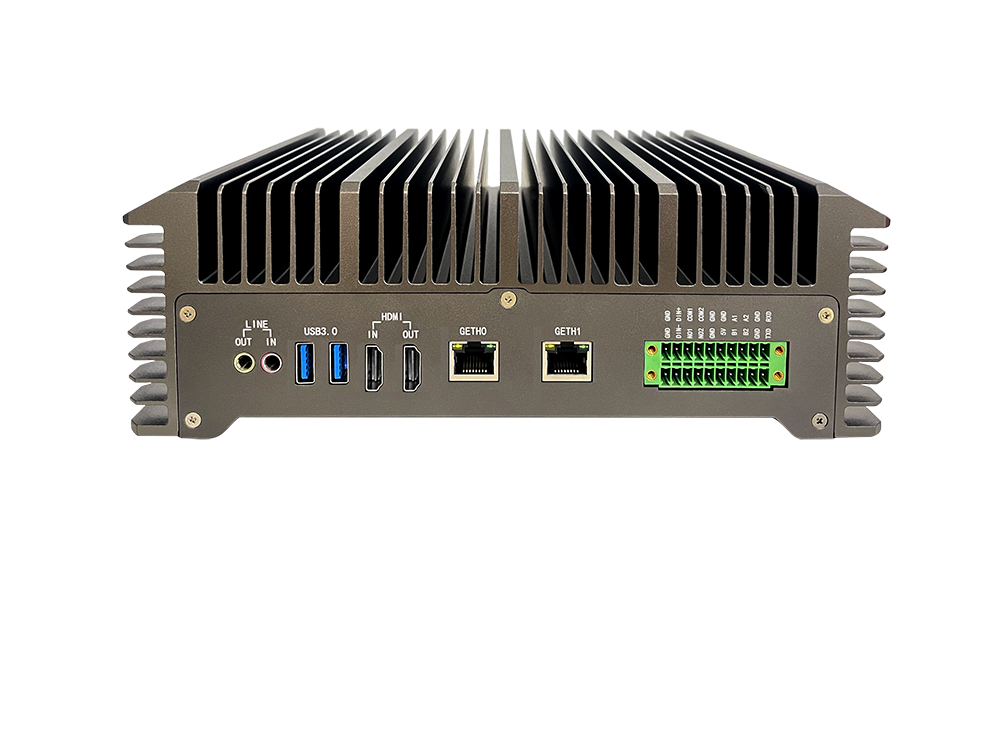
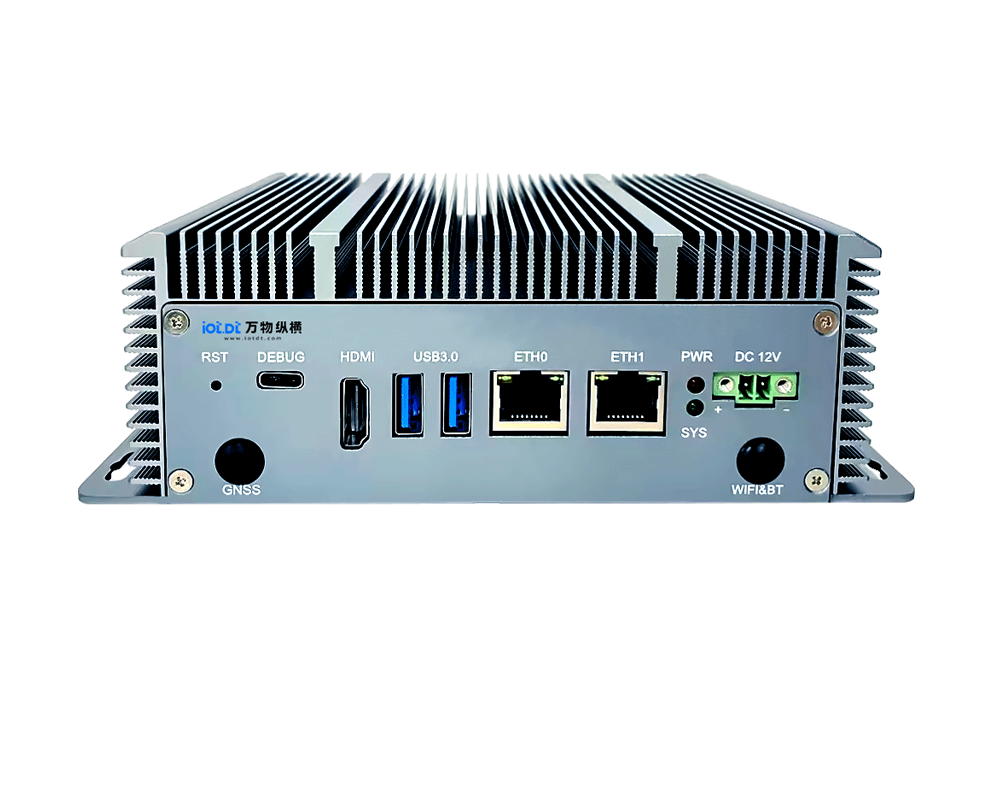
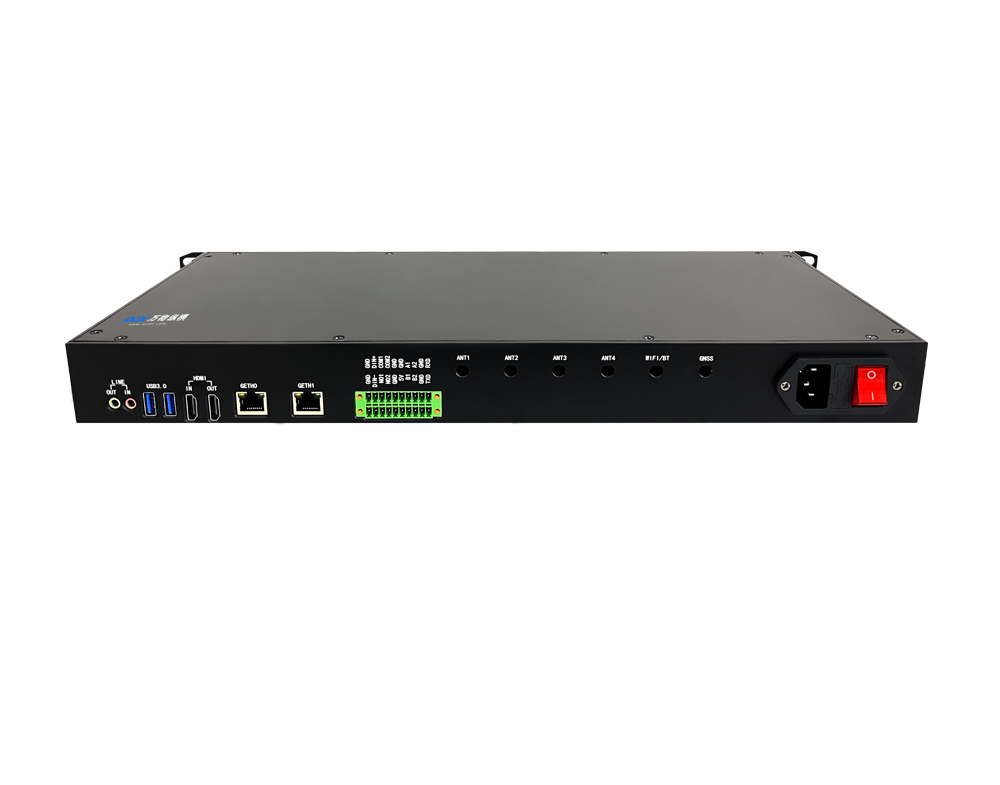
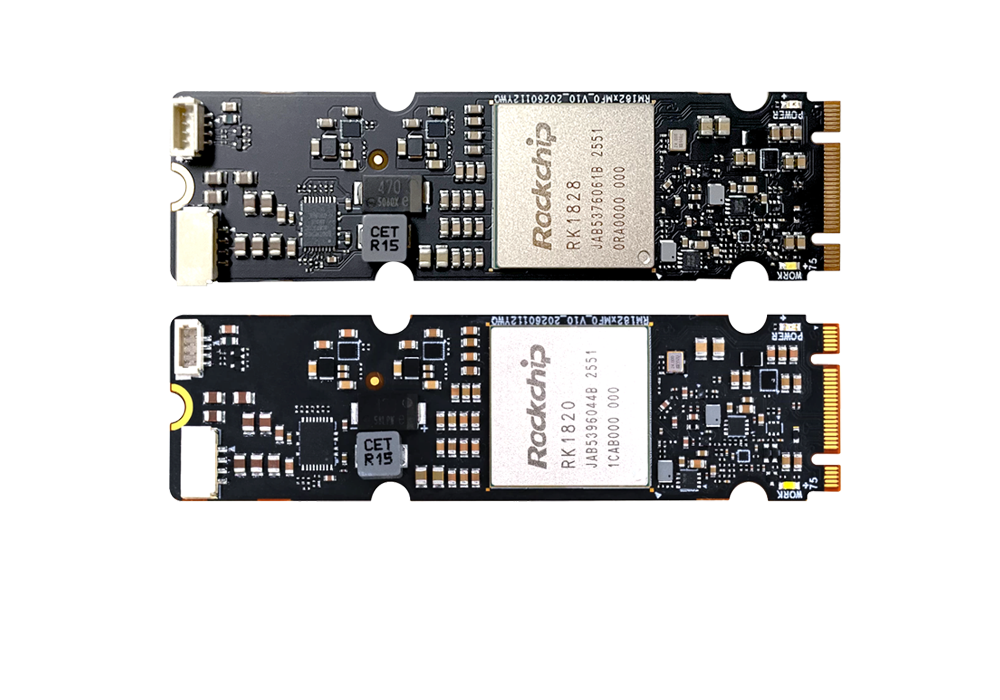
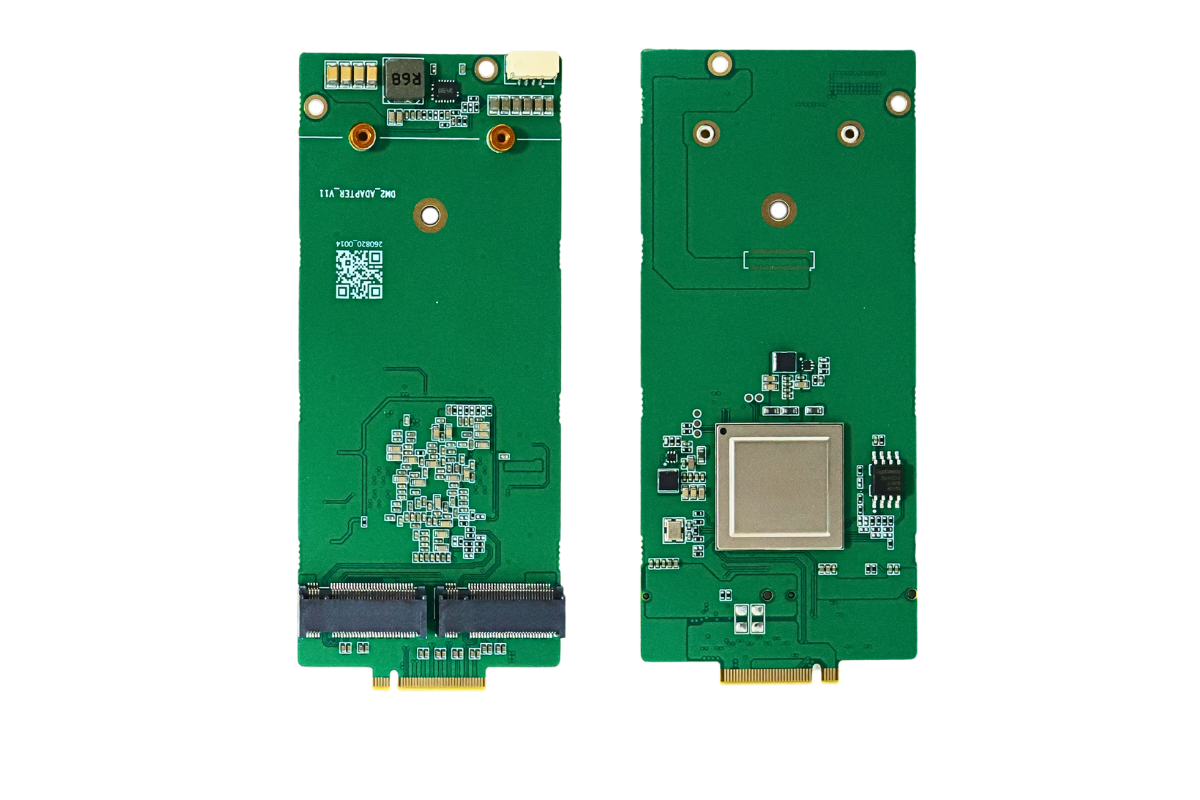


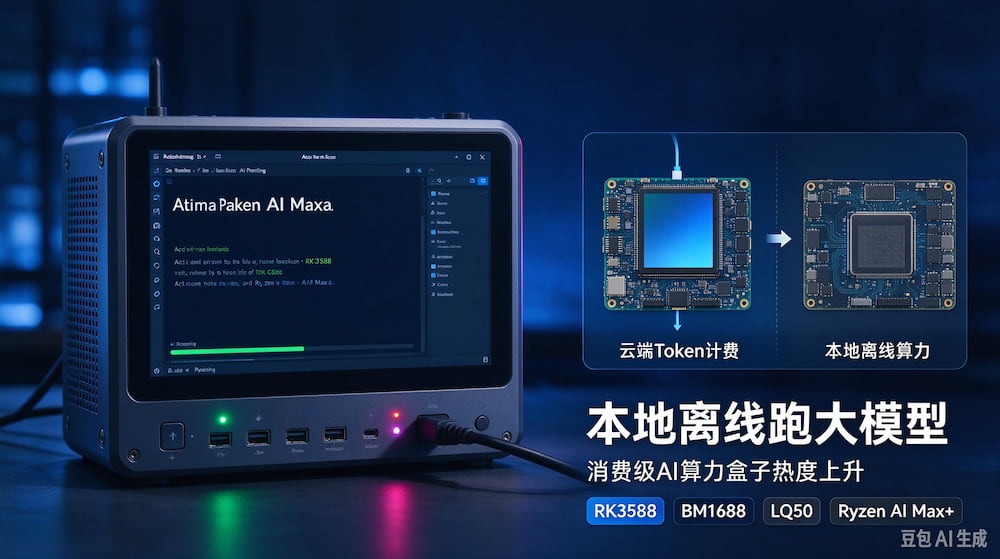
随着开源大模型量化技术持续成熟,消费级 AI 算力盒子热度持续走高,核心卖点就是本地离线推理,一次性硬件投入,不再按 Token 向云端 API 付费,同时满足隐私数据不出本地的需求,吸引极客、独立创作者、小工作室、AI 开发者入场。
一、市场爆发核心动因
1. 云端 Token 成本痛点
高频使用 AI 写作、代码、多模态生成、长文档解析的用户,API Token 账单会持续累积;云端还存在限流、网络延迟、内容审核限制、数据上传泄露风险。本地算力盒子,硬件买断后,模型推理不再产生 API 费用,私有文档、素材全部本地闭环处理,不上传公网。
2. 国产端侧芯片方案成熟,拉低入门门槛
市场分化成两条路线:
入门级:RK3588、RK1828 等 NPU 盒子,几百元价位,适合 7B/13B 量化模型、轻量 VLM 视觉模型,适合学习、原型调试;
高性能消费级:AMD Ryzen AI Max+、搭载力擎 LQ50、算能 BM1684X/BM1688、摩尔线程花港等 M.2 算力卡的整机盒子,可本地跑 34B、70B 甚至更大量化模型,支持多模态、Agent 智能体并发推理,云栖大会等展会持续推出新品,定位超级个体与小微团队。
3. 软件生态降低部署门槛
Ollama、llama.cpp、vLLM 等推理框架开箱可用,厂商预装模型管理系统,普通人不用深度折腾编译,一键加载开源大模型,支持断网离线运行,催生 “龙虾盒子” 这类热门整机方案,一度出现市场缺货涨价现象。
二、核心优势
✅ 成本结构转变:订阅制 → 一次性硬件买断
高频重度使用场景,长期能省下可观 Token 费用;一次性投入,无后续 API 账单。
✅ 隐私可控,数据本地留存
文档、图片、业务资料不用上传第三方云端,适合处理合同、创意素材、内部资料。
✅ 离线可用,不受网络波动、API 限流影响
断网环境依旧可以推理,不存在云端高峰期排队、接口封禁问题。
✅ 模型自由
可自由切换 Qwen、Llama、DeepSeek 等各类开源模型,自定义提示词、微调量化版本,不受平台模型池限制。
三、不可忽视的短板(选购关键)
❌ 硬件有上限,算力 / 内存决定模型上限
消费级盒子内存是最大瓶颈:小内存设备只能跑低位量化小参数模型;大参数量模型、长上下文、多并发任务,需要大内存,硬件成本会显著抬升。TOPS 算力高不等于推理速度快,内存带宽、量化策略影响更大。
❌ 推理速度普遍弱于云端
云端是高端 GPU 集群,本地盒子推理 Token 输出速度更低,大模型下延迟会明显增加。
❌ 硬件存在隐性成本
功耗、散热、存储;硬件折旧;模型更新、驱动、推理框架需要持续维护,有一定技术门槛,纯小白仍需要学习调试。
客观结论:本地盒子的首要价值是隐私与离线能力;只有高频重度使用,才有可能在周期内抹平硬件成本,单纯为省 Token 费不一定划算。
四、当前市场格局与人群
入门玩家 / 学生:RK 系列 NPU 盒子,低成本体验本地大模型,做学习、原型验证;
独立创作者、自由职业者:高性能 AI 盒子,批量文案、图片生成、长文档处理,保护创意素材;
小微工作室 / 个人开发者:用来本地调试 Agent、多模态工作流,降低 API 调试费用;
厂商:传统迷你主机厂商、国产 AI 芯片厂商纷纷入局,产品从单纯播放盒子转向端侧 AI 推理节点。
五、未来趋势
消费级 AI 算力盒子正在从 “极客玩具” 向生产力硬件演变,后续方向:
1. 软硬一体化,出厂预装模型管理、Agent 编排工具,进一步降低上手难度;
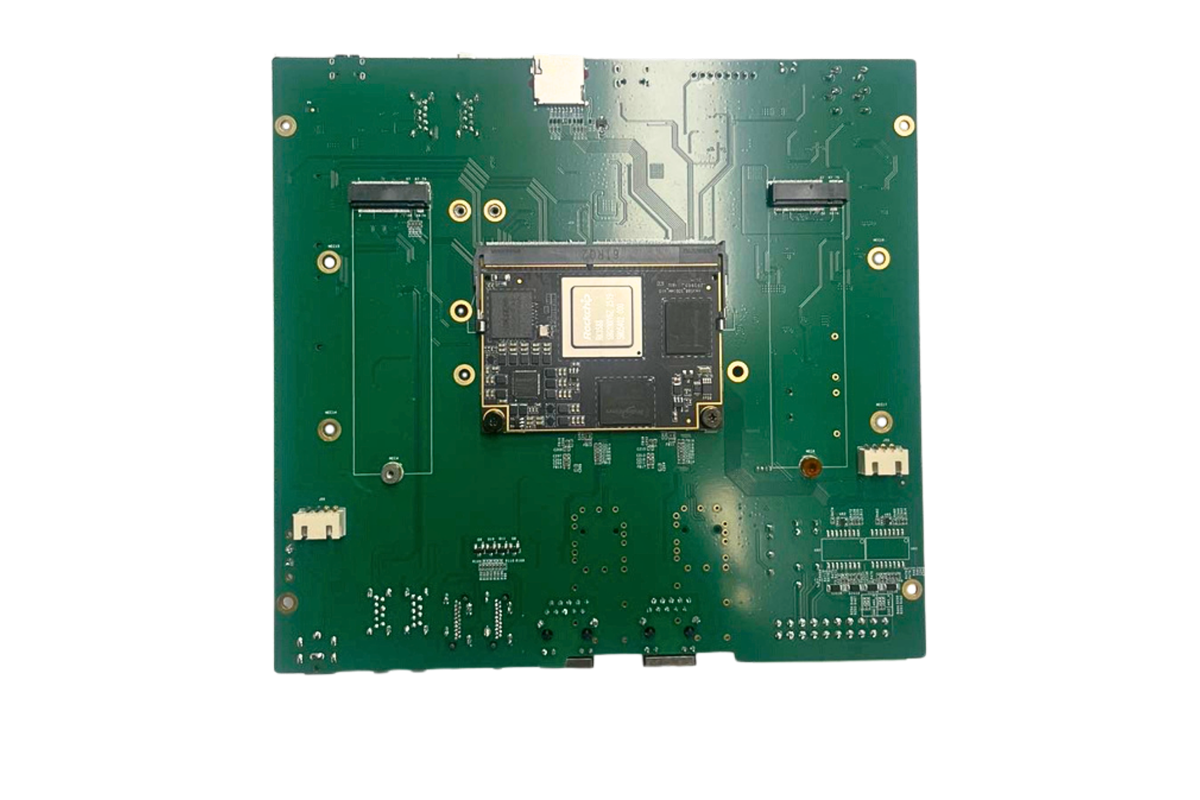
2. M.2 模块化算力卡方案普及,用户可以像升级硬盘一样扩展 AI 算力,不用整机更换;
3. 模型量化、稀疏推理持续优化,同等硬件下支持更大参数模型,缩小本地与云端的体验差距;
4. 市场会进一步分层:低价轻量款主打学习体验,中高端款面向生产力场景,和云端 API 形成互补,而非完全替代。
总结:消费级 AI 算力盒子不是云端 AI 的全面替代品,而是一套「离线 + 隐私 + 一次性硬件成本」的补充方案;重度、私有、离线需求用户收益最大,轻度 AI 用户继续使用云端 API 会更划算。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部