
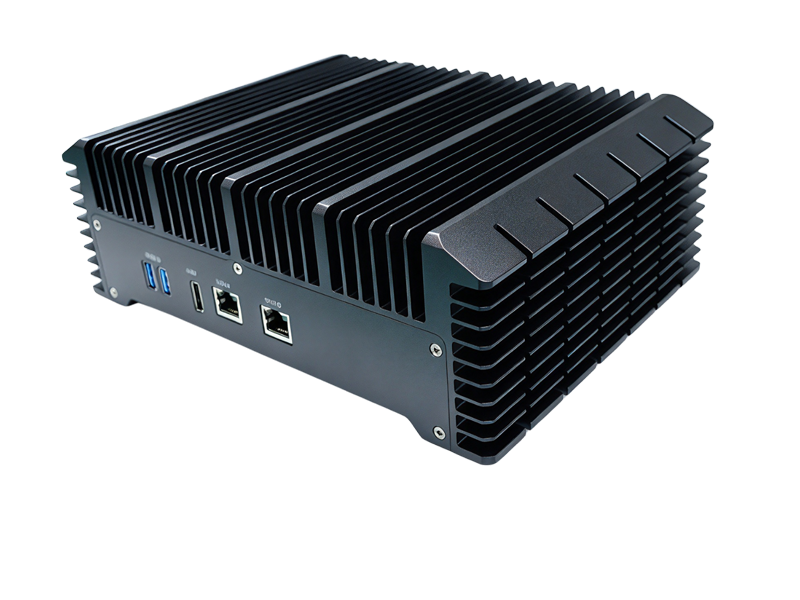
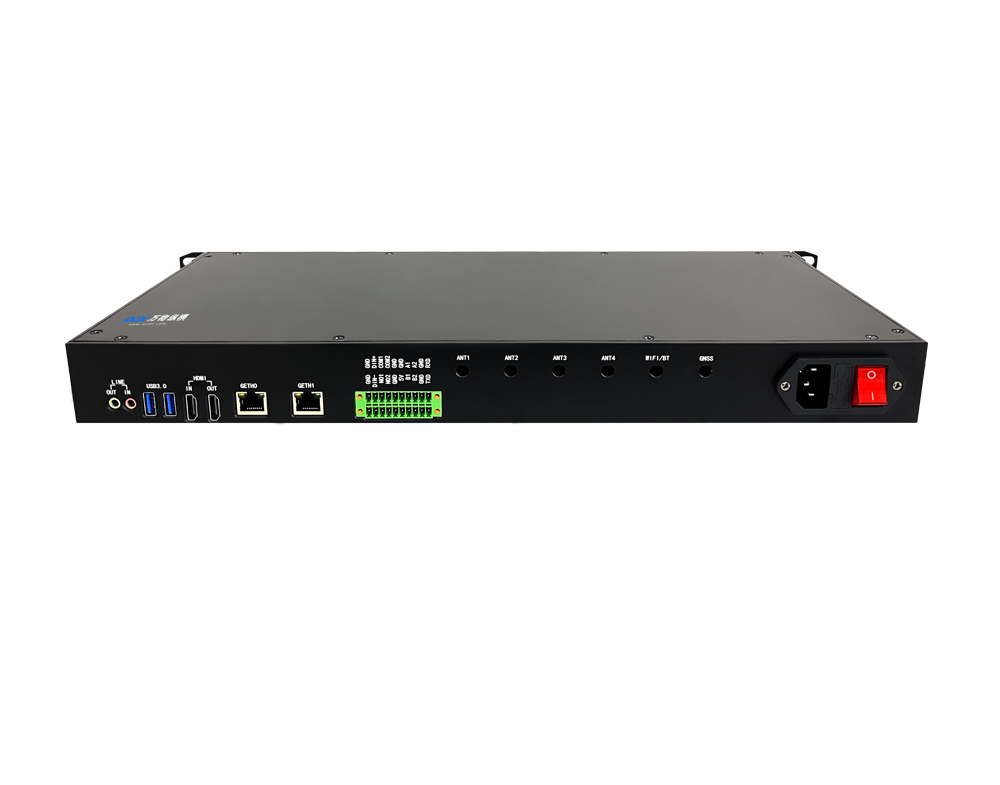
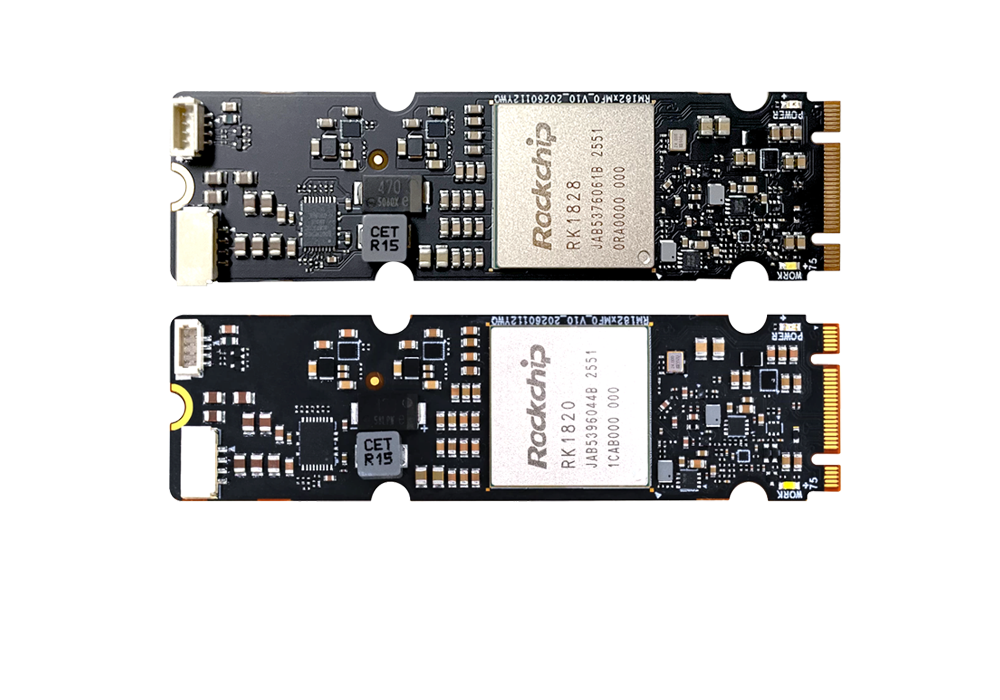
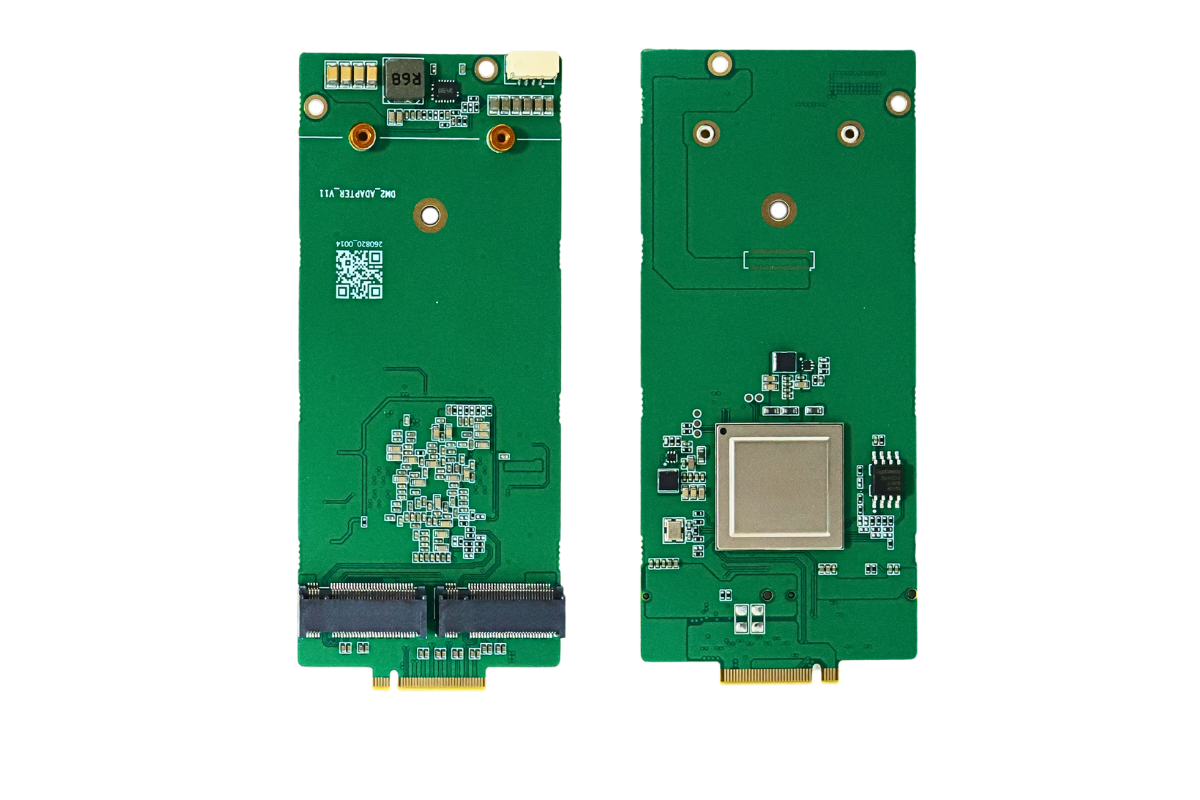


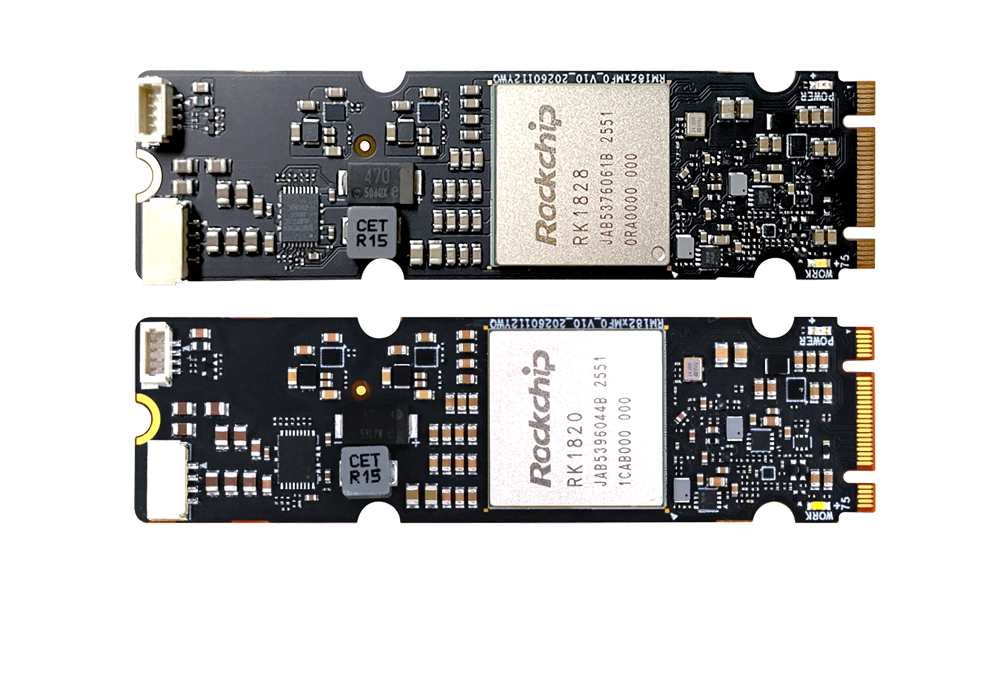
适配RKNN3编译器,AWQ(激活感知权重量化),针对RK1828板载5GB 3D堆叠DRAM优化,重点解决边缘大模型显存瓶颈痛点。
一、显存大幅压缩,突破RK1828片内内存上限(最核心价值)
实测Qwen-VL 7B模型,显存占用下降约22%,7B多模态模型可以完整放进RK1828自带5GB片载DRAM内,不需要依赖主机内存交换,彻底避开内存交换带来的推理卡顿、TPS跳水问题。
长上下文场景(8K上下文)收益尤其明显,KV缓存开销显著降低,长时间连续推理不会因为显存溢出崩溃,适合RAG文档检索、巡检报告解析这类长文本业务。
二、量化后精度几乎无损,优于传统INT4均匀量化
AWQ会识别并保护模型中约1%关键权重通道,基于激活值分布做逐通道缩放;相比普通均匀INT4量化,模型理解能力、图文识别准确率衰减极小,不像普通低比特量化容易出现识别错乱、问答逻辑出错。
优势:视觉多模态VLM、文档问答这类任务,量化效果比GPTQ更稳定,对图文混合场景泛化更好。
三、推理端零额外开销,不牺牲生成速度
量化权重在离线转换阶段完成,推理运行阶段不需要额外的反向计算、重建操作;权重反量化参数直接融合进算子,推理TPS几乎无衰减。
RK1828 NPU原生适配AWQ算子,7B模型token生成速度基本和FP16版本持平,不会出现量化后推理变慢。
四、降低多卡级联部署门槛
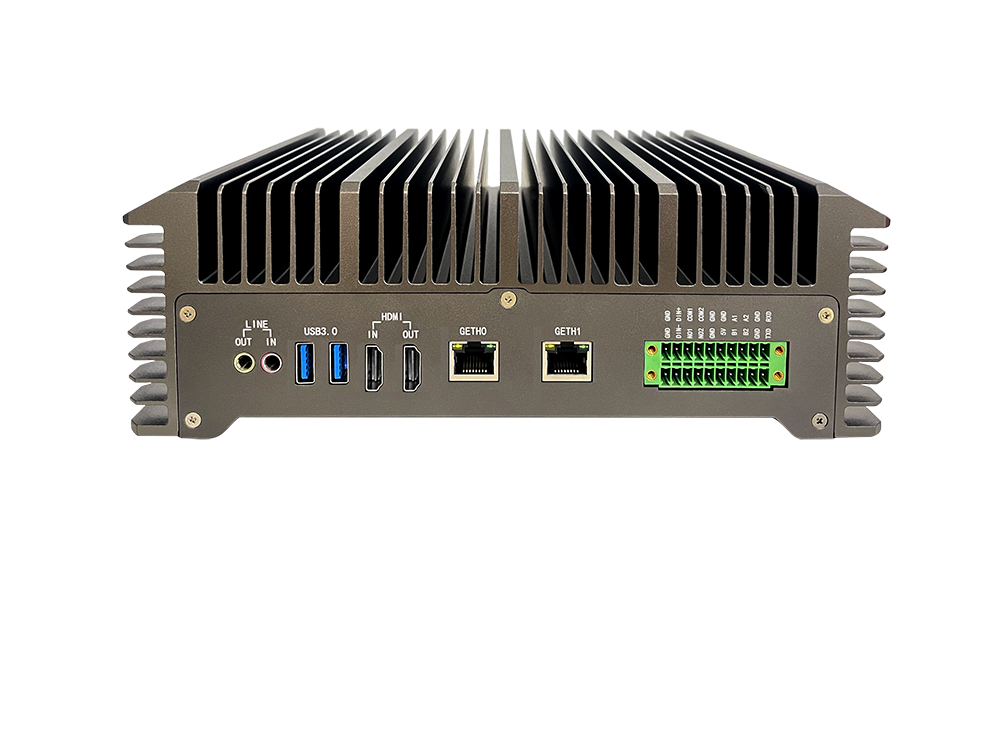
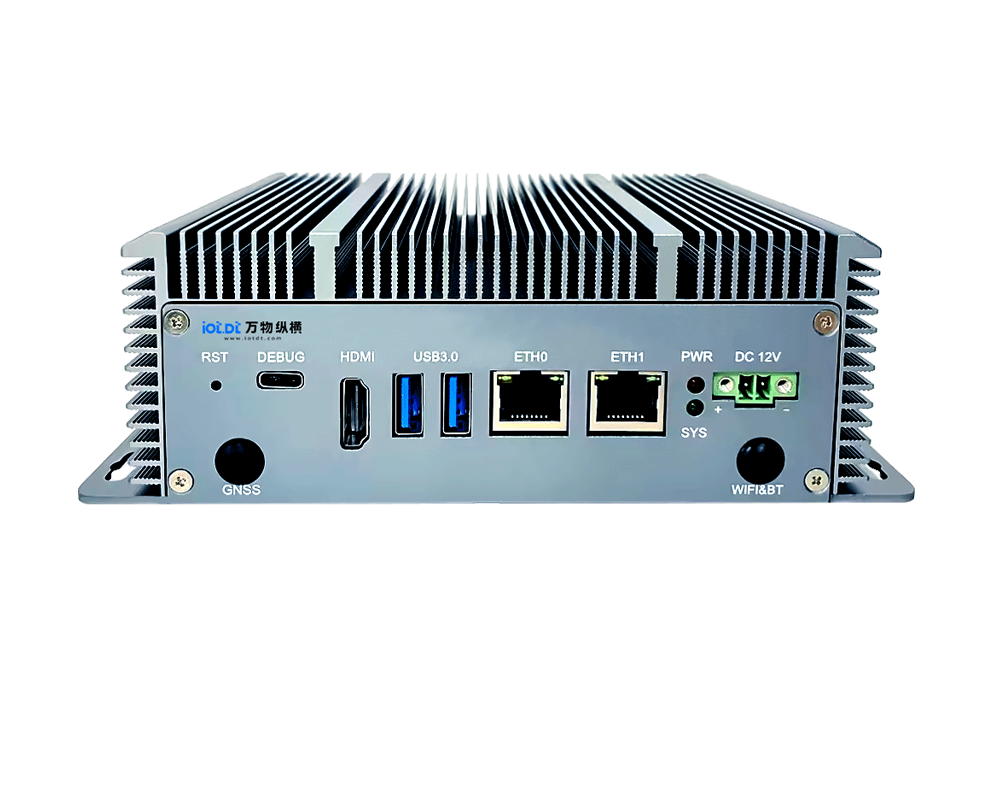
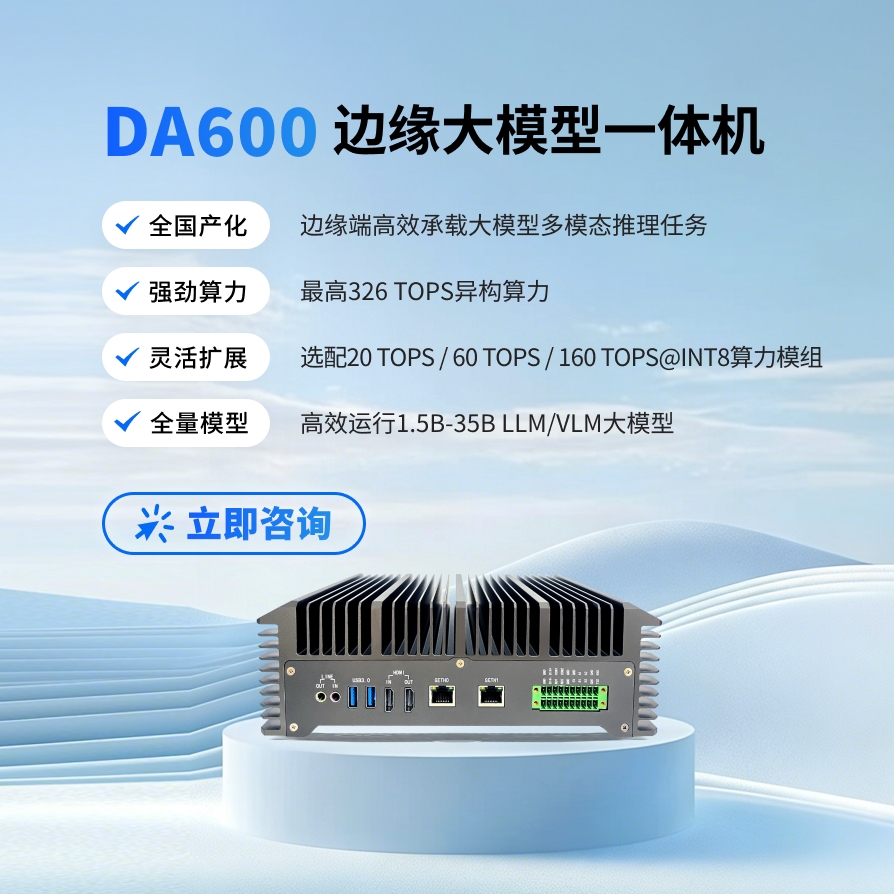
多片RK1828卡级联跑更大模型(如27B)时,单卡显存占用降低,模型分片加载压力减轻;减少多卡之间的数据交互压力,提升长时间满载稳定性,降低多卡项目调试难度。万物纵横等整机方案商直接把这套AWQ量化工具打包进SDK交付集成商。
五、校准简单,降低项目落地工作量
AWQ属于后训练量化,不需要微调、反向传播,少量校准数据集即可完成模型转换;相比GPTQ,模型量化校准速度快很多。算法工程师不需要重新训练模型,原有开源Qwen系列模型可以快速转RKNN,缩短POC验证周期。
六、适配边缘离线场景,兼顾功耗
RK1828本身低功耗,AWQ减少显存读写压力,降低片上DRAM带宽占用,整机功耗不会明显上升,适合野外光伏、工厂巡检这类供电有限、长时间待机运行的边缘项目。
工程选型
AWQ量化让RK1828在5GB片存限制下,能稳定跑7B多模态VLM+8K长上下文RAG,在几乎不丢精度、不降推理速度前提下解决边缘最大的显存瓶颈;是存量RK3588主机加装RK1828算力卡做本地知识库、图文分析项目的关键优化。
短板
AWQ只做权重量化(W4A16),激活保持FP16;如果极致追求更大显存压缩,需要配合其它量化策略。
部分小众自定义模型需要单独做算子适配。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部