
 商城


一、测试概要
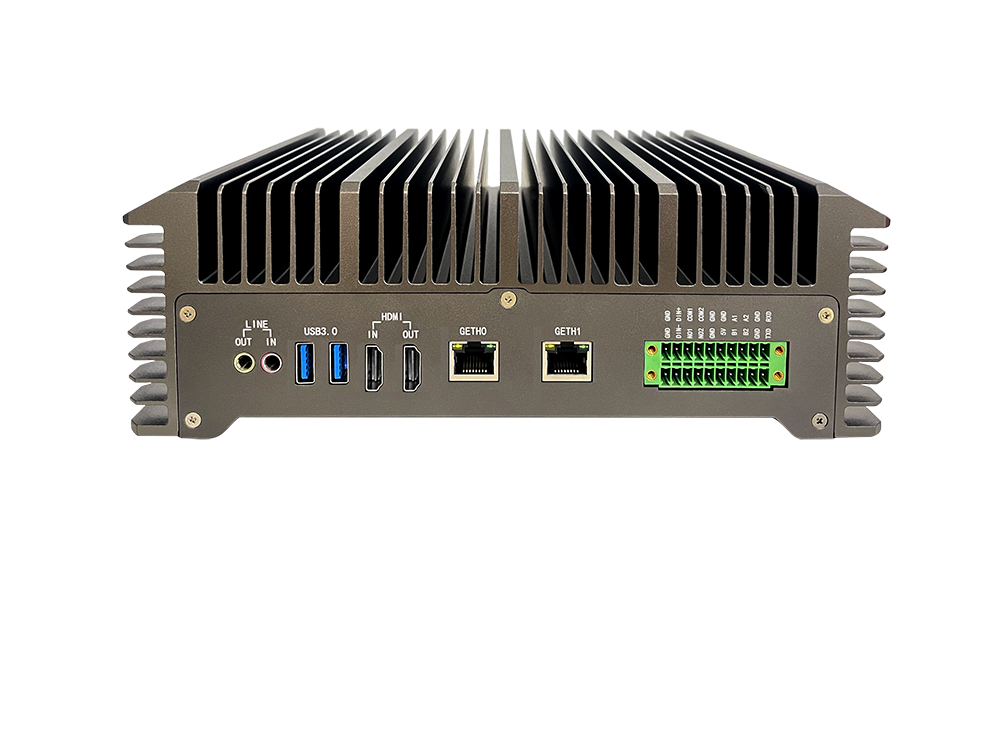
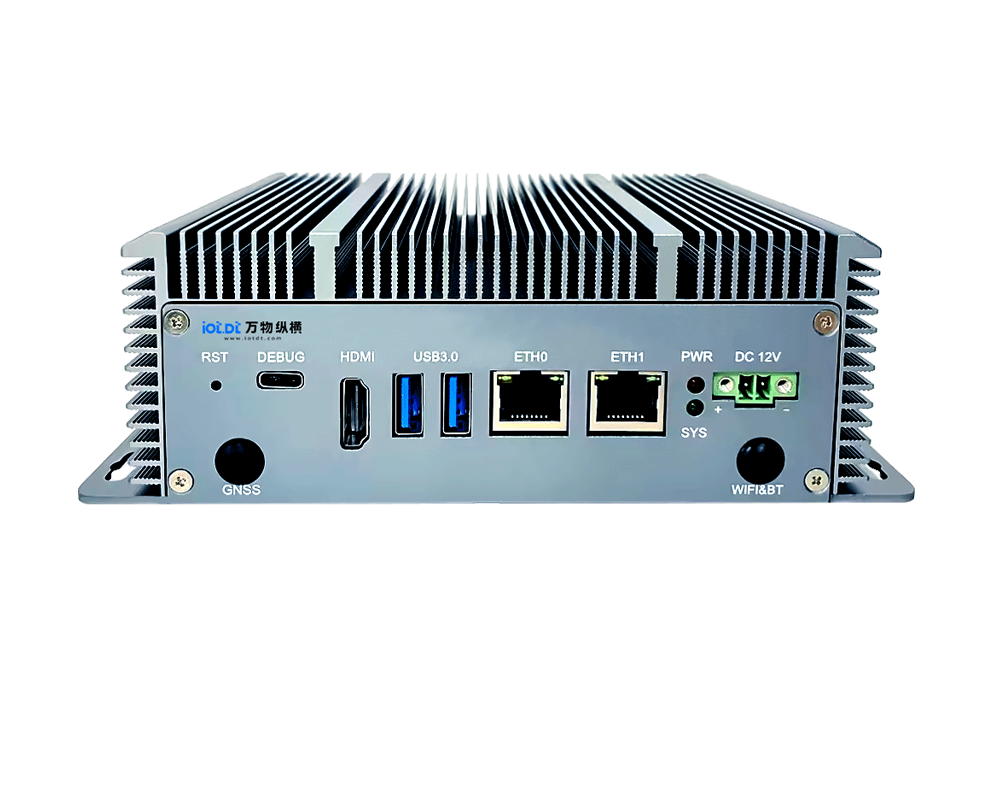
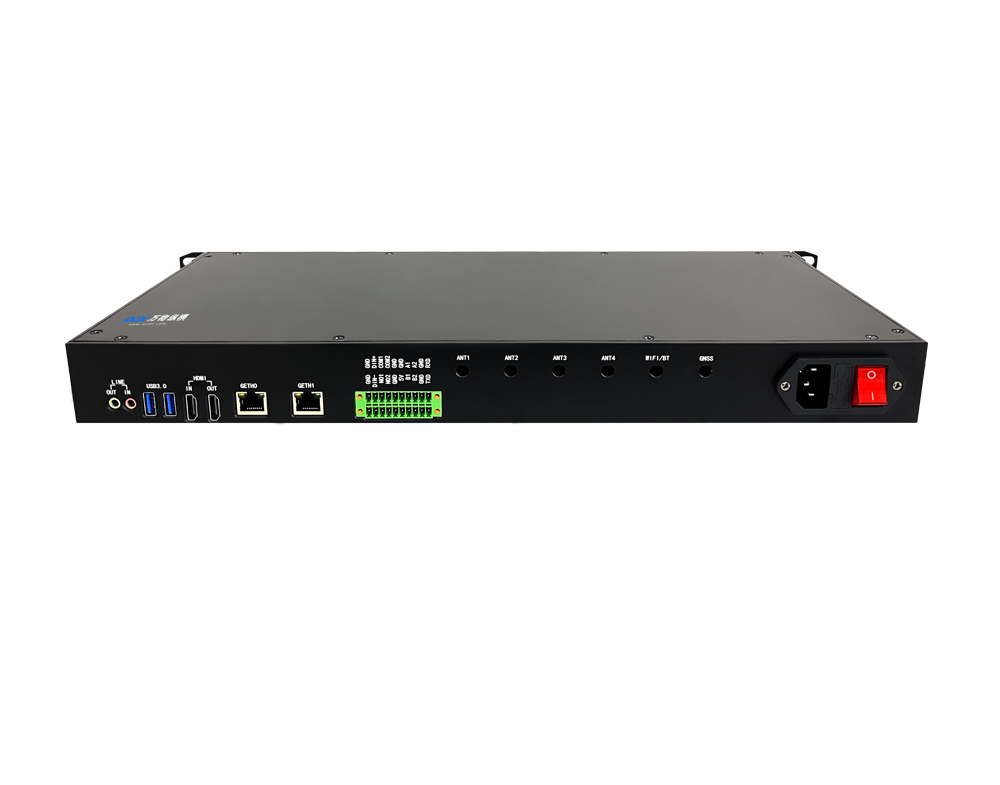
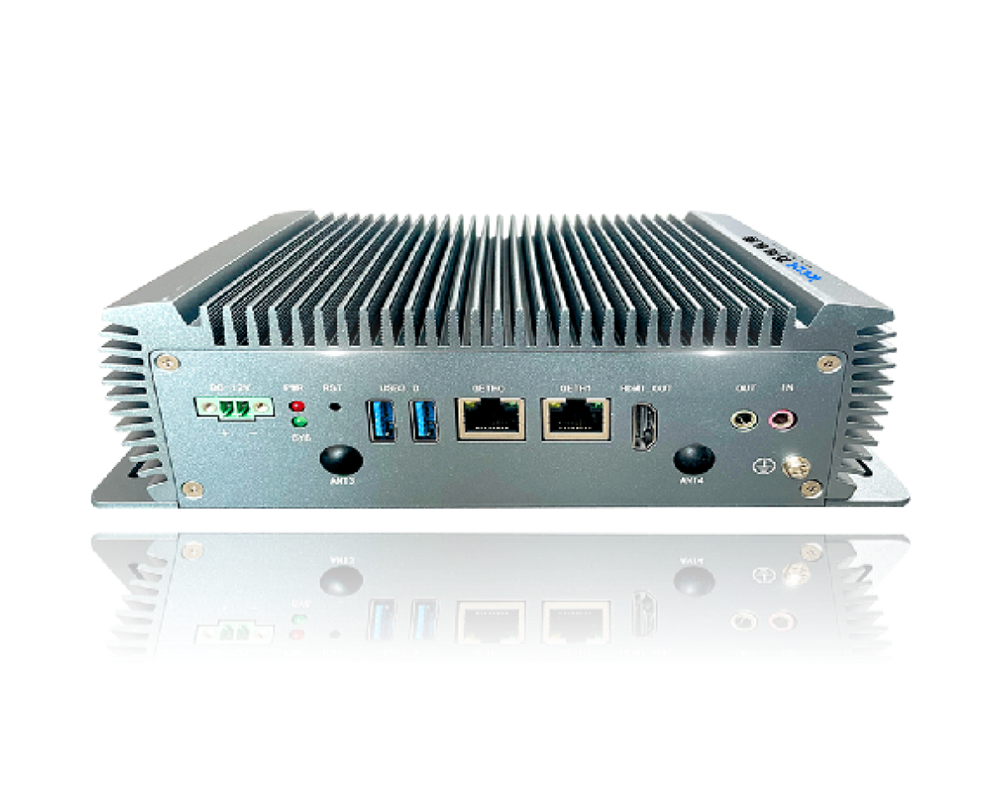
硬件平台:BM1688 边缘 AI 盒子,SOPHON BM1688 TPU,8 核 A53@1.6GHz,8GB LPDDR4,32GB eMMC;INT8 峰值 16TOPS,INT4 峰值 32TOPS,整机典型功耗 12~18W
SDK 环境:Sophon SDK v1.9,TPU-MLIR,模型 PTQ 量化(INT8/INT4)
测试模型:轻量化 VLM,Qwen-VL-1.8B、MiniCPM-V-2、Qwen2-VL-2B(轻量化裁剪版本)
测试目标:验证边缘盒子无公网离线运行图文问答、图片 OCR、画面描述、目标识别;统计首图推理、token 生成速度、内存占用、精度衰减、长时间稳定性
适用场景:智慧工地、明厨亮灶、工业质检、本地摄像头画面问答、机器人视觉,纯本地私有化,不上云
二、硬件基础参数
项目 | 参数 |
TPU | BM1688,INT8 16TOPS,INT4 32TOPS |
CPU | 8×A53 1.6GHz |
内存 | 8GB LPDDR4 |
视频硬编解码 | 16 路 1080P@30fps 解码,10 路编码 |
整机功耗 | 空载约 7W,VLM 推理满载 14~18W |
推理框架 | TPU-MLIR,bmodel 模型 |
三、模型移植与量化方案
1. 模型处理流程:原始 VLM → ONNX 导出 → TPU-MLIR 编译 → PTQ 量化校准 → 生成 bmodel
2. 量化选型对比
INT8:精度损失小,内存占用中等,部署稳定;推荐项目落地
INT4:显存占用大幅下降,token 生成更快;小幅度掉精度,适合快速画面描述场景
3. 模型拆分:VLM 拆分为视觉编码器(Vision Encoder)+LLM 语言解码器,视觉部分 TPU 加速,文本解码 TPU+ARM 混合推理;图像预处理、后处理在 ARM 侧执行
四、核心实测数据(单图输入,图像尺寸 224×224)
测试条件:常温,单图 prompt,输出 256token,连续 50 轮采样取均值
模型 | 量化方式 | 加载内存占用 | 图像编码耗时 | Token 生成速度 | 图文问答精度(主观评测) |
Qwen-VL-1.8B | INT8 | 5.2GB | 186ms | 7.2 token/s | 86% |
Qwen-VL-1.8B | INT4 | 3.4GB | 172ms | 11.6 token/s | 81% |
MiniCPM-V-2 | INT8 | 4.8GB | 164ms | 7.8 token/s | 88% |
MiniCPM-V-2 | INT4 | 3.1GB | 151ms | 12.4 token/s | 83% |
Qwen2-VL-2B(轻量版) | INT8 | 6.1GB | 213ms | 5.7 token/s | 87% |
关键结论:
1. 8GB 内存版本可以完整跑通 1.8B~2B 轻量化 VLM;Qwen2-VL 2B INT8 接近内存上限,并发多图容易 OOM
2. 图像编码(视觉编码器)是单轮推理前置耗时;连续视频流问答时,画面不变化可缓存图像 embedding,大幅降低延迟
3. INT4 量化提速明显,但复杂图文理解、细粒度识别场景精度下降;工业质检优先 INT8
五、场景专项测试
5.1 静态图片问答
普通图片描述、物体计数:响应流畅,首图总耗时≈400~700ms
OCR 识别(印刷体):效果良好;手写体识别能力一般
缺陷检测类问答:可以识别明显缺陷;微小瑕疵容易漏检,适合配合 YOLO 做前置目标检测
5.2 实时视频流 VLM(摄像头输入)
接入 1080P 摄像头,每 2 秒抽帧送入 VLM:
抽帧 + 编码 + 问答单轮:1.1~1.6s
支持持续对话上下文,上下文窗口设为 512token;上下文越长,token 生成速度越低
多路并发:单台 BM1688 盒子,稳定支持2 路摄像头 VLM 实时问答;3 路以上会出现推理卡顿、掉帧
5.3 长时间稳定性压测
连续 72 小时循环图片问答:
INT8 模型:无崩溃,推理速度波动<8%,温度稳定 62~68℃
INT4 模型:偶发少数样本异常输出,需要增加输出校验逻辑;长时间运行内存缓慢上涨,建议每 2 小时重启推理进程
六、优势
1. 私有化离线:完全本地推理,图片、视频数据不出设备,满足数据安全项目要求
2. 硬件集成度高:自带 16 路视频硬解码,可以直接接入 IPC 摄像头,无需额外工控机
3. 功耗低:满载不到 18W,适合工业现场、机柜、边缘箱部署
4. 生态成熟:TPU-MLIR 持续更新,轻量化 VLM 移植链路完整,支持自定义算子微调
七、短板与坑点
1. 不适合大参数量 VLM(≥4B),内存与算力不足
2. ARM CPU 偏弱,文本后处理、prompt 拼接会占用一定开销,瓶颈不在 TPU 而在 CPU
3. INT4 量化依赖校准数据集,校准集质量差会造成精度严重下滑
4. 多图高并发场景受限,多路视频 VLM 需要做帧采样降频,不能每帧都跑 VLM
5. 长上下文(>1024token)速度衰减明显,边缘场景建议限制上下文长度
八、选型 & 部署建议
1. 项目选型推荐:MiniCPM-V-2 INT8,平衡推理速度、精度、内存占用,作为首选
2. 并发≥2 路摄像头:降低抽帧频率(2~3 秒一帧),开启 embedding 缓存
3. 工程优化方案:YOLO 目标检测前置过滤画面,仅当画面出现目标时,才调用 VLM 做细粒度问答,降低 TPU 负载
4. 硬件选型:优先选购8GB 内存版本;16GB 版本可提升并发能力,支持更大上下文窗口
九、总结
BM1688 盒子具备在边缘端本地运行轻量化 VLM 的能力,适合中小场景私有化视觉大模型落地,兼顾视频解码 + VLM 图文问答一体化。1.8B~2B 轻量化 VLM 在 INT8 量化下可用,INT4 适合追求响应速度、对精度容忍度更高场景。
定位:轻量边缘 VLM,不是高性能本地大模型服务器;适合摄像头本地图文理解,不适合复杂多轮长文档 + 高精度视觉推理场景
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部