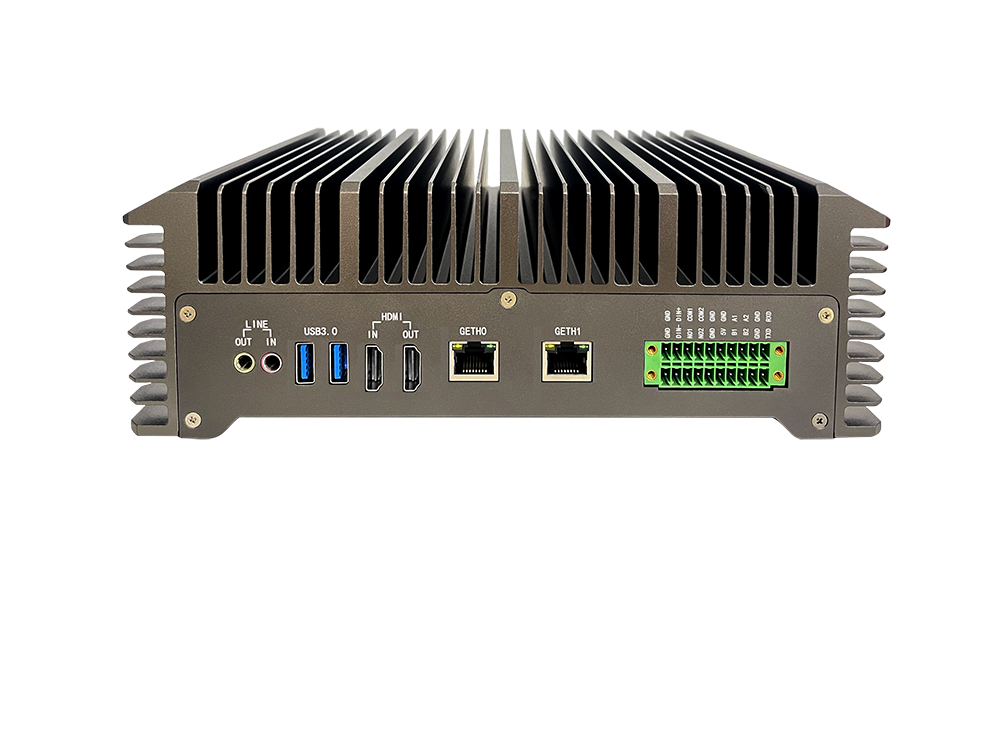
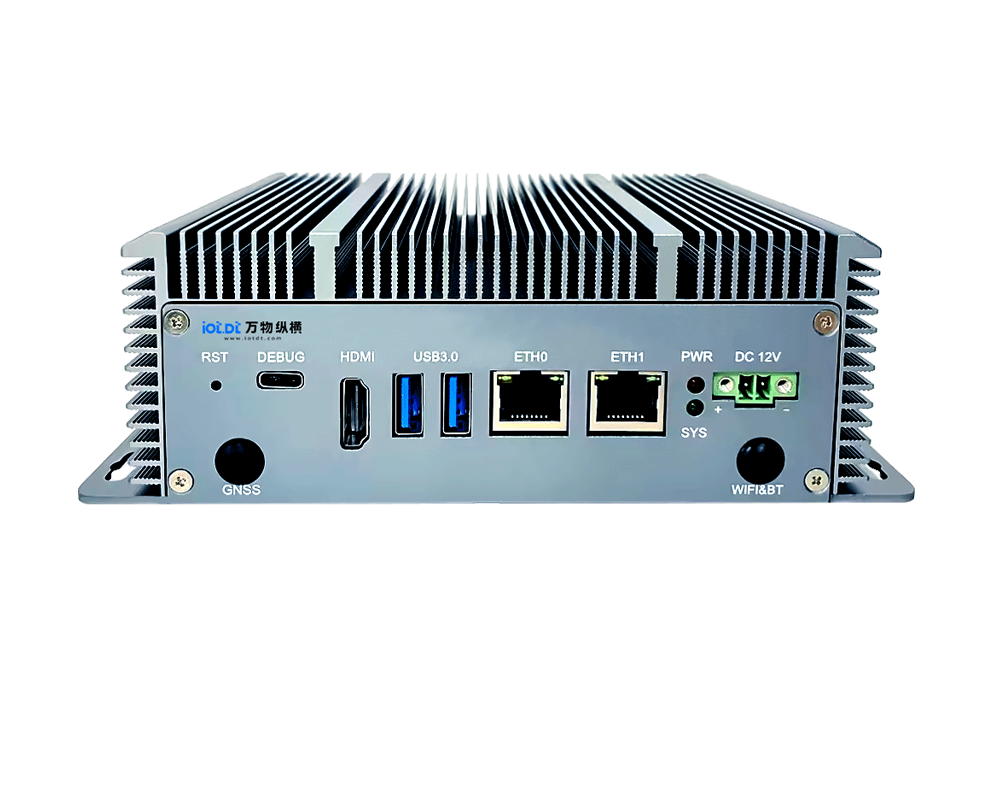
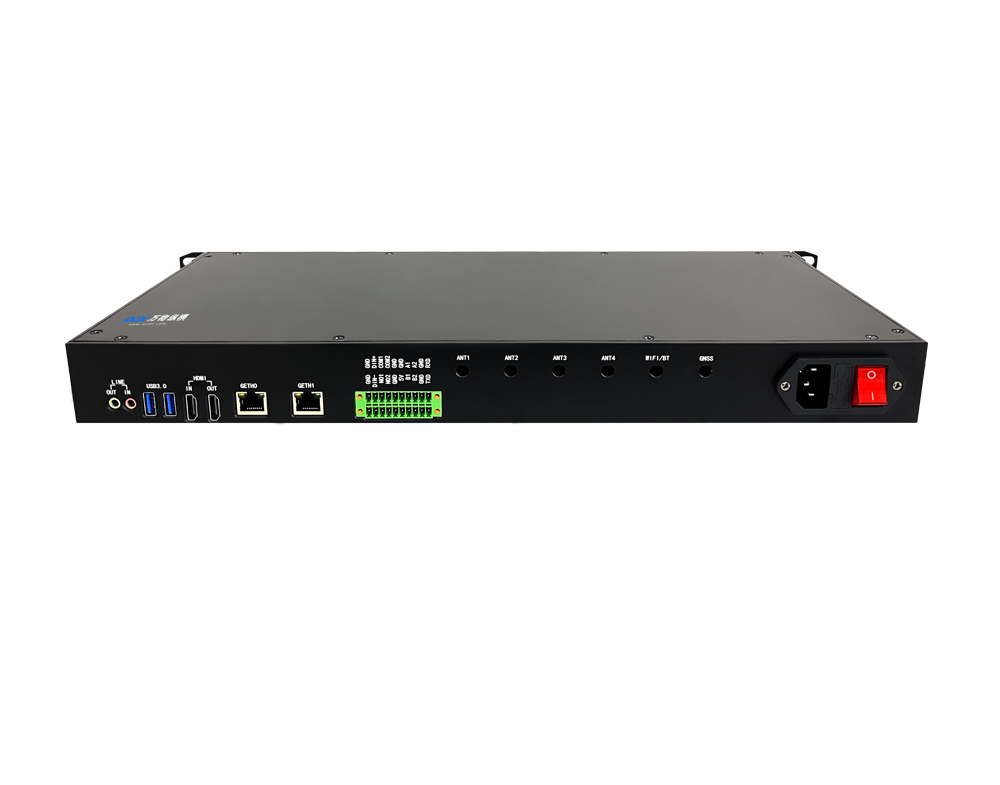
MDC2025 摩尔线程首届 MUSA 开发者大会,摩尔线程公布第五代 MUSA 全功能 GPU 架构花港,除云端华山、庐山芯片外,同步规划边缘 M.2 形态加速卡,补齐云 边 端产品矩阵。
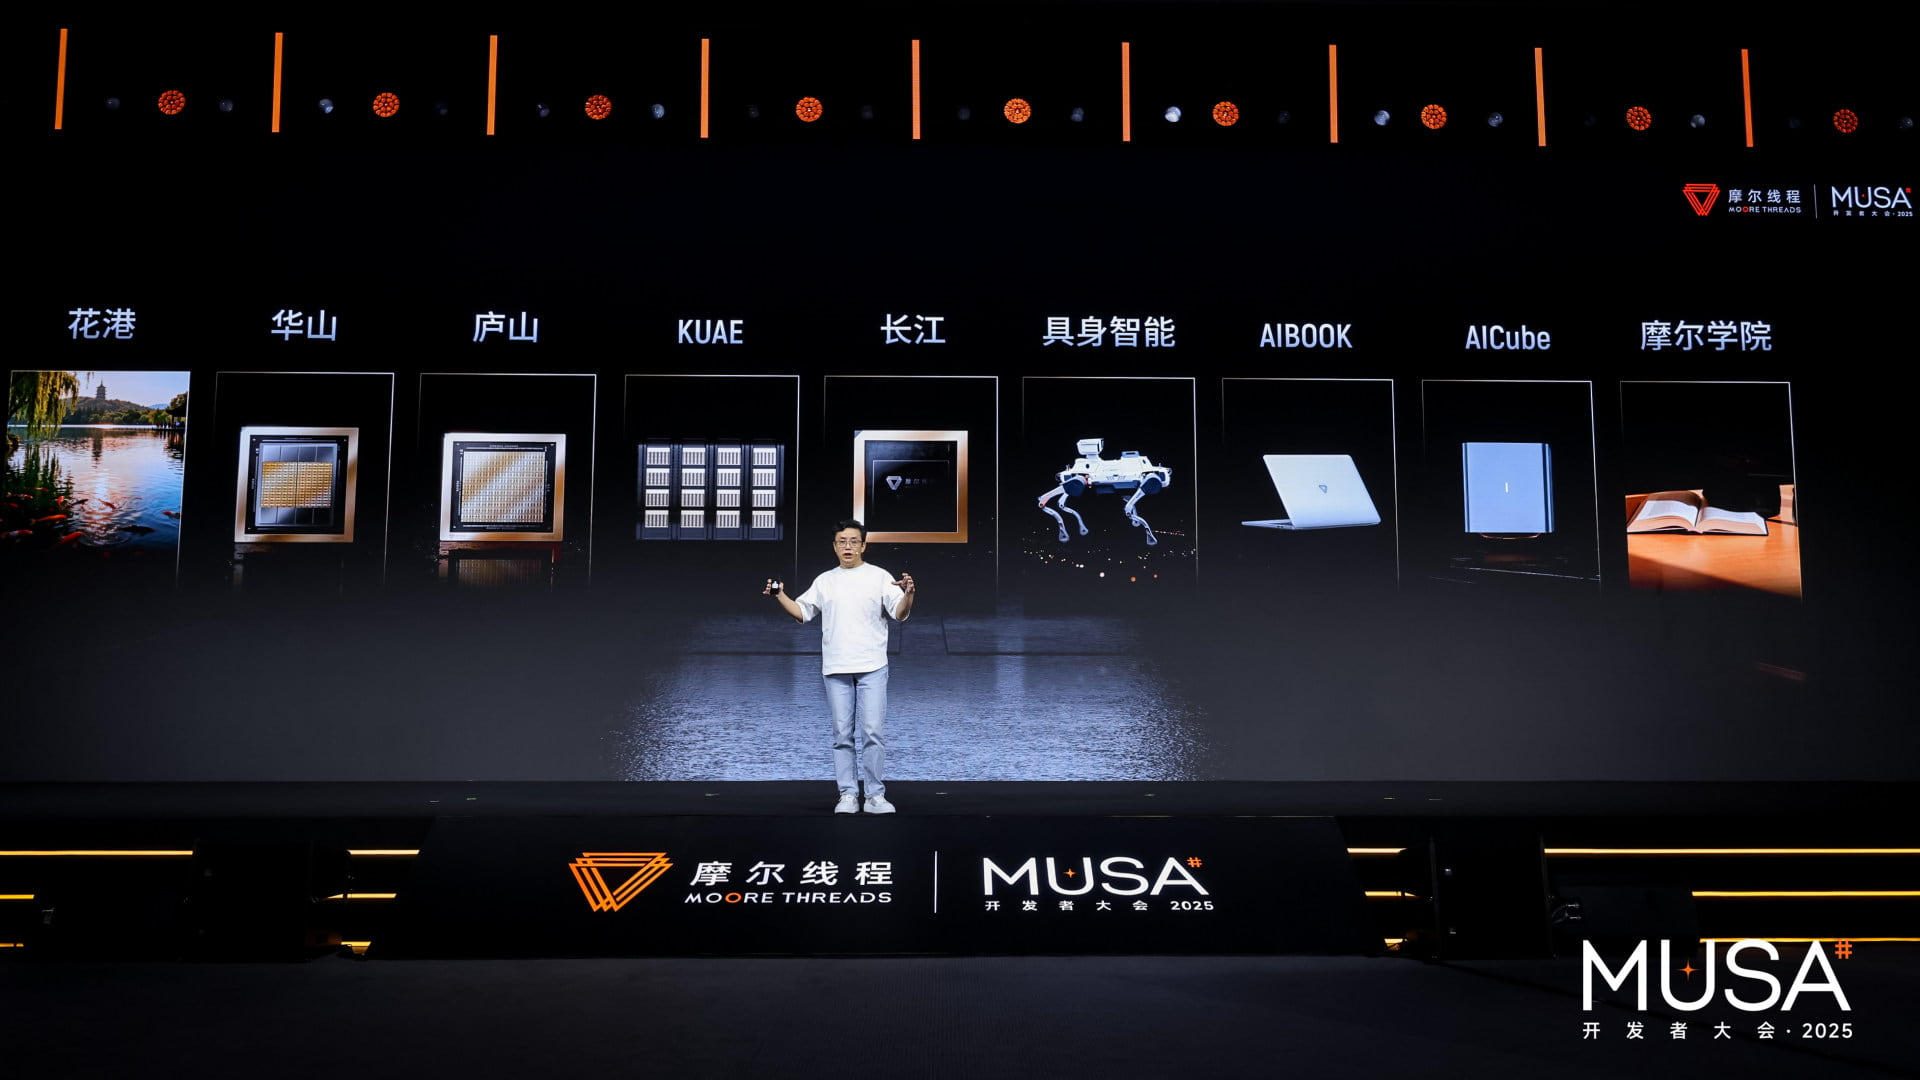
一、花港架构核心能力
花港是摩尔线程继平湖之后第五代自研 MUSA GPU 架构,核心亮点:
1. 算力与能效:新一代指令集,同等工艺下算力密度提升 50%,能效提升 10 倍
2. 全精度 AI 计算:原生支持 FP4/MTFP4、FP6/MTFP6、FP8、FP16、FP32、FP64 全精度端到端计算,适配大模型量化推理、训练、科学计算
3. 超大规模互联:自研 MTLink 高速互联,支持十万卡集群扩展;新一代异步编程模型,减少计算单元空转,提升算力利用率
4. 图形 + AI 融合:第一代 AI 生成式渲染 AGR、第二代硬件光追引擎,完整支持 DirectX 12 Ultimate,图形渲染和 AI 推理可协同运行
5. 安全可信:四层硬件安全架构,芯片级可信执行环境,适配工控、安防等对数据安全要求高的边缘场景
二、芯片产品线规划
基于花港架构规划两颗主力芯片:
华山:云端训推一体芯片,主打大模型训练 + 推理,访存指标对标海外旗舰 GPU
庐山:高性能图形 GPU,面向渲染、数字孪生、工业可视化
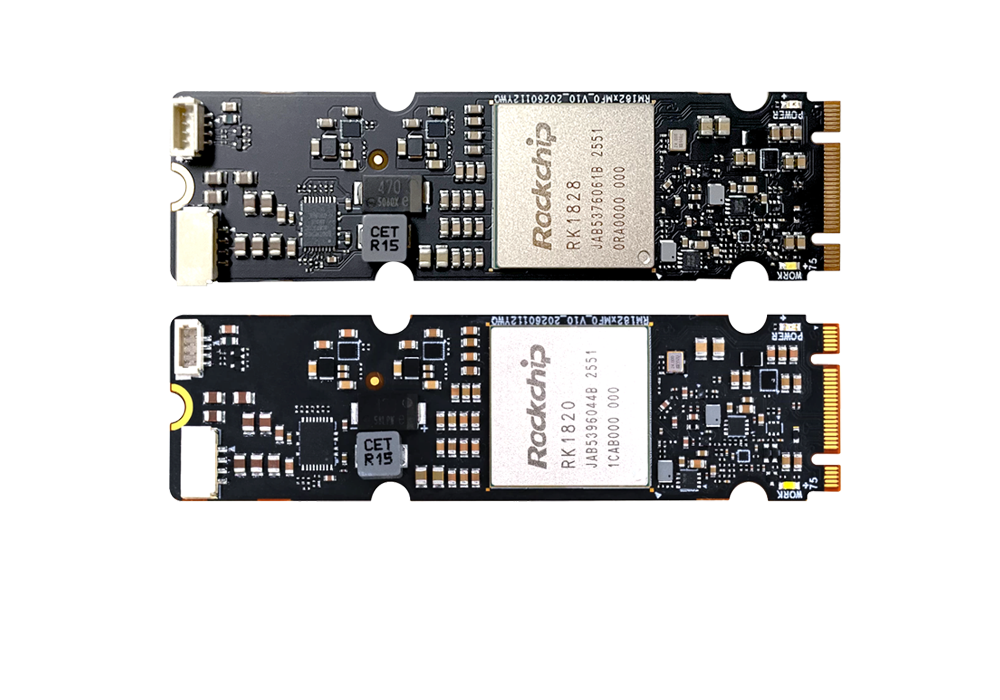
边缘侧:在花港路线下,规划M.2 2280 规格边缘加速卡,属于摩尔线程边缘算力产品线,和长江 SoC 模组形成互补。
M.2 形态优势:小尺寸、低功耗、无需额外供电,可直接插入工控机、嵌入式主机、服务器扩展槽,适合明厨亮灶、工地 AI 巡检、光伏巡检、车载 / 船载边缘推理、工业视觉等场景。
三、M.2 边缘加速卡定位
1. 形态:M.2 2280 标准卡,PCIe 接口,嵌入式友好,小体积低功耗
2. 场景:边缘端 AI 推理、多路视频分析、轻量图形渲染;替代部分海外边缘算力卡,国产信创嵌入式方案
3. 生态:复用统一 MUSA 软件栈,云端训练模型可直接部署到 M.2 边缘加速卡,降低迁移成本
4. 产品矩阵逻辑
云端:华山(大模型训推)、庐山(图形渲染)
边缘:花港 M.2 加速卡(嵌入式 AI 推理)
端侧:长江 SoC(AI 模组、终端设备)
四、行业意义
1. 国产 GPU 首次完整覆盖云端超算、高性能图形、M.2 边缘小卡、端侧 SoC全层级算力,形成完整云边端体系;
2. M.2 边缘卡赛道目前国内算力卡选择不多,摩尔线程入局,可对标 RK、算能、力擎等边缘 AI 方案,在GPU 图形 + AI 推理二合一上形成差异化优势(竞品大多只做纯 AI 推理,缺少硬件光追、图形能力);
3. 花港架构统一指令集,一套软件栈跑遍云、边、端硬件,大幅降低行业客户开发维护成本。
五、总结
摩尔线程花港架构不只是面向智算中心的高端 GPU,还向下延伸推出 M.2 边缘加速卡,凭借图形 + AI 推理一体化、全精度支持、统一 MUSA 软件栈切入工控、视频分析、工业数字孪生等边缘市场,补齐国产 GPU 云边端算力布局。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部

 商城