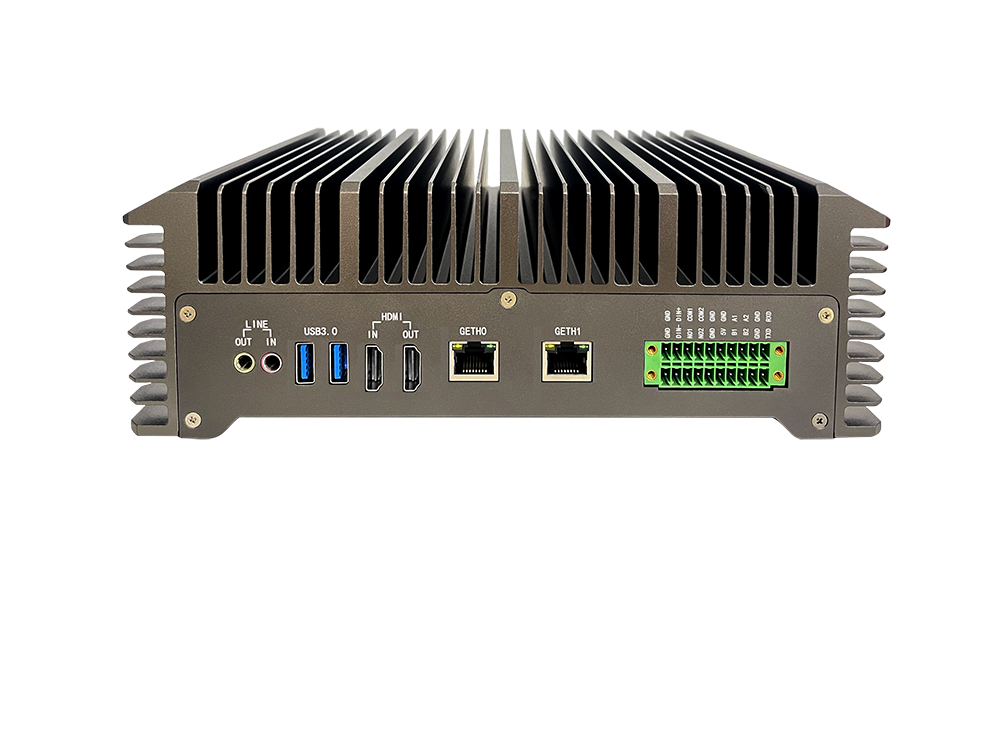
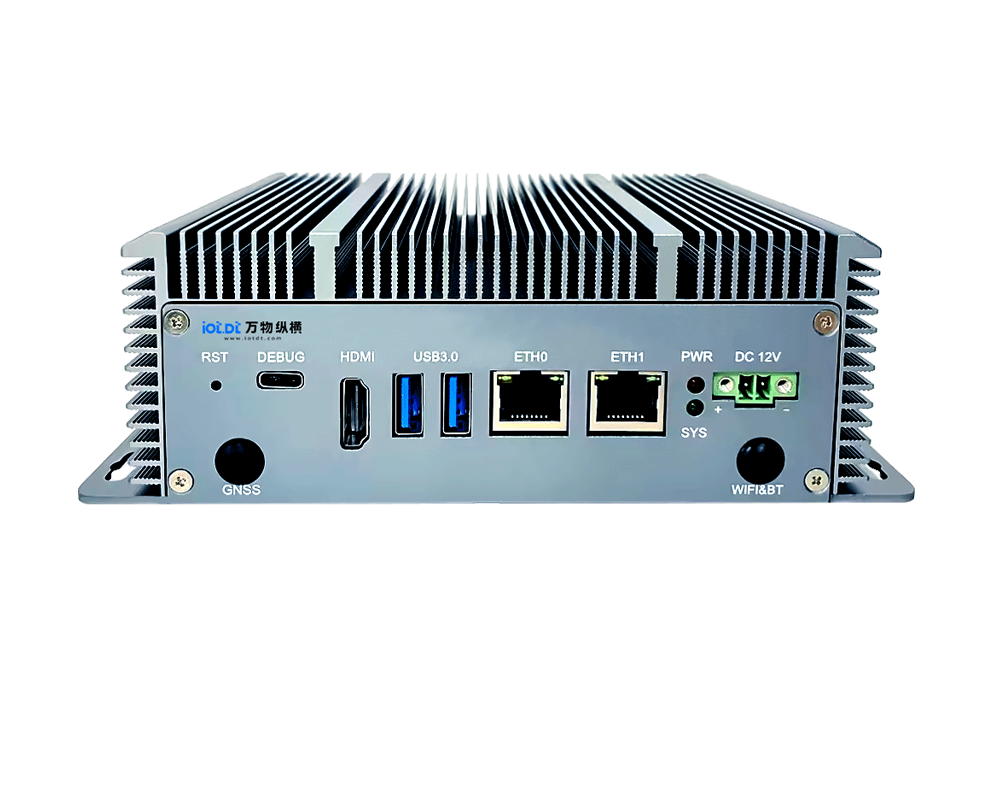
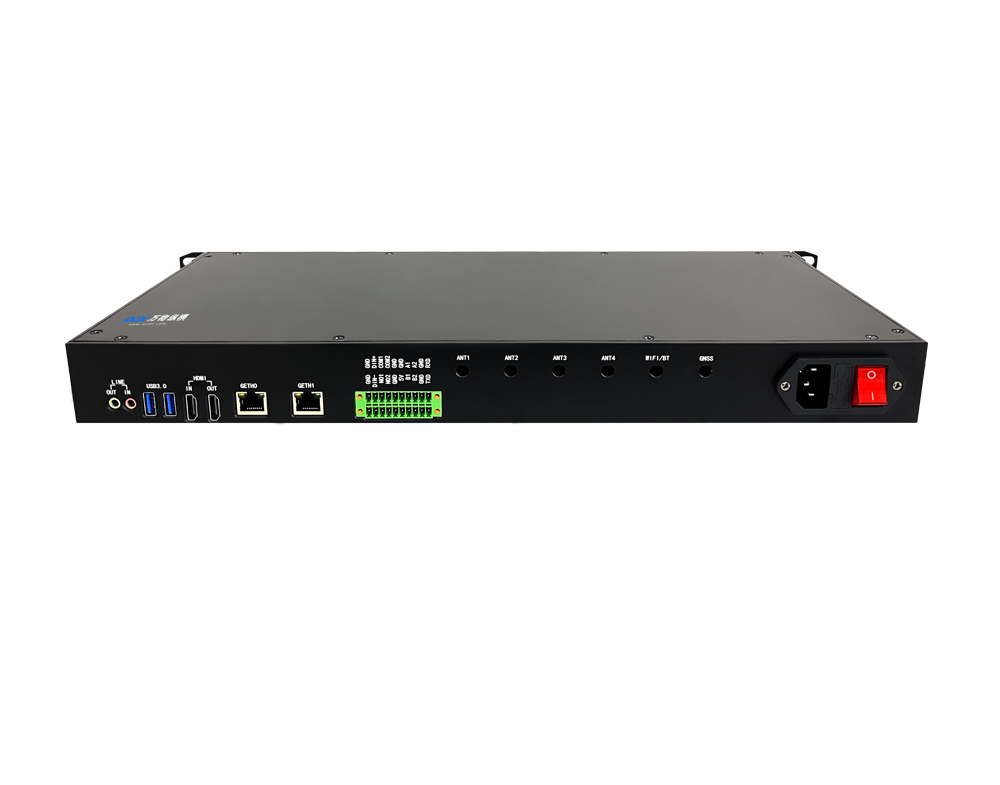
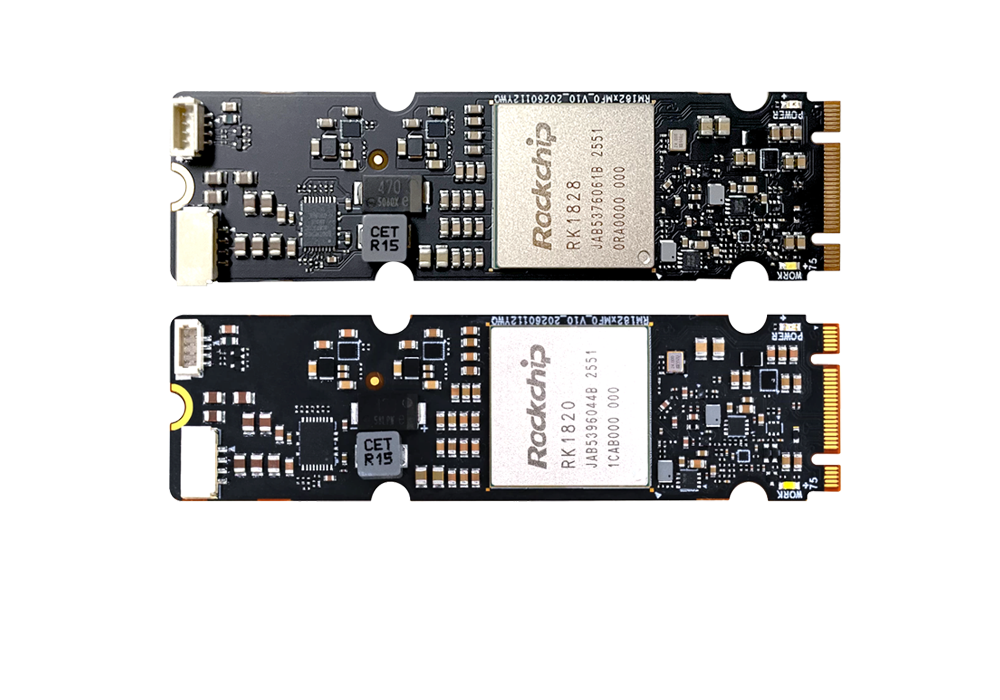
瑞芯微 RK1828 M.2 2280 AI 协算力卡,基于RK182X_AI_SDK V1.1.0,四卡 PCIe 级联推理落地,边缘端原生跑通 Qwen3.8-27B、Gemma-4-31B-it,属于嵌入式边缘私有化大模型方案,替代 Jetson 高功耗方案的有力选项。
一、硬件架构
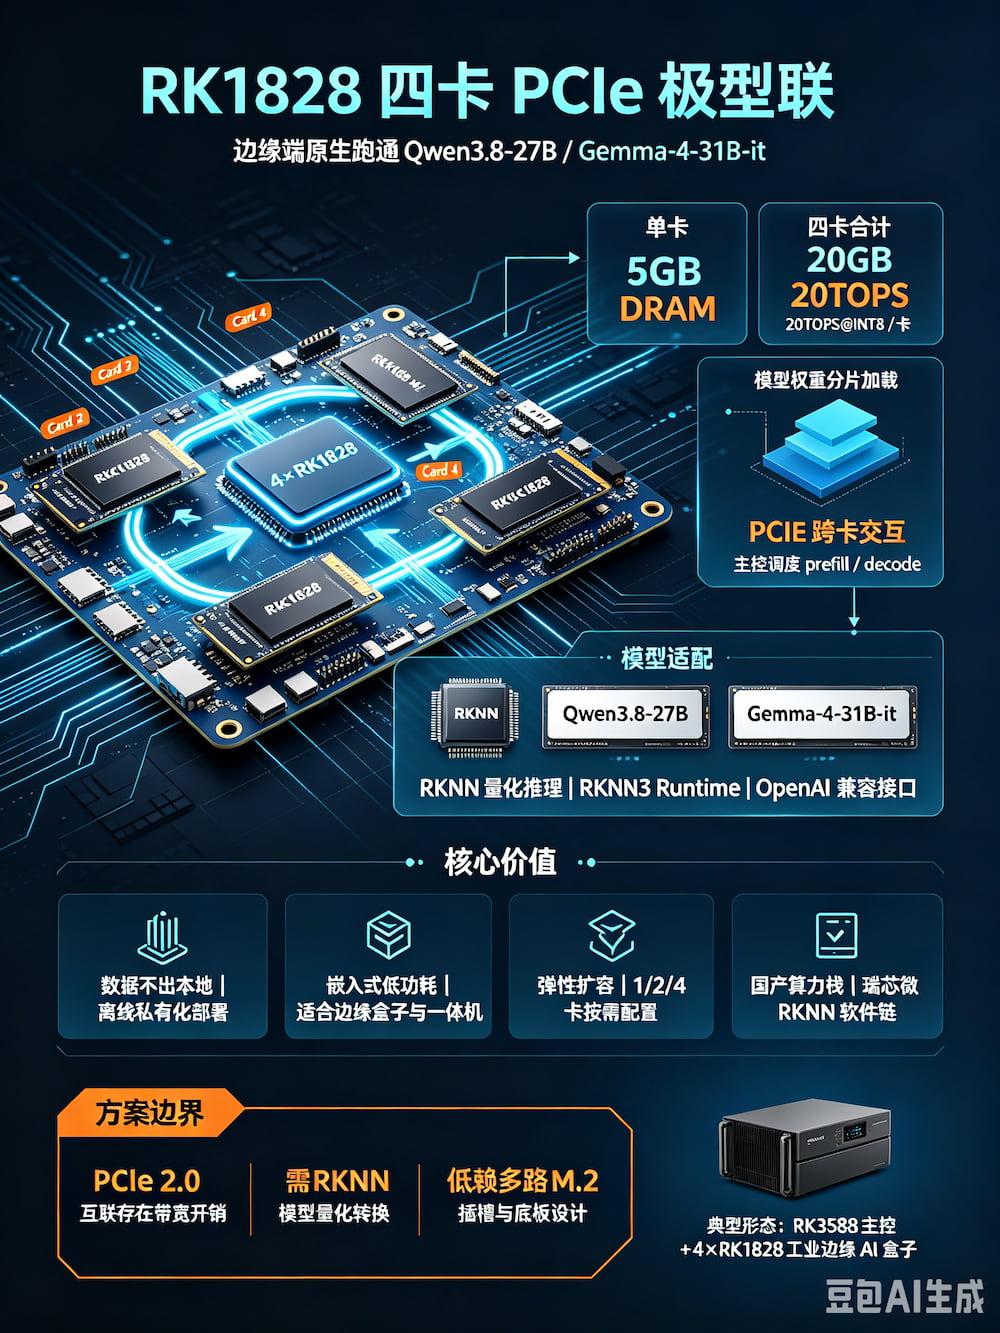
RK1828:单卡内置5GB 片上 DRAM,NPU 算力 20TOPS@INT8,M.2 2280 M-key,PCIe2.0 接口;单卡原生最大 7B 模型推理
四卡级联:4 张 RK1828 通过 PCIe 与主控(RK3588/RK3576/x86)互联,模型张量并行分片,4 个模型 segment 分别加载到 4 张卡,主控做 pipeline 调度 prefill/decode,跨卡通过 PCIe 完成数据交互
总片上内存:4×5GB=20GB,刚好承载量化后的 27B/31B 稠密大模型,无需依赖主机 DDR 加载模型权重,规避内存墙问题,这是该方案核心优势
二、模型适配
1. Qwen3.8-27B:通义千问 3.8 版本 27B 稠密模型,百万级上下文,文本 + 多模态,支持行业知识库、代码、复杂 Agent 推理
2. Gemma-4-31B-it:Gemma4 31B 稠密指令微调版,256K 上下文,图文理解、长文本推理能力强
说明:模型需要做 RKNN 量化,在 RKNN3 Runtime 上推理;对外提供兼容 OpenAI 接口的 RKLLM3 Server,可直接对接 WebUI/Agent 应用
三、核心价值(边缘场景)
✅ 数据不出本地:离线 / 弱网工业场景,数据不传到云端,满足工控、明厨亮灶、智慧工地、光伏巡检、船舶、服务区私有化 AI 合规要求
✅ 嵌入式低功耗:对比 GPU 服务器,整机功耗大幅降低,适合无人值守边缘盒子、嵌入式一体机
✅ 弹性扩容:可以 1 卡跑 7B、2 卡跑 13B、4 卡跑 27B/31B,按需配置算力,硬件复用
✅ 国产算力栈:瑞芯微 RKNN 完整软件链,国产化替代路线,供货可控
四、局限
1. PCIe2.0 互联带宽存在开销,prefill 阶段、多轮长上下文下的 token 吞吐弱于同价位 GPU 卡,更适合并发不高、看重离线私有化部署场景,不是高并发云端推理方案
2. 必须使用 RKNN 模型量化,原生 GGUF 不能直接跑,需要模型转换流程
3. 四卡需要主板支持多路 M.2 PCIe 插槽,硬件底板定制门槛高于普通 x86 显卡
五、典型落地形态
边缘 AI 大模型一体机:RK3588 主控 + 4×RK1828 M.2 算力卡,整机做成工业盒子,本地部署 27B/31B 大模型,实现本地知识库问答、视觉 + 文本多模态 Agent、工业故障分析。
请用手机扫码查看分享内容
 下一篇:边缘 AI 算力方案:LQ50 Duo(力擎LQ50 Duo 双芯片M.2卡)与 RK1828 四卡级联对比分析
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部