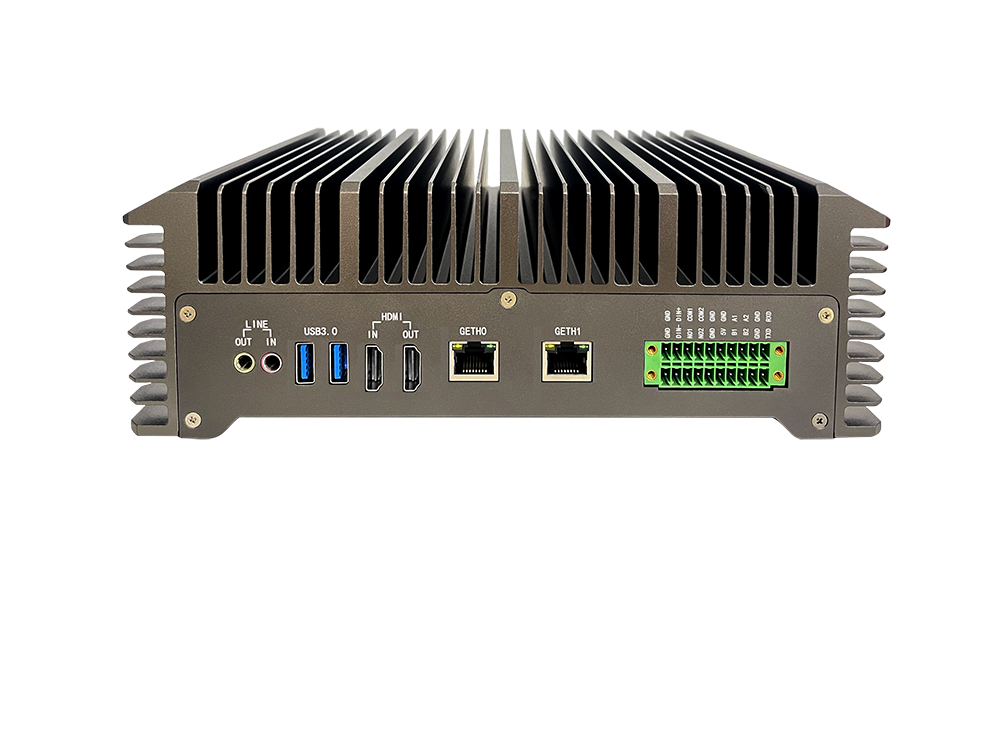
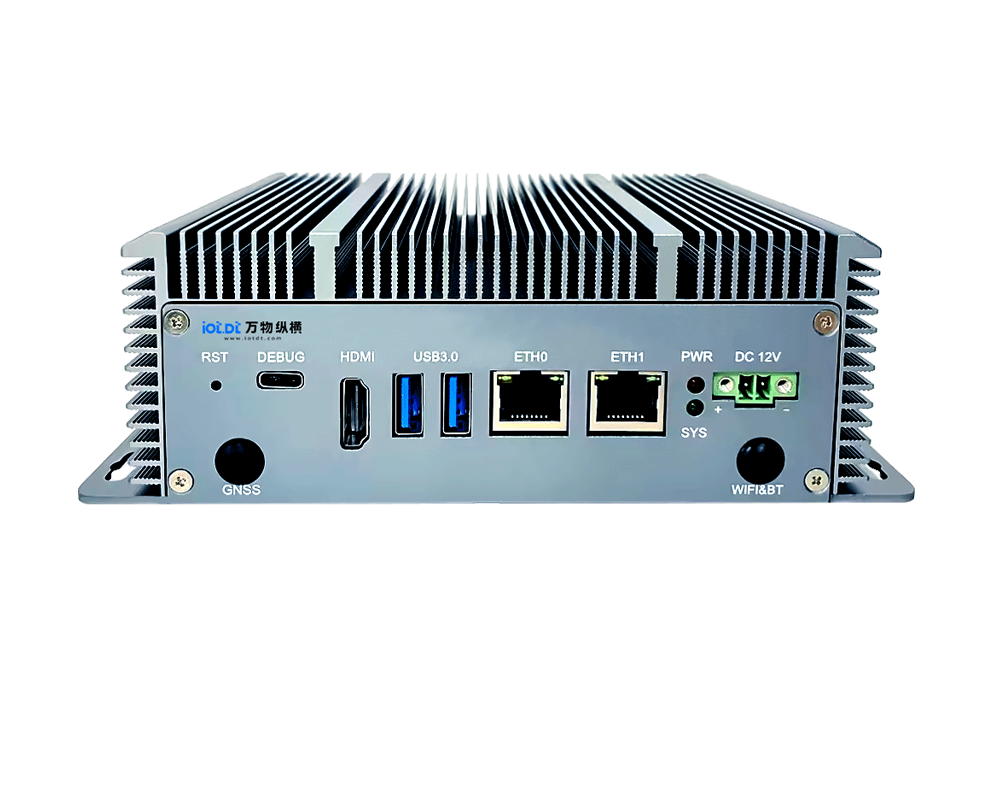
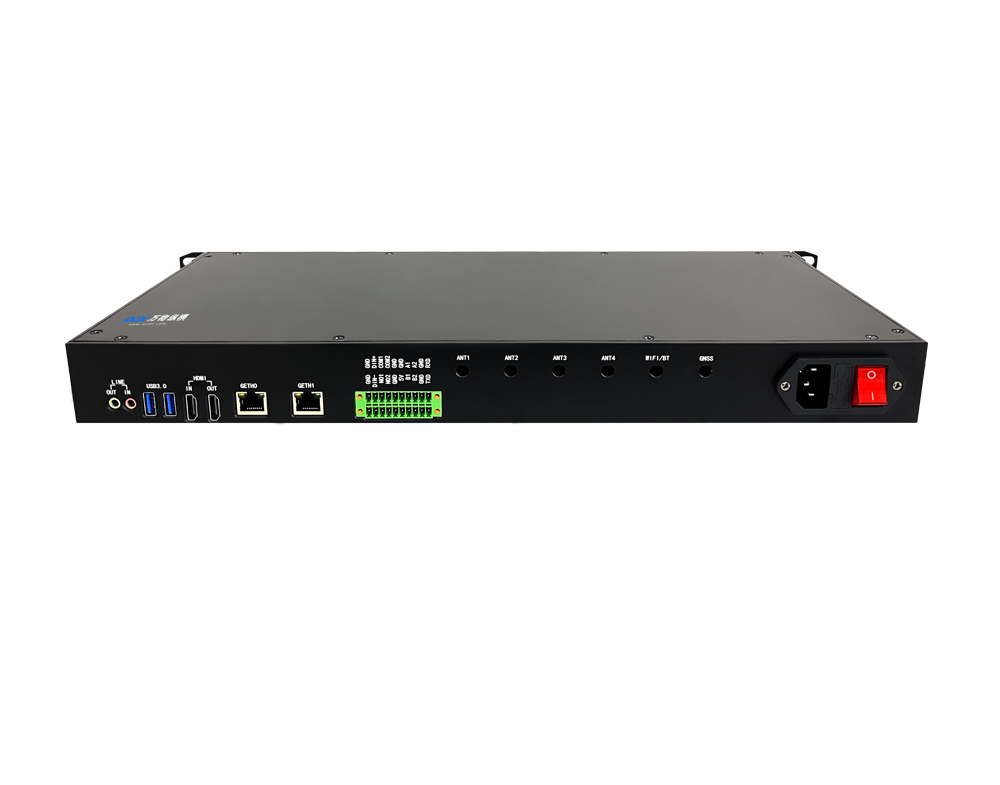
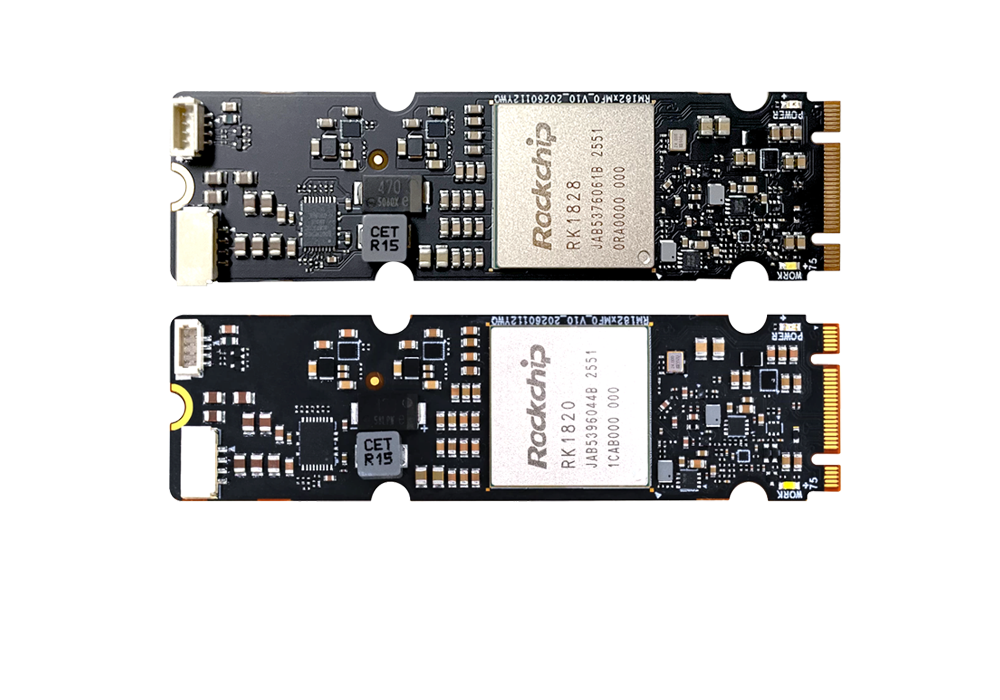
LQ50 Duo 单卡集成双 M50 存算一体芯片,超高单卡算力 / 超大显存,适合 70B 级大模型、高吞吐;RK1828 四卡级联是 4 张独立 M.2 协卡堆叠,优势在多路视觉 + LLM 混合业务、成本可控、生态成熟,主打 27B 以内稠密模型。

核心参数对比表
项目 | ||
架构 | 单 M.2 卡内集成 2 颗 M50 存算一体芯片 | 4 张独立 RK1828 协卡,PCIe2.0 由 RK3588 主控调度 |
INT8 总算力 | 320 TOPS | 80 TOPS(单卡 20TOPS) |
显存 | 最大 96GB(单 M50 最高 48GB) | 20GB(单卡 5GB,4 卡合计) |
单卡功耗 | ≤26W(双芯合计,单 M50≤13W) | 4 卡满载约 40W(单卡 7~10W) |
PCIe | PCIe4.0 x4 | PCIe2.0 x4 每张卡 |
芯片特性 | 存算一体,片上高带宽,大模型高吞吐 | 3D 堆叠 DRAM,RISC-V+NPU 协处理器,视频 / 视觉推理强 |
推荐模型上限 | 70B 参数稠密大模型、多模态 VLM | 27B 稠密模型(Qwen3.8-27B),7B 模型多路并发 |
形态 | 单张 M.2 2280,只需一个 M.2 插槽 | 占用 4 个 M.2 插槽,需要主板支持 4 路 PCIe2.0 |
SDK | 后摩大道 | RKNN3(瑞芯微成熟生态) |
架构与性能差异
LQ50 Duo
1. 单卡双芯:一块 M.2 卡内部封装两颗 M50,只占用 1 个 M.2 插槽,对主板插槽数量友好,整机集成度高。
2. 超大显存 + 存算一体,核心优势是大模型 token 吞吐高,适合单任务跑 70B 大模型、长上下文、大尺寸多模态 VLM。
3. PCIe4.0 带宽更高,减少主机与算力卡之间数据搬运瓶颈;短板是生态较新,视觉检测(YOLO 等传统 CV)配套不如 RKNN 成熟。
4. 适合:单任务大 LLM/VLM,追求高 token 输出,机箱空间有限,不想占用多个 M.2 口。
RK1828 四卡级联
1. 分布式多卡协处理:4 张独立 RK1828 算力卡,每张自带 5GB 独立片上内存,主控 RK3588 负责视频解码、多路摄像头、业务调度,算力卡专职 LLM 推理,视觉业务和大模型硬件资源隔离互不抢占,是智慧工地、明厨亮灶这类多路视频 + 大模型分析的经典方案。
2. RKNN3 生态成熟,CV 检测、VLM、语音、LoRA 微调工具链完善,适配 Qwen 全系列,工程落地案例多。
3. 短板:4 张卡占 4 个 M.2 插槽,需要主板具备 4 路 PCIe2.0;总显存仅 20GB,上限卡在 27B 稠密模型;单卡算力低,大模型 token 吞吐远低于 LQ50 Duo。
4. 适合:多路摄像头视觉检测 + LLM 并发,AIoT 边缘盒子,项目需要快速落地、大量 CV 算法,预算敏感。
功耗、散热、成本对比
功耗:LQ50 Duo 满载≤26W;RK1828 四卡满载约 40W。LQ50 Duo 总功耗更低,但单卡热密度更高,散热器要求更高;RK1828 四张卡分散发热,散热压力更小,可自然散热方案。
硬件成本:RK1828 单卡单价低,四卡方案BOM 成本更低;LQ50 Duo 单卡价格更高,但只需要 1 张卡,省去多卡主板、多路 PCIe 电源开销。
主板资源:RK1828 四卡最大痛点:必须 4 个 M.2 插槽,很多商用边缘主板很难同时支持 4 路 PCIe;LQ50 Duo 仅 1 个 M.2,主板选型简单。
选型建议
✅ 选 LQ50 Duo,如果你:
1. 重点跑70B 级大模型 / 长上下文多模态 VLM,追求高 token 吞吐
2. 主板 M.2 插槽少,希望单卡双芯、节省空间
3. 项目以 LLM 为主,CV 视觉任务不多
✅ 选 RK1828 四卡级联,如果你:
1. 场景是多路视频 + 大模型混合推理(智慧工地、光伏巡检、明厨亮灶)
2. 模型规模≤27B,大量 YOLO、目标检测、图像分析 CV 任务
3. 需要成熟 SDK、丰富工程案例,优先控制 BOM 成本,需要分散式低发热设计
补充拓展方向
如果需要兼顾两者:可以采用 LQ50 Duo 做大 LLM 主推理,RK1828 单独承担多路视频视觉检测,分工部署。
模型并行门槛:RK1828 多卡级联已经有官方 Qwen 27B 适配;LQ50 Duo 双芯是卡内并行,软件调试逻辑和多卡 PCIe 级联不一样。
请用手机扫码查看分享内容
 下一篇:多路视频 + LLM 落地复盘!LQ50 与 LQ50 Duo 选型避坑指南
 需求留言:
领先的边缘智能产品与解决方案提供商



华北地区负责人:17340067106(毛经理)
华东地区负责人:17358670739(甘经理)
华南、华西地区负责人:19113907060(耿女士)
软件算法咨询:18982151213(刘先生)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)
 试用申请
 硬件设备咨询
软件算法咨询
 在线客服
 回到顶部