
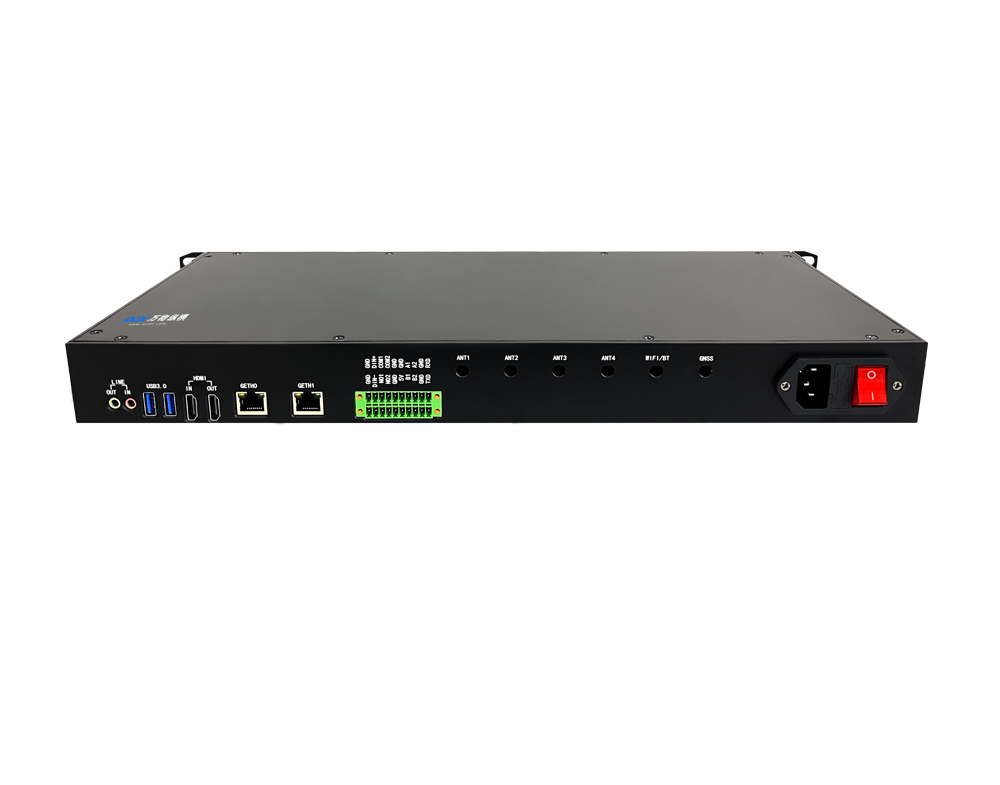
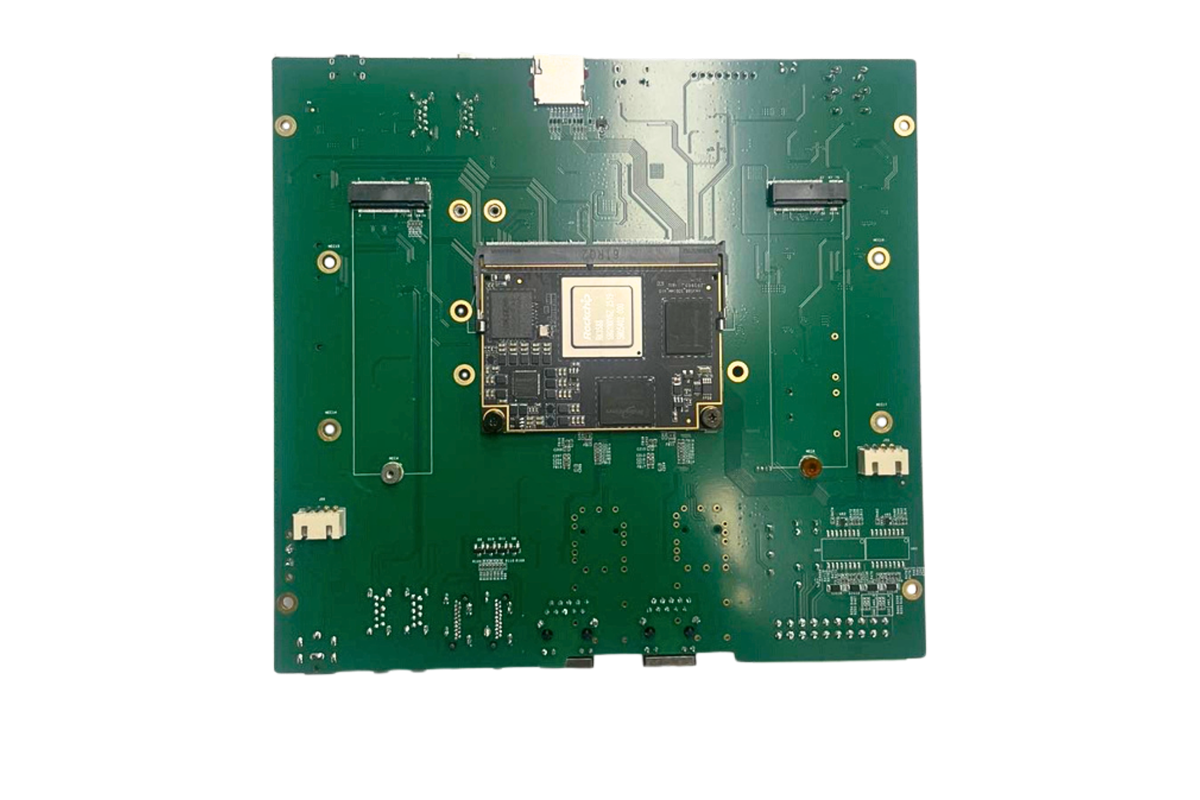
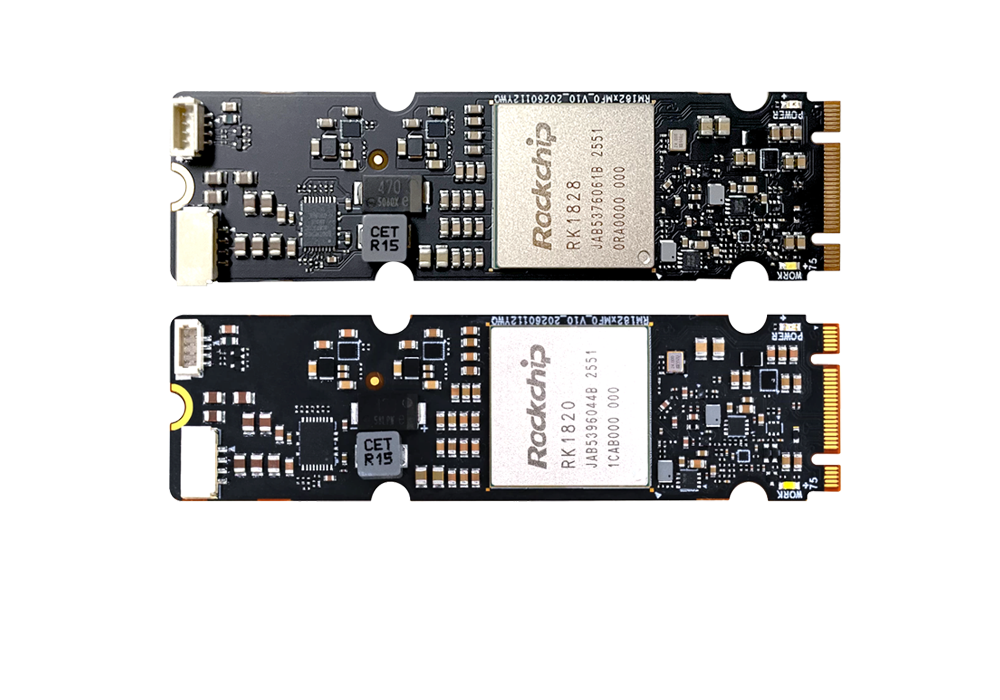
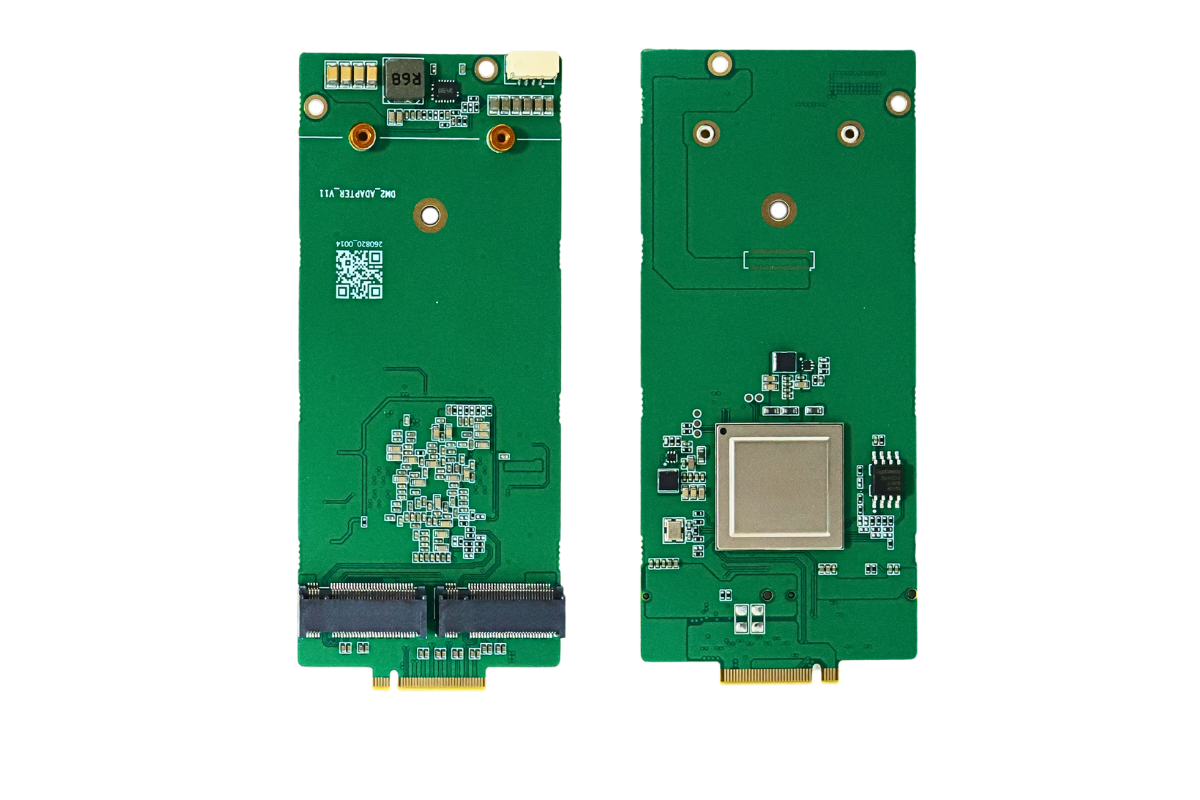


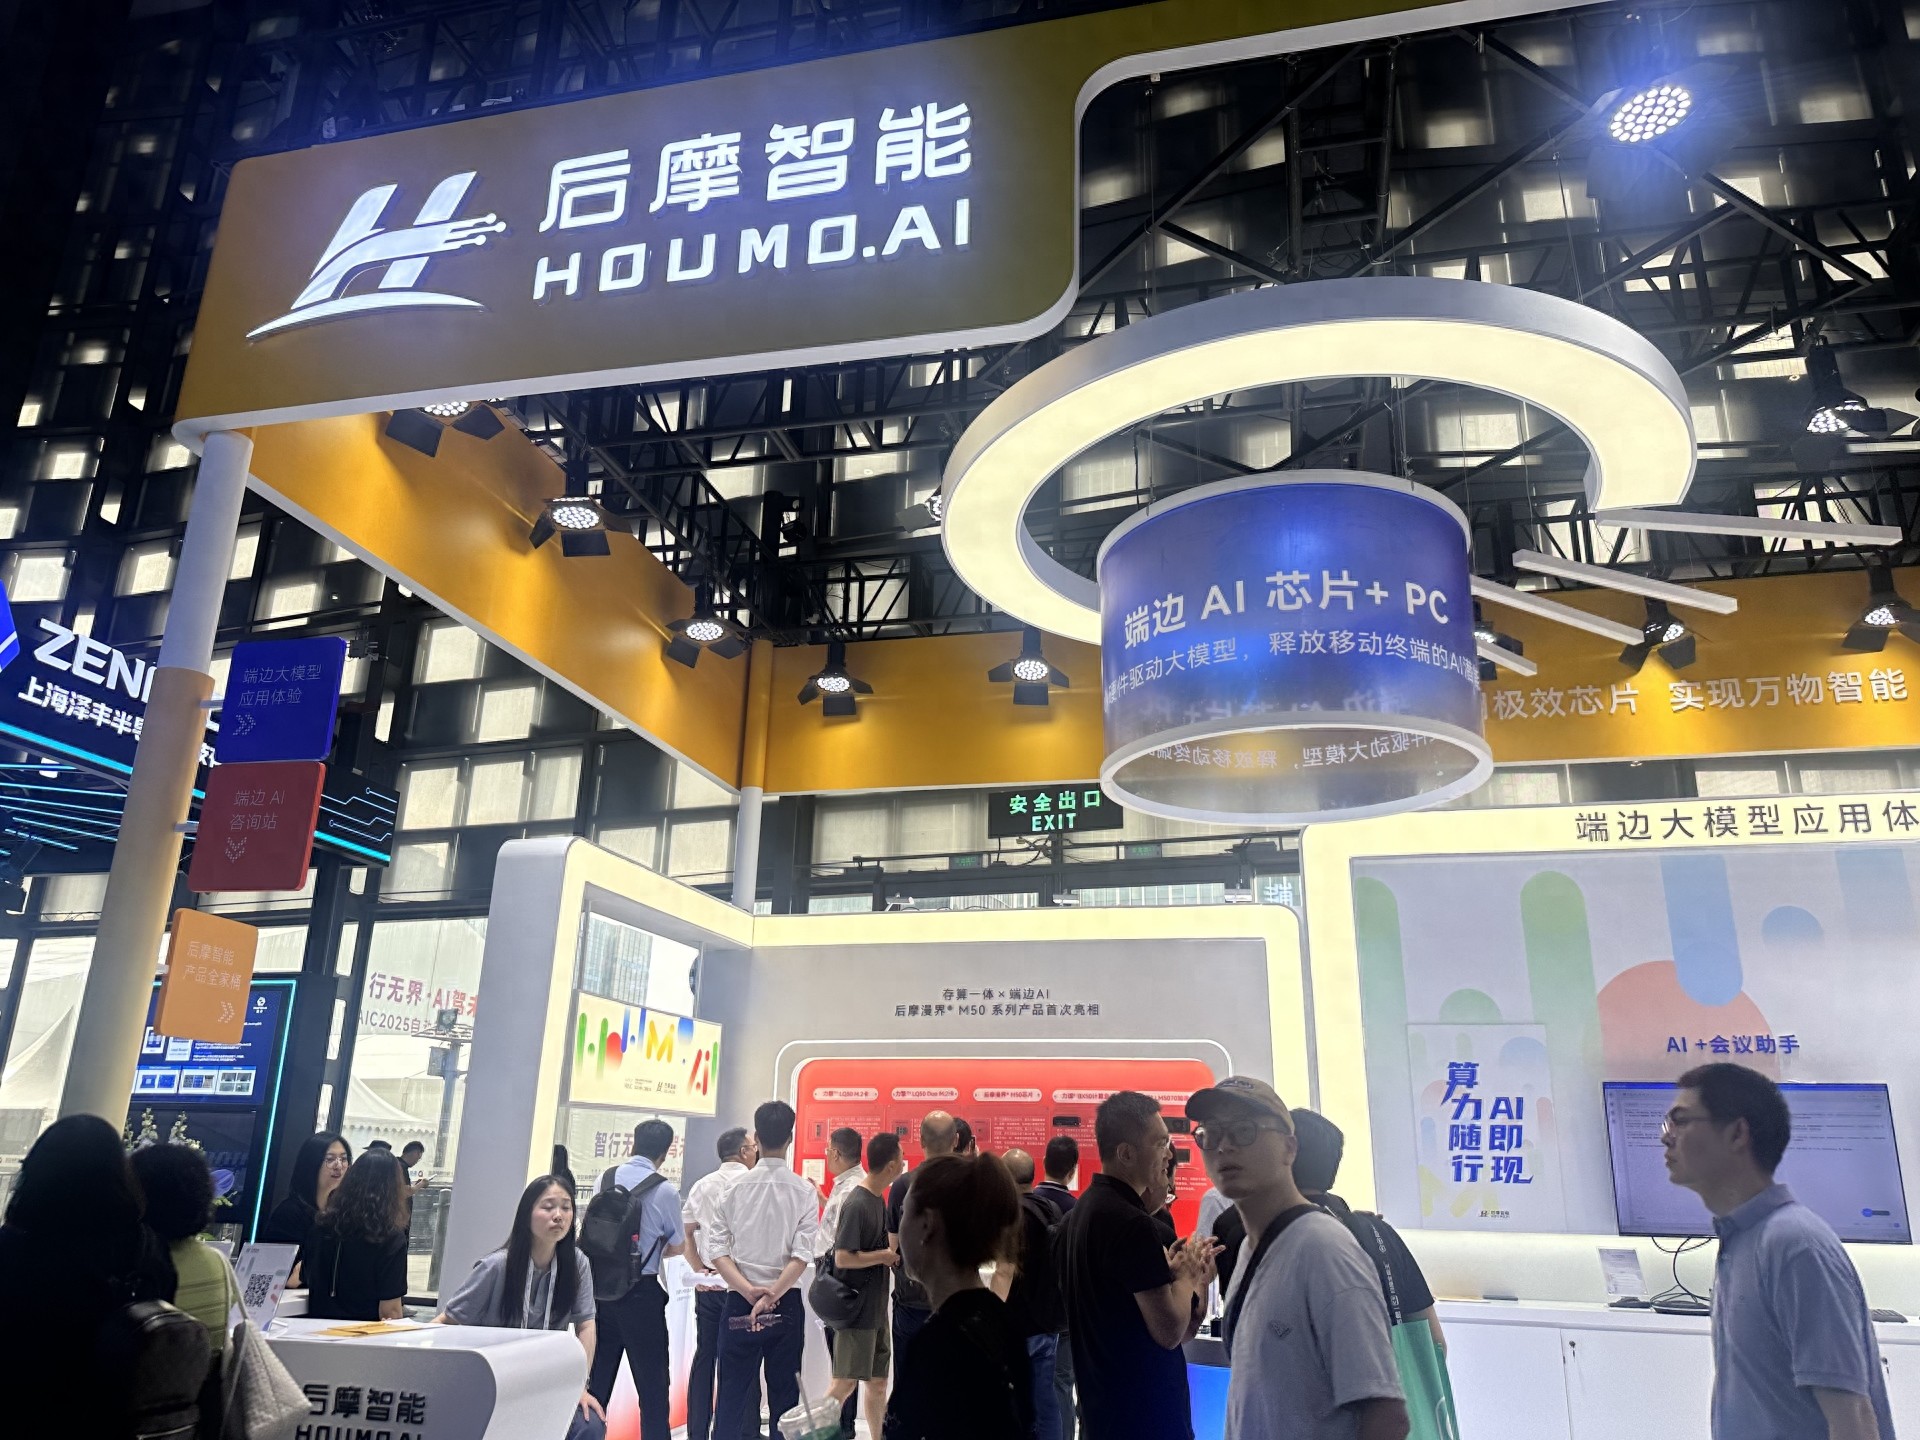
LQ50 Duo:双 M50 存算一体芯片,标准 M.2 2280 规格、OCP Dual 双芯互联,320TOPS INT8,板载 48GB LPDDR5X,带宽 307.2GB/s,主打边缘本地大模型推理,依托后摩大道 ®(DaDao)软件栈完成模型编译、量化、双芯负载拆分与调度。
一、云栖大会相关通义模型适配现状
云栖发布的 Qwen 系列(通义千问)是 LQ50 Duo 重点适配模型,后摩大道软件栈持续迭代,在云栖新版本发布后做模型移植与算子补齐:
1. Qwen2 / Qwen2.5 系列(优先稳定)
Qwen2.5-7B、14B:单芯 LQ50 可跑;LQ50 Duo 双芯拆分权重,原生支持 14B 流畅推理,是边缘私有化部署主力。
Qwen2.5-32B:Duo 双芯联合推理,权重切分到两颗 M50,适合本地私有化知识库、RAG。
2. 云栖新版 Qwen3 / Qwen3-VL 多模态
Qwen3 4B/8B 文本模型:已完成算子适配,INT8/bFP16 混合量化;
Qwen3-VL(视觉语言):云栖更新后完成 VLM 多模态链路适配,支持图片 + 文本联合推理,用于智能安防、本地图文理解;
限制:Qwen3 大参数量 MoE 模型,LQ50 Duo 不支持完整本地加载,适合拆分为轻量激活分支部署。
3. 魔搭社区模型
大道工具链支持直接导入魔搭权重,自动量化、算子替换;云栖期间重点演示:Qwen-VL、MiniCPM-o 多模态模型在 LQ50 Duo 本地端侧推理方案。
补充:云栖本身没有发布 LQ50 Duo 硬件新品,是后摩在云栖生态下,同步更新大道 SDK,完成当年云栖新发布通义模型的适配。
二、LQ50 Duo 双芯适配核心机制(大道 DaDao 栈)
LQ50 Duo 不是两张独立 LQ50 简单堆叠:板载双 M50 高速片间互联,由大道推理引擎做模型权重分片 + 负载均衡。
1. 模型编译:将 HF 权重 → 后摩 IR → 算子优化、量化(INT8 为主,bFP16 保留关键层精度)
2. 双芯切分策略:LLM 按 Transformer 层拆分到两颗 M50;VLM 可视觉编码器放芯 0、LLM 解码器放芯 1 并行。
3. 固件升级:双芯固件与单芯 LQ50 固件不通用,升级命令需要指定双设备 ID hm_upgrade_cli burn-image -d 0 1,用hm_smi -a查看双芯片状态。
4. 系统支持:Linux (x86)、Windows、国产 OS;容器化 Docker 推理镜像,可一键拉起 Qwen 服务。
三、适配清单(云栖更新后)
模型 | 参数 | 部署形态 | LQ50 Duo 适配说明 |
Qwen2.5 | 7B | 单芯可跑,Duo 冗余高并发 | 成熟稳定,推荐 |
Qwen2.5 | 14B | 双芯权重分片 | 边缘 LLM 主力 |
Qwen2.5 | 32B | 双芯联合推理 | 低并发本地私有化 |
Qwen3 | 4B/8B | 双芯,支持多并发 | 云栖新版本适配完成 |
Qwen3-VL | 4B/8B | 双芯,VLM 流水线 | 图文、视频帧理解 |
MiniCPM-o | 2.6B | 双芯多模态(音视频 + 文本) | 端侧语音视觉 Agent |
四、部署 & 升级要点(云栖模型上新操作)
1. 更新后摩大道 SDK + 固件
优先升级大道推理栈到云栖配套版本,更新 LQ50 Duo 双芯固件,固件必须使用 Duo 专用镜像,不能用单 LQ50 固件刷写。
2. 模型转换
# 大道模型转换工具,HF权重转M50模型包
hm_model_convert --model qwen2.5-14b --quant int8 --split dualchip
1. 双芯推理启动
引擎自动做层拆分,无需手动切分权重;支持 RAG、本地向量库联动。
2. 性能参考
Qwen2.5-14B INT8:Duo 双芯,典型 20~30 token/s(视 prompt 长度);VLM 图像推理百毫秒级。
五、边界与局限
1. 不支持超大 MoE(Qwen3-2.4T 这类)完整本地推理;
2. 双芯互联带宽有限,32B 模型并发不能太高,适合低并发私有化场景;
3. 云栖新模型部分新增算子需要等待大道 SDK 版本迭代,刚发布时可能存在算子缺失,后续版本补齐。
六、典型落地场景(云栖展示方向)
AI PC 本地大模型、边缘智能盒子、工地 / 园区本地多模态安防(Qwen3-VL 视频理解)、离线 RAG 知识库、本地智能会议语音 + 文本 + 视觉多模态 Agent。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部