
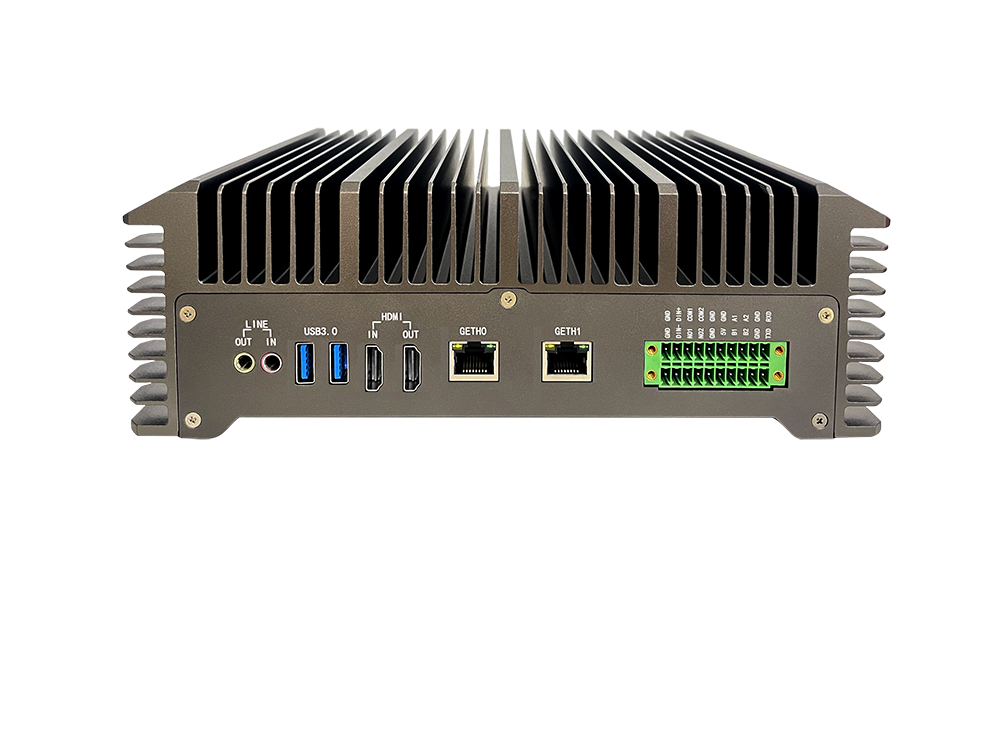
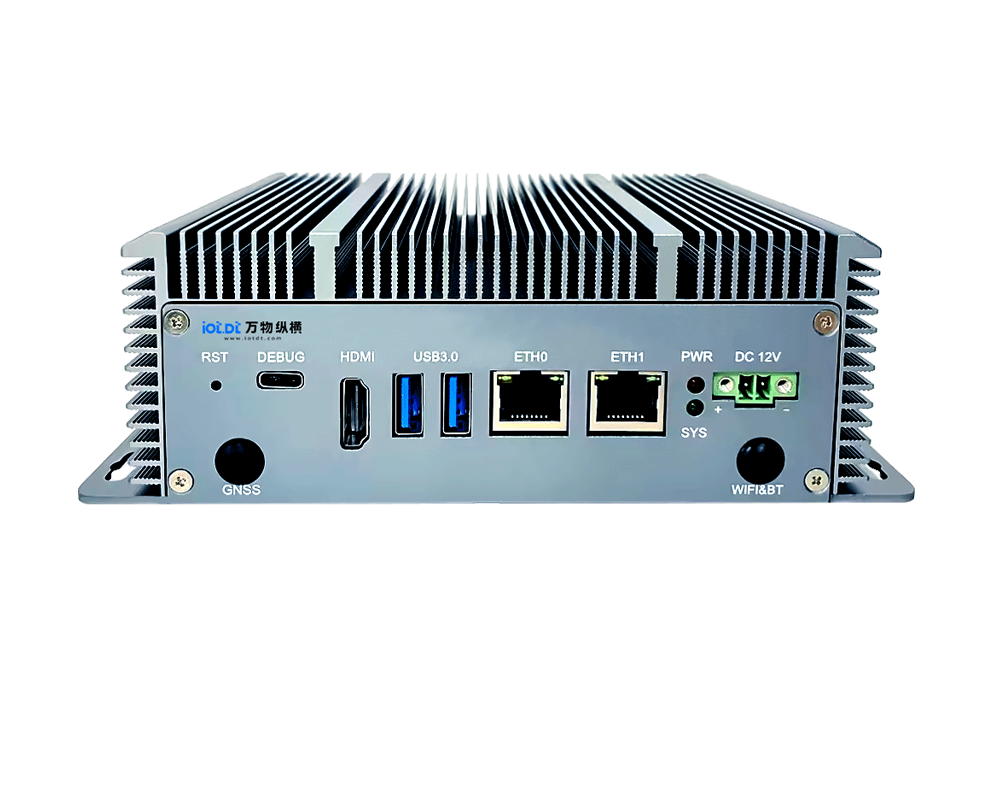
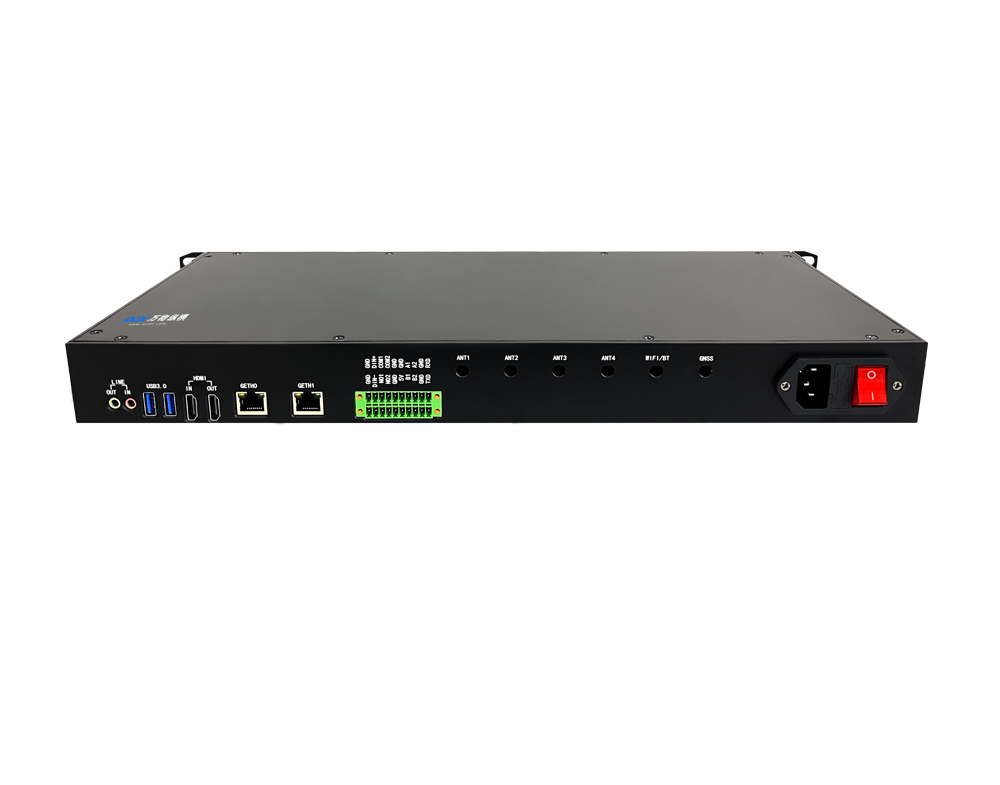
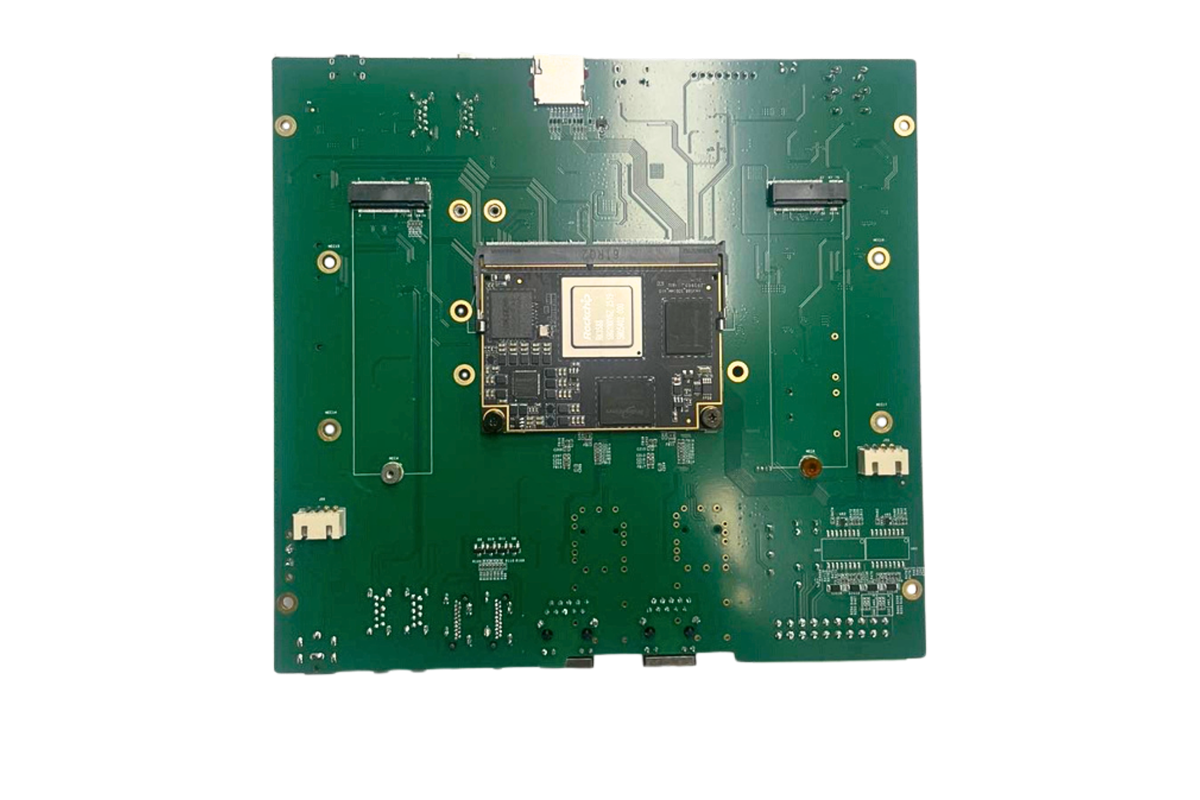
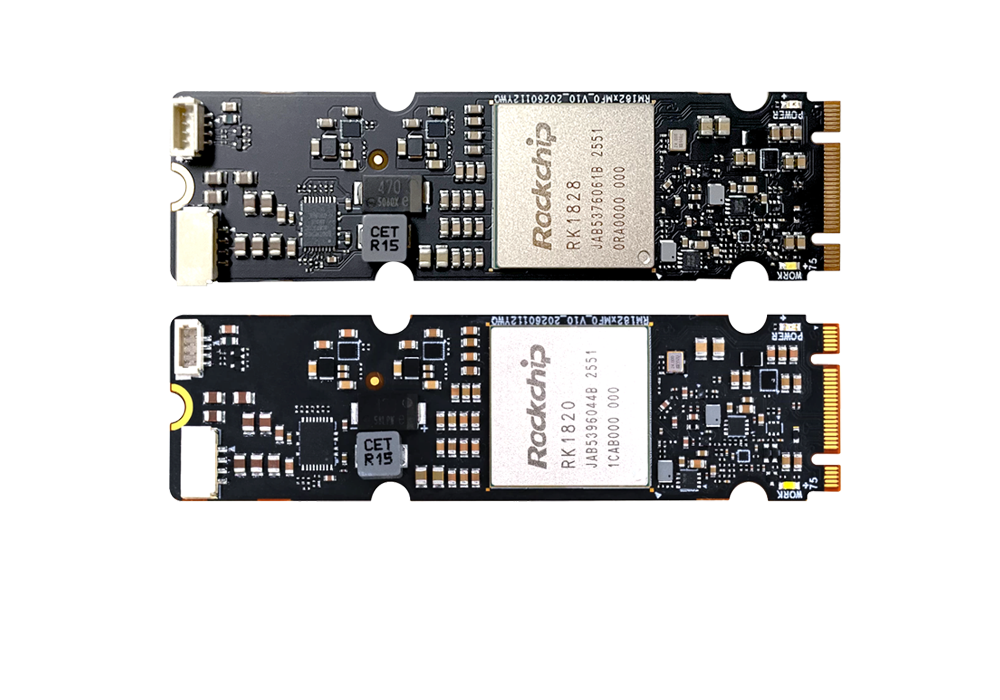
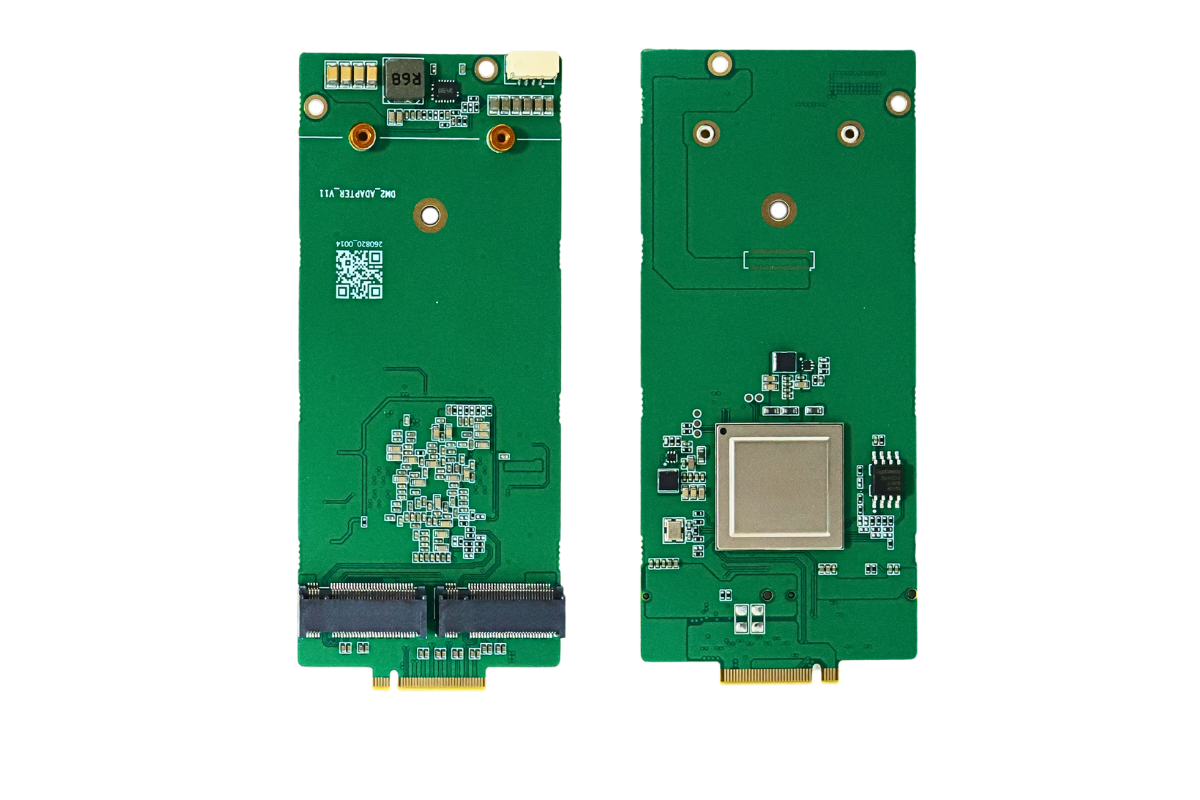


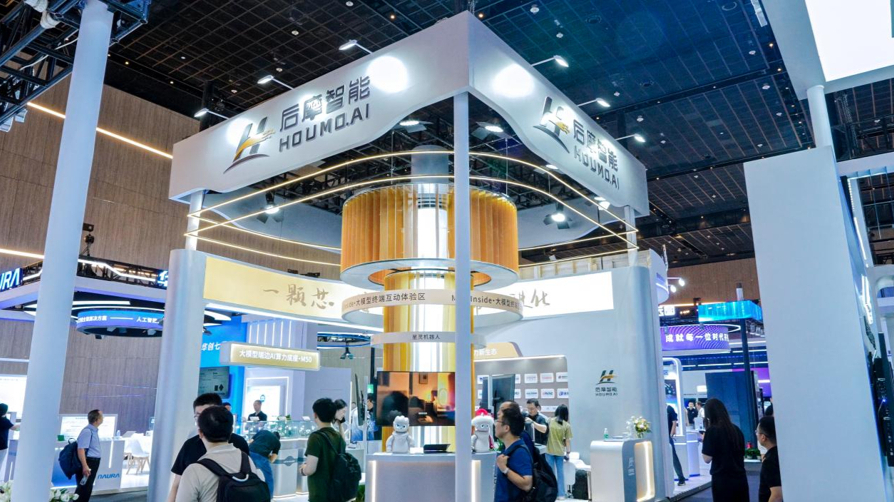
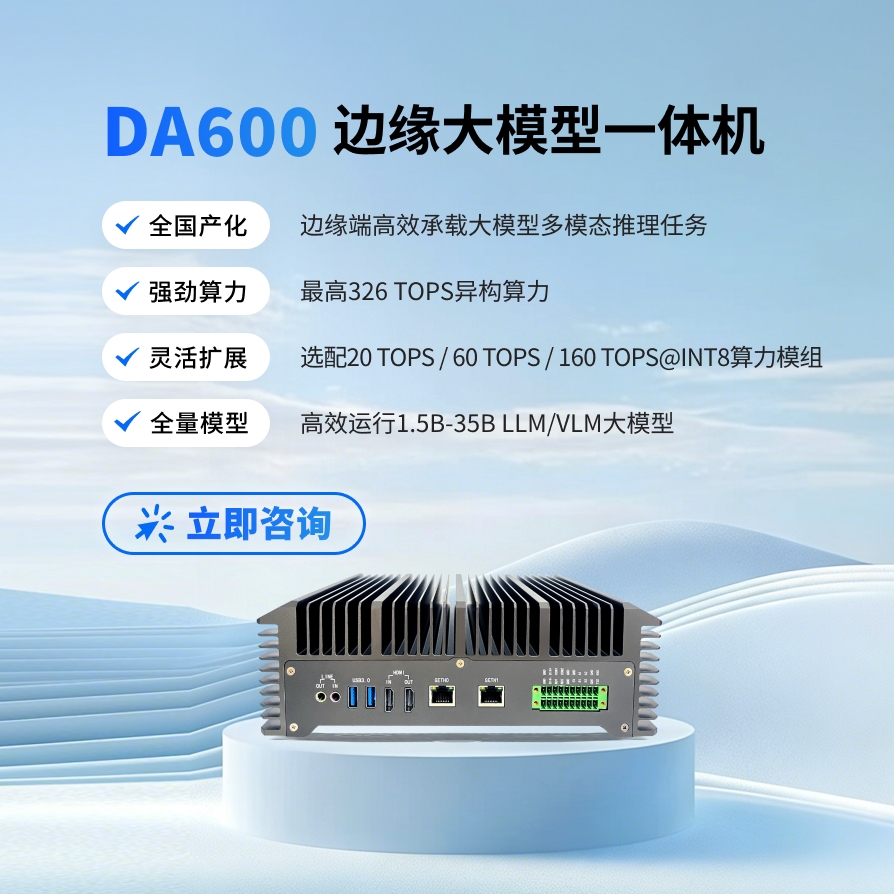
后摩智能力谋 BX50是基于自研漫界 M50 存算一体芯片打造的 All-in-One 边缘计算盒子,目前进入工程样机验证阶段,主打低功耗本地大模型推理 + 多路视频分析,直面 RK3588、BM1684X、LQ50 等主流边缘算力硬件竞争。
核心硬件规格
NPU:单片后摩 M50 存算一体芯片,160TOPS@INT8,100TFLOPS@bFP16,AI 典型功耗仅10W
主控:RK3588(4×A76+4×A55)+Mali G610
内存组合:8GB LPDDR4X +12GB LPDDR5,带宽 153.6GB/s
接口:双千兆网口、WiFi / 蓝牙,M.2 插槽可扩展 4G/5G;支持最多32 路视频解码分析,同时跑本地大模型 + 视觉多模态任务
架构亮点:SRAM-CIM 第二代存算一体,打破传统冯诺依曼存储墙,权重就近计算,相比传统 NPU 能效提升 5~10 倍
能力定位
1. 大模型本地推理:单盒可离线跑 7B/8B 流畅对话,也可部署 30B + 大模型,本地推理 25+tokens/s;支持多模态、知识库、Agent 应用,数据不出设备,满足工业、安防隐私合规要求
2. 场景:工业质检、明厨亮灶、智慧工地、车路协同、边缘数字人、离线 AI 工作站;适合对功耗、散热、离线能力敏感的项目
3. 软件栈:自研大道软件栈,适配主流大模型框架,内置存算专属算子库,降低客户模型量化、移植成本
市场竞争看点
优势:极低功耗 + 超高内存带宽是存算一体最大卖点,同等算力下功耗远低于传统 NPU 盒子;单设备同时承载多路视频 + 大语言模型,一体机形态开箱即用,无需额外算力卡。
短板:存算一体属于非传统架构,算子生态、模型适配成熟度仍是工程落地最大考验;处于工程样机阶段,稳定性、长期高低温可靠性、量产交付还需要持续验证。
对标竞品:RK3588、算能 BM1684X/BM1688、力擎 LQ50 系列边缘盒子。传统方案生态成熟,但带宽受限、跑大模型功耗更高;BX50 用存算一体换能效,走差异化路线。
产业意义
边缘市场正在从单纯视频识别,转向视觉 + 大模型 Agent 融合,很多项目需要在边缘节点同时做视频分析 + 本地大模型问答、推理。传统架构带宽瓶颈明显,跑 7B 以上模型功耗飙升。BX50 代表存算一体方案正式从芯片样片走向整机边缘盒子工程化落地,争夺低功耗本地大模型边缘市场份额。
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部