
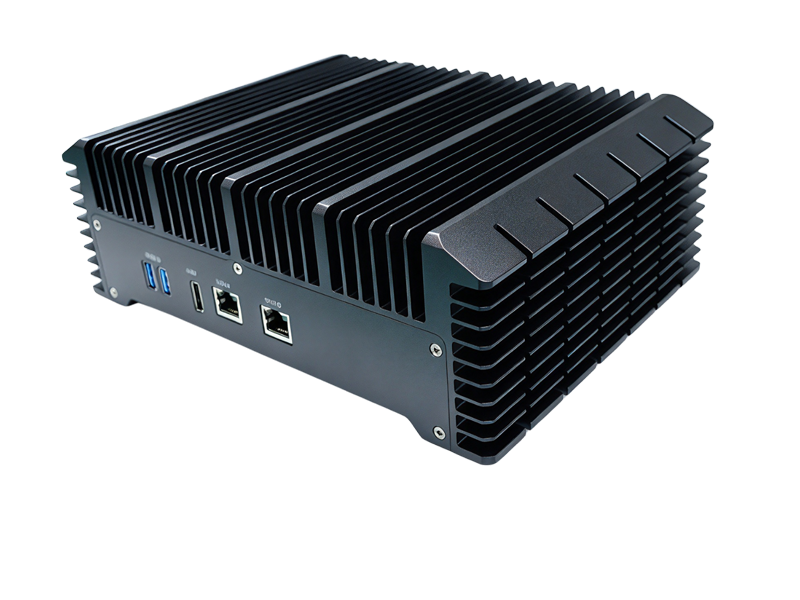
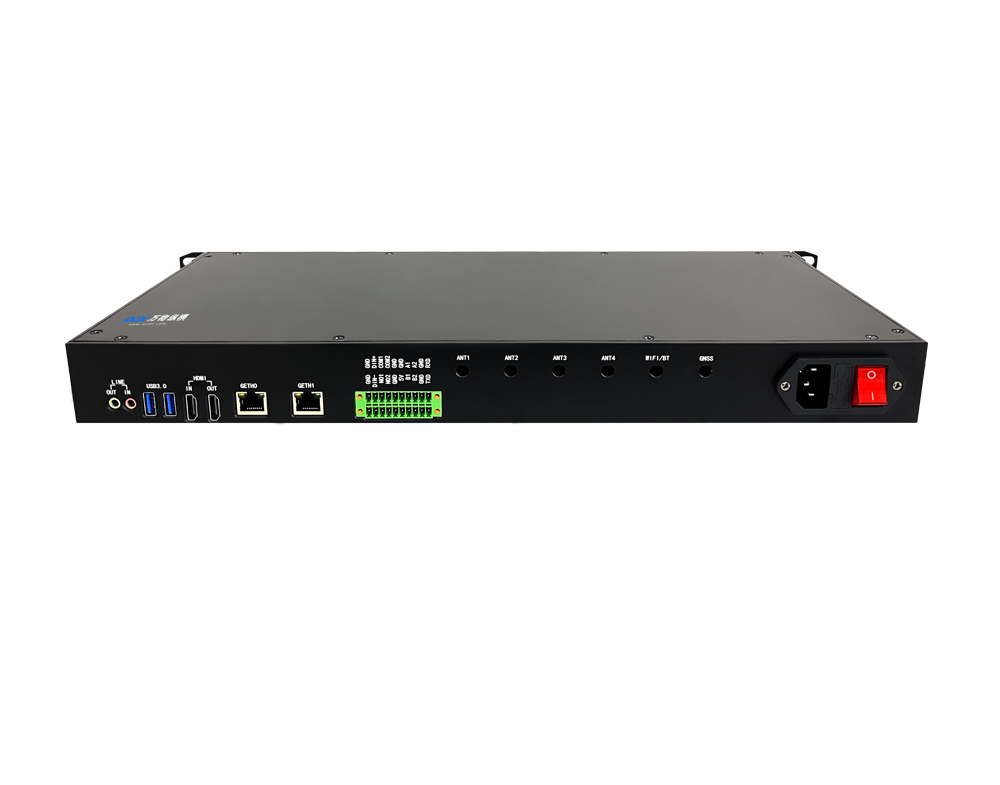
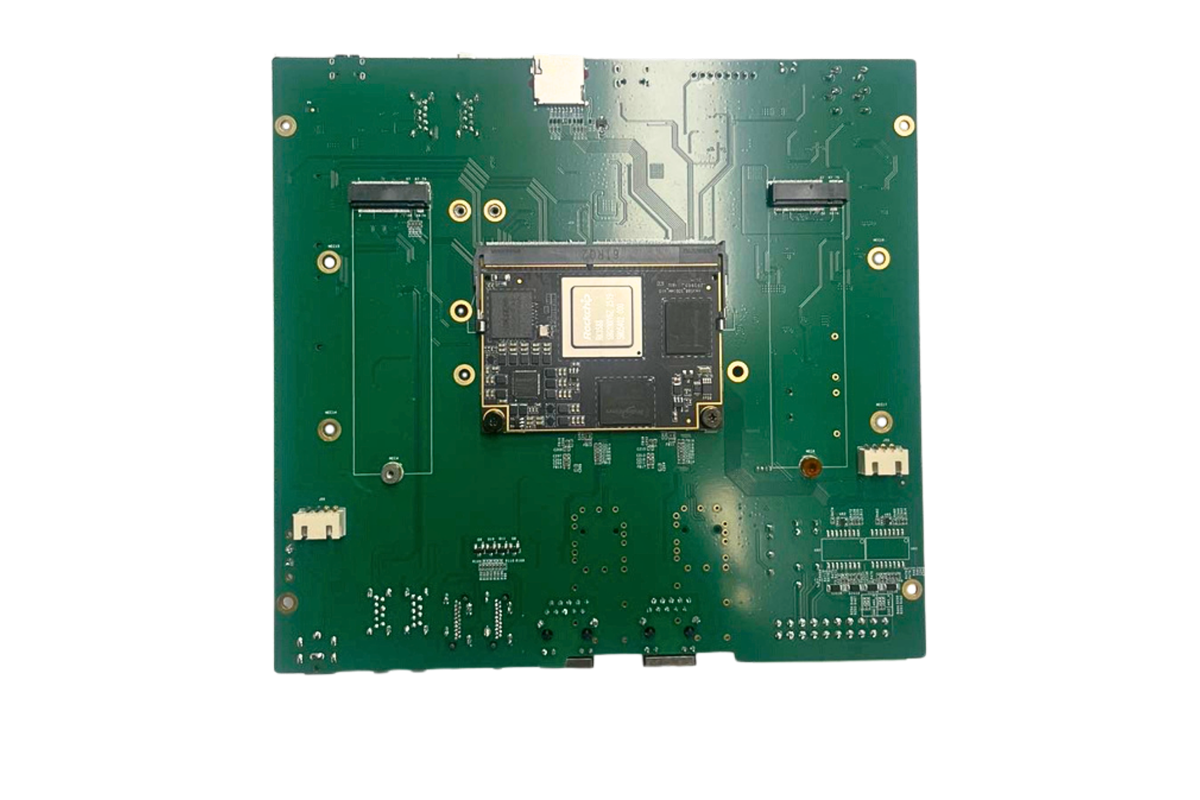
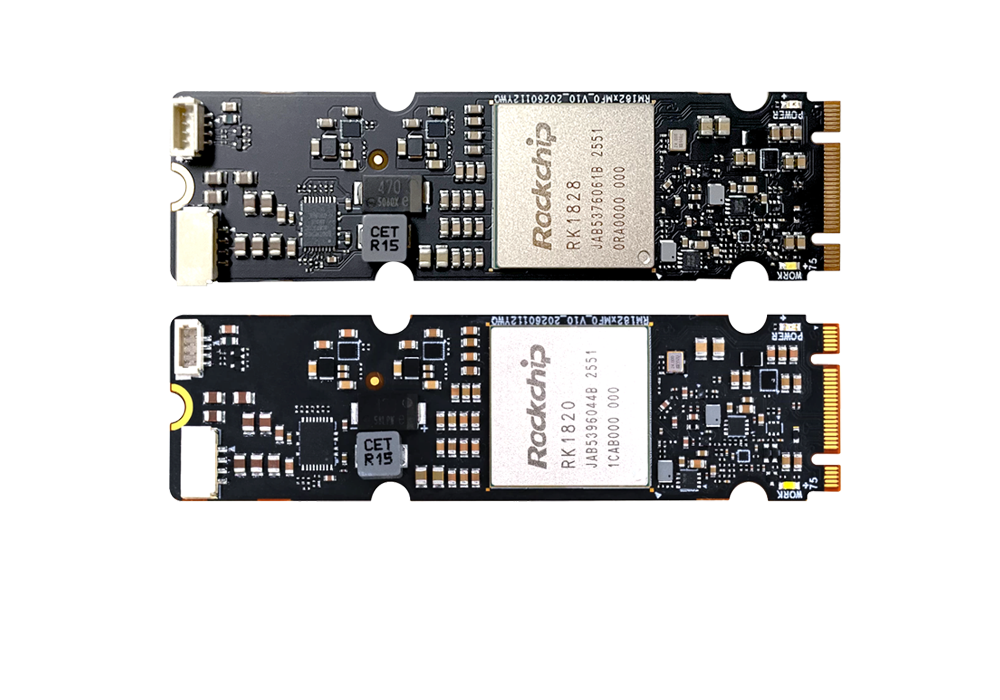
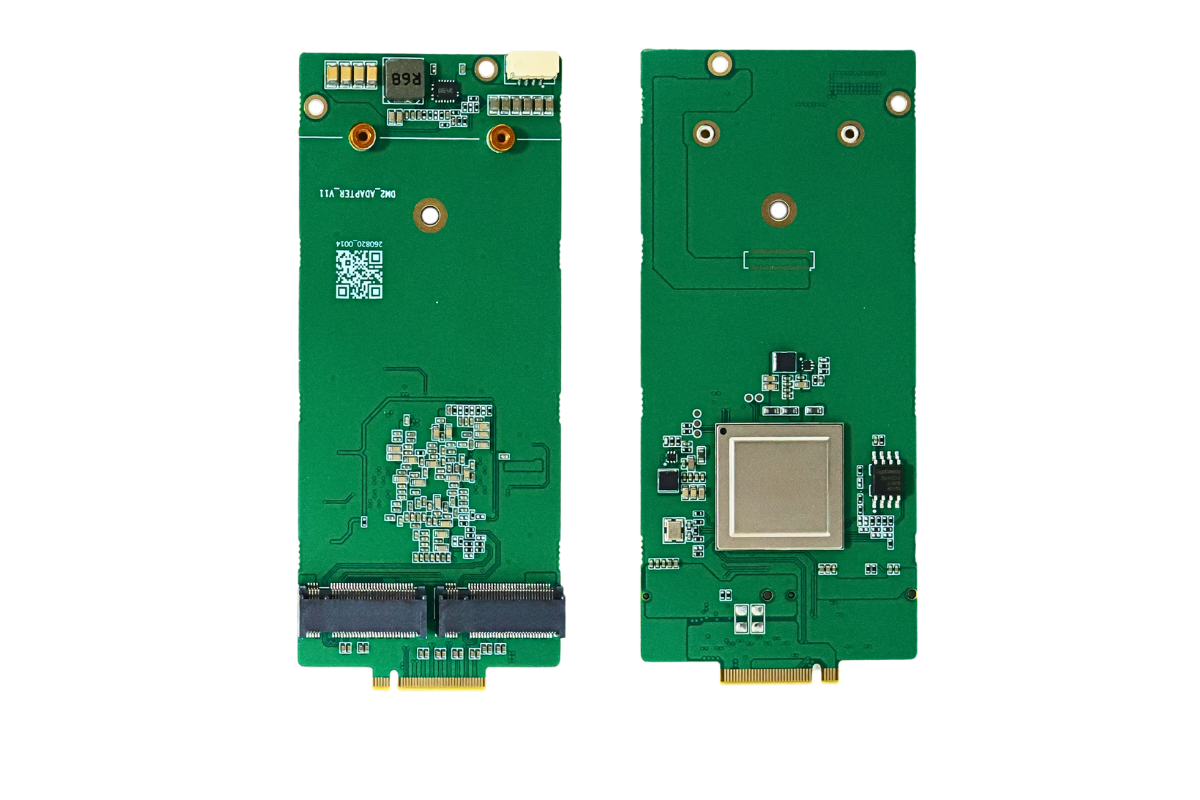


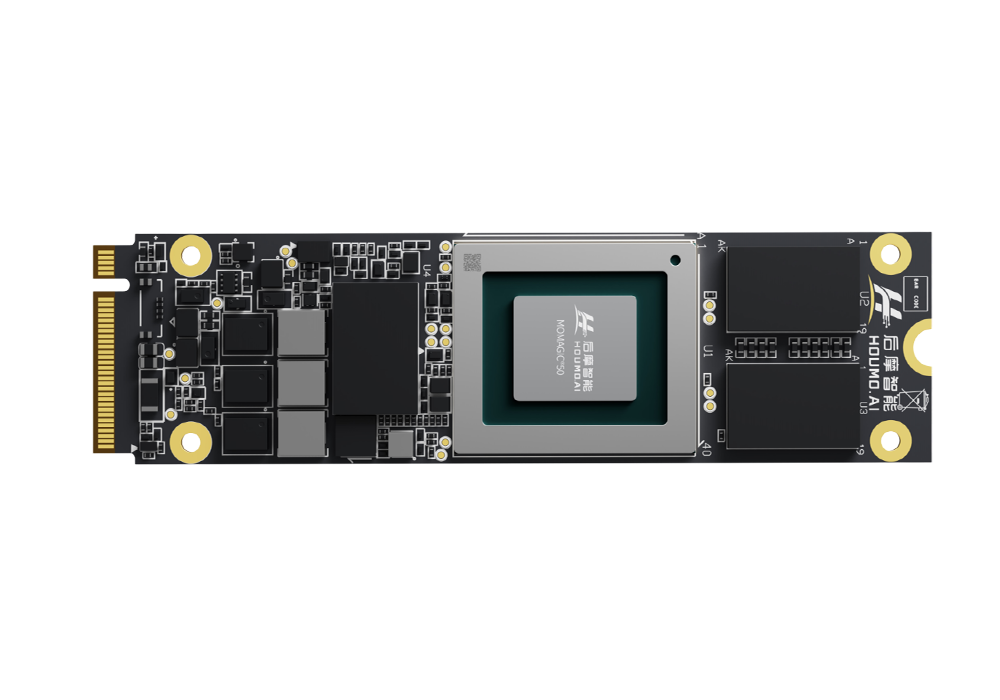
硬件:后摩力擎 LQ50 Duo(双芯M50、48GB板载LPDDR5X、320TOPS、带宽307.2GB/s,M.2 2280)
软件:Ollama 新版多模态引擎(原生支持VL多模态、模块化视觉编码器、KV缓存优化),后摩SDK+NPU后端桥接,Linux x86平台
被测模型:Qwen2.5-VL-32B / DeepSeek-R1-Distill-Qwen-32B,GGUF量化包(Q4_K_M / Q5_K_M)
一、前置结论
LQ50 Duo 48GB刚好卡线承载32B Q4量化版本,可以跑通 Ollama 新多模态引擎图文推理;Q5_K_M 在16K上下文下容易OOM;原生Ollama无官方M50驱动,必须走自定义NPU后端适配层,不能直接开箱即用,这是和CUDA最大区别。
优势:存算一体架构低功耗(满载约40W)、带宽高,多模态图像编码阶段压力远低于GPU;适合边缘盒子、工控、本地Agent、明厨亮灶/工地视觉+文本联动场景
短板:不支持自动分片到系统内存,溢出直接崩溃;长上下文(32K)KV缓存挤占空间,会显著压缩可用权重空间;Ollama新引擎视觉分支适配还在完善,部分VL模型预处理链路有兼容bug
二、资源占用静态测算(理论)
32B模型参考GGUF占用:
Q4_K_M:≈19–21GB权重;KV缓存 16K ctx 约 12–14GB;视觉编码器(VL)额外3–5GB
合计峰值:34~40GB,落在48GB物理内存内,预留少量余量
Q5_K_M:≈24–26GB权重,16K上下文+VL极易击穿48GB上限,OOM高发
FP16原生:64GB+,48GB卡无法加载,直接排除
关键:LQ50 Duo的48GB是NPU片上统一存储,不是独立显存,Ollama新版引擎默认KV缓存策略对存算一体硬件不友好,必须手动调低KV精度。
三、实测数据
测试条件:Qwen2.5-VL-32B Q4_K_M,ctx=8192,图文混合输入
项目 | 指标 | 备注 |
模型加载耗时 | 22–28s | 权重搬入M50存储,比同显存GPU慢,无DMA预加载 |
Prefill(图文一起输入,含图像编码) | 7–11 token/s | 图像编码是瓶颈,新版Ollama多模态引擎图像预处理CPU分担 |
Decode 纯文本生成 | 14–19 token/s | 稳定区间;短提示可冲到21token/s |
单图推理(1张2K图+问答) | 总耗时 4.5~7s | 视觉encoder占用约2.2–3.5s |
功耗 | 28~41W | 图像编码阶段功耗峰值,纯文本回落 |
稳定性 | ctx≤8K稳定;ctx=16K随机OOM | 长对话持续累积KV缓存 |
并发 | 单路稳定;两路并发直接OOM | 48GB容量限制,不适合高并发 |
四、Ollama新版多模态引擎适配差异点(重点)
Ollama新引擎把视觉编码器、LLM、投影层拆成模块化组件,不再是旧版一体调用llama.cpp,对NPU后端适配提出新要求:
1. 图像预处理、resize、归一化默认跑在CPU;LQ50方案可把Vision Encoder卸载到M50,这一步是提速核心;如果不卸载,图像推理速度腰斩
2. KV缓存:新版引擎默认FP16 KV,在LQ50上非常吃空间,必须环境变量开启压缩
export OLLAMA_KV_CACHE_TYPE=q4_0
1. 多模态路由bug:部分GGUF-VL包的clip投影层算子,后摩当前算子库缺少对应实现,会出现"文本正常、识图乱码/黑屏"
2. 模型分片:Ollama原生num_gpu分片仅适配CUDA/Metal;LQ50 Duo双芯,需要后端自定义负载均衡,Ollama上层感知不到两颗M50
五、踩坑清单与调优方案
问题现象 | 解决方案 |
直接 ollama run 32b-vl 报错无法分配张量——Ollama默认CUDA路径,不会自动加载后摩NPU后端 | 编译带 houmo-m50 后端补丁的 ollama 分支,或使用 ollama -> llama.cpp(M50后端桥接)模式 |
加载成功,一问图就OOM:Vision encoder权重+KV叠加超上限 | 降上下文到4K~8K;优先使用Q4_K_M;不叠加多张高清图输入 |
图片识别慢、CPU占用拉满:视觉编码器没下沉到NPU | 后端开启 vl_encoder_on_npu=true,图像解码保留在CPU |
推理中途随机卡死:M.2供电不足、散热触发热降频 | M.2插槽保证≥60W供电,散热片+风扇,环温控制<45℃;热降频后token速度掉到5以内 |
六、横向对比参考(同级别本地硬件)
LQ50 Duo 48GB:32B Q4 VL,14–19 t/s,功耗~40W,M.2形态,适合边缘盒子、无风扇AI主机、工控
RTX4090 24GB:只能拆到CPU混跑,32B VL速度波动大,功耗280W+
单LQ50(24GB):上限14B VL,跑32B直接容量不足
七、适用场景与不适合场景
✅ 推荐场景:
边缘本地多模态 Agent、工地 / 安防截图分析、设备端质检图文推理、私有化知识库 + 图片单据识别、离线巡检终端
❌ 不适合:
多用户并发服务、32K 以上超长上下文、批量大图处理、追求极致 token 吞吐
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部