


差距不在"纸面 TOPS",而在能效、访存瓶颈、通用性。存算一体 NPU(后摩 M50 / LQ50 这类数字 CIM)在大模型推理、高访存场景能效显著领先传统脉动阵列 NPU;但算子生态、训练能力、非稀疏通用计算弱很多,不是全方位碾压。
LQ50 是数字存算一体(漫界 M50),不是模拟 RRAM 存算,精度、稳定性更适合商用边缘推理。
一、存算一体 NPU vs 传统脉动阵列 NPU
传统 NPU(RK3588、BM1684X 这类):冯诺依曼架构,计算阵列和片上 SRAM / 片外 DDR 分离,权重、激活反复在 DDR、片上缓存、计算单元之间搬运。绝大多数功耗耗在数据搬运而非乘法累加本身,即经典"存储墙"问题。
存算一体 CIM NPU:把乘加计算直接做在存储阵列内部,权重驻留在存算阵列里,大幅减少权重反复搬移。
✅ 优势(推理场景,尤其 LLM)
1. TOPS/W 能效更高:LLM 是访存密集型(KV 缓存、权重反复读),存算架构收益最大;同等有效 token 吞吐,功耗明显更低。
2. 延迟更稳、带宽压力小:长上下文、大 KV 缓存场景,PCIe、DDR 带宽瓶颈被缓解。
3. 稀疏、量化推理适配友好:LQ50 支持弹性算力调度,可动态降功耗档位。
❌ 短板(和传统 NPU 比)
1. 训练弱:CIM 天然适合权重固定的推理;反向传播、权重更新效率远不如脉动阵列 NPU / GPU,基本不拿来做训练。
2. 算子灵活性受限:部分非常规算子、图像后处理、自定义算子适配成本高于成熟传统 NPU,依赖厂商 SDK(后摩大道)。
3. 纸面峰值算力 ≠ 有效算力:传统 NPU 峰值 TOPS 容易跑满在 CNN;CIM 的收益高度依赖模型量化、权重复用、算子映射,映射不好能效优势会缩水。
简单理解:跑本地大模型、长文本多轮对话、持续视频流推理,差距很大;跑简单 YOLO 检测、常规 CNN,差距很小,甚至传统成熟 NPU 生态更好用。
二、LQ50 / LQ50 Duo 功耗与规格
公开第三方独立满负载实测数据不多,以下为官方手册 + SMI 监控实测汇总。
项目 | LQ50(单芯 M50) | LQ50 Duo(双芯 M50) |
显存 | 24 GB LPDDR5 | 48 GB LPDDR5 |
峰值算力 | 160 TOPS INT8 / 100 TFLOPS bFP16 | 320 TOPS INT8 / 200 TFLOPS bFP16 |
典型功耗 | 13 W | 22–30 W(推理稳态) |
板级 TDP | 约 21.6 W(含 DDR、电源损耗) | 约 42.9 W |
可调功耗档位 | 3 W ~ 20 W 区间可锁 PowerLimit | 双芯满载接近 40 W |
互联 | — | 带 HM-LINK 互联,卡间级联做多卡 LLM 拆分 |
不同负载下功耗表现(单 LQ50)
空载:3–5 W
轻量 7B 模型 Q4 推理:7–10 W
拉满 160 TOPS 满载极限:接近 20 W 上限
三、实测现象(社区部署反馈)
1. LLM 推理功耗不会瞬间冲到顶:7B / 13B 量化模型稳态一般落在 8–14 W(单 LQ50);对比同吞吐 RK3588、BM1684X,单位 token 功耗低约 30%~60%,长上下文差距进一步拉开。
2. 跑纯 CNN 目标检测,能效优势缩水到 10%~20%,生态成熟的传统 NPU 反而更省心。
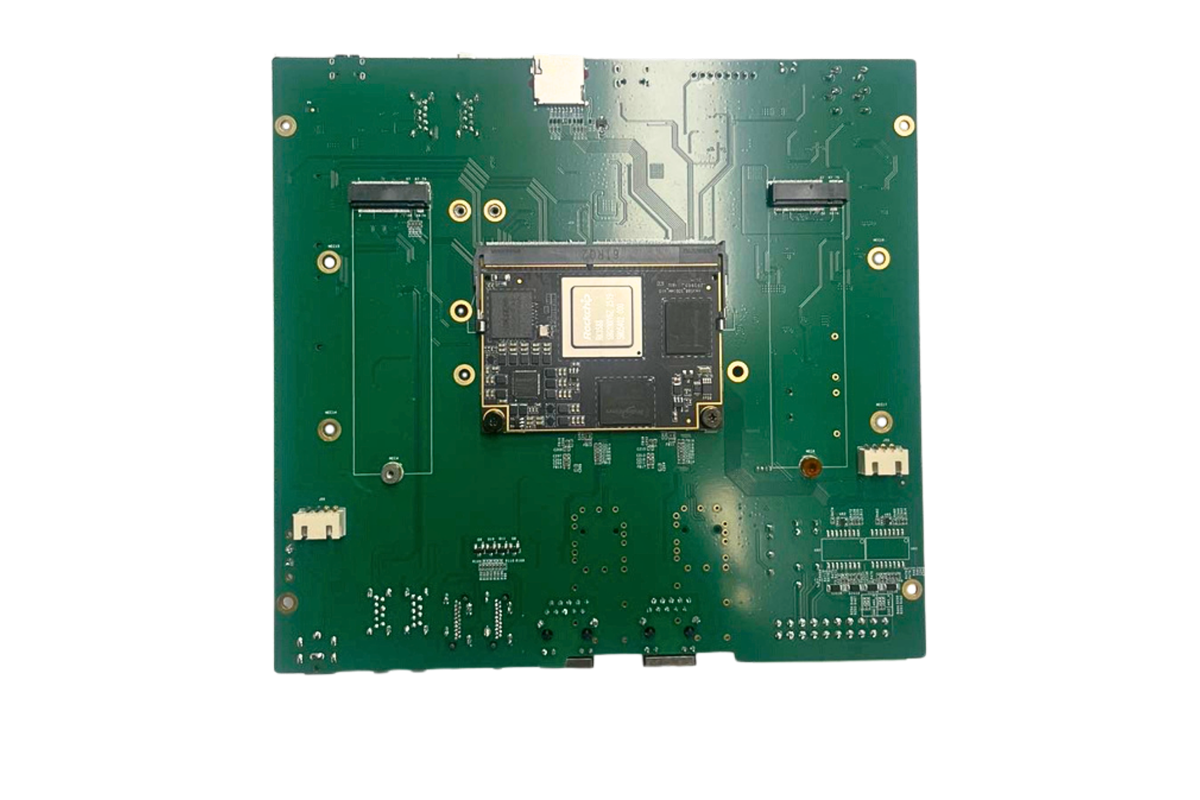
3. M.2 插槽供电是瓶颈:普通 M.2 插槽很多只能给到 10 W 左右,想跑满 LQ50 要改供电、用专用载板,不然会降频锁功耗。
四、横向对标参考
产品 | 典型功耗 | 算力 | 定位与特点 |
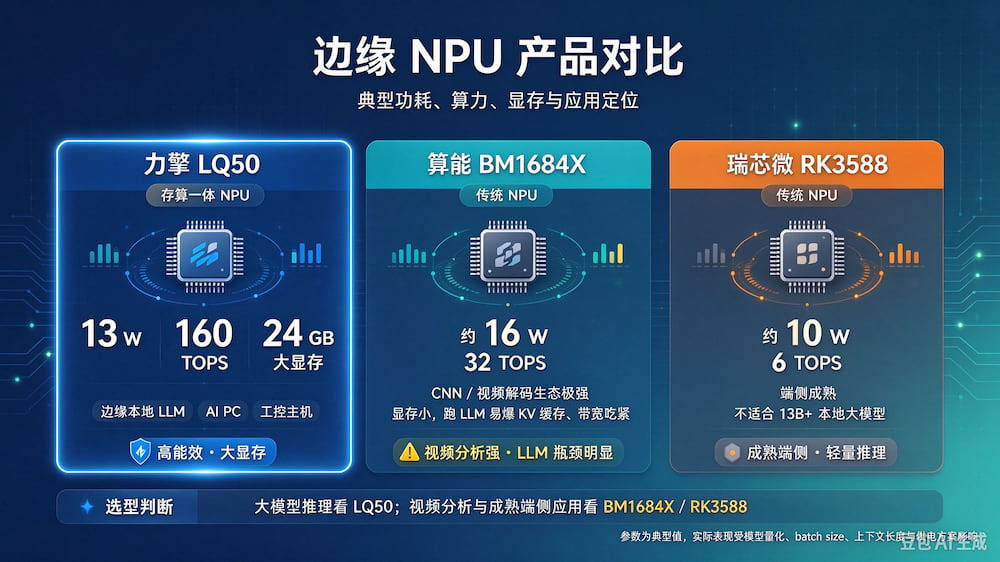
力擎 LQ50 | 13 W | 160 TOPS | 24 GB 大显存,边缘本地 LLM、AI PC、工控主机 |
算能 BM1684X | 约 16 W | 32 TOPS | CNN / 视频解码生态极强;显存小,跑 LLM 易爆 KV 缓存、带宽吃紧 |
瑞芯微 RK3588 | 约 10 W | 6 TOPS | 端侧成熟,不适合 13B+ 本地大模型 |
五、选型建议
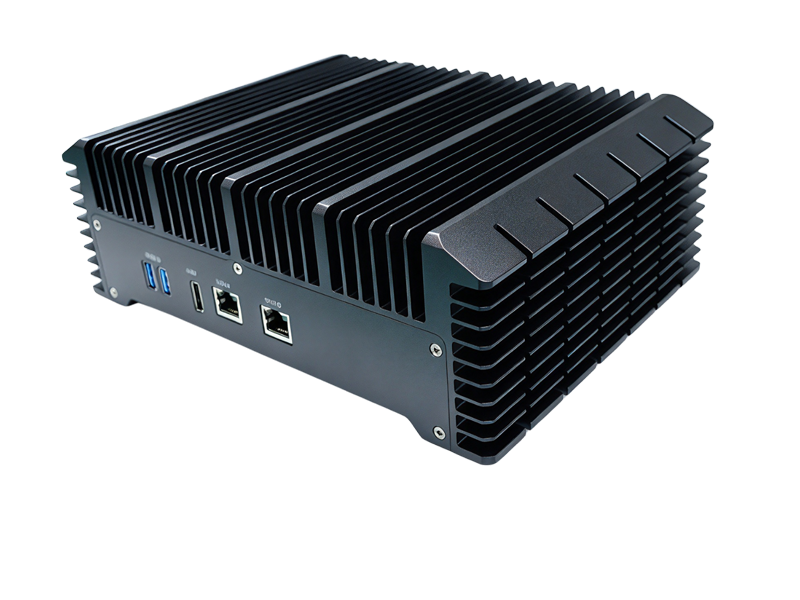
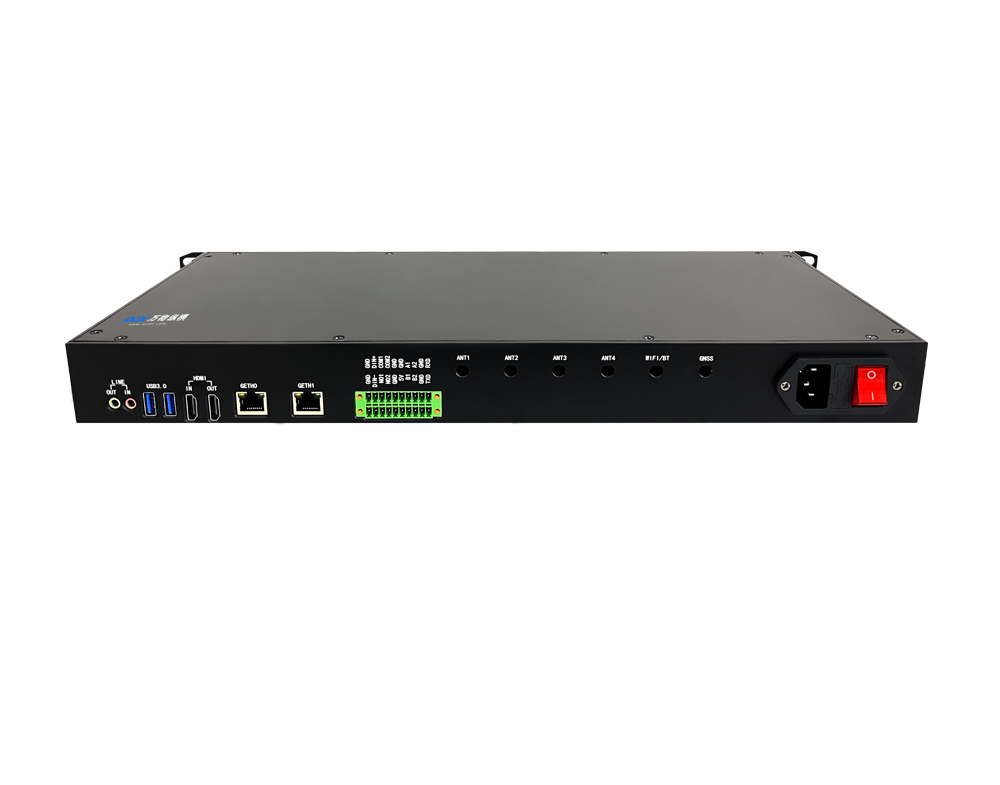
目标:本地跑 7B/13B/34B 量化大模型、长上下文、多并发对话、低功耗边缘盒子 → LQ50 存算一体优势很大,值得上
目标:只做视频分析、YOLO、人脸识别、批量图像推理、需要自定义算子 / 训练 → BM1684X、RK 这类传统 NPU 更稳、工具链成熟
请用手机扫码查看分享内容
 需求留言:
领先的边缘智能产品与解决方案提供商



产品咨询:17340067106(毛经理)
软件算法咨询:18982151213(刘经理)
四川省成都市武侯区天府五街花漾锦江JR大厦B座7层(总部)



 试用申请
 产品咨询
 在线客服
 回到顶部