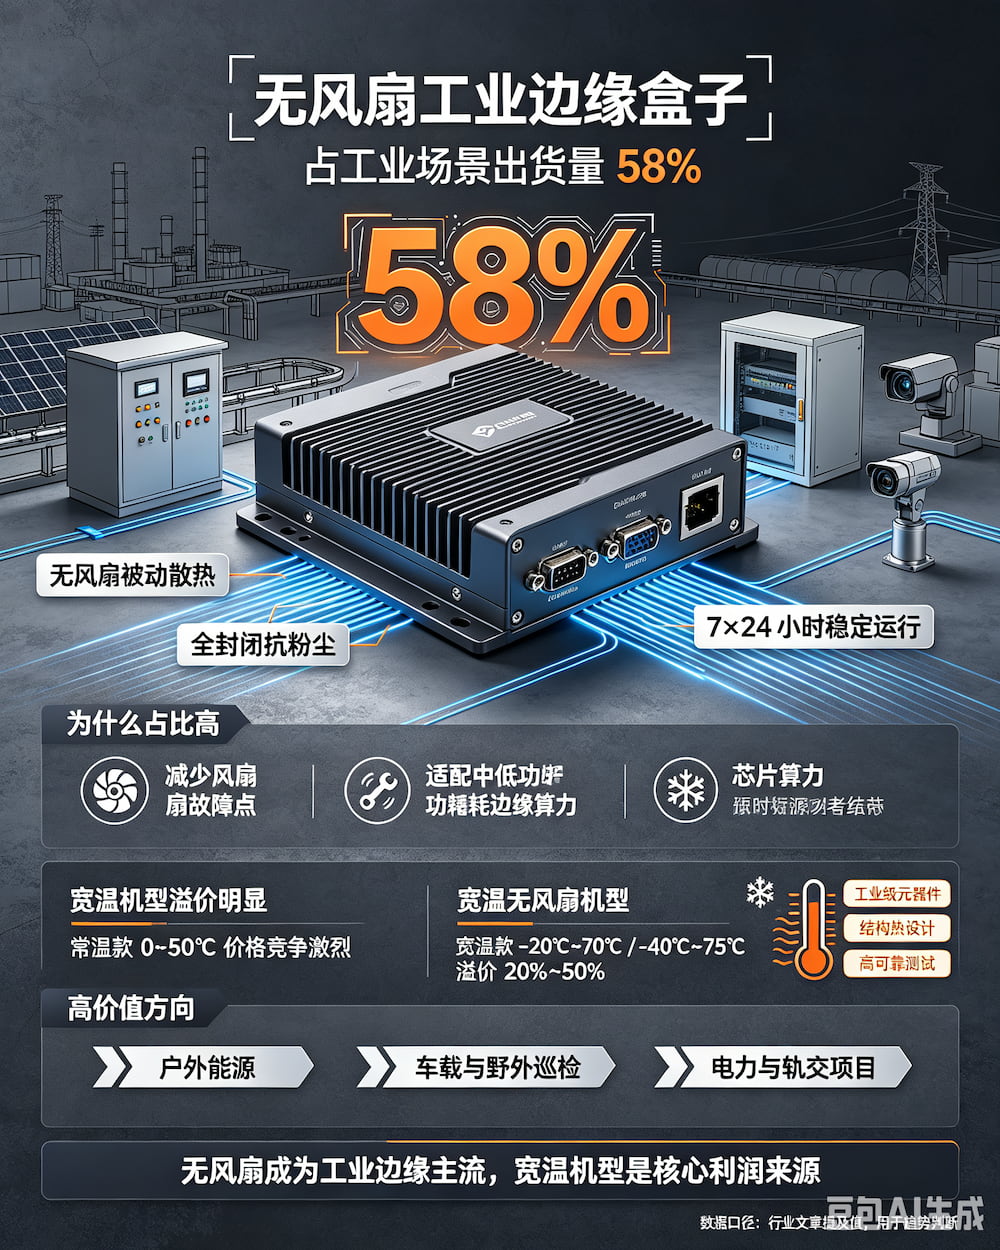
无风扇被动散热方案已经成为工业边缘盒子主流选型,出货量占工业场景整体 58%。核心驱动是工业现场粉尘、振动、长期 724 小时运行场景,风扇属于运动部件,是整机
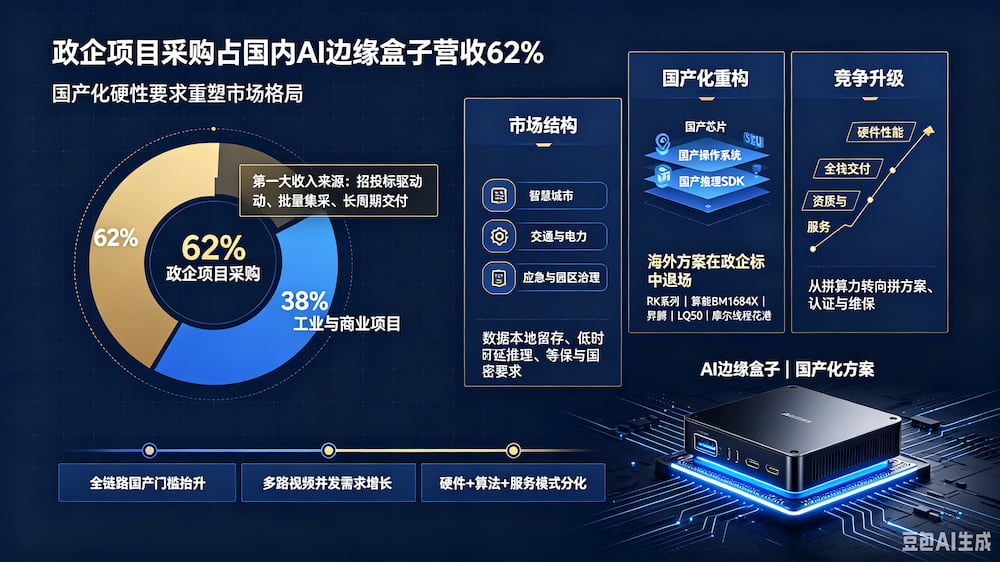
国内 AI 边缘盒子市场呈现政企采购为主导、国产化招标规则重塑产业链的格局:政企项目贡献整体营收 62%,是行业第一大收入来源,涵盖智慧城市、明厨亮灶、智慧工地
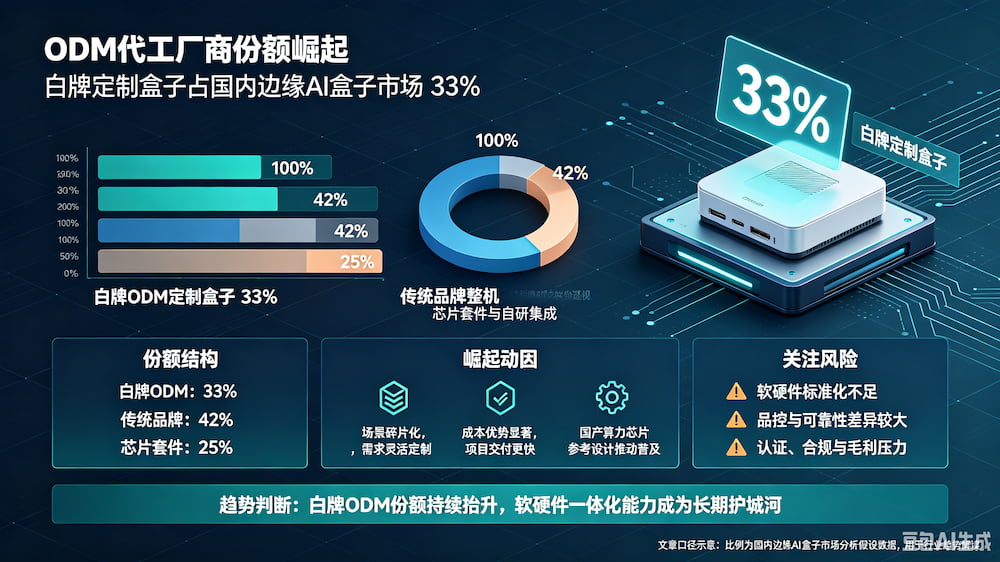
国内边缘 AI 盒子市场,白牌 ODM 定制整机出货占比达到 33%,已经成为不可忽视的主力板块;传统品牌整机份额承压,产业链重心向硬件 ODM + 算法集成方
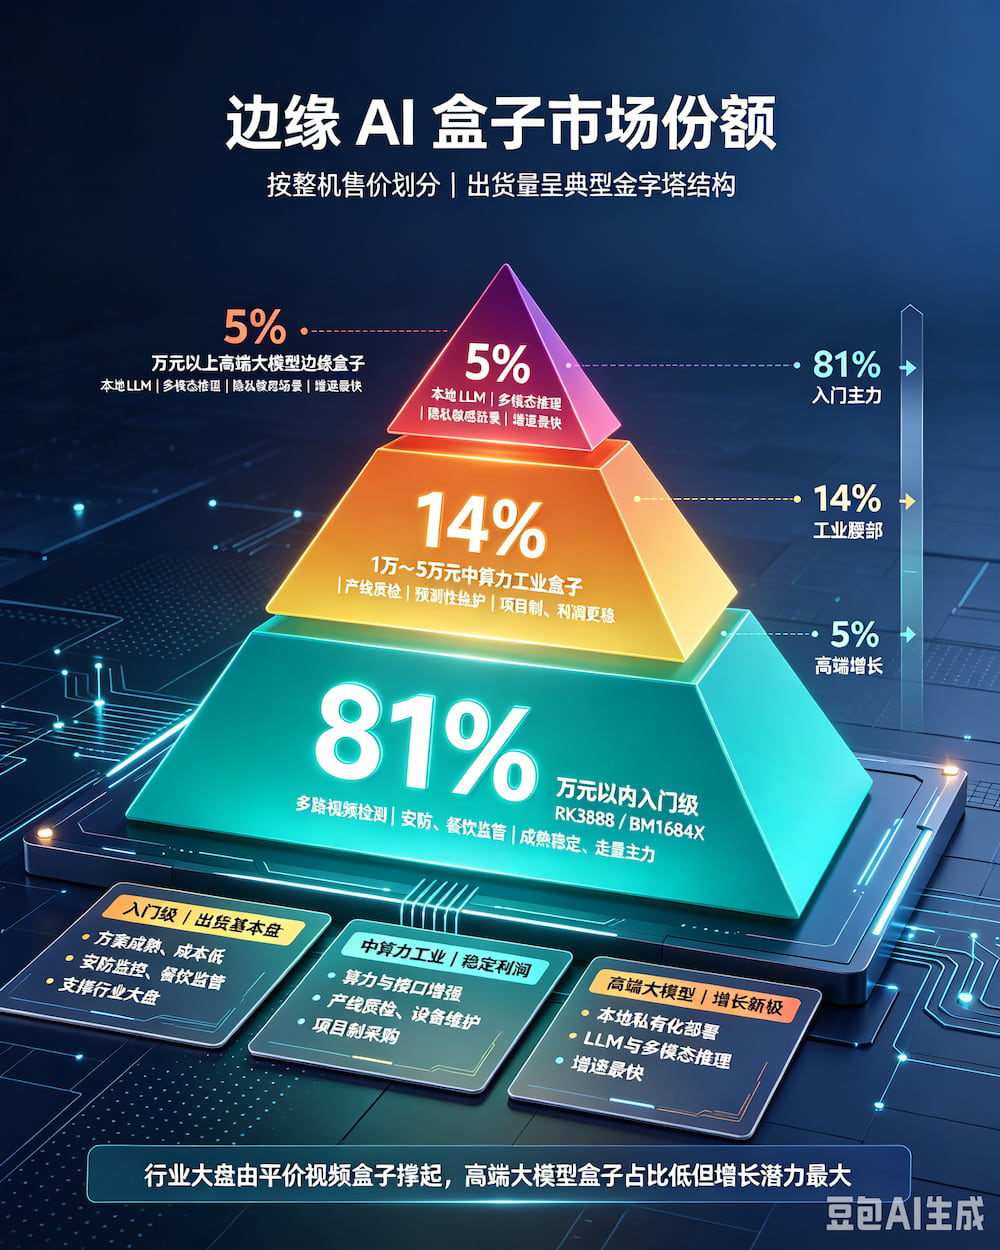
从整机售价划分边缘 AI 盒子出货份额,行业呈现典型金字塔结构,出货量高度集中在低价入门产品。万元以内入门级 AI 盒子,采用 RK3588、BM1684X 主
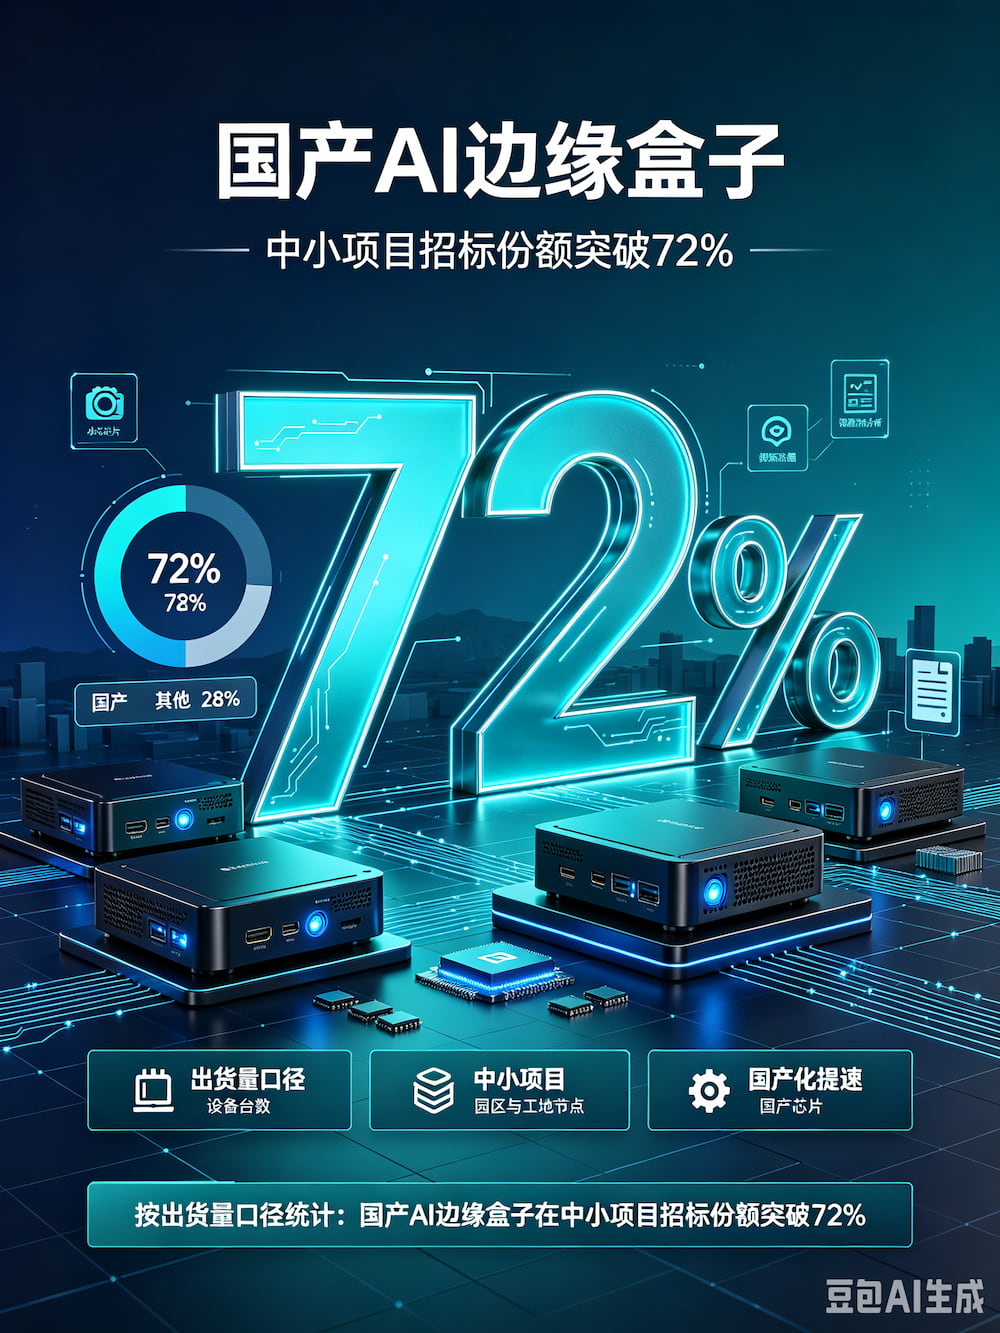
按出货量口径统计,国产 AI 边缘盒子在中小项目招标市场份额已突破 72%;大型项目仍存在海外方案(Jetson 等)的存量空间,中小项目成为国产替代主战场。一
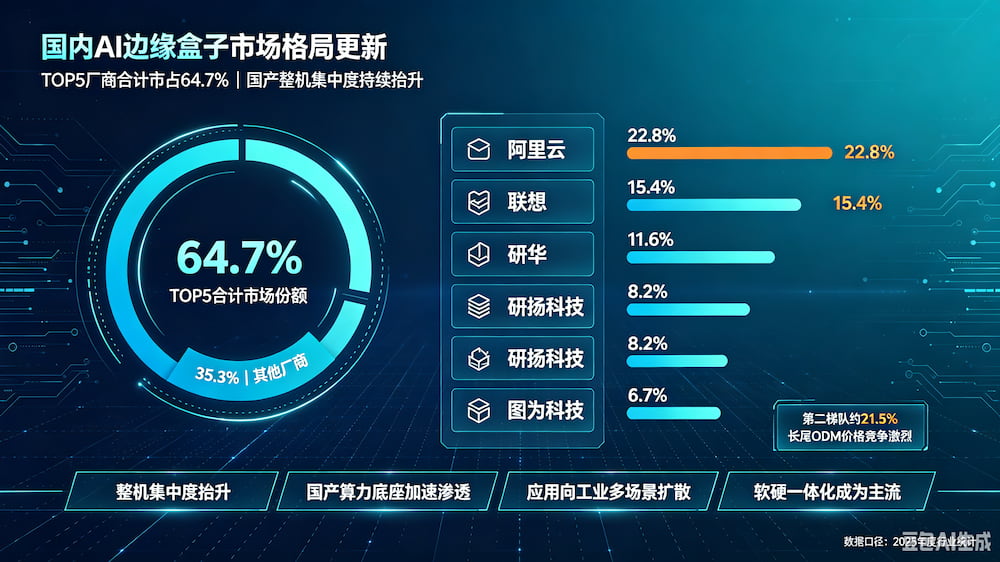
核心数据(2025 年度统计)TOP5 厂商:阿里云、联想、研华、研扬科技、图为科技,合计市场份额64.7%,相比 2024 年的 61.2% 提升 3.5 个
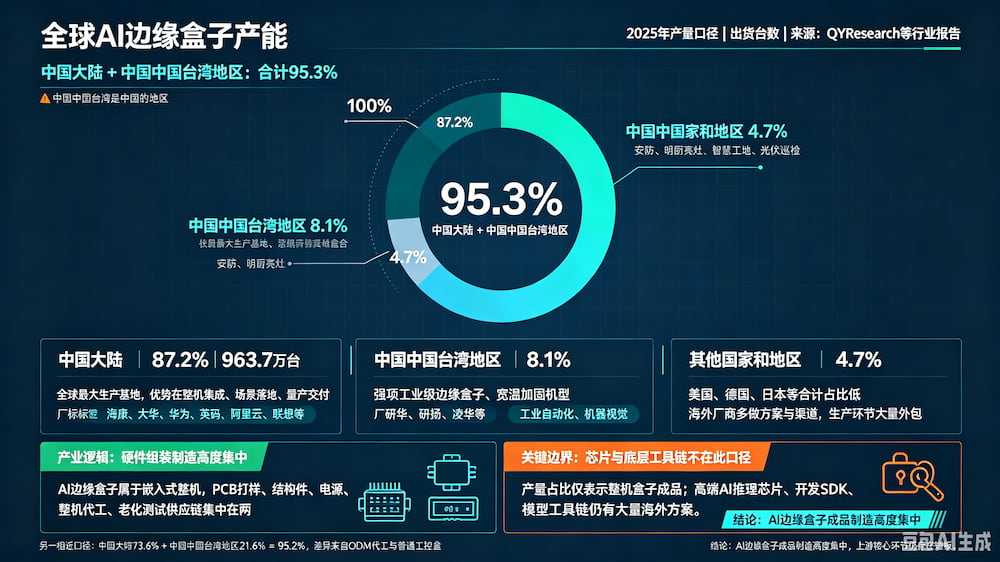
一、核心拆分中国大陆:87.2%,出货 963.7 万台;代表厂商:海康、大华、华为、英码、阿里云、联想等,主打安防、明厨亮灶、智慧工地、光伏巡检等海量场景,是
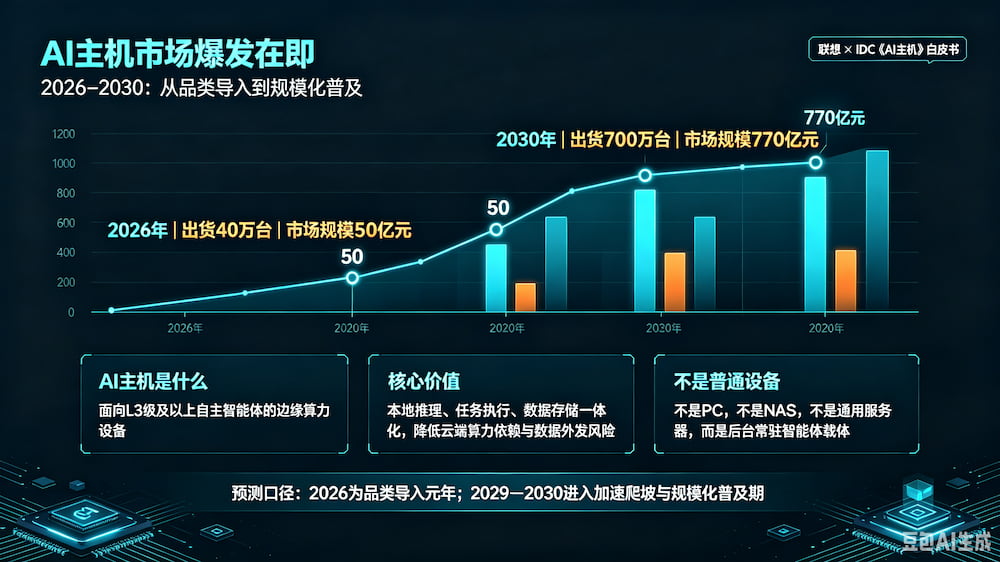
一、AI 主机定义AI 主机是专为智能体打造的边缘设备,定位介于普通 PC 和服务器之间:能力:本地推理、任务执行、本地数据存储一体化,724 小时常驻运行,做
AI 主机定义:专为 L3 级及以上自主智能体设计的边缘算力设备,支持 724 小时常驻运行,集本地推理、任务执行、数据存储一体化,作为端 - 边 - 云架构里
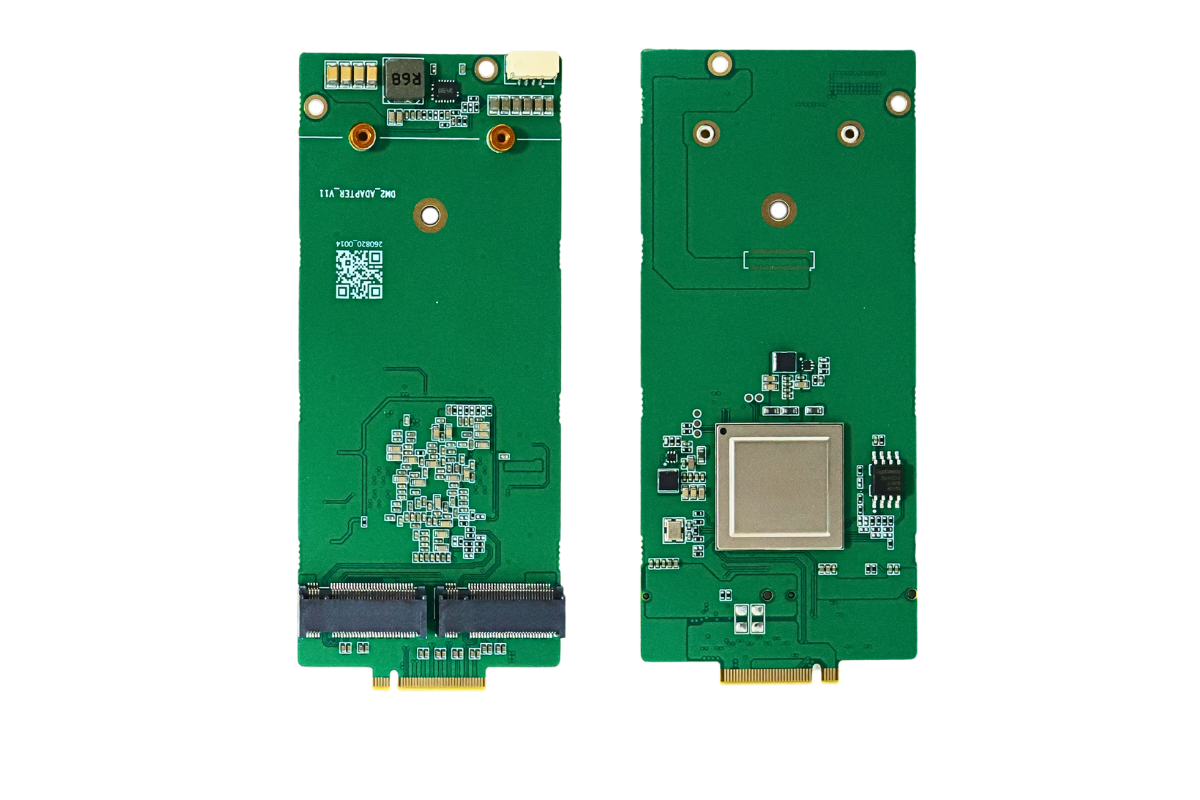
边缘 AI、工业物联网项目中,硬件资源往往寸土寸金。很多 ARM 开发板仅提供单个 M.2 M‑Key 接口,当项目既要本地高速存储,又要挂载 AI 算力加速卡
很多做边缘嵌入式开发的工程师,都希望一块开发板可以同时运行多块 M.2 设备。传统方案想要拆分 PCIe 通道,大多依赖主板 BIOS 开启通道分叉(Bifur
在边缘计算、工控、NAS 存储场景中,大量开发者经常面临一个现实难题:主板原生 M.2 接口数量有限,无法同时挂载多块 NVMe 硬盘、AI 算力模组等 M‑K
在边缘计算领域,如何在有限的功耗和体积下运行更大的大语言模型,一直是开发者关注的痛点。此前,基于瑞芯微 RK182X SDK 1.1.0 的双卡级联方案,已经让
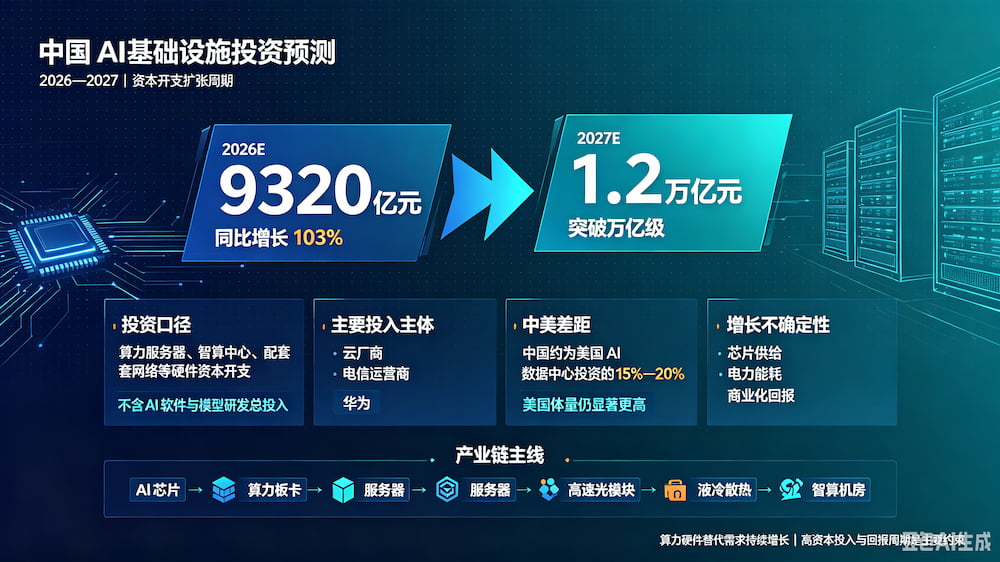
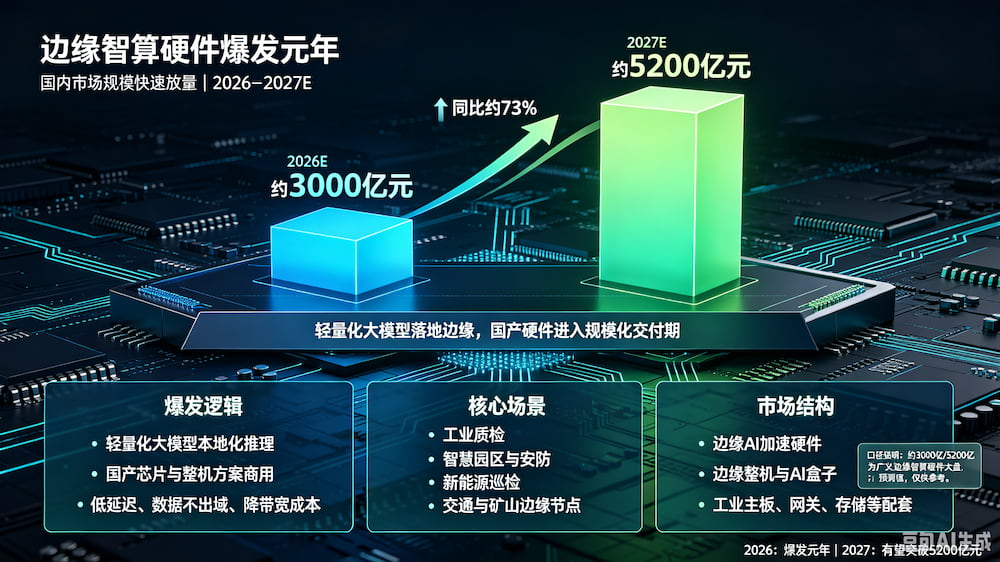
报告测算:2026 年国内 AI 基础设施资本开支预计同比增长 103%,达到9320 亿元;2027 年将突破 1.2 万亿元,主要由国内超大规模云厂商、三大
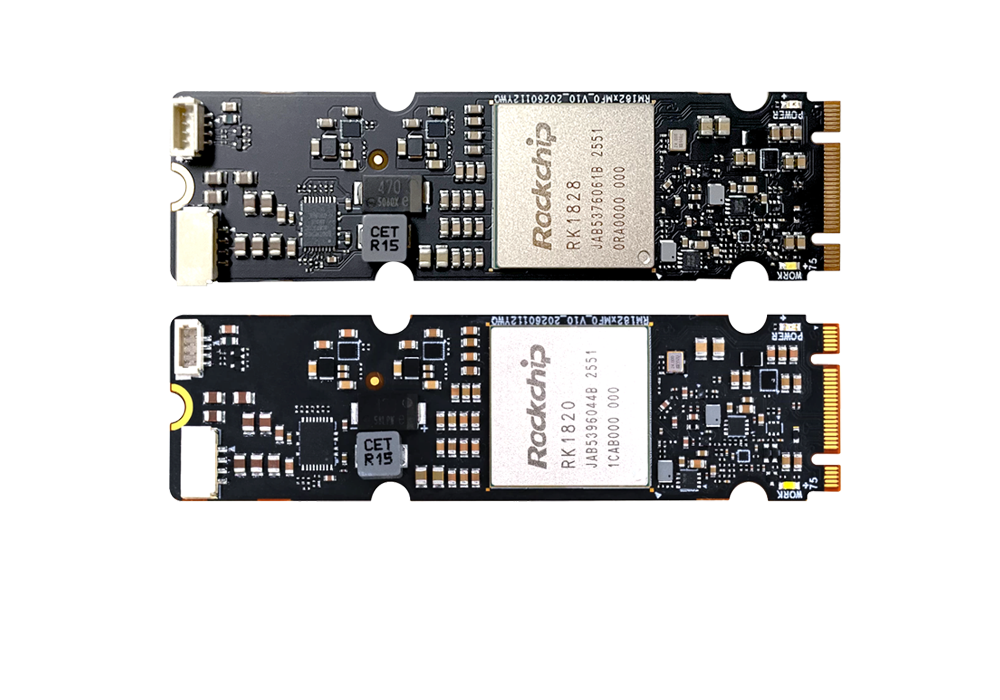
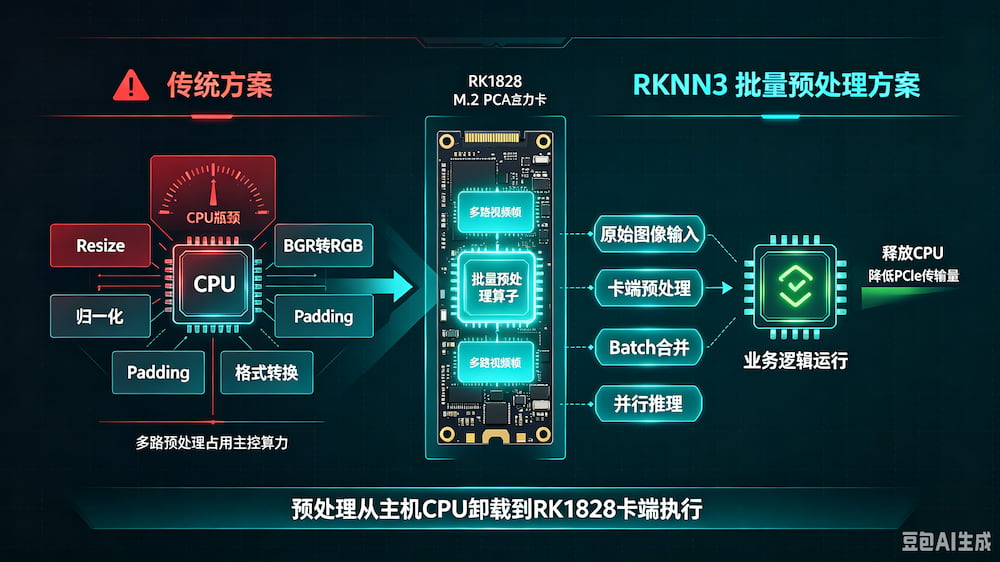
RK1828 M.2 PCIe 算力卡搭配新版 RKNN3 SDK,新增批量预处理算子,把图像缩放、归一化、通道转换、均值方差、数据格式转换等预处理操作,从主控
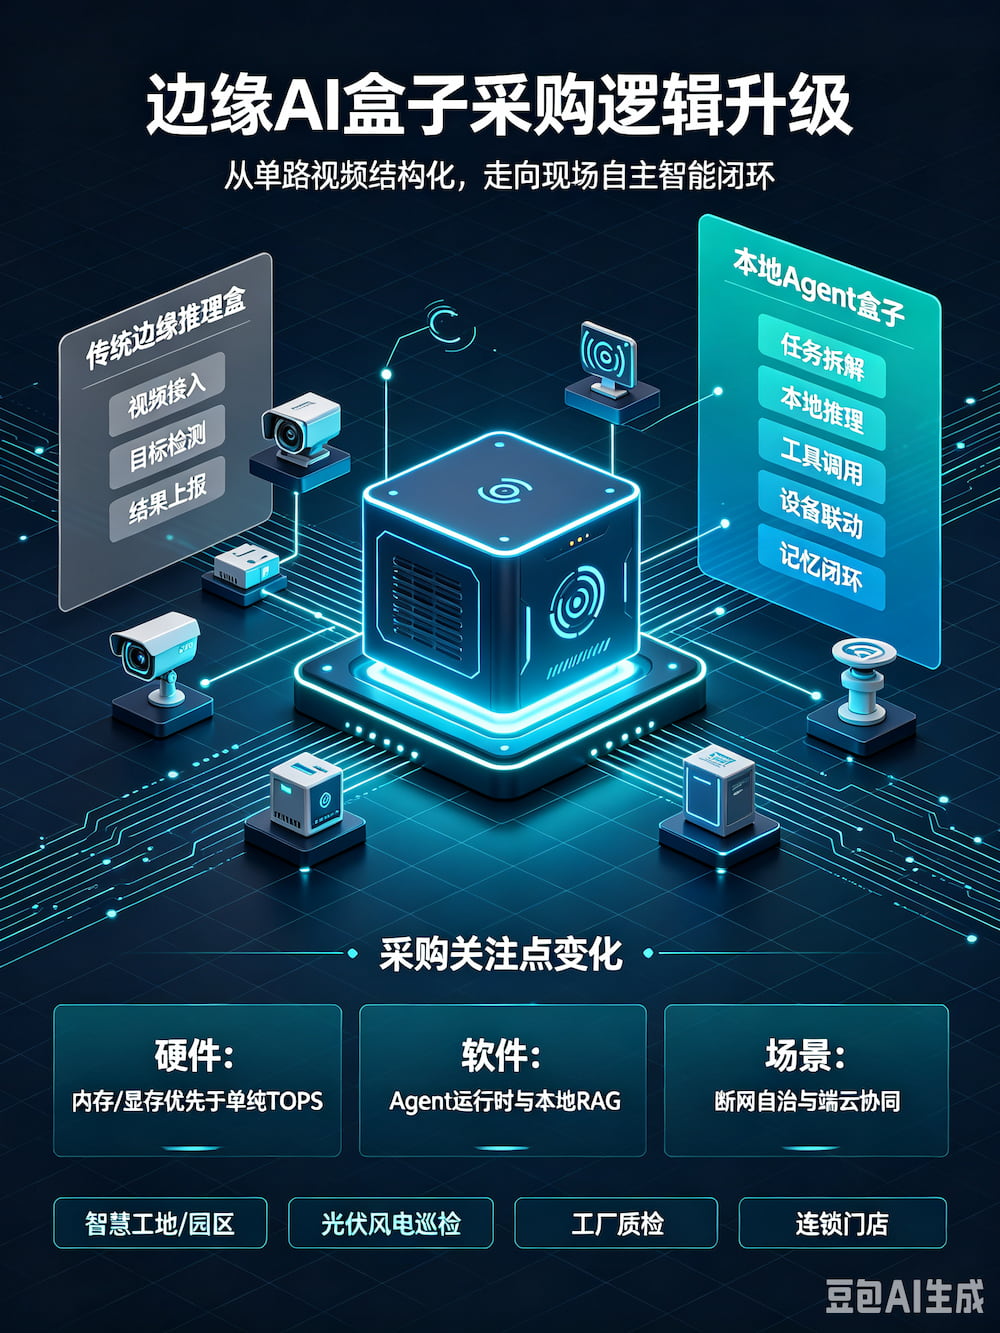
采购逻辑从单路视频结构化 / 目标检测,升级为现场自主智能闭环;不再只看 TOPS,重点看内存 / 显存、长上下文、Agent 运行时、多模型并发、本地工具调用
口径说明:3000 亿 / 5200 亿属于广义边缘智算硬件大盘(边缘算力卡、AI 盒子、边缘服务器、工业智算主板、网关、存储、配套硬件整机,不包含纯软件与云端
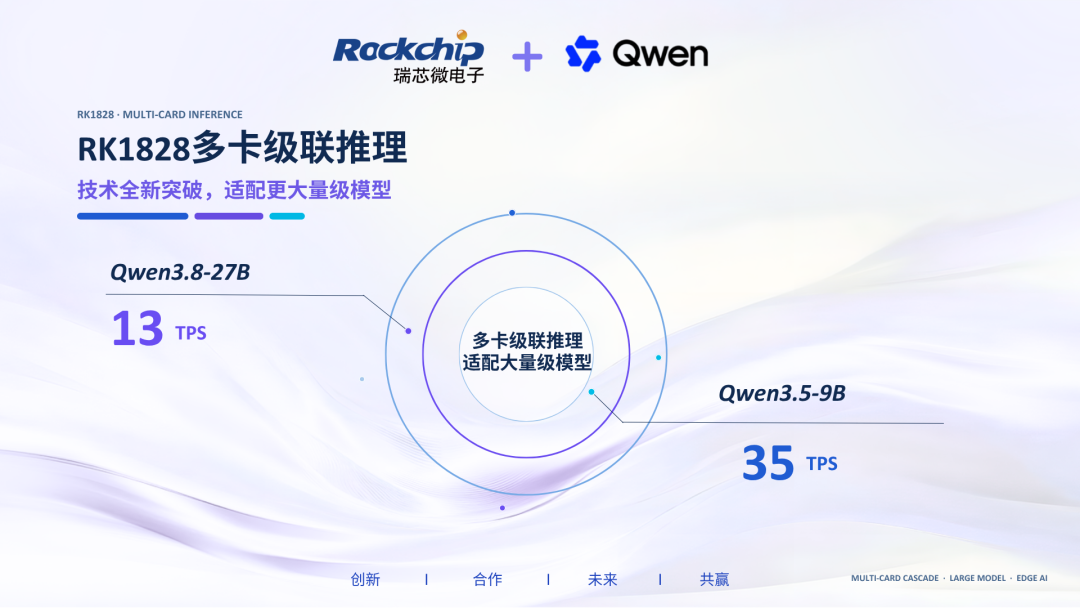
RK1828 多卡级联采用模型层间流水线并行(Pipeline Parallelism),依托 RKNN3 SDK 做调度、显存、KV Cache 与解码循环深
一、项目背景项目类型:边缘端多路视频分析 + 本地大语言模型联动方案典型场景:智慧工地、明厨亮灶、园区安防、光伏巡检、高速服务区视频 AI。核心诉求:1. 多路
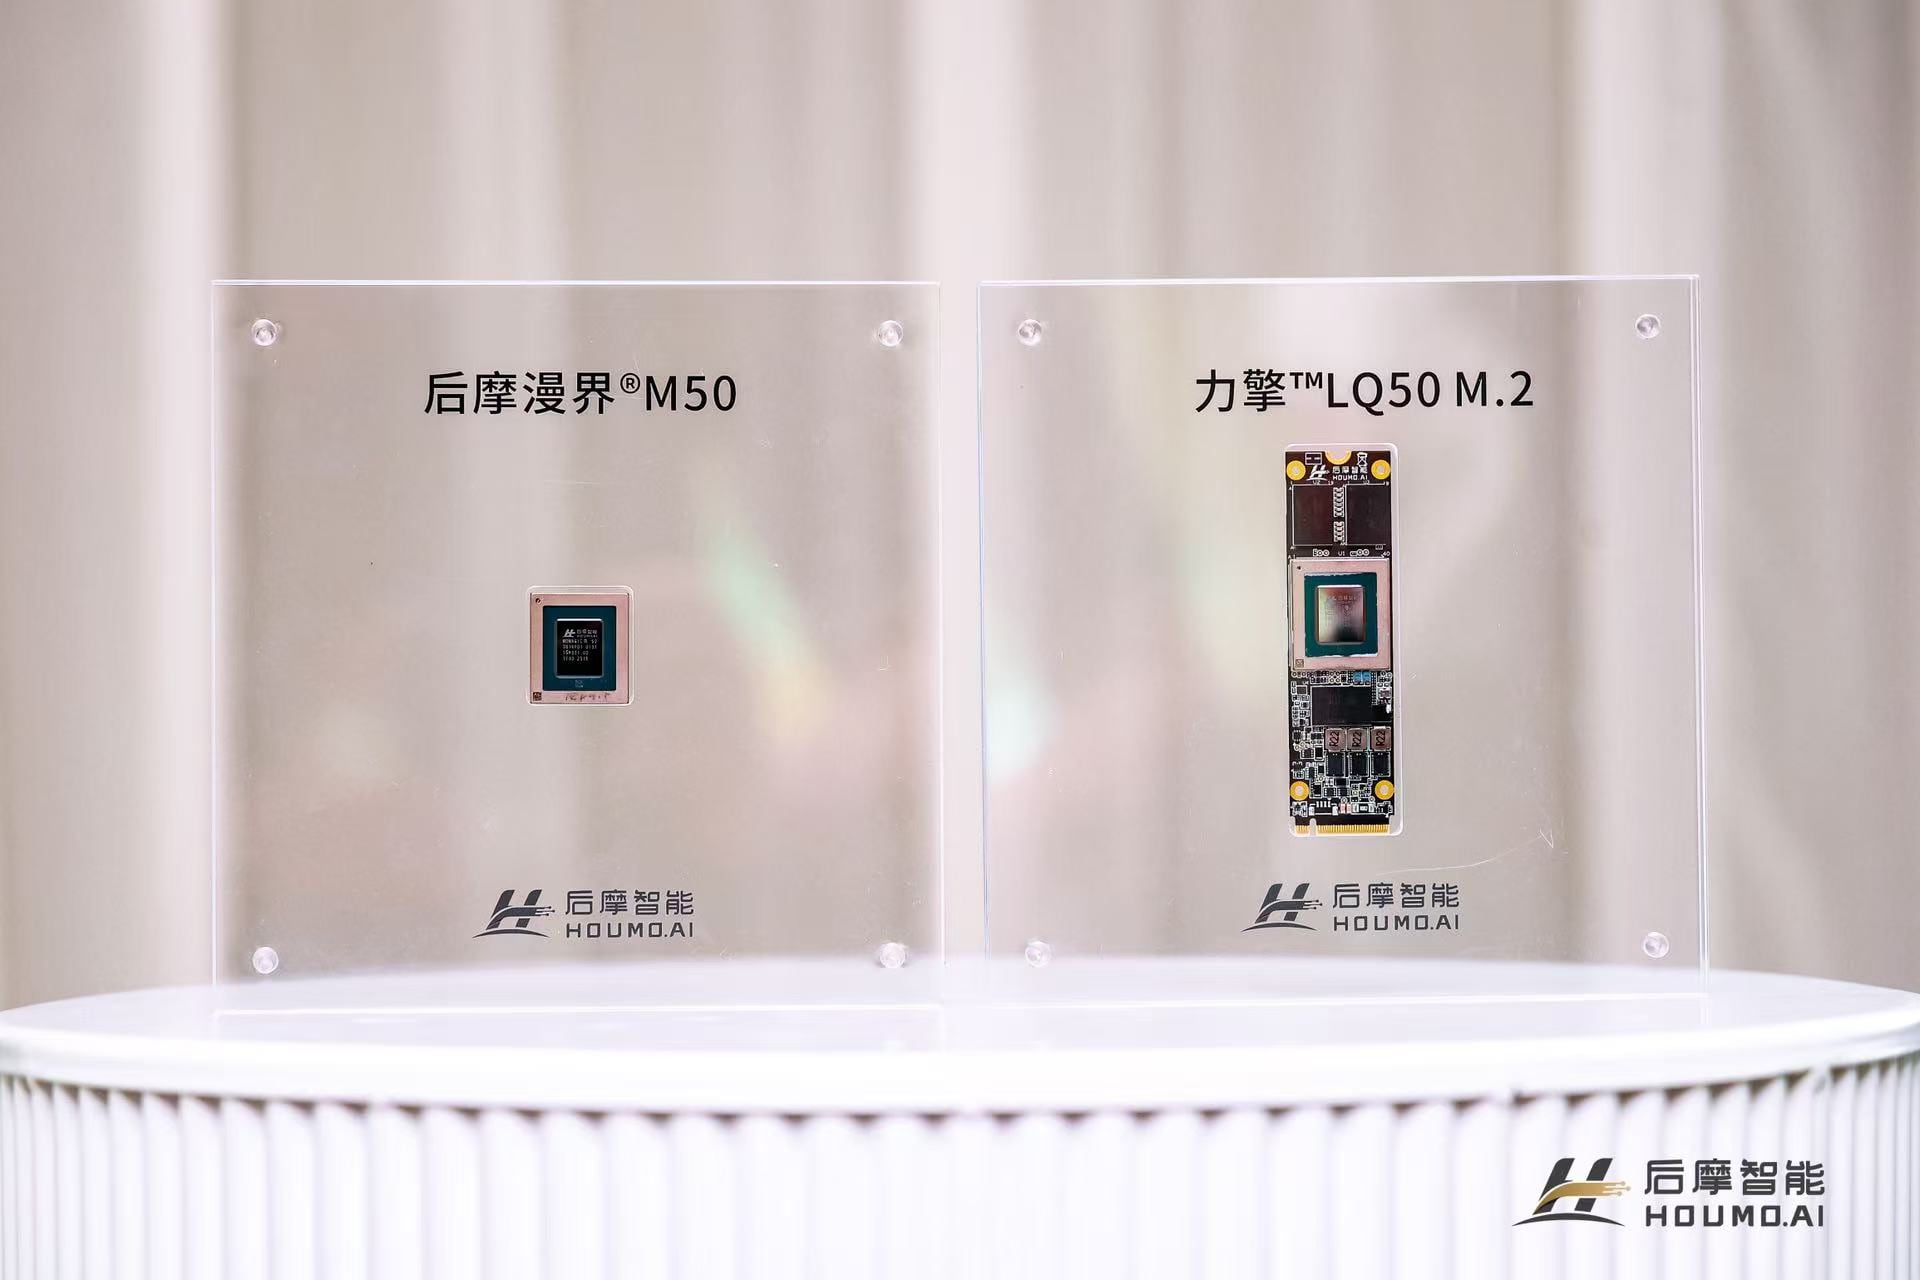
LQ50 Duo 单卡集成双 M50 存算一体芯片,超高单卡算力 / 超大显存,适合 70B 级大模型、高吞吐;RK1828 四卡级联是 4 张独立 M.2 协
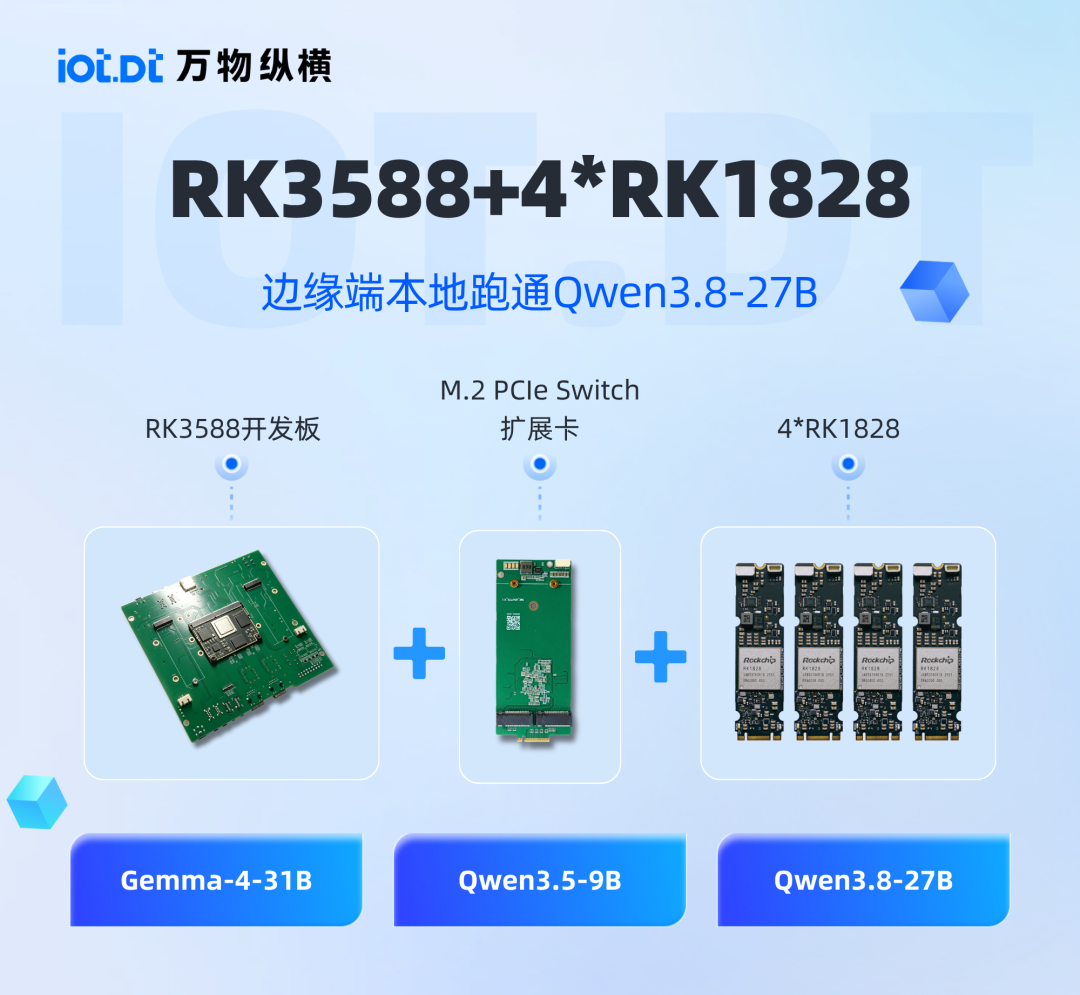
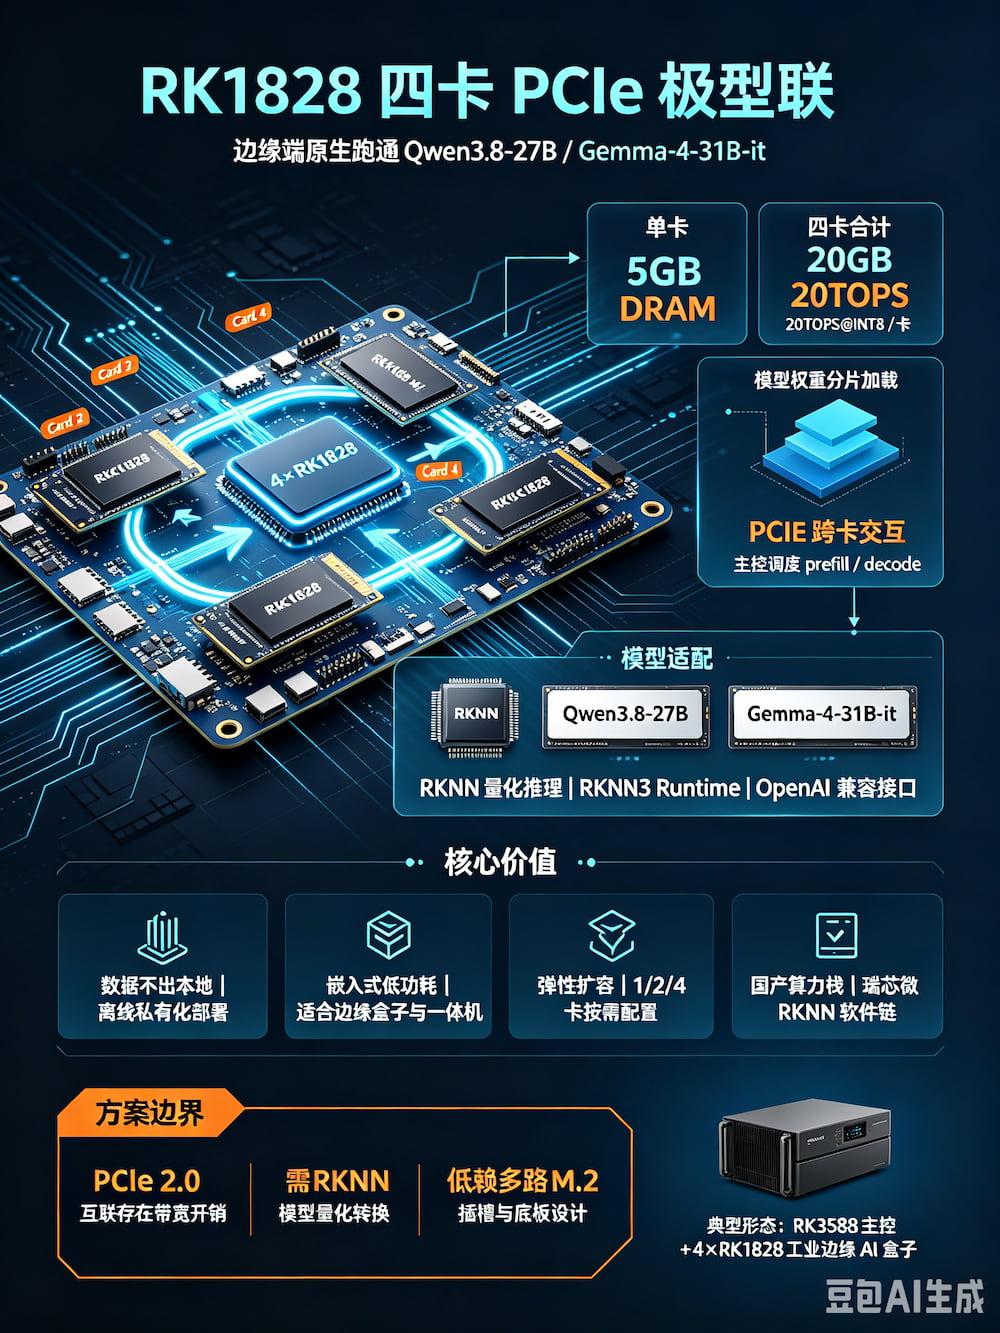
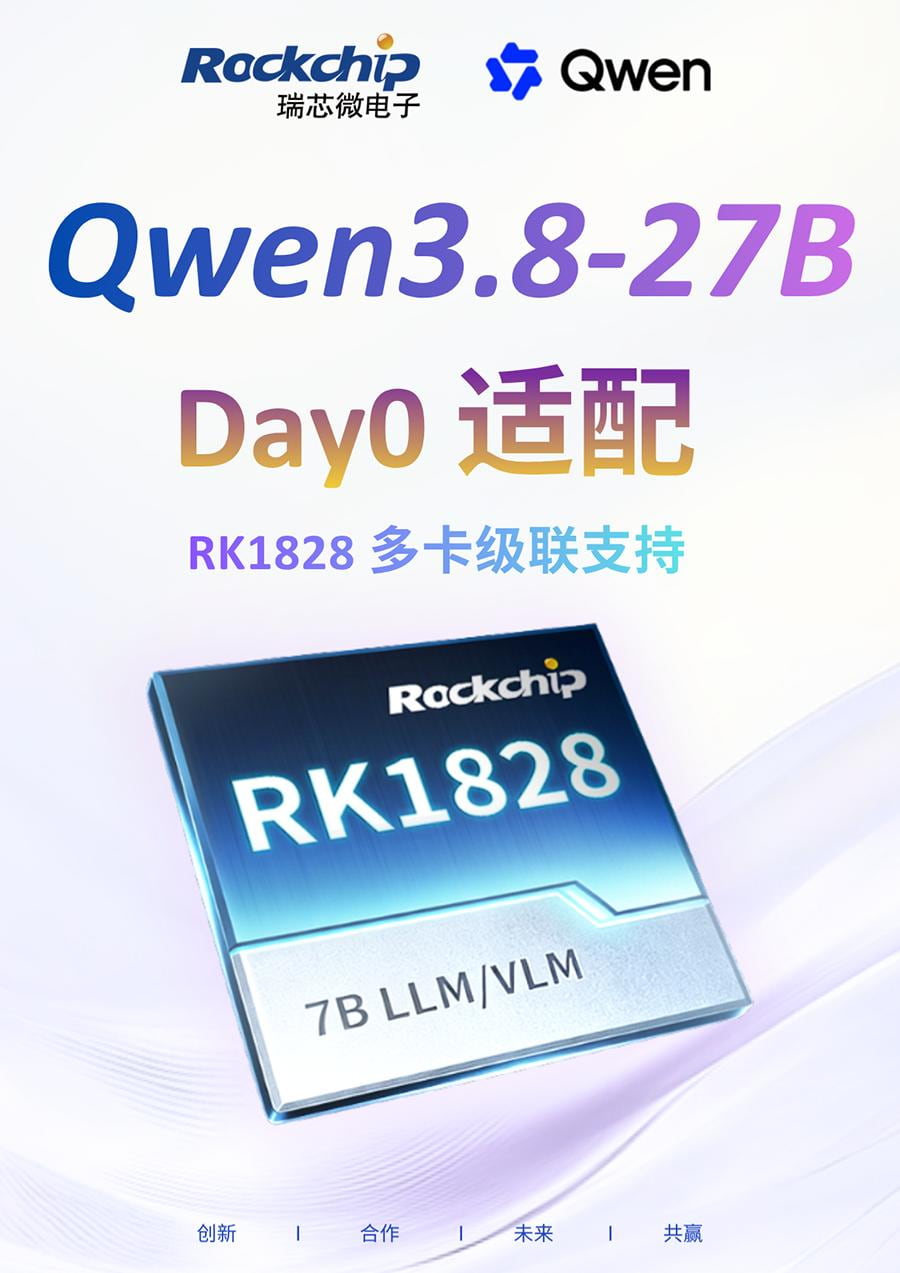
瑞芯微 RK1828 M.2 2280 AI 协算力卡,基于RK182X_AI_SDK V1.1.0,四卡 PCIe 级联推理落地,边缘端原生跑通 Qwen3.
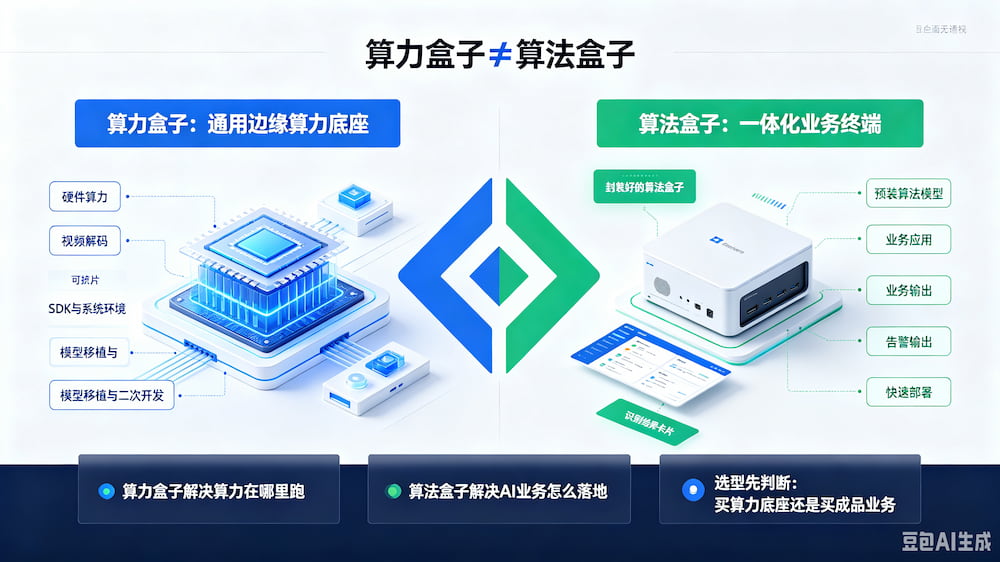
很多项目选型时,很容易把算力盒子和算法盒子混为一谈,甚至当成同一种硬件采购,最后出现算法无法部署、交付周期拉长、运维成本飙升等问题。一句话先划重点:算力盒子 =
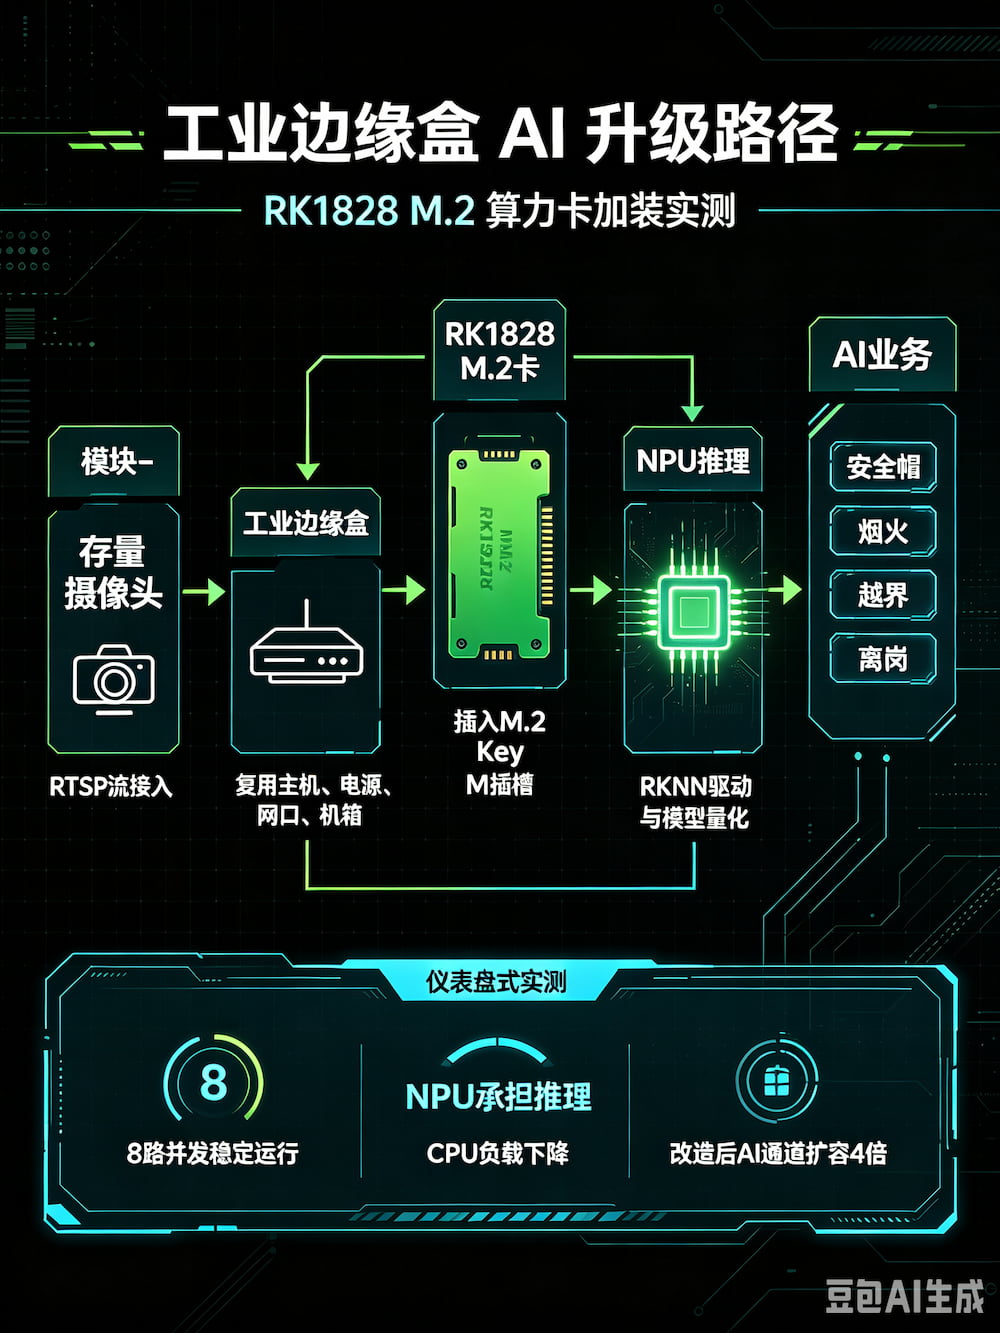
一、改造背景大量工地、园区、明厨亮灶项目已有存量 IPC 摄像头,原有边缘盒算力不足,只能做简单视频转发,无法新增 AI 识别(安全帽、烟火、离岗、越界等)。重
RK1828 支持的大语言模型清单(RKNN3 / RKLLM3,单卡 / 多卡级联)底层依靠 RKNN3+RKLLM3,原生支持 mRoPE、Function
一、硬件架构主控:RK3588(仅做任务调度、外设管理,不参与 LLM 算力计算)加速卡:4 张 M.2 2280 Key-BM RK1828 AI 算力卡,P
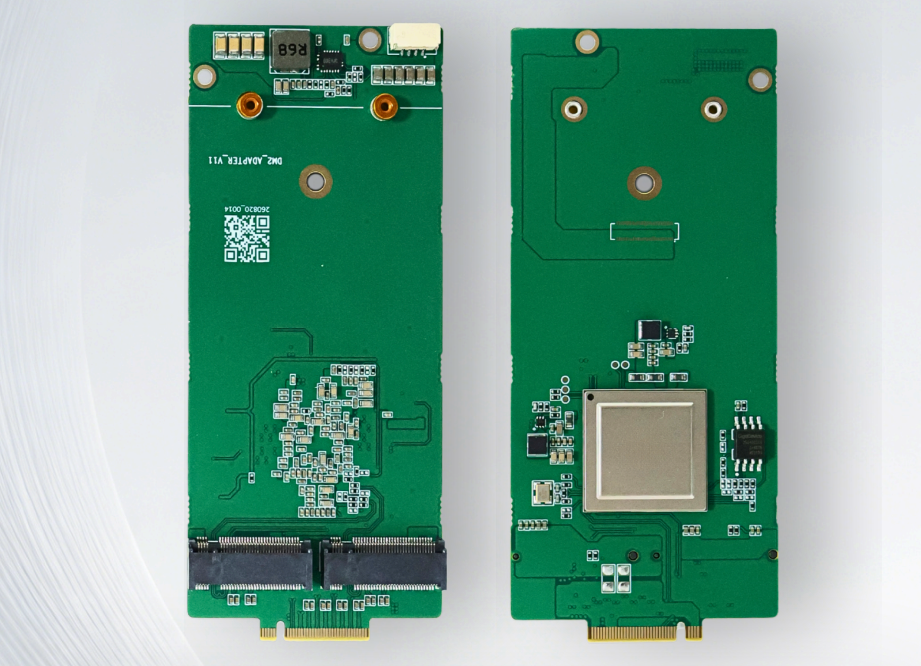
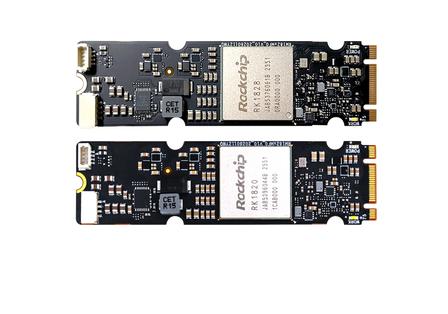
一、硬件核心规格RK1828 是瑞芯微 RK182X 系列 M.2 2280 形态 AI 协算力卡,定位边缘端本地大模型推理,峰值算力 20TOPS@INT8接
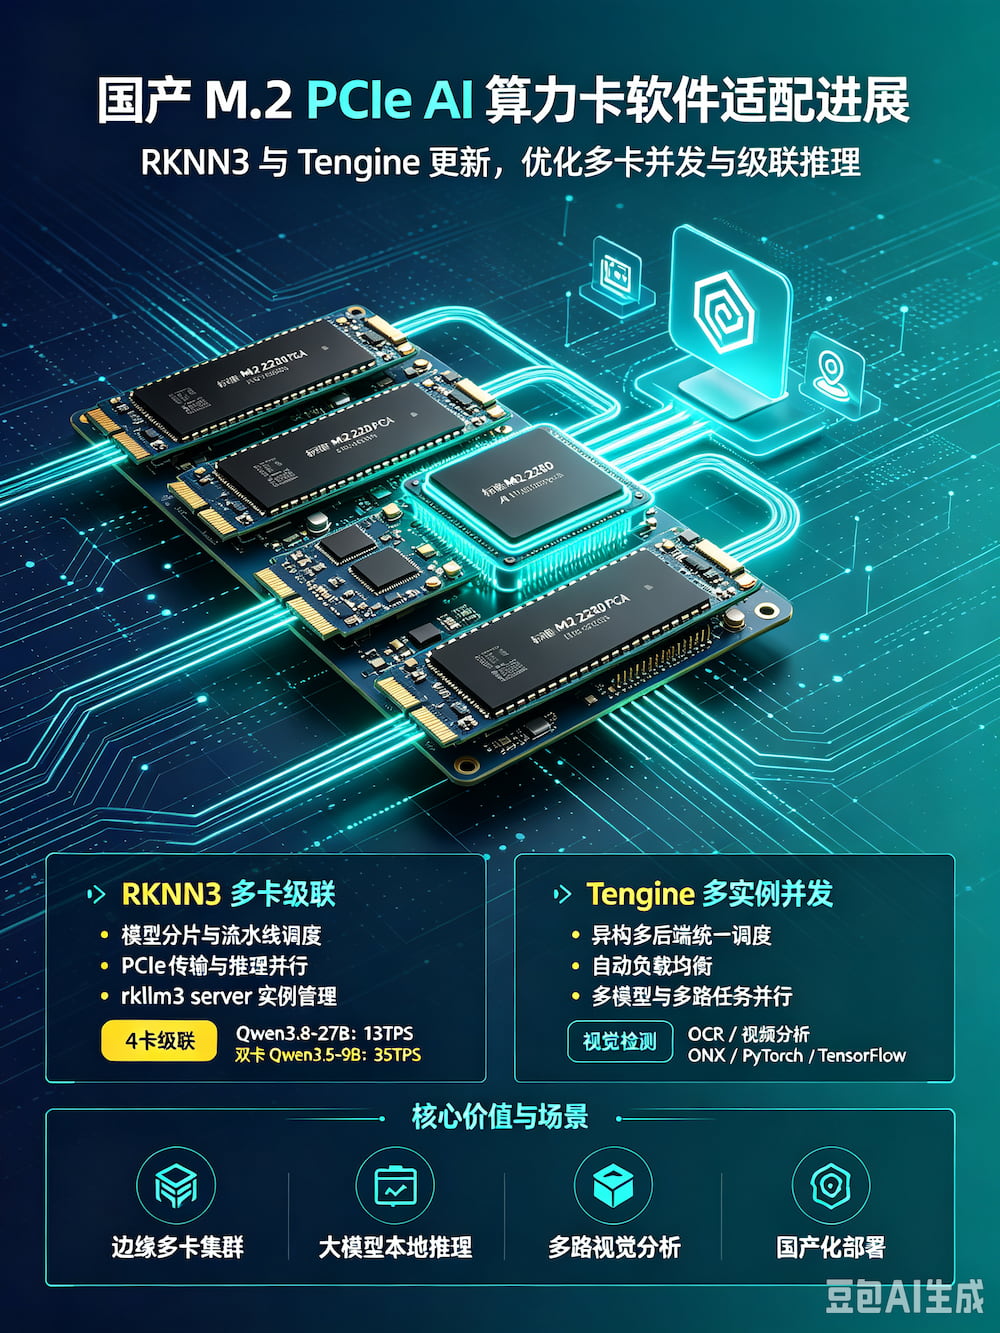
国产 M.2 形态 PCIe AI 算力卡生态持续补齐软件短板,RKNN、Tengine 两大国产推理框架陆续发布新版本,重点针对 M.2 多卡并发、多卡级联推
*









 试用申请
 产品咨询
 在线客服
 回到顶部